Innstillinger
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Guide til SEO for medier: Top Stories, Discover, nyhetssitemaps, markup for artikler og betalingsmurer, pluss hvordan du blir sitert av KI og tar stilling til lisensiering.

Verktøy

Kort fortalt
SEO for medier er settet med tiltak som hjelper nyhets- og mediesider med å tjene trafikk fra Google Search, Top Stories, Google News, Discover og nå også KI-assistenter. Det hviler på fire søyler: rask indeksering av ferske artikler (nyhetssitemap, rene URL-er, interne lenker), tillitssignaler (signaturer, datoer, rettelser, forfattersider), teknisk markup (krav til Article, betalingsmur og bilder) og en bevisst holdning til KI-crawlere og lisensiering. Evergreen-innhold og egne kanaler mot publikum beskytter virksomheten når søketrafikken går ned.
Vil du vite mer? Spør
Rask quiz
Passer SEO for deg, og hvordan bør du starte?
Sorank passer til svarene dine


Prøv det i 3 dager på ditt eget nettsted, og se hvor du står på Google, ChatGPT og de andre AI-assistentene.
Start en gratis prøveperiode på 3 dager3 dager gratis, deretter kan du stoppe når du vil. Resultatgaranti i 90 dager, ellers pengene tilbake.
SEO for medier skiller seg fra vanlig SEO fordi et nyhetsnettsted publiserer dusinvis eller hundrevis av sider hver dag, og de fleste mister verdien sin i løpet av 48 timer, mens det redaksjonelle arkivet fortsetter å gi besøk i årevis. Innsatsen har økt: rapporten Journalism, Media and Technology Trends and Predictions 2026 fra Reuters Institute (januar 2026) siterer data fra Chartbeat som viser at Google-søketrafikken til mer enn 2,500 nyhetssider falt med 33% fra år til år mellom november 2024 og november 2025, og at de 280 mediesjefene som ble spurt, venter at søkehenvisningene vil falle med ytterligere 43% i løpet av tre år. Å optimalisere godt handler nå om å beholde trafikken som er igjen, og å bli sitert der leserne går videre. Denne guiden dekker hva som endrer seg for forlag og medieselskaper, fra nyhetsflater til KI-svar.
SEO for medier bruker søkeoptimalisering på nettsteder der produktet er redaksjonelt innhold: aviser, magasiner, digitale medier, fagpublikasjoner og store blogger som lever av annonser eller abonnement. Tre forhold skiller det fra vanlig SEO.
Et medie er også avhengig av flater de fleste nettsteder aldri ser: karusellene Top Stories, fanen Nyheter, appen Google News og Discover, en feed som viser innhold til brukere uten noe søk.
Hver flate har sin egen utvelgelseslogikk. Tabellen oppsummerer hva som driver synlighet, og hvor du måler den.
| Flate | Hvordan innhold kommer inn | Viktigste påvirkningsfaktorer | Hvor du måler |
|---|---|---|---|
| Søkeresultater (blå lenker) | Vanlig crawling og rangering | Relevans, dybde, lenker, sideopplevelse | Search Console, Søketype: Web |
| Top Stories | Automatisk, for søk med nyhetsintensjon | Aktualitet, autoritet på temaet, egen journalistikk | Search Console, filtrene for søkeutseende |
| Appen Google News og fanen Nyheter | Automatisk, underlagt retningslinjene for innhold i Google News | Åpenhet, datoer, signaturer, etterlevelse av retningslinjene | Search Console, rapporten for Google News |
| Discover | Automatisk, basert på brukernes interesser | Store bilder, ærlige titler, aktuelle eller unike saker | Search Console, rapporten for Discover |
| AI Overviews og KI-assistenter | Henting fra indekserte eller crawlede sider | Klare fakta, strukturerte svar, crawler-tilgang, merkeautoritet | Oppfølging av spørsmål, henvisningsanalyse |
Google sier i hjelpesiden for Publisher Center at det ikke finnes noe søknadsskjema: nettsteder som finnes via vanlig crawling, blir automatisk vurdert for Top Stories og fanen Nyheter hvis de produserer innhold av høy kvalitet og følger retningslinjene for innhold i Google News. Publisher Center er fortsatt nyttig for å administrere utgiverens navn, logo og seksjoner i appen Google News.
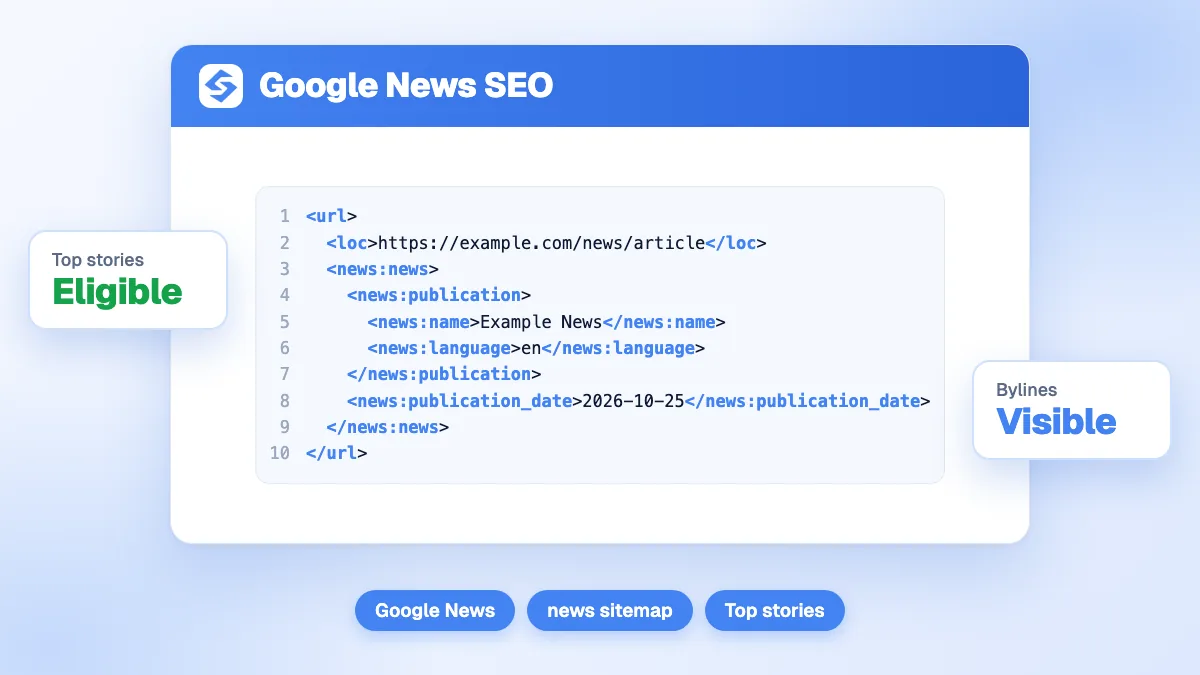
Et nyhetssitemap lister bare ferske artikler. Googles dokumentasjon for nyhetssitemap ber utgivere om å ta med bare URL-er til artikler opprettet de siste to dagene, med opptil 1,000 news:news-oppføringer per fil, og krever taggene news:publication (navn og språk), news:publication_date og news:title. Utgivernavnet må samsvare med det som vises i Google News. Behold et vanlig XML-sitemap for hele arkivet ved siden av.
Googlebot besøker forsiden og seksjonssidene ofte. Hvis du lenker hver ny sak fra disse knutepunktene, og fra relaterte aktive sider, blir den crawlet raskere enn med en innsending av sitemap. Temasider (én per gjentatt tema, person eller team) samler lenker og gir Google en stabil URL å rangere på for gjentatte søk.
Oppdater en pågående sak på samme URL i stedet for å publisere en ny artikkel for hver utvikling, og vis både publiseringsdato og siste oppdatering. Når flere medier i en gruppe viderepubliserer den samme saken, peker en canonical-tag til originalen og unngår konkurrerende duplikater.
Uendelige kombinasjoner av tagger, interne søkesider, kalenderarkiver og sporingsparametere svekker crawlingen. Blokker eller sett noindex på det som ikke har søkeverdi, og gå gjennom tynne tagsider (en tagg med to artikler hjelper ingen).
Tips
Sjekk rapporten Crawl-statistikk i Search Console etter en stor nyhetsdag. Hvis gjennomsnittlig svartid stiger, bremser Googlebot ned, og de ferske sakene dine venter i kø bak arkivsider.
Tre typer markup gjør mesteparten av jobben for medier.
datePublished, dateModified og author med lenke til forfattersiden. Det hjelper Google med å vise riktig dato og tilskrive saken riktig.isAccessibleForFree til false og peke hasPart til den låste delen med en cssSelector. Dette lar Googlebot lese hele teksten, mens Google skiller betalingsmuren din fra cloaking, som bryter med retningslinjene for spam.Strukturerte data får ikke en artikkel til å rangere av seg selv, men de fjerner tvetydighet om hvem som skrev hva og når, for Google og for språkmodellene som leser sidene dine. Guiden vår om strukturerte data for KI-søk forklarer hvilke egenskaper KI-systemene faktisk bruker.
Discover er en stor trafikkilde for mange nyhets- og livsstilsmedier, og samtidig den mest ustabile. Googles dokumentasjon for Discover (oppdatert mars 2026) setter tydelige vilkår:
max-image-preview:large;Rapporten for Discover i Search Console viser klikk, visninger og CTR over 16 måneder når en minimumsterskel er nådd, og den inkluderer trafikk fra Chrome. Vår egen guide til optimalisering for Google Discover går dypere inn i tester av bilder og titler.
Vær oppmerksom
Sensasjonelle overskrifter kan løfte klikkene i Discover en uke, for så å kutte rekkevidden din. Google lister eksplisitt opp villedende titler og taktikker som utnytter harme eller nysgjerrighet som grunner til å vise mindre av et nettsteds innhold.
Tillit bygges side for side og for hele nettstedet.
Seksjoner for monetarisering krever også forsiktighet. Googles retningslinjer for spam definerer misbruk av nettstedets omdømme som tredjepartsinnhold publisert hovedsakelig for å dra nytte av vertens rangeringssignaler. Kupong-, produktanmeldelses- eller sponsede seksjoner drevet av eksterne partnere uten redaksjonell integrering eksponerer hele domenet, mens en redaksjonelt kuratert og tydelig merket seksjon ikke er målrettet.
Aktuelle nyheter gir topper, evergreen-innhold gir et gulv. Et sunt medie planlegger begge deler.
AI Overviews, ChatGPT, Perplexity og Gemini oppsummerer nyhetene og svarer direkte på faktaspørsmål, noe som reduserer klikk på mange informasjonssøk (se Google AI Overviews). Mediene må nå ta tre valg.
Robots.txt lar deg tillate eller blokkere hver KI-crawler separat: GPTBot for trening hos OpenAI, OAI-SearchBot for søk i ChatGPT, PerplexityBot, ClaudeBot og andre. Google-Extended er et eget token som styrer bruken av innholdet ditt til trening og forankring av Gemini; Google sier at det ikke påvirker innkludering eller rangering i Google Search. Å blokkere søkeorienterte boter fjerner deg fra svarene deres, så mange medier blokkerer treningsbotene og tillater søkebotene. Guiden vår om robots.txt for KI-crawlere lister user agents.
Store KI-selskaper har signert innholdsavtaler med medier (OpenAI med Associated Press og Axel Springer, for eksempel), og nye modeller med betaling per crawl dukker opp. Lisensiering for medier er like mye en forretningsbeslutning som en SEO-beslutning: en avtale kan gi inntekt og tilskrivning, mens en generell blokkering beskytter eksklusiviteten på bekostning av synlighet.
KI-assistenter siterer kilder som sier fakta tydelig, tidlig i teksten, med datoer og navngitte kilder. Originale data, eksklusive sitater og godt strukturerte forklaringer siteres oftere enn omskrevne nyhetsbyråer. Vår studie av KI-sitering av medier viser hvilke medier KI-assistenter siterer oftest.
Del rapporteringen etter flate og innholdstype: aktuelle nyheter, evergreen og temasider. Følg i Search Console rapportene for Web, Discover og Google News hver for seg, forsinkelsen i indeksering av nye artikler (tiden mellom publisering og første visninger), og andelen trafikk fra evergreen-sider. For KI-synlighet følger du en fast liste med spørsmål om temaene dine og sjekker om mediet ditt siteres, og hvilken konkurrent som siteres i stedet.

Sorank samler disse signalene: dashbordet for GEO og SEO følger klikk, visninger og posisjoner fra Search Console, og sporing av KI-omtaler sjekker hver måned om ChatGPT, Claude og Gemini siterer mediet ditt på spørsmålene leserne dine stiller. Programvaren skriver og publiserer også evergreen-artikler i autopilot, noe som passer til forklaringssiden i en redaksjon, mer enn til aktuelle nyheter.
SEO for medier betyr nå å bli funnet raskt på Google og å være kilden KI-assistentene siterer. Rett opp indeksering og tillit først, beskytt evergreen-trafikken, og bestem deretter KI-crawler- og lisensieringspolitikken sammen med forretningssiden. For å følge både Google- og KI-synlighet samlet, se Sorank-abonnementene, med 3-dagers gratis prøveperiode.

Nei. Google finner nyhetssider gjennom vanlig crawling, og vurderer dem automatisk for Top Stories, fanen Nyheter og appen Google News hvis de publiserer innhold av høy kvalitet og følger retningslinjene for innhold i Google News. Publisher Center er valgfritt og hjelper deg med å administrere utgiverens navn, logo og seksjoner.
Det avhenger av forretningsmodellen. Å blokkere treningscrawlere som GPTBot beskytter innholdet mot modelltrening, mens å blokkere søkecrawlere som OAI-SearchBot eller PerplexityBot fjerner nettstedet fra disse assistentenes svar og siteringer. Mange medier blokkerer treningsbotene, tillater søkebotene og forhandler om lisensiering separat.
Godt lenkede artikler på etablerte nyhetssider blir ofte crawlet og indeksert i løpet av minutter, mens nye eller trege sider kan vente i timer eller dager. Å lenke nye saker fra forsiden og seksjonssidene, liste dem i et nyhetssitemap og holde svartidene på serveren lave, forkorter forsinkelsen.
Vi analyserer konkurrentene dine, nettstedet ditt og synligheten din i AI for å lage en skreddersydd innholdsplan, gratis.
 KI-generator for innholdsbrief
 Generator for FAQ-schema
 Generator for blogg-ideer med AI
 Validator for strukturerte data (schema-validator)
 Sjekk av alt-tekst
 Analyse av interne lenker
 Lenkeutfordringen
 KI-generator for metabeskrivelser
 KI-generator for bloggtitler
 Indekserbarhetssjekker for Google
 KI-generator for bloggdisposisjon
 Generator for UTM-lenker
 Verktøy for gruppering av søkeord
 Sjekk av kanonisk tagg
 XML-sitemap-generator
 Sjekk av ødelagte lenker
 KI-generator for SEO-tittel
 Overskriftsanalyse
 SERP-forhåndsvisning
 Kontroll av omdirigeringer
 Generator for hreflang-tagger
 Analyse av overskriftsstruktur
 Kontroll av HTTP-headere
 Favikon-henter
 SERP CTR-kalkulator
 Sparekalkulator: SEO mot betalt søk
 Kalkulator for SEO-synlighetsandel
 ROI-kalkulator for SEO
 SEO-prognosekalkulator for trafikk og inntekter
 SEO-budsjettkalkulator
 SEO-nullpunktkalkulator
 ROI-kalkulator for SaaS-SEO
 ROAS-kalkulator
 Lesetidskalkulator
 Simulator for rangeringsgevinst
 Kalkulator for verdien av organisk trafikk
 Estimator for organisk trafikk og sjekk av nettstedstrafikk
 Kalkulator for LTV til CAC-forhold
 Kalkulator for avkastning på lokal SEO
 Kalkulator for kostnad ved lenkebygging
 Kalkulator for søkeordverdi
 Kalkulator for poengsum for søkeordmuligheter
 Kalkulator for tetthet av søkeord
 Kalkulator for GEO-avkastning
 Kalkulator for investering i GEO-innhold
 Kalkulator for SEO-avkastning i netthandel
 Kalkulator for kundens levetidsverdi
 Kalkulator for kundeanskaffelseskostnad
 CTR-kalkulator
 Kalkulator for kostnad per artikkel
 Kalkulator for konverteringsrate
 Kalkulator for ROI i innholdsmarkedsføring
 Estimator for ChatGPT-trafikk
 Kalkulator for avvisningsrate
 Kalkulator for backlink-ROI
 Kalkulator for AI-synlighetspoeng
 Kalkulator for verdien av AI-trafikk
 Kalkulator for AI-synlighetsandel
 Kalkulator for kostnaden av AI-usynlighet
 Kalkulator for AI-siteringsrate
 llms.txt-validator
 AI Overview-sjekker og rangeringssjekker for AI Overviews
 Robots.txt-sjekker
 KI-SEO-revisjon
 Sjekk av lesbarhet for LLM
 Sjekk av klargjøring for SearchGPT
 Revisjon av strukturerte data for LLM
 KI-revisjon av crawlbarhet
 Hvorfor ChatGPT ikke anbefaler nettstedet mitt
 Gemini-rangeringsverktøy
 Sjekk av rangering i Perplexity
 Sjekk av LLM-sitater
 AEO-revisjon
 GEO-revisjon
 Test av synlighet i AI-søk
 Sjekk av synlighet i ChatGPT
 llms.txt-generator
 URL-uttrekker
 Nettside til Markdown
 Sjekk av sitemap
 Sensor for SERP-volatilitet
 Sidestørrelsessjekk
 Ordteller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Generator for metatagger
 Bildekomprimerer
 Favicon-generator
 Revisjon av on-page SEO: SEO-sjekk og SEO-analyse
 Verktøy for analyse av tilbakelenker
 Verktøy for søkeordforslag
 Sjekk av domeneautoritet
DE PRØVDE SORANK FØR DEG
 “Jeg testet Sorank på et ekte kundenettsted, og det er helt utrolig. Det gjør alt et byrå ville tatt deg $1500 i måneden for. Nå går det i produksjon på den kunden.”

 Guillaume Guersanguersanguillaume.com“Vi er et annonsebyrå, og vi ville få SEO-en vår på rett spor en gang for alle. Sorank ga oss en tydelig oversikt over nettstedet vårt, hjalp oss å prioritere optimaliseringene og å strukturere innholdet vårt på riktig måte. Verktøyet er enkelt å bruke, godt utformet for et team, og veldig praktisk for å samle oppfølgingen på ett sted uten å jonglere med flere plattformer. Et veldig solid grunnlag for å starte på nytt med SEO.”
 Gaspard MadouiAnnonsebyrå
 “Jeg lot bare Sorank-programvaren gjøre jobben sin, og nå er DR-en min 25, og siden min rangerer høyere.”
 Lucas Flandrefoundertrace.fr“Jeg spesialiserte meg på GEO takket være Sorank. GEO-rangeringen lar meg vise kundene mine hvor de står mot konkurrentene på ChatGPT. Det er en reell kommersiell fordel.”
 MélanieSEO-frilanser“Kjempebra service, den fungerer godt for nettstedet vårt og hjelper oss å forstå hvordan vi kan forbedre det for å rangere bedre på Google og andre steder. Gratulerer, fortsett slik, jeg anbefaler det.”
 Hugo T.Netthandler