A magánszféra fontos számunkra, ezért lehetőséged van kikapcsolni bizonyos típusú tárolókat, amelyekre a weboldal alapvető működéséhez nincs szükség. A kategóriák letiltása befolyásolhatja a weboldal használatának élményét. További információ (Sütikezelési szabályzat)
Kiadói SEO: Google News, Discover és AI-válaszok hír- és médiaoldalaknak
Kiadói SEO útmutató: Top Stories, Discover, hírtérképek, cikk- és fizetősfal-jelölés, valamint hogyan maradj AI-idézetekben, és hogyan dönts a licencelésről.
A „Publisher SEO” cikk borítója, a cím mellett a Sorank szoftver képernyőképével
Eszközök
Ezen az oldalon
Röviden
a kiadói SEO azoknak a gyakorlatoknak az összessége, amelyek segítenek a hír- és médiaoldalaknak forgalmat szerezni a Google Keresésből, a Top Stories-ból, a Google News-ból, a Discover-ből, és mostantól az AI-asszisztensekből. Négy pillérre épül: a friss cikkek gyors indexelésére (hírtérkép, tiszta URL-ek, belső linkek), a bizalmi jelekre (szerzőjelölés, dátumok, helyesbítések, szerzőoldalak), a technikai jelölésre (Article, fizetősfal- és képkövetelmények), valamint egy tudatos AI-robotpolitikára és a licencelési döntésekre. Az örökzöld tartalom és a közvetlen közönségcsatornák védik az üzletet, amikor a keresőkből érkező látogatók száma csökken.
3 nap ingyen, utána bármikor leállhatsz. 90 napos eredménygarancia visszatérítéssel.
A kiadói SEO másképp működik, mint a klasszikus SEO, mert egy hírportál naponta több tucat vagy száz oldalt publikál, amelyek többsége 48 órán belül elveszíti értékét, az örökzöld archívum viszont évekig hoz látogatókat. A tét nőtt: a Reuters Intézet „Journalism, Media and Technology Trends and Predictions 2026” jelentése (2026. január) a Chartbeat adataira hivatkozva azt írja, hogy a több mint 2500 hírportálra érkező Google-keresési forgalom 33%-kal esett egy évvel korábbihoz képest 2024 novembere és 2025 novembere között, a felmért 280 médiavezető pedig további 43%-os csökkenést vár a keresőkből érkező látogatókban három év alatt. A jó optimalizálás ma azt jelenti, hogy megtartod a megmaradt forgalmat, és ott idéznek, ahová az olvasók a következőnek mennek. Ez az útmutató azt mutatja be, mi változik a kiadó- és médiavállalatoknak, a hírfelületektől az AI-válaszokig.
Mi a kiadói SEO, és miben más?
A kiadói SEO a keresőoptimalizálást olyan oldalakra alkalmazza, amelyeknek a terméke a szerkesztői tartalom: újságok, magazinok, digitális médiumok, szakmai lapok és nagy blogok, amelyek hirdetésből vagy előfizetésekből élnek. Három kényszer különbözteti meg.
Sebesség: egy friss hír az első órákban ér a legtöbbet. A Google-nek percek alatt kell felfedeznie, feltérképeznie és indexelnie, ezért a feltérképezési útvonalak és a térképek többet számítanak, mint egy szórólapszerű oldalon.
Mennyiség: ezer cikk, címkeoldal, szerzőoldal és archívum duplikált és vékony oldalakat hoz létre, amelyek pazarolják a feltérképezési keretet, és kulcsszó-kannibalizációt okoznak ugyanarról a történetről írt több cikk között.
Bizalom: a hírek és a közéleti témák azok, ahol a Google nagy súlyt fektet a megbízhatóságra. A látható szerzők, a forrásmegjelölés és a helyesbítések támogatják az E-E-A-T (tapasztalat, szakértelem, tekintélyesség és bizalom) elveket.
A kiadó olyan felületektől is függ, amelyeket a legtöbb oldal sosem lát: a Top Stories sávjai, a News fül, a Google News alkalmazás és a Discover, egy hírfolyam, amely lekérdezés nélkül juttat el tartalmat a felhasználókhoz.
Mely Google-felületek számítanak a kiadóknak?
Minden felületnek saját kiválasztási logikája van. A táblázat összefoglalja, mi hajtja a láthatóságot, és hol érdemes mérni.
Felület
Hogyan kerül be a tartalom
Fő hatótényezők
Hol mérhető
Keresési találatok (kék linkek)
Szokásos feltérképezés és rangsorolás
Relevancia, mélység, linkek, oldalélmény
Search Console, Keresés típusa: Web
Top Stories
Automatikus, hírintenciójú lekérdezéseknél
Frissesség, témaspecifikus tekintély, eredeti tudósítás
Search Console, Keresési megjelenés szűrői
Google News alkalmazás és News fül
Automatikus, a Google News tartalmi szabályainak hatálya alatt
Nagy képek, őszinte címek, időszerű vagy egyedi történetek
Search Console, Discover jelentés
AI Overviews és AI-asszisztensek
Indexelt vagy feltérképezett oldalakról való visszakeresés
Világos tények, strukturált válaszok, robothozzáférés, márkatekintély
Lekérdezéskövetés, hivatkozási analitika
A Google Publisher Center súgója szerint nincs jelentkezési űrlap: a normál feltérképezéssel talált oldalak automatikusan szóba jönnek a Top Stories-ban és a News fülön, ha minőségi tartalmat közölnek, és betartják a Google News tartalmi irányelveit. A Publisher Center továbbra is hasznos a kiadvány nevének, logójának és rovatainak kezelésére a Google News alkalmazásban.
Hogyan érheti el a cikkeket gyorsan az indexelés?
1. Készíts hírtérképet
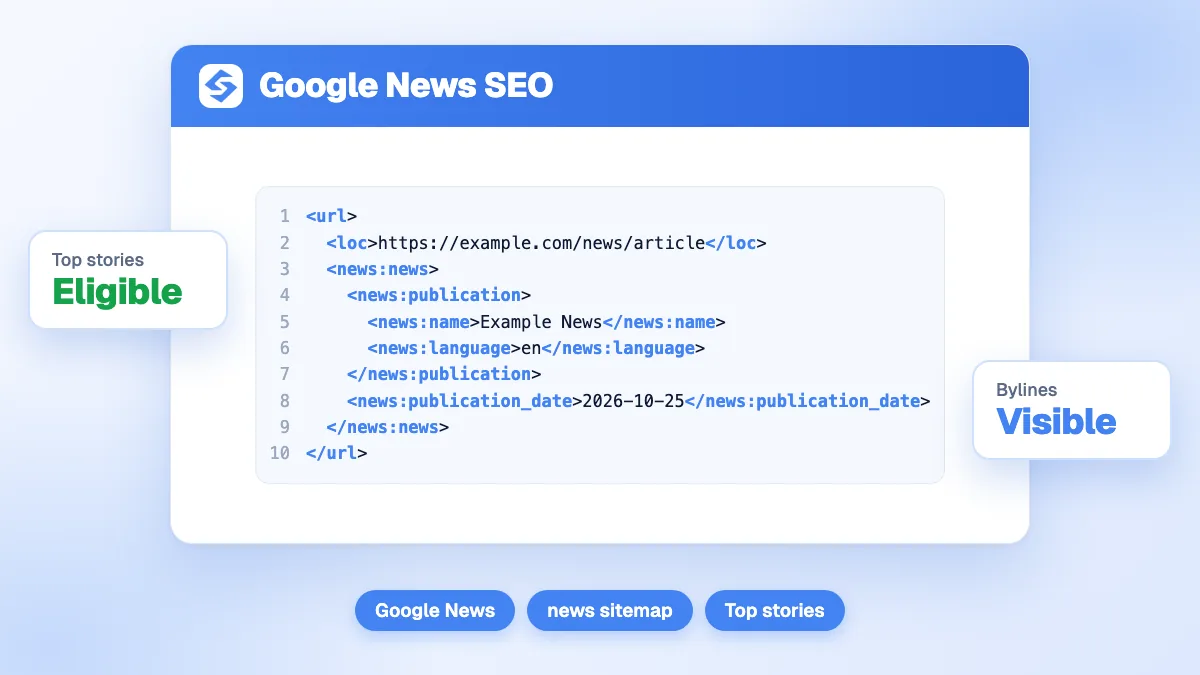
A hírtérkép csak a friss cikkeket sorolja fel. A Google hírtérkép dokumentációja arra kéri a kiadókat, hogy csak az elmúlt két napban létrehozott cikkek URL-jeit tartalmazza, fájlonként legfeljebb 1000 news:news bejegyzéssel, és megköveteli a news:publication (név és nyelv), a news:publication_date és a news:title címkéket. A kiadvány nevének egyeznie kell azzal, amelyet a Google News mutat. Mellette tarts fenn egy szokásos XML-térképet a teljes archívumnak.
2. Linkeld az új híreket a feltérképezett központi oldalakról
A Googlebot gyakran visszatér a főoldalra és a rovatoldalakra. Ha ezekről a központokról és a kapcsolódó élő oldalakról linkeled az összes új hírt, az gyorsabban feltérképeződik, mint bármilyen térképes jelzés. A témaoldalak (egy-egy visszatérő témához, személyhez vagy csapathoz) gyűjtik a linkeket, és a Google-nak stabil URL-t adnak, amelyre visszatérő lekérdezésekre lehet rangsorolni.
3. Egy URL legyen egy történethez
A fejlődő történetet ugyanazon az URL-en frissítsd, ahelyett hogy minden fejleményhez új cikket publikálnál, és mutasd a közzététel dátumát és az utolsó frissítést is. Ha egy csoport több hírportálja ugyanazt az anyagot szindikálja, az eredetire mutató canonical címke elkerüli a versengő duplikátumokat.
4. Kontrolláld a feltérképezési pazarlást
A végtelen címkekombinációk, a belső keresőoldalak, a naptári archívumok és a követőparaméterek hígítják a feltérképezést. Tiltsd le vagy noindex-eld azt, aminek nincs keresési értéke, és vizsgáld át a vékony címkeoldalakat (egy címke két cikkel senkinek sem segít).
Tipp
Egy nagy hírnap után nézd meg a Search Console Feltérképezési statisztika jelentését. Ha az átlagos válaszidő nő, a Googlebot lassít, és a friss hírek az archívumoldalak mögött várakoznak.
Milyen strukturált adatokat használjon egy hírportál?
Három jelölés-típus végzi a munka nagy részét a kiadóknál.
Article vagy NewsArticle: címsor, képek, datePublished, dateModified és a author, a szerzői oldalra mutató linkkel. Segít a Google-nek a helyes dátum megjelenítésében és a történet szerzőjének azonosításában.
Fizetősfal-jelölés: előfizetéses tartalomnál a Google fizetős tartalomra vonatkozó irányelvei arra kérnek, hogy az isAccessibleForFree értékét állítsd hamisra, a hasPart pedig a zárt szakaszra mutasson a cssSelector segítségével. Így a Googlebot el tudja olvasni a teljes szöveget, a Google pedig meg tudja különböztetni a fizetősfalat az álcázástól (cloaking), amely sérti a spamszabályait.
Organization és Person: a kiadó azonossága, logója, közösségimédia-profiljai és a szerzői profilok, amelyek a tartalmadat ismert entitásokhoz kötik.
A strukturált adatok önmagukban nem emelnek egy cikket a rangsorban, de megszüntetik a kétértelműséget arról, ki írt mit és mikor, a Google és az oldalaidat feldolgozó nyelvi modellek számára egyaránt. A strukturált adatokról az AI-keresésben szóló útmutatónk elmagyarázza, mely tulajdonságokat használják ténylegesen az AI-rendszerek.
Hogyan szerezhetsz forgalmat a Google Discover-ből?
A Discover sok hír- és életmódportál számára jelentős forrás, egyben a legingatagabb is. A Google Discover-dokumentációja (2026. márciusi frissítés) egyértelmű feltételeket szab:
használj nagy képeket, legalább 1200 px szélesen, 300000 képpontnál nagyobb területtel, 16x9 arányban, a max-image-preview:large robots-beállítással engedélyezve;
kerüld a logókat és a szövegdús képeket fő vizuálisként;
írj olyan címeket, amelyek megragadják a történet lényegét, és kerüld a kattintásvadászatot, a túlzást vagy az információ visszatartását;
publikálj időszerű történeteket, eredeti szögeket és jó oldalélményt.
A Search Console Discover jelentése bizonyos minimumküszöb elérése után 16 hónapra visszamenőleg mutatja a kattintásokat, megjelenéseket és CTR-t, és a Chrome-ból érkező forgalmat is tartalmazza. A Google Discover optimalizálásáról szóló külön útmutatónk részletesebben foglalkozik a kép- és címtesztekkel.
Figyelem
A szenzációhajhász címek egy hétig növelhetik a Discover-kattintásokat, aztán csökkenthetik az elérést. A Google kifejezetten felsorolja a félrevezető címeket és a dühre vagy kíváncsiságra építő taktikákat azok közé az okok közé, amelyek miatt kevesebb tartalmat mutat egy oldalból.
Mitől megbízható egy kiadó a Google szemében?
A bizalom oldalanként és az egész oldalon keresztül épül.
Szerzőjelölések és szerzőoldalak valódi életrajzzal, szakértelemmel, elérhetőséggel és a szerző munkáira mutató linkekkel.
Dátumok a címsor közelében láthatóan, összhangban a jelöléssel és a térképpel.
Szerkesztői átláthatóság: egy rólunk oldal, tulajdonosi viszonyok, szerkesztési irányelvek, helyesbítési szabályzat és lehetőség a szerkesztőséggel való kapcsolatfelvételre.
Eredeti tudósítás az átírt ügynökségi szöveg helyett: a Top Stories inkább azt a hírportált részesíti előnyben, amely megtörte vagy kiegészítette a történetet.
Tiszta monetizáció: a hirdetéssűrűség, amely a Core Web Vitals mutatókat zöld tartományban tartja, és a követőszkriptek aszinkron módon töltődnek.
A monetizációs szakaszokra is figyelni kell. A Google spamszabályai a webhely-hírnév visszaélését olyan harmadik féltől származó tartalomként határozzák meg, amelyet elsősorban a házigazda rangsorolási jeleinek kihasználására tesznek közzé. A külső partnerek által, szerkesztői integráció nélkül futtatott kupon-, termékteszt- vagy szponzorált szakaszok az egész domaint kitehetik, míg a szerkesztőileg válogatott és egyértelműen jelölt szakasz nem kerül célkeresztbe.
Hogyan egyensúlyozd a friss híreket és az örökzöld tartalmat?
A friss hírek csúcsokat hoznak, az örökzöld tartalom alapot. Az egészséges kiadó mindkettőt tervezi.
Magyarázók és útmutatók („mi az”, „hogyan”, idővonalak, szószedetek), amelyek a visszatérő hírek mögötti stabil kérdésekre válaszolnak. Lásd az örökzöld tartalomról szóló útmutatónkat.
Témaközpontok, amelyek összekötik a legfrissebb híreket a háttérelemzésekkel.
Rendszeres frissítések a nagy forgalmú archívumoldalakon: frissítsd a tényeket, dátumokat és linkeket ahelyett, hogy egy szinte azonos cikket publikálnál. A tartalomfrissítés módszerünk közvetlenül alkalmazható a hírarchívumokra.
Kulcsszókutatás a visszatérő eseményekre (választások, költségvetések, szezonok, termékbevezetések), hogy a magyarázó már a csúcs előtt létezzen.
Hogyan változtatják meg az AI-válaszok a kiadói SEO-t?
Az AI Overviews, a ChatGPT, a Perplexity és a Gemini összefoglalják a híreket, és közvetlenül válaszolnak a tényszerű kérdésekre, ami sok tájékoztató lekérdezésnél csökkenti a kattintásokat (lásd Google AI Overviews). A kiadóknak mostantól három döntést kell hozniuk.
Robothozzáférés
A robots.txt lehetővé teszi, hogy minden AI-robotot külön engedélyezz vagy tiltson: GPTBot az OpenAI tanításához, OAI-SearchBot a ChatGPT kereséséhez, PerplexityBot, ClaudeBot és mások. A Google-Extended külön token, amely azt szabályozza, hogy a tartalmadat a Gemini tanítására és megalapozására használják-e; a Google szerint ez nem befolyásolja a Google Keresésben való szerepelést vagy rangsorolást. A keresési célú robotok tiltása kivesz a válaszaikból, ezért sok kiadó a tanító robotokat tiltja, a keresőrobotokat pedig engedélyezi. A robots.txt-ről AI-robotokhoz szóló útmutatónk felsorolja a felhasználói ügynököket.
Licencelés
Nagy AI-cégek szerződtek már tartalmi megállapodást kiadókkal (például az OpenAI az Associated Pressszel és az Axel Springerrel), és megjelennek a letöltésenkénti fizetéses modellek is. A kiadói licencelés ugyanannyira üzleti döntés, mint SEO-kérdés: egy szerződés bevételt és hivatkozást hozhat, míg a teljes tiltás a láthatóság árán védi a kizárólagosságot.
Idézhetőség
Az AI-asszisztensek azokat a forrásokat idézik, amelyek világosan, a tetején, dátumokkal és megnevezett forrásokkal közlik a tényeket. Az eredeti adatok, az exkluzív idézetek és a jól strukturált magyarázók gyakrabban kerülnek idézésre, mint az átírt hírügynökségi anyagok. Az AI-idézési tanulmányunk a médiáról megmutatja, mely hírportálokat idézik leggyakrabban az AI-asszisztensek.
Hogyan mérd a kiadói SEO-t?
Bontsd a jelentéseket felület és tartalomtípus szerint: friss hírek, örökzöld tartalom, témaközpontok. A Search Console-ban külön kövesd a Web, a Discover és a Google News jelentést, az új cikkek indexelési késését (a közzététel és az első megjelenés közötti időt), valamint az örökzöld oldalakról érkező forgalom arányát. Az AI-láthatósághoz kövess egy rögzített kérdéslistát a témáidról, és nézd meg, hogy a kiadványodat idézik-e, és helyette melyik versenytárs szerepel.
A Sorank összefogja ezeket a jelzéseket: a GEO- és SEO-irányítópult követi a Search Console kattintásait, megjelenéseit és pozícióit, az AI-említéskövetés pedig havonta ellenőrzi, hogy a ChatGPT, a Claude és a Gemini idézi-e a kiadványodat az olvasóid kérdéseire. A szoftver autopilot módban írja és publikálja az örökzöld cikkeket is, ami a szerkesztőség magyarázó oldalához illik, nem a friss hírekhez.
A kiadói SEO ma azt jelenti, hogy a Google-on gyorsan megtalálnak, és te vagy a forrás, amelyet az AI-asszisztensek idéznek. Először az indexelést és a bizalmat javítsd, védd az örökzöld forgalmat, majd döntsd el a robot- és licencelési politikát az üzleti csapattal együtt. Ha a Google- és az AI-láthatóságot egy helyen akarod követni, lásd a Sorank csomagjait, 3 napos ingyenes próbaidőszakkal.
Gyakran ismételt kérdések
Kell jelentkezni, hogy megjelenjek a Google News-ban?
Nem. A Google a normál feltérképezéssel találja meg a hírportálokat, és automatikusan szóba veszi őket a Top Stories, a News fül és a Google News alkalmazás számára, ha minőségi tartalmat közölnek, és betartják a Google News tartalmi irányelveit. A Publisher Center opcionális, és a kiadvány neve, logója és rovatai kezelésében segít.
Tiltania kell egy hírportálnak az AI-robotokat?
Ez az üzleti modelltől függ. A tanító robotok, például a GPTBot tiltása védi a tartalmat a modelltanítástól, míg a keresőrobotok, például az OAI-SearchBot vagy a PerplexityBot tiltása kiveszi az oldalt az asszisztensek válaszaiból és hivatkozásaiból. Sok kiadó tiltja a tanító robotokat, engedélyezi a keresőrobotokat, és a licencelésről külön tárgyal.
Mennyi idő alatt indexeli a Google a hírcikket?
A jól belinkelt cikkeket megbízható hírportálokon gyakran percek alatt feltérképezik és indexelik, míg az új vagy lassú oldalaknak órákat vagy napokat kell várniuk. Ha az új híreket a főoldalról és a rovatoldalakról linkeled, hírtérképen felsorolod őket, és alacsonyan tartod a szerver válaszidejét, rövidül a késés.
y!
Ingyenes SEO- és GEO-audit
Kérd ingyen a 30 napos tartalomtervedet
Elemezzük a versenytársaidat, a weboldalad és az AI-láthatóságodat, hogy ingyen készítsünk neked testre szabott tartalomtervet.
“Teszteltem a Sorankot egy valódi ügyfél oldalán, és őrület. Mindent megtesz, amiért egy ügynökség $1500-t kérne havonta. Most ennél az ügyfélnél már éles üzemben van.”Guillaume Guersanguersanguillaume.com
“Egy hirdetési ügynökség vagyunk, és végre rendbe akartuk tenni a SEO-nkat. A Sorank tiszta képet adott az oldalunkról, segített sorrendbe állítani az optimalizálásokat, és segített rendesen felépíteni a tartalmainkat. Az eszköz könnyen kezelhető, csapatra jól szabott, és nagyon praktikus, hogy több platform közötti ugrálás nélkül egy helyen követhetjük a munkát. Nagyon szilárd alap ahhoz, hogy újrakezdjük a SEO-nkat.”Gaspard MadouiHirdetési ügynökség
“A Soranknak köszönhetően GEO-szakértő lettem. A GEO-ranglista segítségével megmutathatom az ügyfeleimnek, hol állnak a versenytársakhoz képest a ChatGPT-ben. Ez valódi kereskedelmi előny.”MélanieSEO szabadúszó
“Remek szolgáltatás, jól működik a weboldalunkon, és segít megérteni, hogyan lehet javítani, hogy jobban szerepeljünk a Google-on és másutt. Gratulálok, így tovább, ajánlom.”Hugo T.E-kereskedelmi kereskedő