A privacidade é importante para nós, então você tem a opção de desativar certos tipos de armazenamento que podem não ser necessários para o funcionamento básico do site. O bloqueio de categorias pode afetar sua experiência no site. Mais informações (Política de cookies)
Capa do artigo “SEO para editoras”, com uma captura de tela do software Sorank ao lado do título
Ferramentas
Nesta página
Em resumo
O SEO para editoras é o conjunto de práticas que ajudam sites de notícias e de mídia a ganhar tráfego da busca do Google, de Top Stories, do Google Notícias, do Discover e, agora, de assistentes de IA. Ele se apoia em quatro pilares: indexação rápida de artigos novos (sitemap de notícias, URLs limpas, links internos), sinais de confiança (assinaturas, datas, correções, páginas de autor), marcação técnica (Article, requisitos de paywall e de imagens) e uma política deliberada para rastreadores de IA e licenciamento. Conteúdos perenes e canais de audiência direta protegem o negócio quando as visitas vindas de buscadores caem.
3 dias grátis, depois você para quando quiser. Garantia de resultados ou reembolso de 90 dias.
O SEO para editoras se diferencia do SEO clássico porque um site de notícias publica dezenas ou centenas de páginas por dia, a maioria das quais perde valor em 48 horas, enquanto o arquivo perene continua trazendo visitas por anos. A aposta cresceu: o relatório Journalism, Media and Technology Trends and Predictions 2026 do Reuters Institute (janeiro de 2026) cita dados da Chartbeat segundo os quais o tráfego de busca do Google para mais de 2500 sites de notícias caiu 33% em um ano, entre novembro de 2024 e novembro de 2025. Os 280 líderes de mídia ouvidos esperam mais uma queda de 43% nas referências vindas de buscadores em três anos. Otimizar bem hoje significa manter o tráfego que resta e ser citado para onde os leitores vão depois. Este guia mostra o que muda para as empresas de publicação e mídia, das superfícies de notícias às respostas de IA.
O que é SEO para editoras e em que ele difere?
O SEO para editoras aplica a otimização para buscadores a sites cujo produto é o conteúdo editorial: jornais, revistas, veículos nativos digitais, publicações especializadas e grandes blogs que vivem de publicidade ou assinaturas. Três restrições o distinguem.
Velocidade: uma notícia de última hora vale mais nas primeiras horas. O Google precisa descobri-la, rastreá-la e indexá-la em minutos, por isso caminhos de rastreamento e sitemaps pesam mais do que em um site institucional.
Volume: milhares de artigos, páginas de tags, páginas de autor e arquivos criam páginas duplicadas ou fracas que desperdiçam o orçamento de rastreamento e provocam canibalização de palavras-chave entre vários artigos sobre o mesmo assunto.
Confiança: notícias e temas de interesse público são áreas em que o Google dá muito peso à confiabilidade. Autores visíveis, fontes claras e correções sustentam a E-E-A-T (experiência, especialização, autoridade e confiança).
Uma editora também depende de superfícies que a maioria dos sites nunca vê: os carrosséis de Top Stories, a aba Notícias, o app Google Notícias e o Discover, um feed que entrega conteúdos aos usuários sem nenhuma busca.
Quais superfícies do Google importam para as editoras?
Cada superfície tem sua própria lógica de seleção. A tabela resume o que impulsiona a visibilidade e onde medi-la.
Superfície
Como o conteúdo entra
Principais alavancas
Onde medir
Resultados de busca (links azuis)
Rastreamento e ranqueamento padrão
Relevância, profundidade, links, experiência da página
Search Console, tipo de pesquisa: Web
Top Stories
Automático, para consultas com intenção de notícia
Frescor, autoridade sobre o tema, reportagem original
Search Console, filtros de aparência da pesquisa
App Google Notícias e aba Notícias
Automático, sujeito às políticas de conteúdo do Google Notícias
Transparência, datas, assinaturas, conformidade com as políticas
Search Console, relatório do Google Notícias
Discover
Automático, com base nos interesses do usuário
Imagens grandes, títulos honestos, histórias oportunas ou inéditas
Search Console, relatório do Discover
Visões gerais de IA e assistentes de IA
Recuperação de páginas indexadas ou rastreadas
Fatos claros, respostas estruturadas, acesso dos rastreadores, autoridade da marca
Monitoramento de prompts, analytics de referências
O Google afirma em sua central de ajuda para editores que não há formulário de candidatura: sites encontrados pelo rastreamento normal são considerados automaticamente para Top Stories e para a aba Notícias se produzem conteúdo de qualidade e seguem as políticas de conteúdo do Google Notícias. O Publisher Center continua útil para gerenciar o nome da publicação, o logotipo e as seções no app Google Notícias.
Como fazer os artigos serem indexados rápido?
1. Publique um sitemap de notícias
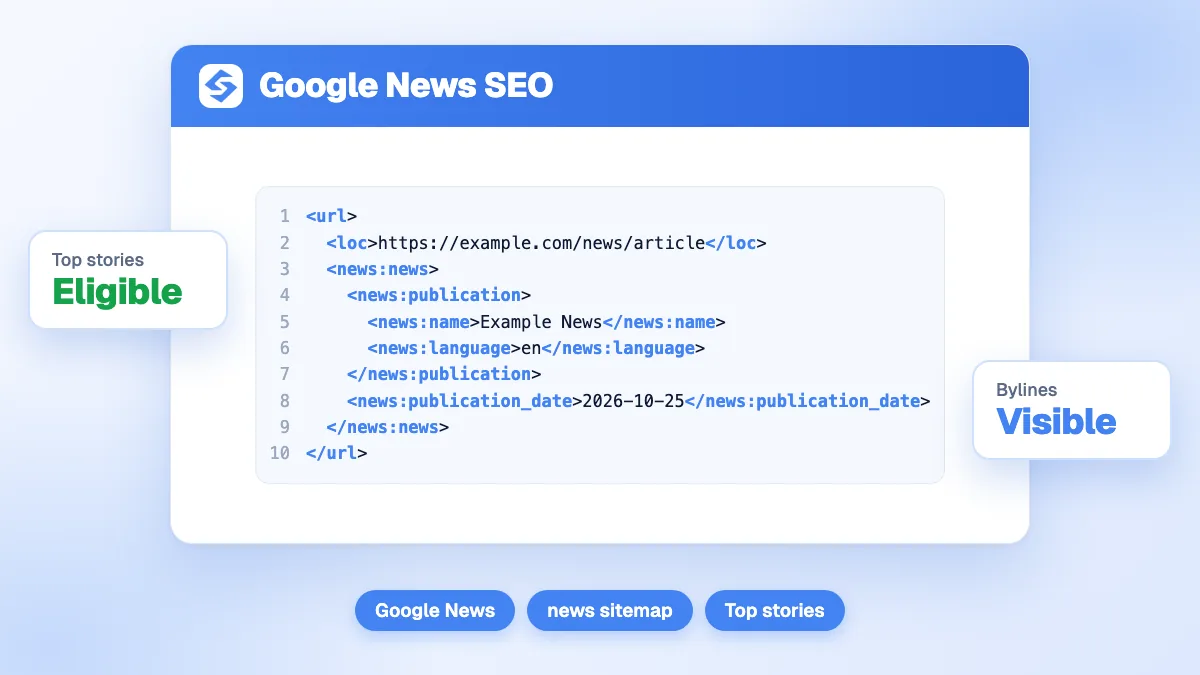
Um sitemap de notícias lista apenas artigos recentes. A documentação do Google sobre sitemaps de notícias pede que você inclua apenas URLs de artigos criados nos últimos dois dias, até 1000 entradas news:news por arquivo, e exige as tags news:publication (nome e idioma), news:publication_date e news:title. O nome da publicação precisa coincidir com o exibido no Google Notícias. Mantenha ao lado um sitemap XML comum para todo o arquivo.
2. Linke as notícias novas a partir de hubs rastreados
O Googlebot visita com frequência a página inicial e as páginas de seção. Linkar cada notícia nova a partir desses hubs e de páginas ativas relacionadas faz com que ela seja rastreada mais rápido do que qualquer aviso de sitemap. As páginas de tema (uma para cada assunto recorrente, pessoa ou equipe) reúnem links e dão ao Google uma URL estável para ranquear nas buscas que se repetem.
3. Mantenha uma URL por história
Atualize uma história em andamento na mesma URL, em vez de publicar um artigo novo para cada desdobramento, e mostre tanto a data de publicação quanto a da última atualização. Quando vários veículos de um grupo republicam o mesmo texto, uma tag canonical apontando para o original evita duplicatas concorrentes.
4. Controle o desperdício de rastreamento
Combinações infinitas de tags, páginas de busca interna, arquivos de calendário e parâmetros de rastreamento diluem o rastreamento. Bloqueie ou marque com noindex o que não tem valor de busca, e audite páginas de tags fracas (uma tag com dois artigos não ajuda ninguém).
Dica
Confira o relatório Estatísticas de rastreamento no Search Console depois de um grande dia de notícias. Se o tempo médio de resposta subir, o Googlebot desacelera, e suas histórias novas esperam na fila atrás das páginas de arquivo.
Quais dados estruturados um site de notícias deve usar?
Três tipos de marcação fazem a maior parte do trabalho para as editoras.
Article ou NewsArticle: título, imagens, datePublished, dateModified e author com um link para a página do autor. Ajuda o Google a mostrar a data certa e a atribuir a matéria.
Marcação de paywall: para conteúdo por assinatura, as diretrizes do Google sobre conteúdo pago pedem que você defina isAccessibleForFree como false e aponte hasPart para a seção restrita com um cssSelector. Assim o Googlebot consegue ler o texto completo, e o Google distingue seu paywall do cloaking, que viola suas políticas de spam.
Organization e Person: identidade da publicação, logotipo, perfis em redes sociais e perfis de autores, que ligam seu conteúdo a entidades conhecidas.
Os dados estruturados não fazem um artigo ranquear sozinho, mas eliminam a ambiguidade sobre quem escreveu o quê e quando, para o Google e para os modelos de linguagem que leem suas páginas. Nosso guia sobre dados estruturados para a busca com IA explica quais propriedades os sistemas de IA realmente usam.
Como ganhar tráfego do Google Discover?
O Discover é uma fonte importante de tráfego para muitas editoras de notícias e de estilo de vida, e também a mais volátil. A documentação do Discover do Google (atualizada em março de 2026) define condições claras:
use imagens grandes com pelo menos 1200 px de largura, acima de 300.000 pixels, na proporção 16x9, ativadas com a configuração de robots max-image-preview:large;
evite logotipos e imagens com muito texto como visual principal;
escreva títulos que capturem a essência da história e evite clickbait, exagero ou informação retida;
publique histórias oportunas, ângulos originais e uma boa experiência de página.
O relatório do Discover no Search Console mostra cliques, impressões e CTR por 16 meses, assim que um limite mínimo é atingido, e inclui o tráfego do Chrome. Nosso guia dedicado à otimização para o Google Discover aprofunda os testes de imagem e de título.
Cuidado
Títulos sensacionalistas podem elevar os cliques do Discover por uma semana e depois reduzir seu alcance. O Google cita explicitamente títulos enganosos e táticas que exploram indignação ou curiosidade como motivos para mostrar menos o conteúdo de um site.
O que torna uma editora confiável para o Google?
A confiança se constrói página por página e em todo o site.
Assinaturas e páginas de autor com biografias reais, especialidades, dados de contato e links para os trabalhos de cada autor.
Datas visíveis perto do título, coerentes com a marcação e o sitemap.
Transparência editorial: uma página sobre a publicação, a propriedade, uma política editorial, uma política de correções e uma forma de contatar a redação.
Reportagem própria em vez de textos de agência reescritos: o Top Stories tende a favorecer o veículo que revelou ou ampliou a história.
Monetização limpa: uma densidade de anúncios que mantém os Core Web Vitals no verde, e scripts de rastreamento carregados de forma assíncrona.
As seções monetizadas também pedem cuidado. As políticas de spam do Google definem o abuso de reputação do site como a publicação de conteúdo de terceiros principalmente para aproveitar os sinais de ranqueamento do domínio hospedeiro. Seções de cupons, avaliações de produtos ou conteúdo patrocinado administradas por parceiros externos, sem integração editorial, expõem o domínio inteiro, enquanto uma seção curada pela redação e claramente identificada não é alvo.
Como equilibrar notícias de última hora e conteúdo perene?
Notícias de última hora trazem picos, o conteúdo perene traz uma base. Uma editora saudável planeja os dois.
Explicações e guias («o que é», «como», linhas do tempo, glossários) que respondem às perguntas estáveis por trás de notícias recorrentes. Veja nosso guia sobre conteúdo perene.
Hubs de tema que ligam as notícias mais recentes a textos de contexto.
Atualizações regulares das páginas de arquivo mais acessadas: atualize fatos, datas e links em vez de publicar um quase duplicado. Nosso método de atualização de conteúdo se aplica diretamente aos arquivos de notícias.
Pesquisa de palavras-chave sobre eventos recorrentes (eleições, orçamentos, temporadas esportivas, lançamentos de produtos), para que a explicação exista antes do pico.
Como as respostas de IA mudam o SEO para editoras?
As visões gerais de IA, o ChatGPT, o Perplexity e o Gemini resumem as notícias e respondem perguntas factuais diretamente, o que reduz os cliques em muitas consultas informativas (veja Google AI Overviews). Hoje as editoras tomam três decisões.
Acesso dos rastreadores
O robots.txt permite autorizar ou bloquear cada rastreador de IA separadamente: GPTBot para o treinamento da OpenAI, OAI-SearchBot para a busca do ChatGPT, PerplexityBot, ClaudeBot e outros. O Google-Extended é um token à parte que controla o uso do seu conteúdo para o treinamento e a ancoragem do Gemini; o Google afirma que ele não afeta a inclusão nem o ranqueamento na Busca Google. Bloquear os rastreadores voltados à busca tira você das respostas deles, por isso muitas editoras bloqueiam os rastreadores de treinamento e autorizam os de busca. Nosso guia sobre o robots.txt para rastreadores de IA lista os user agents.
Licenciamento
Grandes empresas de IA firmaram acordos de conteúdo com editoras (a OpenAI com a Associated Press e a Axel Springer, por exemplo), e surgem modelos de pagamento por rastreamento. O licenciamento de conteúdo é uma decisão de negócio tanto quanto de SEO: um acordo pode trazer receita e atribuição, enquanto um bloqueio geral protege a exclusividade ao custo da visibilidade.
Citabilidade
Assistentes de IA citam fontes que expõem fatos com clareza, no início do texto, com datas e fontes nomeadas. Dados originais, citações exclusivas e explicações bem estruturadas são citados com mais frequência do que notas de agência reescritas. Nosso estudo sobre a citação de veículos de mídia pela IA mostra quais veículos os assistentes de IA mais citam.
Como medir o SEO para editoras?
Separe os relatórios por superfície e por tipo de conteúdo: notícias de última hora, perene, hubs de tema. No Search Console, acompanhe em separado os relatórios Web, Discover e Google Notícias, o atraso de indexação dos artigos novos (tempo entre a publicação e as primeiras impressões) e a parcela de tráfego vinda de páginas perenes. Para a visibilidade em IA, acompanhe uma lista fixa de perguntas sobre seus temas e verifique se a publicação é citada e qual concorrente é citado no lugar dela.
A Sorank reúne esses sinais: o painel de GEO e SEO acompanha seus cliques, impressões e posições do Search Console, e o monitoramento de menções em IA verifica todo mês se o ChatGPT, o Claude e o Gemini citam sua publicação nas perguntas que seus leitores fazem. O software também escreve e publica artigos perenes no autopilot, o que combina com o lado explicativo de uma redação mais do que com as notícias de última hora.
O SEO para editoras hoje significa ser encontrado rápido no Google e ser a fonte que os assistentes de IA citam. Corrija primeiro a indexação e a confiança, proteja o tráfego perene e depois defina, junto com a direção, sua política para rastreadores de IA e licenciamento. Para acompanhar a visibilidade no Google e em IA no mesmo lugar, veja os planos da Sorank, com teste grátis de 3 dias.
Perguntas frequentes
Precisa se inscrever para aparecer no Google Notícias?
Não. O Google encontra sites de notícias pelo rastreamento normal e os considera automaticamente para Top Stories, a aba Notícias e o app Google Notícias, desde que publiquem conteúdo de qualidade e sigam as políticas de conteúdo do Google Notícias. O Publisher Center é opcional e ajuda a gerenciar o nome da publicação, o logotipo e as seções.
Um site de notícias deve bloquear os rastreadores de IA?
Depende do modelo de negócio. Bloquear rastreadores de treinamento como o GPTBot protege o conteúdo do treinamento de modelos, enquanto bloquear rastreadores de busca como o OAI-SearchBot ou o PerplexityBot tira o site das respostas e citações desses assistentes. Muitas editoras bloqueiam os rastreadores de treinamento, autorizam os de busca e negociam licenças à parte.
Quanto tempo o Google leva para indexar uma notícia?
Artigos bem linkados em sites de notícias consolidados costumam ser rastreados e indexados em minutos, enquanto sites novos ou lentos podem esperar horas ou dias. Linkar as notícias novas a partir da página inicial e das páginas de seção, incluí-las em um sitemap de notícias e manter baixo o tempo de resposta do servidor reduzem esse atraso.
y!
Free SEO & GEO audit
Receba gratuitamente o seu plano de conteúdo para 30 dias
Analisamos seus concorrentes, seu site e sua visibilidade nas IA para criar, gratuitamente, um plano de conteúdo sob medida.
“Testei o Sorank no site real de um cliente e é uma loucura. Faz tudo aquilo que uma agência cobra 1.500 € por mês. Agora vai para produção nesse cliente.”Guillaume Guersanguersanguillaume.com
“Somos uma agência de publicidade e queríamos colocar nosso SEO nos trilhos de uma vez por todas. A Sorank nos deu uma visão clara do nosso site, ajudou-nos a priorizar as otimizações e estruturar corretamente nosso conteúdo. A ferramenta é fácil de usar, bem projetada para uma equipe e muito prática para centralizar o acompanhamento sem ter que fazer malabarismos entre várias plataformas. Uma base muito sólida para recomeçar do zero com nosso SEO.”Gaspard MadouiAgência de Publicidade
“Me especializei em GEO graças à Sorank. O GEO Leaderboard me permite mostrar aos meus clientes o seu posicionamento em relação aos concorrentes no ChatGPT. É um verdadeiro diferencial comercial.”MélanieFreelancer SEO
Crescimento orgânicoGeração de leads para instaladores
“Excelente serviço, funciona bem para o nosso site e nos ajuda a entender como melhorá-lo para nos posicionarmos melhor no Google e em outros lugares. Parabéns, continuem assim, eu recomendo.”Hugo T.Comerciante de e-commerce