आपकी गोपनीयता हमारे लिए महत्वपूर्ण है, इसलिए आपके पास कुछ प्रकार के स्टोरेज को बंद करने का विकल्प है जो वेबसाइट के बुनियादी कामकाज के लिए ज़रूरी नहीं हो सकते। कुछ श्रेणियों को बंद करने से वेबसाइट पर आपके अनुभव पर असर पड़ सकता है। अधिक जानकारी (कुकी नीति)
Publisher SEO: Google News, Discover और समाचार व मीडिया साइटों के लिए AI जवाब
Publisher SEO गाइड: Top Stories, Discover, न्यूज़ साइटमैप, लेख और पेवॉल मार्कअप, साथ में AI द्वारा उद्धृत होते रहने और लाइसेंसिंग पर फ़ैसला लेने का तरीका।
3 दिन मुफ़्त, फिर जब चाहें बंद करें। 90 दिन की नतीजे-या-रिफ़ंड गारंटी।
संक्षेप में: Publisher SEO उन तरीकों का समूह है जो समाचार और मीडिया साइटों को Google Search, Top Stories, Google News, Discover और अब AI असिस्टेंट से ट्रैफ़िक कमाने में मदद करता है। यह चार स्तंभों पर टिका है: ताज़ा लेखों की तेज़ इंडेक्सिंग (न्यूज़ साइटमैप, साफ़ URL, आंतरिक लिंक), भरोसे के संकेत (बायलाइन, तारीखें, सुधार, लेखक पेज), तकनीकी मार्कअप (Article, पेवॉल और इमेज की ज़रूरतें), और AI क्रॉलर व लाइसेंसिंग के प्रति सोची-समझी नीति। जब खोज से आने वाला ट्रैफ़िक घटता है, तब एवरग्रीन कंटेंट और सीधे दर्शक-चैनल व्यवसाय को बचाते हैं।
Publisher SEO क्लासिक SEO से अलग है, क्योंकि एक समाचार साइट रोज़ दर्जनों या सैकड़ों पेज प्रकाशित करती है, जिनमें से ज़्यादातर 48 घंटों में अपना मूल्य खो देते हैं, जबकि उसका एवरग्रीन आर्काइव सालों तक विज़िट कमाता रहता है। दाँव बढ़ गए हैं: Reuters Institute की Journalism, Media and Technology Trends and Predictions 2026 रिपोर्ट (जनवरी 2026) Chartbeat के डेटा का हवाला देती है, जिसके अनुसार नवंबर 2024 और नवंबर 2025 के बीच 2,500 से ज़्यादा समाचार साइटों पर Google खोज ट्रैफ़िक साल-दर-साल 33% गिरा, और सर्वे में शामिल 280 मीडिया नेताओं को उम्मीद है कि तीन साल में खोज से आने वाले रेफ़रल और 43% घटेंगे। अब अच्छा ऑप्टिमाइज़ेशन का मतलब है जो ट्रैफ़िक बचा है उसे बनाए रखना, और जहाँ पाठक आगे जाते हैं वहाँ उद्धृत होना। यह गाइड बताती है कि प्रकाशन और मीडिया कंपनियों के लिए न्यूज़ सतहों से लेकर AI जवाबों तक क्या बदलता है।
Publisher SEO क्या है और यह कैसे अलग है?
Publisher SEO उन साइटों पर खोज ऑप्टिमाइज़ेशन लागू करता है जिनका उत्पाद संपादकीय कंटेंट है: अख़बार, पत्रिकाएँ, डिजिटल-नेटिव मीडिया, ट्रेड प्रकाशन और बड़े ब्लॉग जो विज्ञापन या सदस्यता पर चलते हैं। तीन बाधाएँ इसे अलग करती हैं।
गति: ब्रेकिंग खबर की कीमत पहले कुछ घंटों में सबसे ज़्यादा होती है। Google को उसे मिनटों में खोजना, क्रॉल करना और इंडेक्स करना होता है, इसलिए ब्रोशर वाली साइट से ज़्यादा क्रॉल पाथ और साइटमैप मायने रखते हैं।
मात्रा: हज़ारों लेख, टैग पेज, लेखक पेज और आर्काइव डुप्लीकेट और पतले पेज बनाते हैं, जो क्रॉल बजट बर्बाद करते हैं और एक ही खबर पर कई लेखों के बीच कीवर्ड कैनिबलाइज़ेशन पैदा करते हैं।
भरोसा: समाचार और समसामयिक विषयों पर Google विश्वसनीयता को भारी वज़न देता है। दिखने वाले लेखक, स्रोत और सुधार E-E-A-T (अनुभव, विशेषज्ञता, आधिकारिकता और भरोसा) को सहारा देते हैं।
प्रकाशक उन सतहों पर भी निर्भर करता है जो ज़्यादातर साइटें कभी नहीं देखतीं: Top Stories कैरोसेल, News टैब, Google News ऐप और Discover, एक ऐसा फ़ीड जो बिना किसी खोज के उपयोगकर्ताओं तक कंटेंट पहुँचाता है।
प्रकाशकों के लिए कौन-सी Google सतहें मायने रखती हैं?
हर सतह का अपना चयन तर्क होता है। तालिका बताती है कि दृश्यता क्या चलाती है और उसे कहाँ मापें।
सतह
कंटेंट कैसे आता है
मुख्य लीवर
कहाँ मापें
खोज नतीजे (नीले लिंक)
सामान्य क्रॉल और रैंकिंग
प्रासंगिकता, गहराई, लिंक, पेज अनुभव
Search Console, Search type: Web
Top Stories
स्वचालित, समाचार इरादे वाली खोजों के लिए
ताज़गी, विषय पर अधिकार, मूल रिपोर्टिंग
Search Console, Search appearance फ़िल्टर
Google News ऐप और News टैब
स्वचालित, Google News की कंटेंट नीतियों के अधीन
पारदर्शिता, तारीखें, बायलाइन, नीति का पालन
Search Console, Google News रिपोर्ट
Discover
स्वचालित, उपयोगकर्ता की रुचियों पर आधारित
बड़ी इमेज, ईमानदार टाइटल, समय पर या अनोखी खबरें
Search Console, Discover रिपोर्ट
AI Overviews और AI असिस्टेंट
इंडेक्स या क्रॉल किए गए पेजों से रिट्रीवल
साफ़ तथ्य, संरचित जवाब, क्रॉलर की पहुँच, ब्रांड अधिकार
प्रॉम्प्ट ट्रैकिंग, रेफ़रल एनालिटिक्स
Google अपने Publisher Center मदद पेज में कहता है कि कोई आवेदन फ़ॉर्म नहीं है: सामान्य क्रॉल से मिली साइटें, अगर उच्च गुणवत्ता का कंटेंट बनाती हैं और Google News की कंटेंट नीतियों का पालन करती हैं, तो Top Stories और News टैब के लिए अपने-आप विचार की जाती हैं। Publisher Center फिर भी उपयोगी है, ताकि Google News ऐप में प्रकाशन का नाम, लोगो और सेक्शन प्रबंधित किए जा सकें।
लेख जल्दी इंडेक्स कैसे कराएँ?
1. न्यूज़ साइटमैप प्रकाशित करें
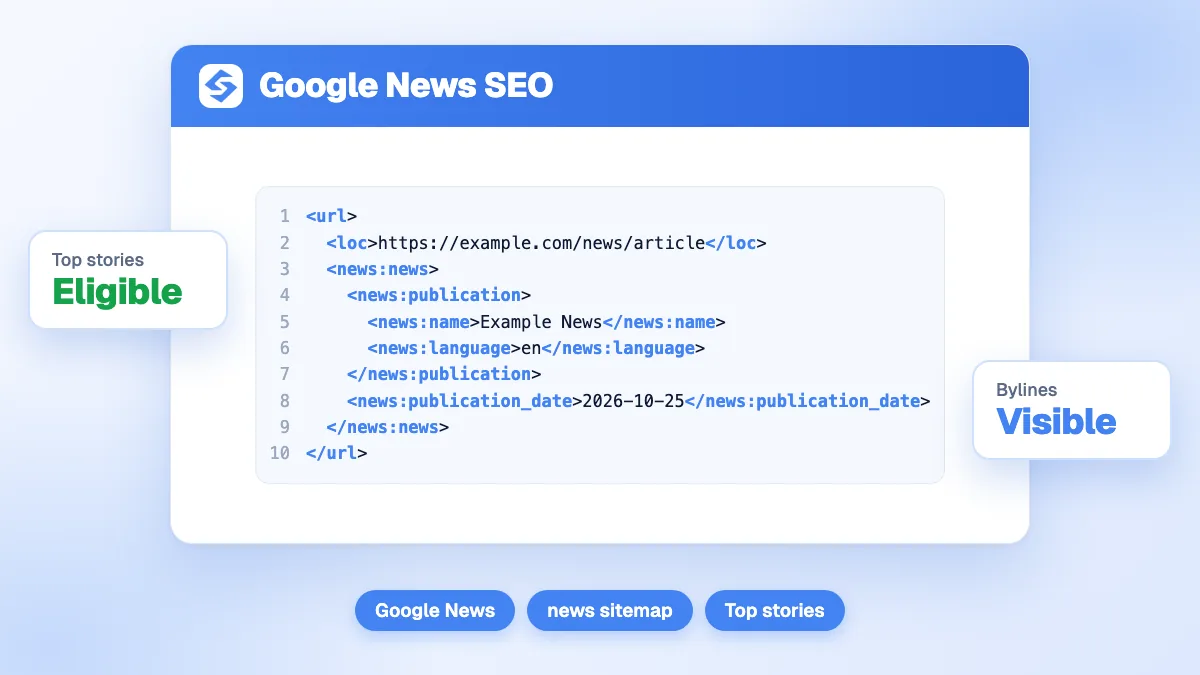
एक न्यूज़ साइटमैप सिर्फ़ ताज़ा लेखों को सूचीबद्ध करता है। Google के न्यूज़ साइटमैप दस्तावेज़ प्रकाशकों से माँग करते हैं कि वे सिर्फ़ पिछले दो दिनों में बने लेखों के URL शामिल करें, हर फ़ाइल में अधिकतम 1,000 news:news प्रविष्टियों के साथ, और टैग news:publication (नाम और भाषा), news:publication_date और news:title ज़रूरी बताते हैं। प्रकाशन का नाम वही होना चाहिए जो Google News पर दिखता है। इसके साथ पूरे आर्काइव के लिए एक नियमित XML साइटमैप भी रखें।
2. नई कहानियों को क्रॉल होने वाले हब से लिंक करें
Googlebot होमपेज और सेक्शन पेजों पर बार-बार लौटता है। हर नई कहानी को इन हबों से और संबंधित लाइव पेजों से लिंक करने पर वह किसी भी साइटमैप पिंग से तेज़ी से क्रॉल होती है। टॉपिक पेज (हर बार आने वाले विषय, व्यक्ति या टीम के लिए एक) लिंक इकट्ठा करते हैं और Google को एक स्थायी URL देते हैं, जिस पर बार-बार आने वाली खोजों के लिए रैंक किया जा सके।
3. हर कहानी का एक URL रखें
विकसित होती कहानी को हर विकास के लिए नया लेख छापने के बजाय उसी URL पर अपडेट करें, और प्रकाशन की तारीख व आख़िरी अपडेट दोनों दिखाएँ। जब किसी समूह के कई आउटलेट एक ही सामग्री सिंडिकेट करें, तो मूल की ओर इशारा करने वाला canonical टैग प्रतिस्पर्धी डुप्लीकेट से बचाता है।
4. क्रॉल की बर्बादी रोकें
अनंत टैग संयोजन, आंतरिक खोज पेज, कैलेंडर आर्काइव और ट्रैकिंग पैरामीटर क्रॉलिंग को पतला करते हैं। जिसका खोज में कोई मूल्य न हो उसे ब्लॉक करें या noindex करें, और पतले टैग पेजों की जाँच करें (दो लेखों वाला टैग किसी की मदद नहीं करता)।
सुझाव
किसी बड़े खबर वाले दिन के बाद Search Console में Crawl stats रिपोर्ट देखें। अगर औसत प्रतिक्रिया समय बढ़ता है, तो Googlebot धीमा हो जाता है, और आपकी ताज़ा कहानियाँ आर्काइव पेजों के पीछे कतार में इंतज़ार करती हैं।
एक न्यूज़ साइट को कौन-सा स्ट्रक्चर्ड डेटा इस्तेमाल करना चाहिए?
प्रकाशकों के लिए तीन प्रकार का मार्कअप ज़्यादातर काम करता है।
Article या NewsArticle: हेडलाइन, इमेज, datePublished, dateModified और author जिसमें लेखक पेज का लिंक हो। इससे Google को सही तारीख दिखाने और कहानी का श्रेय देने में मदद मिलती है।
पेवॉल मार्कअप: सदस्यता वाले कंटेंट के लिए, Google के पेवॉल कंटेंट दिशानिर्देश माँगते हैं कि आप isAccessibleForFree को false सेट करें और hasPart को cssSelector के साथ बंद हिस्से की ओर इशारा करें। इससे Googlebot पूरा टेक्स्ट पढ़ सकता है, और Google आपके पेवॉल को क्लोकिंग से अलग पहचानता है, जो उसकी स्पैम नीतियों का उल्लंघन है।
Organization और Person: प्रकाशक की पहचान, लोगो, सोशल प्रोफ़ाइल और लेखक प्रोफ़ाइल, जो आपके कंटेंट को ज्ञात इकाइयों से जोड़ते हैं।
स्ट्रक्चर्ड डेटा अपने-आप किसी लेख को रैंक नहीं कराता, लेकिन यह इस बारे में अस्पष्टता हटाता है कि किसने क्या और कब लिखा, Google के लिए और उन भाषा मॉडलों के लिए जो आपके पेज पार्स करते हैं। AI खोज के लिए स्ट्रक्चर्ड डेटा पर हमारी गाइड समझाती है कि AI सिस्टम वास्तव में कौन सी प्रॉपर्टी इस्तेमाल करते हैं।
Google Discover से ट्रैफ़िक कैसे जीतें?
Discover कई समाचार और जीवनशैली प्रकाशकों के लिए एक बड़ा ट्रैफ़िक स्रोत है, और सबसे अस्थिर भी। Google के Discover दस्तावेज़ (मार्च 2026 में अपडेट) साफ़ शर्तें तय करते हैं:
बड़ी इमेज इस्तेमाल करें, कम से कम 1200 px चौड़ी, 300,000 पिक्सल से ऊपर, 16x9 अनुपात में, max-image-preview:large robots सेटिंग के साथ सक्षम;
मुख्य विज़ुअल के रूप में लोगो और टेक्स्ट-भारी इमेज से बचें;
ऐसे टाइटल लिखें जो कहानी का सार पकड़ें, और क्लिकबेट, अतिशयोक्ति या जानकारी छिपाने से बचें;
समय पर आने वाली कहानियाँ, मौलिक नज़रिया और अच्छा पेज अनुभव प्रकाशित करें।
Search Console की Discover रिपोर्ट एक न्यूनतम सीमा पहुँचने के बाद 16 महीनों तक क्लिक, इम्प्रेशन और CTR दिखाती है, और इसमें Chrome से आने वाला ट्रैफ़िक भी शामिल होता है। इमेज और टाइटल टेस्ट में गहराई से जाने के लिए हमारी समर्पित गाइड Google Discover ऑप्टिमाइज़ेशन देखें।
सावधान रहें
सनसनीखेज़ हेडलाइन Discover के क्लिक एक हफ़्ते के लिए बढ़ा सकती हैं, फिर आपकी पहुँच घटा देती हैं। Google साफ़ तौर पर भ्रामक टाइटल, और गुस्से या जिज्ञासा का फ़ायदा उठाने वाली तकनीकों को उन कारणों में गिनता है जिनसे किसी साइट का कंटेंट कम दिखाया जाता है।
Google की नज़र में एक प्रकाशक भरोसेमंद कैसे बनता है?
भरोसा पेज-दर-पेज और पूरी साइट पर बनता है।
बायलाइन और लेखक पेज असली जीवनी, विशेषज्ञता, संपर्क विवरण और लेखक के काम के लिंक के साथ।
तारीखें हेडलाइन के पास दिखें, मार्कअप और साइटमैप से मेल खाती हुई।
संपादकीय पारदर्शिता: एक बारे में पेज, स्वामित्व, संपादकीय नीति, सुधार नीति और न्यूज़रूम से संपर्क का तरीका।
मूल रिपोर्टिंग, फिर से लिखे गए एजेंसी कंटेंट के बजाय: Top Stories आमतौर पर उस आउटलेट को तरजीह देता है जिसने कहानी तोड़ी या उसमें कुछ जोड़ा।
साफ़ मुद्रीकरण: विज्ञापनों का घनत्व इतना कि Core Web Vitals हरे रहें, और ट्रैकिंग स्क्रिप्ट असिंक्रोनस रूप से लोड हों।
मुद्रीकरण वाले सेक्शन पर भी ध्यान चाहिए। Google की स्पैम नीतियाँसाइट प्रतिष्ठा के दुरुपयोग को ऐसे तृतीय-पक्ष कंटेंट के रूप में परिभाषित करती हैं जो मुख्य रूप से मेज़बान के रैंकिंग संकेतों का फ़ायदा उठाने के लिए छापा गया हो। बाहरी साझेदारों द्वारा चलाए गए कूपन, उत्पाद समीक्षा या प्रायोजित सेक्शन, जिनमें संपादकीय एकीकरण न हो, पूरे डोमेन को खतरे में डालते हैं, जबकि संपादकीय रूप से चुना गया और साफ़ तौर पर घोषित सेक्शन निशाने पर नहीं आता।
ब्रेकिंग न्यूज़ और एवरग्रीन कंटेंट में संतुलन कैसे रखें?
ब्रेकिंग न्यूज़ उछाल लाती है, एवरग्रीन कंटेंट एक न्यूनतम आधार देता है। स्वस्थ प्रकाशक दोनों की योजना बनाता है।
व्याख्याकार और गाइड (“यह क्या है”, “कैसे करें”, टाइमलाइन, शब्दावली) जो बार-बार आने वाली खबरों के पीछे के स्थायी सवालों का जवाब देते हैं। एवरग्रीन कंटेंट पर हमारी गाइड देखें।
टॉपिक हब जो ताज़ा कहानियों को पृष्ठभूमि वाले लेखों से जोड़ते हैं।
ज़्यादा ट्रैफ़िक वाले आर्काइव पेजों के नियमित अपडेट: लगभग-डुप्लीकेट लेख छापने के बजाय तथ्य, तारीखें और लिंक ताज़ा करें। कंटेंट रिफ़्रेश का हमारा तरीका सीधे न्यूज़ आर्काइव पर लागू होता है।
कीवर्ड रिसर्च बार-बार होने वाली घटनाओं (चुनाव, बजट, खेल सीज़न, प्रोडक्ट लॉन्च) पर, ताकि उछाल से पहले व्याख्याकार मौजूद हो।
AI जवाब Publisher SEO को कैसे बदलते हैं?
AI Overviews, ChatGPT, Perplexity और Gemini खबरों का सार देते हैं और तथ्यात्मक सवालों के जवाब सीधे देते हैं, जिससे कई सूचनात्मक खोजों पर क्लिक घटते हैं (देखें Google AI Overviews)। प्रकाशक अब तीन फ़ैसले लेते हैं।
क्रॉलर की पहुँच
Robots.txt आपको हर AI क्रॉलर को अलग से अनुमति देने या ब्लॉक करने देता है: OpenAI ट्रेनिंग के लिए GPTBot, ChatGPT खोज के लिए OAI-SearchBot, PerplexityBot, ClaudeBot और अन्य। Google-Extended एक अलग टोकन है जो Gemini ट्रेनिंग और ग्राउंडिंग में आपके कंटेंट के इस्तेमाल को नियंत्रित करता है; Google बताता है कि यह Google Search में शामिल होने या रैंकिंग को प्रभावित नहीं करता। खोज-उन्मुख बॉट को ब्लॉक करने से आप उनके जवाबों से बाहर हो जाते हैं, इसलिए कई प्रकाशक ट्रेनिंग बॉट ब्लॉक करते हैं और खोज बॉट को अनुमति देते हैं। user agents की सूची के लिए हमारी गाइड AI क्रॉलर के लिए robots.txt देखें।
लाइसेंसिंग
बड़ी AI कंपनियों ने प्रकाशकों के साथ कंटेंट समझौते किए हैं (उदाहरण के लिए OpenAI का Associated Press और Axel Springer के साथ), और प्रति-क्रॉल भुगतान के नए मॉडल आ रहे हैं। प्रकाशक लाइसेंसिंग जितना SEO का फ़ैसला है उतना ही एक व्यावसायिक फ़ैसला है: एक सौदा राजस्व और श्रेय ला सकता है, जबकि सामान्य ब्लॉक विशिष्टता बचाता है, पर दृश्यता की कीमत पर।
उद्धृत होने की क्षमता
AI असिस्टेंट ऐसे स्रोत उद्धृत करते हैं जो तथ्य साफ़ तौर पर, ऊपर के पास, तारीखों और नामित स्रोतों के साथ बताते हैं। मूल डेटा, विशेष उद्धरण और अच्छी तरह संरचित व्याख्याकार, फिर से लिखी गई एजेंसी खबरों से ज़्यादा उद्धृत होते हैं। कौन से आउटलेट AI असिस्टेंट सबसे ज़्यादा उद्धृत करते हैं, यह देखने के लिए हमारा मीडिया AI उद्धरण अध्ययन देखें।
Publisher SEO को कैसे मापें?
रिपोर्टिंग को सतह और कंटेंट प्रकार के हिसाब से बाँटें: ब्रेकिंग न्यूज़, एवरग्रीन, टॉपिक हब। Search Console में Web, Discover और Google News रिपोर्ट अलग-अलग ट्रैक करें, नए लेखों की इंडेक्सिंग देरी (प्रकाशन और पहले इम्प्रेशन के बीच का समय), और एवरग्रीन पेजों से आने वाले ट्रैफ़िक का हिस्सा। AI दृश्यता के लिए, अपने विषयों पर सवालों की एक तय सूची पर नज़र रखें और जाँचें कि आपका प्रकाशन उद्धृत होता है या नहीं, और उसकी जगह कौन सा प्रतियोगी उद्धृत होता है।
Sorank ये संकेत एक जगह लाता है: GEO और SEO डैशबोर्ड आपके Search Console क्लिक, इम्प्रेशन और स्थितियों पर नज़र रखता है, और AI मेंशन ट्रैकिंग हर महीने जाँचता है कि ChatGPT, Claude और Gemini उन सवालों पर आपके प्रकाशन को उद्धृत करते हैं या नहीं जो आपके पाठक पूछते हैं। सॉफ़्टवेयर एवरग्रीन लेख भी autopilot पर लिखता और प्रकाशित करता है, जो न्यूज़रूम के व्याख्याकार वाले हिस्से में फ़िट होता है, ब्रेकिंग न्यूज़ में नहीं।
Publisher SEO अब का मतलब है Google पर तेज़ी से मिलना और वह स्रोत बनना जिसे AI असिस्टेंट उद्धृत करते हैं। पहले इंडेक्सिंग और भरोसे को ठीक करें, एवरग्रीन ट्रैफ़िक को बचाएँ, फिर व्यवसाय के साथ मिलकर अपनी AI क्रॉलर और लाइसेंसिंग नीति तय करें। Google और AI दृश्यता दोनों को एक जगह ट्रैक करने के लिए, Sorank की योजनाएँ देखें, जिनमें 3 दिन का मुफ़्त ट्रायल है।
अक्सर पूछे जाने वाले सवाल
Google News में दिखने के लिए क्या आवेदन करना पड़ता है?
नहीं। Google सामान्य क्रॉल के ज़रिए समाचार साइटें खोजता है, और अगर वे उच्च गुणवत्ता का कंटेंट प्रकाशित करती हैं और Google News की कंटेंट नीतियों का पालन करती हैं, तो उन्हें Top Stories, News टैब और Google News ऐप के लिए अपने-आप विचार करता है। Publisher Center वैकल्पिक है और प्रकाशन का नाम, लोगो और सेक्शन प्रबंधित करने में मदद करता है।
क्या एक समाचार साइट को AI क्रॉलर ब्लॉक करने चाहिए?
यह व्यावसायिक मॉडल पर निर्भर करता है। GPTBot जैसे ट्रेनिंग क्रॉलर को ब्लॉक करने से कंटेंट मॉडल ट्रेनिंग से बचता है, जबकि OAI-SearchBot या PerplexityBot जैसे खोज क्रॉलर ब्लॉक करने से साइट उन असिस्टेंट के जवाबों और उद्धरणों से बाहर हो जाती है। कई प्रकाशक ट्रेनिंग बॉट ब्लॉक करते हैं, खोज बॉट को अनुमति देते हैं, और लाइसेंसिंग पर अलग से बातचीत करते हैं।
Google को एक न्यूज़ लेख इंडेक्स करने में कितना समय लगता है?
अच्छी तरह लिंक किए गए लेख स्थापित समाचार साइटों पर अक्सर मिनटों में क्रॉल और इंडेक्स हो जाते हैं, जबकि नई या धीमी साइटों को घंटों या दिनों तक इंतज़ार करना पड़ सकता है। होमपेज और सेक्शन पेजों से नई कहानियों को लिंक करने, उन्हें न्यूज़ साइटमैप में सूचीबद्ध करने, और सर्वर प्रतिक्रिया समय कम रखने से देरी घटती है।
y!
मुफ़्त SEO और GEO ऑडिट
30 दिनों का अपना कंटेंट प्लान मुफ़्त में पाएँ
हम आपके प्रतिस्पर्धियों, आपकी वेबसाइट और आपकी AI दृश्यता का विश्लेषण करते हैं, ताकि मुफ़्त में आपके लिए एक अनुकूल कंटेंट योजना बनाई जा सके।
“मैंने Sorank को एक असली क्लाइंट की साइट पर आज़माया और यह कमाल का है। यह वह सब कुछ करता है जिसके लिए एक एजेंसी आपसे हर महीने $1500 वसूलती है। अब उस क्लाइंट के लिए इसे प्रोडक्शन में डाला जा रहा है।”Guillaume Guersanguersanguillaume.com
“हम एक Ads एजेंसी हैं और हम अपने SEO को एक बार और हमेशा के लिए सही रास्ते पर लाना चाहते थे। Sorank ने हमें हमारी साइट की साफ तस्वीर दी, ऑप्टिमाइज़ेशन को प्राथमिकता देने में मदद की, और हमारे कंटेंट को सही तरीके से व्यवस्थित किया। टूल इस्तेमाल में आसान है, टीम के लिए अच्छी तरह डिज़ाइन किया गया है, और कई प्लेटफ़ॉर्म के बीच भागदौड़ किए बिना ट्रैकिंग को एक जगह रखने के लिए बहुत व्यावहारिक है। नए सिरे से SEO शुरू करने के लिए एक बहुत मज़बूत आधार।”Gaspard MadouiAds एजेंसी
“Sorank की बदौलत मैं GEO में विशेषज्ञ बन गई। GEO रैंकिंग मुझे ChatGPT पर क्लाइंट्स को उनकी प्रतियोगियों के मुकाबले उनकी पोज़िशन दिखाने देती है। यह एक असली व्यावसायिक अंतर है।”Mélanieफ्रीलांस SEO
“बेहतरीन सेवा है, हमारी वेबसाइट के लिए अच्छा काम करती है, और यह समझने में मदद करती है कि इसे कैसे सुधारें ताकि Google और दूसरी जगहों पर बेहतर रैंक हो। बधाई, ऐसे ही आगे बढ़ते रहिए। इसकी सिफ़ारिश है।”Hugo T.E-commerce व्यापारी