Jouw privacy is belangrijk voor ons, daarom kun je bepaalde soorten opslag uitschakelen die niet nodig zijn voor de basiswerking van de website. Het blokkeren van categorieën kan invloed hebben op je ervaring op de website. Meer informatie (Cookiebeleid)
Omslag van het artikel ‘SEO voor uitgevers’, met een schermafbeelding van de Sorank-software naast de titel
Tools
Op deze pagina
Kort gezegd
SEO voor uitgevers is de verzameling praktijken waarmee nieuws- en mediasites verkeer binnenhalen uit de Google-zoekmachine, uit Top Stories, Google News, Discover en inmiddels ook van AI-assistenten. Het rust op vier pijlers: snelle indexering van nieuwe artikelen (nieuwssitemap, schone URL's, interne links), vertrouwenssignalen (bylines, datums, correcties, auteurspagina's), technische markup (Article, eisen voor paywall en afbeeldingen) en een bewust beleid ten aanzien van AI-crawlers en licenties. Tijdloze content en directe kanalen naar het publiek beschermen het bedrijf wanneer het verkeer vanuit zoekmachines terugloopt.
3 dagen gratis, daarna stop je wanneer je wilt. 90 dagen resultaat-of-geld-terug-garantie.
SEO voor uitgevers verschilt van klassieke SEO omdat een nieuwssite dagelijks tientallen of honderden pagina's publiceert, waarvan de meeste binnen 48 uur aan waarde verliezen, terwijl het tijdloze archief jarenlang bezoekers blijft trekken. De inzet is gestegen: het rapport Journalism, Media and Technology Trends and Predictions 2026 van het Reuters Institute (januari 2026) noemt Chartbeat-gegevens waaruit blijkt dat het Google-zoekverkeer naar meer dan 2500 nieuwssites tussen november 2024 en november 2025 met 33% daalde ten opzichte van een jaar eerder. De 280 ondervraagde medialeiders verwachten over drie jaar nog eens 43% minder verwijzingen vanuit zoekmachines. Goed optimaliseren betekent nu het verkeer dat overblijft behouden en worden geciteerd waar lezers daarna naartoe gaan. Deze gids laat zien wat er verandert voor uitgeverijen en mediabedrijven, van nieuwsoppervlakken tot AI-antwoorden.
Wat is SEO voor uitgevers en waarin verschilt het?
SEO voor uitgevers past zoekmachineoptimalisatie toe op sites waarvan het product redactionele content is: kranten, tijdschriften, digitale mediamerken, vakpublicaties en grote blogs die leven van advertenties of abonnementen. Drie beperkingen maken het verschil.
Snelheid: een breaking story is het meest waard in de eerste uren. Google moet die binnen minuten ontdekken, crawlen en indexeren, dus crawlpaden en sitemaps tellen zwaarder dan op een brochuresite.
Volume: duizenden artikelen, tagpagina's, auteurspagina's en archieven creëren dubbele en dunne pagina's die crawlbudget verspillen en keyword-kannibalisatie veroorzaken tussen meerdere artikelen over hetzelfde onderwerp.
Vertrouwen: nieuws en actuele maatschappelijke thema's zijn onderwerpen waarbij Google betrouwbaarheid zwaar weegt. Zichtbare auteurs, duidelijke bronvermelding en correcties ondersteunen E-E-A-T (ervaring, expertise, autoriteit en betrouwbaarheid).
Een uitgever is ook afhankelijk van oppervlakken die de meeste sites nooit zien: de Top Stories-carrousels, het tabblad Nieuws, de Google News-app en Discover, een feed die content zonder enige zoekopdracht aan gebruikers aanbiedt.
Welke Google-oppervlakken zijn belangrijk voor uitgevers?
Elk oppervlak heeft zijn eigen selectielogica. De tabel vat samen wat zichtbaarheid aandrijft en waar je die meet.
Oppervlak
Hoe content erin komt
Belangrijkste hefbomen
Waar meten
Zoekresultaten (blauwe links)
Standaard crawlen en ranking
Relevantie, diepgang, links, paginaervaring
Search Console, zoektype: Web
Top Stories
Automatisch, bij zoekopdrachten met nieuwsintentie
Actualiteit, autoriteit over het onderwerp, eigen verslaggeving
Search Console, filters voor zoekweergave
Google News-app en tabblad Nieuws
Automatisch, onder voorbehoud van het contentbeleid van Google News
Transparantie, datums, bylines, naleving van het beleid
Search Console, rapport Google News
Discover
Automatisch, op basis van de interesses van gebruikers
Grote afbeeldingen, eerlijke titels, actuele of unieke verhalen
Google meldt in zijn helpcentrum voor uitgevers dat er geen aanvraagformulier is: sites die via de normale crawl worden gevonden, komen automatisch in aanmerking voor Top Stories en het tabblad Nieuws als ze content van hoge kwaliteit leveren en het contentbeleid van Google News naleven. Het Publisher Center blijft nuttig om de naam van de publicatie, het logo en de rubrieken in de Google News-app te beheren.
Hoe krijg je artikelen snel geïndexeerd?
1. Publiceer een nieuwssitemap
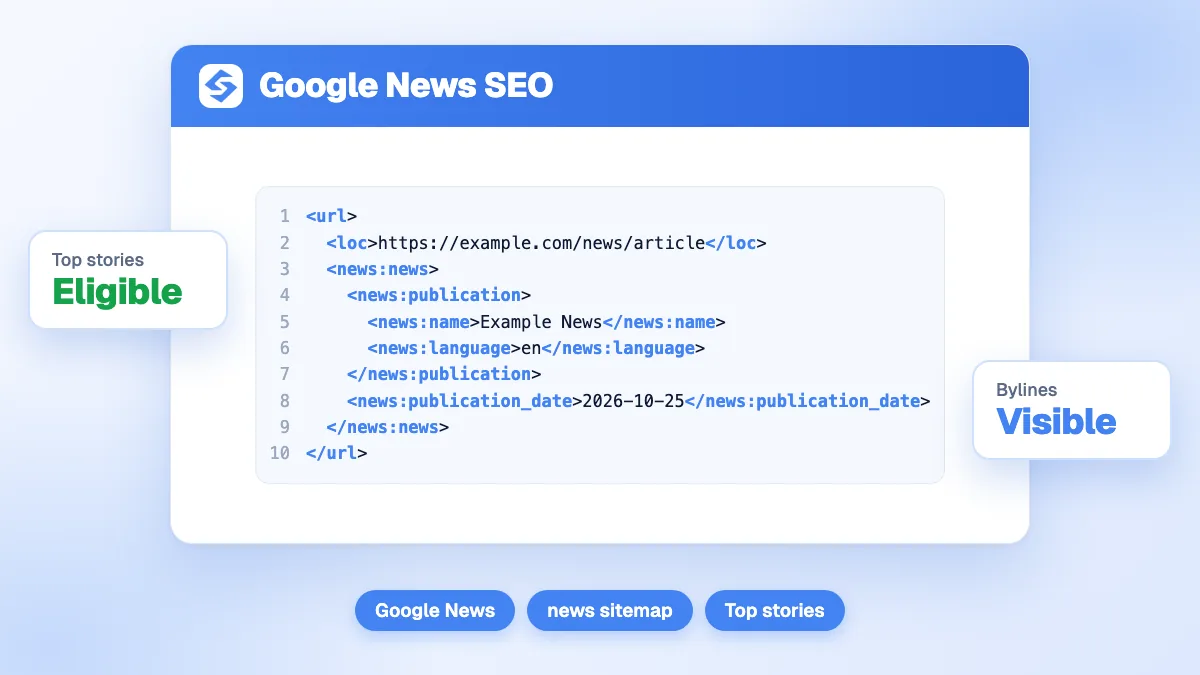
Een nieuwssitemap bevat alleen recente artikelen. De documentatie van Google over nieuwssitemaps vraagt om alleen URL's op te nemen van artikelen die in de laatste twee dagen zijn gemaakt, tot 1000 news:news-vermeldingen per bestand, en vereist de tags news:publication (naam en taal), news:publication_date en news:title. De naam van de publicatie moet overeenkomen met de naam die in Google News wordt getoond. Houd naast de nieuwssitemap ook een gewone XML-sitemap aan voor het volledige archief.
2. Link nieuwe verhalen vanaf gecrawlde hubs
Googlebot komt vaak terug op de homepage en rubriekspagina's. Elk nieuw verhaal vanaf deze hubs en vanaf gerelateerde live pagina's linken zorgt ervoor dat het sneller wordt gecrawld dan via welke sitemap-ping ook. Onderwerpspagina's (één per terugkerend onderwerp, persoon of team) verzamelen links en geven Google een stabiele URL om op terugkerende zoekopdrachten te ranken.
3. Houd één URL per verhaal
Werk een zich ontwikkelend verhaal bij op dezelfde URL, in plaats van voor elke ontwikkeling een nieuw artikel te publiceren, en toon zowel de publicatiedatum als de datum van de laatste update. Wanneer meerdere titels binnen een groep dezelfde tekst overnemen, voorkomt een canonical-tag naar het origineel concurrerende duplicaten.
4. Beperk verspilling van crawls
Oneindige tagcombinaties, interne zoekpagina's, kalenderarchieven en trackingparameters verzwakken het crawlen. Blokkeer of noindex wat geen zoekwaarde heeft, en controleer dunne tagpagina's (een tag met twee artikelen helpt niemand).
Tip
Bekijk na een drukke nieuwsdag het rapport Crawlstatistieken in Search Console. Als de gemiddelde responstijd stijgt, vertraagt Googlebot en wachten je nieuwe verhalen in de rij achter de archiefpagina's.
Welke gestructureerde data moet een nieuwssite gebruiken?
Drie soorten markup doen het grootste deel van het werk voor uitgevers.
Article of NewsArticle: kop, afbeeldingen, datePublished, dateModified en author met een link naar de auteurspagina. Het helpt Google de juiste datum te tonen en het verhaal toe te schrijven.
Paywall-markup: voor abonnementscontent vragen de richtlijnen van Google voor betaalde content om isAccessibleForFree op false te zetten en hasPart naar het afgeschermde deel te laten verwijzen met een cssSelector. Zo kan Googlebot de volledige tekst lezen, en onderscheidt Google je paywall van cloaking, dat het spambeleid overtreedt.
Organization en Person: identiteit van de uitgever, logo, sociale profielen en auteursprofielen, die je content verbinden met bekende entiteiten.
Gestructureerde data laat een artikel niet vanzelf ranken, maar ze halen de dubbelzinnigheid weg over wie wat en wanneer heeft geschreven, voor Google en voor de taalmodellen die je pagina's verwerken. Onze gids over gestructureerde data voor AI-zoekopdrachten legt uit welke eigenschappen AI-systemen echt gebruiken.
Hoe win je verkeer uit Google Discover?
Discover is voor veel nieuws- en lifestyle-uitgevers een belangrijke verkeersbron, en ook de meest wisselvallige. De documentatie van Google over Discover (bijgewerkt in maart 2026) stelt duidelijke voorwaarden:
gebruik grote afbeeldingen van minstens 1200 px breed, boven 300.000 pixels, in een verhouding van 16x9, ingeschakeld met de robots-instelling max-image-preview:large;
vermijd logo's en tekstzware afbeeldingen als belangrijkste visual;
schrijf titels die de kern van het verhaal vangen en vermijd clickbait, overdrijving of achtergehouden informatie;
publiceer actuele verhalen, originele invalshoeken en een goede paginaervaring.
Het Discover-rapport in Search Console toont klikken, vertoningen en CTR over 16 maanden zodra een minimumdrempel is bereikt, en bevat verkeer vanuit Chrome. Onze gids over optimalisatie voor Google Discover gaat dieper in op tests met afbeeldingen en titels.
Let op
Sensationele koppen kunnen de Discover-klikken een week lang verhogen en daarna je bereik verkleinen. Google noemt misleidende titels en tactieken die op verontwaardiging of nieuwsgierigheid inspelen uitdrukkelijk als redenen om minder content van een site te tonen.
Wat maakt een uitgever betrouwbaar in de ogen van Google?
Vertrouwen wordt opgebouwd pagina voor pagina en over de hele site heen.
Bylines en auteurspagina's met echte biografieën, expertise, contactgegevens en links naar het werk van de auteur.
Datums die zichtbaar zijn bij de kop en overeenkomen met de markup en de sitemap.
Redactionele transparantie: een over-ons-pagina, eigendom, een redactiebeleid, een correctiebeleid en een manier om de redactie te bereiken.
Eigen verslaggeving in plaats van herschreven agentschapstekst: Top Stories geeft doorgaans de voorkeur aan de titel die het verhaal heeft onthuld of aangevuld.
Schone monetisatie: een advertentiedichtheid die de Core Web Vitals in het groen houdt, en trackingscripts die asynchroon laden.
Ook gemonetiseerde rubrieken vragen om zorg. Het spambeleid van Google definieert misbruik van sitereputatie als het publiceren van content van derden die vooral bedoeld is om te profiteren van de rankingsignalen van de host. Kortingsrubrieken, productreviews of gesponsorde content die door externe partners wordt beheerd zonder redactionele inbedding, brengen het hele domein in gevaar, terwijl een door de redactie samengestelde en duidelijk aangeduide rubriek niet wordt getroffen.
Hoe balanceer je breaking news en tijdloze content?
Breaking news zorgt voor pieken, tijdloze content zorgt voor een vaste basis. Een gezonde uitgever plant beide.
Verklaringen en gidsen («wat is», «hoe», tijdlijnen, woordenlijsten) die antwoord geven op de vaste vragen achter terugkerende nieuwsonderwerpen. Zie onze gids over tijdloze content.
Themahubs die de laatste nieuwsberichten koppelen aan achtergrondverhalen.
Regelmatige updates van archiefpagina's met veel bezoek: vernieuw feiten, datums en links in plaats van een bijna-duplicaat te publiceren. Onze methode voor een contentupdate geldt direct voor nieuwsarchieven.
Zoekwoordonderzoek naar terugkerende gebeurtenissen (verkiezingen, begrotingen, sportseizoenen, productlanceringen), zodat de verklaring er al is voordat de piek komt.
Hoe veranderen AI-antwoorden de SEO voor uitgevers?
AI-overzichten, ChatGPT, Perplexity en Gemini vatten het nieuws samen en beantwoorden feitelijke vragen rechtstreeks, wat de klikken op veel informatieve zoekopdrachten verlaagt (zie Google AI Overviews). Uitgevers nemen nu drie beslissingen.
Toegang voor crawlers
Het robots.txt-bestand laat je elke AI-crawler afzonderlijk toestaan of blokkeren: GPTBot voor de training van OpenAI, OAI-SearchBot voor de zoekfunctie van ChatGPT, PerplexityBot, ClaudeBot en andere. Google-Extended is een apart token dat bepaalt of je content gebruikt mag worden voor de training en onderbouwing van Gemini; Google stelt dat het geen invloed heeft op opname of ranking in de Google-zoekmachine. Zoekgerichte bots blokkeren haalt je uit hun antwoorden, daarom blokkeren veel uitgevers de trainingsbots en staan ze de zoekbots toe. Onze gids over robots.txt voor AI-crawlers somt de user agents op.
Licenties
Grote AI-bedrijven hebben contentovereenkomsten gesloten met uitgevers (OpenAI met de Associated Press en Axel Springer, bijvoorbeeld), en er komen modellen op met betaling per crawl. Licentieverlening is net zo goed een zakelijke beslissing als een SEO-beslissing: een deal kan omzet en naamsvermelding opleveren, terwijl een algemene blokkade exclusiviteit beschermt ten koste van zichtbaarheid.
Citeerbaarheid
AI-assistenten citeren bronnen die feiten helder formuleren, bovenaan, met datums en genoemde bronnen. Originele data, exclusieve citaten en goed gestructureerde verklaringen worden vaker geciteerd dan herschreven agentschapsberichten. Onze studie naar hoe AI-assistenten media citeren laat zien welke titels AI-assistenten het vaakst citeren.
Hoe meet je SEO voor uitgevers?
Splits je rapportage op oppervlak en contenttype: breaking news, tijdloze content, themahubs. Volg in Search Console de rapporten Web, Discover en Google News apart, de indexeringsvertraging van nieuwe artikelen (de tijd tussen publicatie en de eerste vertoningen) en het aandeel verkeer van tijdloze pagina's. Voor AI-zichtbaarheid volg je een vaste lijst vragen over je onderwerpen en controleer je of je publicatie wordt geciteerd, en welke concurrent er in plaats daarvan wordt geciteerd.
Sorank brengt deze signalen samen: het GEO- en SEO-dashboard volgt je klikken, vertoningen en posities uit Search Console, en de AI-vermeldingstracking controleert elke maand of ChatGPT, Claude en Gemini je publicatie citeren bij de vragen van je lezers. De software schrijft en publiceert ook tijdloze artikelen op autopilot, wat past bij het verklarende deel van een redactie meer dan bij breaking news.
SEO voor uitgevers betekent nu snel gevonden worden op Google en de bron zijn die AI-assistenten citeren. Los eerst indexering en vertrouwen op, bescherm het tijdloze verkeer en bepaal daarna samen met de directie je beleid voor AI-crawlers en licenties. Om Google- en AI-zichtbaarheid op één plek te volgen, zie je de Sorank-abonnementen, met een gratis proefperiode van 3 dagen.
Veelgestelde vragen
Moet je je aanmelden om in Google News te verschijnen?
Nee. Google vindt nieuwssites via de normale crawl en overweegt ze automatisch voor Top Stories, het tabblad Nieuws en de Google News-app als ze content van hoge kwaliteit publiceren en het contentbeleid van Google News naleven. Het Publisher Center is optioneel en helpt de naam van de publicatie, het logo en de rubrieken te beheren.
Moet een nieuwssite AI-crawlers blokkeren?
Dat hangt af van het verdienmodel. Trainingscrawlers zoals GPTBot blokkeren beschermt je content tegen modeltraining, terwijl zoekcrawlers zoals OAI-SearchBot of PerplexityBot blokkeren de site uit de antwoorden en citaten van die assistenten haalt. Veel uitgevers blokkeren de trainingsbots, staan de zoekbots toe en onderhandelen apart over licenties.
Hoe lang duurt het voordat Google een nieuwsartikel indexeert?
Goed gelinkte artikelen op gevestigde nieuwssites worden vaak binnen enkele minuten gecrawld en geïndexeerd, terwijl nieuwe of trage sites uren of dagen kunnen wachten. Nieuwe verhalen linken vanaf de homepage en rubriekspagina's, ze opnemen in een nieuwssitemap en de serverresponstijden laag houden, verkort de vertraging.
y!
Gratis SEO- en GEO-audit
Ontvang gratis je contentplan voor 30 dagen
We analyseren je concurrenten, je website en je AI-zichtbaarheid om gratis een contentplan op maat voor je te maken.
“Ik heb Sorank getest op de site van een echte klant en het is waanzinnig. Het doet alles waar een bureau je $1500 per maand voor rekent. Het gaat nu bij die klant in productie.”Guillaume Guersanguersanguillaume.com
“Wij zijn een advertentiebureau en wilden onze SEO eens en voor altijd weer op de rails krijgen. Sorank gaf ons een helder beeld van onze site, hielp ons optimalisaties te prioriteren en onze content goed te structureren. De tool is makkelijk in gebruik, goed ontworpen voor een team en erg handig om het volgen te centraliseren zonder met meerdere platforms te hoeven jongleren. Een heel solide basis om met onze SEO opnieuw te beginnen.”Gaspard MadouiAdvertentiebureau
“Dankzij Sorank heb ik me gespecialiseerd in GEO. Met de GEO-ranglijst kan ik mijn klanten hun positie ten opzichte van concurrenten in ChatGPT laten zien. Het is een echt commercieel onderscheidend vermogen.”MélanieFreelance SEO-specialist
“Geweldige service, werkt goed voor onze website en helpt ons begrijpen hoe we die kunnen verbeteren om beter te scoren in Google en elders. Gefeliciteerd, ga zo door, ik raad het aan.”Hugo T.E-commerce-ondernemer