Datenschutz ist uns wichtig. Deshalb können Sie bestimmte Speicherarten deaktivieren, die für die grundlegende Funktion der Website nicht erforderlich sind. Das Blockieren einzelner Kategorien kann Ihr Erlebnis auf der Website beeinträchtigen. Weitere Informationen (Cookie-Richtlinie)
Titelbild des Artikels „SEO für Verlage“ mit einem Screenshot der Sorank-Software neben dem Titel
Werkzeuge
Auf dieser Seite
Kurz gesagt
SEO für Verlage umfasst die Praktiken, mit denen Nachrichten- und Medienseiten Traffic aus der Google-Suche, aus Top Stories, Google News, Discover und inzwischen auch von KI-Assistenten gewinnen. Es ruht auf vier Säulen: schnelle Indexierung frischer Artikel (News-Sitemap, saubere URLs, interne Verlinkung), Vertrauenssignale (Autorenzeilen, Datumsangaben, Korrekturen, Autorenseiten), technisches Markup (Article, Paywall- und Bildanforderungen) sowie eine bewusste Richtlinie für KI-Crawler und Lizenzen. Zeitlose Inhalte und direkte Kanäle zur Leserschaft schützen das Geschäft, wenn die Weiterleitungen aus der Suche zurückgehen.
3 Tage kostenlos, danach beenden Sie jederzeit. 90-Tage-Ergebnis-oder-Geld-zurück-Garantie.
SEO für Verlage unterscheidet sich von klassischem SEO, weil eine Nachrichtenseite täglich Dutzende oder Hunderte Seiten veröffentlicht, von denen die meisten innerhalb von 48 Stunden an Wert verlieren, während ihr zeitloses Archiv jahrelang Besuche bringt. Der Einsatz ist gestiegen: Der Bericht Journalism, Media and Technology Trends and Predictions 2026 des Reuters Institute (Januar 2026) nennt Chartbeat-Daten, wonach der Google-Suchtraffic auf mehr als 2500 Nachrichtenseiten zwischen November 2024 und November 2025 gegenüber dem Vorjahr um 33 % gesunken ist. Die 280 befragten Medienverantwortlichen erwarten, dass Suchweiterleitungen über drei Jahre um weitere 43 % zurückgehen. Gut zu optimieren heißt heute, den verbleibenden Traffic zu halten und dort zitiert zu werden, wohin Leser als Nächstes gehen. Dieser Leitfaden zeigt, was sich für Verlags- und Medienunternehmen ändert, von Nachrichtenoberflächen bis zu KI-Antworten.
Was ist SEO für Verlage und wodurch unterscheidet es sich?
SEO für Verlage wendet Suchmaschinenoptimierung auf Seiten an, deren Produkt redaktionelle Inhalte sind: Zeitungen, Magazine, digital entstandene Medien, Fachpublikationen und große Blogs, die von Werbung oder Abos leben. Drei Rahmenbedingungen unterscheiden es.
Tempo: Eine Eilmeldung hat in den ersten Stunden den größten Wert. Google muss sie in Minuten entdecken, crawlen und indexieren, deshalb zählen Crawling-Pfade und Sitemaps mehr als auf einer Visitenkartenseite.
Volumen: Tausende Artikel, Tag-Seiten, Autorenseiten und Archive erzeugen doppelte und dünne Seiten, die das Crawl-Budget verschwenden und eine Keyword-Kannibalisierung zwischen mehreren Artikeln zum selben Thema verursachen.
Vertrauen: Nachrichten und aktuelle Themen sind Bereiche, in denen Google Verlässlichkeit stark gewichtet. Sichtbare Autoren, Quellenangaben und Korrekturen unterstützen E-E-A-T (Erfahrung, Expertise, Autorität und Vertrauen).
Ein Verlag hängt außerdem von Oberflächen ab, die die meisten Seiten nie sehen: Top-Stories-Karussells, der Tab „News“, die Google-News-App und Discover, ein Feed, der Inhalte ohne jede Suchanfrage an Nutzer ausspielt.
Welche Google-Oberflächen sind für Verlage wichtig?
Jede Oberfläche hat eine eigene Auswahllogik. Die Tabelle fasst zusammen, was Sichtbarkeit treibt und wo man sie misst.
Oberfläche
Wie Inhalte hineinkommen
Wichtigste Hebel
Wo messen
Suchergebnisse (blaue Links)
Normales Crawling und Ranking
Relevanz, Tiefe, Links, Seitenerlebnis
Search Console, Suchtyp: Web
Top Stories
Automatisch, bei Anfragen mit Nachrichtenabsicht
Aktualität, Autorität zum Thema, eigene Berichterstattung
Search Console, Filter für Sucherscheinungen
Google-News-App und Tab „News“
Automatisch, vorbehaltlich der Google-News-Inhaltsrichtlinien
Google erklärt in seiner Hilfe für das Publisher Center, dass es kein Bewerbungsformular gibt: Seiten, die über das normale Crawling gefunden werden, werden automatisch für Top Stories und den Tab „News“ berücksichtigt, wenn sie hochwertige Inhalte liefern und die Google-News-Richtlinien einhalten. Das Publisher Center bleibt nützlich, um Name, Logo und Rubriken der Publikation in der Google-News-App zu verwalten.
Wie werden Artikel schnell indexiert?
1. Eine News-Sitemap veröffentlichen
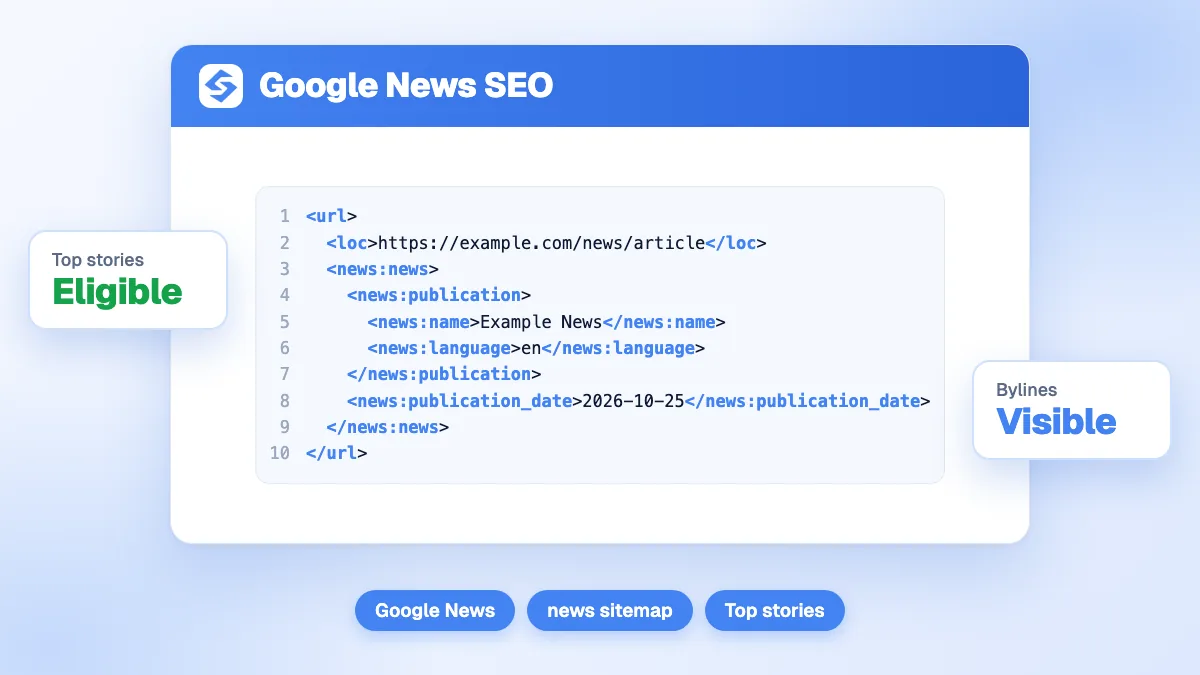
Eine News-Sitemap listet nur frische Artikel. Die Dokumentation Googles zu News-Sitemaps verlangt, nur URLs von Artikeln aufzunehmen, die in den letzten zwei Tagen erstellt wurden, bis zu 1000 news:news-Einträge pro Datei, und die Tags news:publication (Name und Sprache), news:publication_date und news:title. Der Publikationsname muss mit dem in Google News angezeigten übereinstimmen. Behalten Sie daneben eine reguläre XML-Sitemap für das gesamte Archiv.
2. Neue Meldungen von gecrawlten Hubs aus verlinken
Googlebot besucht Startseite und Rubrikenseiten häufig erneut. Wenn jede neue Meldung von diesen Hubs und von verwandten Live-Seiten verlinkt wird, wird sie schneller gecrawlt als durch jeden Sitemap-Ping. Themenseiten (eine pro wiederkehrendem Thema, jeder Person oder jedem Team) sammeln Links und geben Google eine stabile URL, auf die sich wiederkehrende Suchanfragen ranken lassen.
3. Eine URL pro Geschichte behalten
Aktualisieren Sie eine laufende Geschichte unter derselben URL, statt für jede Entwicklung einen neuen Artikel zu veröffentlichen, und zeigen Sie sowohl das Veröffentlichungsdatum als auch das letzte Update. Wenn mehrere Medien einer Gruppe denselben Text übernehmen, verhindert ein Canonical-Tag auf das Original konkurrierende Duplikate.
4. Crawl-Verschwendung begrenzen
Endlose Tag-Kombinationen, interne Suchseiten, Kalenderarchive und Tracking-Parameter verwässern das Crawling. Blockieren oder noindexen Sie alles ohne Suchwert und prüfen Sie dünne Tag-Seiten (ein Tag mit zwei Artikeln hilft niemandem).
Tipp
Prüfen Sie nach einem großen Nachrichtentag den Bericht Crawling-Statistiken in der Search Console. Steigt die durchschnittliche Antwortzeit, bremst Googlebot, und Ihre frischen Meldungen warten hinter Archivseiten.
Welches strukturierte Markup sollte eine Nachrichtenseite nutzen?
Drei Markup-Typen leisten für Verlage den Großteil der Arbeit.
Article oder NewsArticle: Überschrift, Bilder, datePublished, dateModified und author mit Link zur Autorenseite. Es hilft Google, das richtige Datum anzuzeigen und die Meldung zuzuordnen.
Paywall-Markup: Für Abo-Inhalte bitten die Richtlinien Googles für Paywall-Inhalte darum, isAccessibleForFree auf false zu setzen und hasPart mit einem cssSelector auf den geschützten Bereich zeigen zu lassen. So kann Googlebot den vollen Text lesen, und Google unterscheidet Ihre Paywall von Cloaking, das gegen die Spam-Richtlinien verstößt.
Organization und Person: Identität des Verlags, Logo, Social-Profile und Autorenprofile, die Ihre Inhalte mit bekannten Entitäten verbinden.
Strukturierte Daten bringen einen Artikel nicht von allein nach oben, aber sie beseitigen Unklarheit darüber, wer was wann geschrieben hat, für Google und für Sprachmodelle, die Ihre Seiten auswerten. Unser Leitfaden zu strukturierten Daten für die KI-Suche erklärt, welche Eigenschaften KI-Systeme tatsächlich nutzen.
Wie gewinnt man Traffic aus Google Discover?
Discover ist eine wichtige Traffic-Quelle für viele Nachrichten- und Lifestyle-Verlage und zugleich die schwankendste. Die Discover-Dokumentation von Google (Stand März 2026) setzt klare Bedingungen:
große Bilder mit mindestens 1200 px Breite, über 300.000 Pixel, im Format 16x9, aktiviert über die robots-Einstellung max-image-preview:large;
Logos und textlastige Bilder als Hauptmotiv vermeiden;
Titel schreiben, die den Kern der Geschichte treffen, und Clickbait, Übertreibung oder zurückgehaltene Informationen vermeiden;
aktuelle Geschichten, eigene Blickwinkel und ein gutes Seitenerlebnis liefern.
Der Discover-Bericht in der Search Console zeigt Klicks, Impressionen und CTR über 16 Monate, sobald eine Mindestschwelle erreicht ist, und enthält Traffic aus Chrome. Unser eigener Leitfaden zur Optimierung für Google Discover geht tiefer in Bild- und Titeltests.
Achtung
Reißerische Schlagzeilen können Discover-Klicks eine Woche lang steigern und danach Ihre Reichweite drücken. Google nennt irreführende Titel und Taktiken, die Empörung oder Neugier ausnutzen, ausdrücklich als Gründe, Inhalte einer Seite seltener zu zeigen.
Was macht einen Verlag für Google vertrauenswürdig?
Vertrauen entsteht Seite für Seite und seitenübergreifend.
Autorenzeilen und Autorenseiten mit echten Biografien, Fachgebiet, Kontaktdaten und Links zu den Arbeiten der Autoren.
Datumsangaben, sichtbar nahe der Überschrift und konsistent mit Markup und Sitemap.
Redaktionelle Transparenz: eine Über-uns-Seite, Eigentumsverhältnisse, Redaktionsleitlinien, Korrekturrichtlinie und ein Kontaktweg zur Redaktion.
Eigene Berichterstattung statt umgeschriebener Agenturmeldungen: Top Stories bevorzugt in der Regel das Medium, das die Geschichte aufgedeckt oder ergänzt hat.
Saubere Monetarisierung: eine Werbedichte, die die Core Web Vitals im grünen Bereich hält, und asynchron geladene Tracking-Skripte.
Auch monetarisierte Bereiche brauchen Sorgfalt. Die Spam-Richtlinien von Google definieren Missbrauch der Website-Reputation als Veröffentlichung von Drittinhalten, die hauptsächlich von den Ranking-Signalen des Hosts profitieren sollen. Gutschein-, Produkttest- oder Sponsored-Bereiche, die externe Partner ohne redaktionelle Einbindung betreiben, setzen die ganze Domain aufs Spiel, während ein redaktionell kuratierter und klar gekennzeichneter Bereich nicht betroffen ist.
Wie bringt man aktuelle Meldungen und zeitlose Inhalte in Balance?
Aktuelle Meldungen bringen Spitzen, zeitlose Inhalte bringen einen Sockel. Ein gesunder Verlag plant beides.
Erklärungen und Ratgeber („Was ist“, „So geht“, Zeitleisten, Glossare), die stabile Fragen hinter wiederkehrenden Nachrichten beantworten. Siehe unseren Leitfaden zu zeitlosen Inhalten.
Themen-Hubs, die die neuesten Meldungen mit Hintergrundbeiträgen verknüpfen.
Regelmäßige Aktualisierung stark besuchter Archivseiten: Fakten, Daten und Links auffrischen, statt einen Quasi-Duplikat-Artikel zu veröffentlichen. Unsere Methode für eine Inhaltsaktualisierung gilt direkt für Nachrichtenarchive.
Keyword-Recherche zu wiederkehrenden Ereignissen (Wahlen, Haushalte, Sportsaisons, Produktstarts), damit die Erklärung vor dem Ansturm existiert.
Wie verändern KI-Antworten das SEO für Verlage?
KI-Übersichten, ChatGPT, Perplexity und Gemini fassen Nachrichten zusammen und beantworten Sachfragen direkt, was die Klicks auf viele informative Anfragen senkt (siehe Google AI Overviews). Verlage müssen heute drei Entscheidungen treffen.
Crawler-Zugang
Die robots.txt erlaubt oder blockiert jeden KI-Crawler einzeln: GPTBot für das Training von OpenAI, OAI-SearchBot für die Suche von ChatGPT, PerplexityBot, ClaudeBot und andere. Google-Extended ist ein eigenes Token, das die Nutzung Ihrer Inhalte für das Training und die Verankerung von Gemini steuert. Google erklärt, dass es weder Aufnahme noch Ranking in der Google-Suche beeinflusst. Wer suchorientierte Bots blockiert, verschwindet aus deren Antworten, deshalb blockieren viele Verlage Trainings-Bots und erlauben Such-Bots. Unser Leitfaden zur robots.txt für KI-Crawler listet die User-Agents auf.
Lizenzierung
Große KI-Unternehmen haben Inhaltsvereinbarungen mit Verlagen geschlossen (etwa OpenAI mit der Associated Press und Axel Springer), und Modelle mit Bezahlung pro Crawl entstehen. Die Lizenzierung von Inhalten ist ebenso eine unternehmerische wie eine SEO-Entscheidung: Ein Deal kann Umsatz und Namensnennung bringen, während eine pauschale Sperre die Exklusivität schützt, aber Sichtbarkeit kostet.
Zitierfähigkeit
KI-Assistenten zitieren Quellen, die Fakten klar, weit oben, mit Datum und genannten Quellen formulieren. Eigene Daten, exklusive Zitate und gut strukturierte Erklärungen werden häufiger zitiert als umgeschriebene Agenturmeldungen. Unsere Studie zur Zitierung von Medien durch KI zeigt, welche Medien KI-Assistenten am häufigsten zitieren.
Wie misst man SEO für Verlage?
Teilen Sie das Reporting nach Oberfläche und Inhaltstyp auf: aktuelle Meldungen, zeitlose Inhalte, Themen-Hubs. Verfolgen Sie in der Search Console die Berichte Web, Discover und Google News getrennt, die Indexierungsverzögerung neuer Artikel (Zeit zwischen Veröffentlichung und ersten Impressionen) und den Anteil des Traffics von zeitlosen Seiten. Für die KI-Sichtbarkeit verfolgen Sie eine feste Liste von Fragen zu Ihren Themen und prüfen, ob Ihr Medium zitiert wird und welcher Wettbewerber stattdessen.
Sorank bündelt diese Signale: Das GEO- und SEO-Dashboard verfolgt Ihre Klicks, Impressionen und Positionen aus der Search Console, und das KI-Erwähnungs-Tracking prüft jeden Monat, ob ChatGPT, Claude und Gemini Ihr Medium zu den Fragen Ihrer Leser zitieren. Die Software schreibt und veröffentlicht außerdem zeitlose Artikel im Autopilot, was eher zum erklärenden Teil einer Redaktion passt als zu aktuellen Meldungen.
SEO für Verlage heißt heute, auf Google schnell gefunden zu werden und die Quelle zu sein, die KI-Assistenten zitieren. Beheben Sie zuerst Indexierung und Vertrauen, schützen Sie den zeitlosen Traffic und legen Sie dann mit der Geschäftsführung Ihre Richtlinie für KI-Crawler und Lizenzen fest. Um Google- und KI-Sichtbarkeit an einem Ort zu verfolgen, sehen Sie sich die Tarife von Sorank an, mit einer kostenlosen 3-Tage-Testphase.
Häufig gestellte Fragen
Muss man sich bewerben, um in Google News zu erscheinen?
Nein. Google findet Nachrichtenseiten über sein normales Crawling und berücksichtigt sie automatisch für Top Stories, den Tab „News“ und die Google-News-App, wenn sie hochwertige Inhalte veröffentlichen und die Google-News-Richtlinien einhalten. Das Publisher Center ist optional und hilft, Name, Logo und Rubriken der Publikation zu verwalten.
Sollte eine Nachrichtenseite KI-Crawler blockieren?
Das hängt vom Geschäftsmodell ab. Das Blockieren von Trainings-Crawlern wie GPTBot schützt Inhalte vor dem Modelltraining, während das Blockieren von Such-Crawlern wie OAI-SearchBot oder PerplexityBot die Seite aus den Antworten und Zitaten dieser Assistenten entfernt. Viele Verlage blockieren Trainings-Bots, erlauben Such-Bots und verhandeln Lizenzen separat.
Wie lange braucht Google, um einen Nachrichtenartikel zu indexieren?
Gut verlinkte Artikel auf etablierten Nachrichtenseiten werden oft innerhalb von Minuten gecrawlt und indexiert, neue oder langsame Seiten können Stunden oder Tage warten. Neue Meldungen von der Startseite und den Rubrikenseiten aus zu verlinken, sie in einer News-Sitemap aufzuführen und niedrige Serverantwortzeiten zu halten, verkürzt die Verzögerung.
y!
Kostenloses SEO- und GEO-Audit
Erhalten Sie kostenlos Ihren Content-Plan für 30 Tage
Wir analysieren Ihre Wettbewerber, Ihre Website und Ihre KI-Sichtbarkeit, um kostenlos einen maßgeschneiderten Content-Plan für Sie zu erstellen.
“Ich habe Sorank auf einer echten Kundenwebsite getestet, und es ist der Wahnsinn. Es macht alles, wofür eine Agentur 1.500 € im Monat berechnet. Jetzt geht es bei diesem Kunden in den Produktivbetrieb.”Guillaume Guersanguersanguillaume.com
“Wir sind eine Ads-Agentur und wollten unser SEO endgültig wieder auf Kurs bringen. Sorank hat uns eine klare Übersicht über unsere Website verschafft, uns geholfen, Optimierungen zu priorisieren und unsere Inhalte richtig zu strukturieren. Das Tool ist einfach zu bedienen, gut für ein Team konzipiert und sehr praktisch, um das Tracking zu zentralisieren, ohne zwischen mehreren Plattformen jonglieren zu müssen. Eine sehr solide Grundlage, um mit unserem SEO neu zu starten.”Gaspard MadouiWerbeagentur
“Ich habe mich dank Sorank auf GEO spezialisiert. Das GEO Leaderboard ermöglicht es mir, meinen Kunden ihre Position im Vergleich zu ihren Wettbewerbern auf ChatGPT zu zeigen. Das ist ein echter kommerzieller Differenzierungsfaktor.”MélanieFreelancer im Bereich SEO
Organisches WachstumLead-Generierung für Installateure
“Hervorragender Service, funktioniert gut für unsere Website und hilft uns zu verstehen, wie wir sie verbessern können, um auf Google und anderswo besser zu ranken. Herzlichen Glückwunsch, machen Sie weiter, ich empfehle es.”Hugo T.E-Commerce-Händler