La privacidad es importante para nosotros, por lo que tiene la opción de desactivar ciertos tipos de almacenamiento que pueden no ser necesarios para el funcionamiento básico del sitio web. Bloquear categorías puede afectar a su experiencia en el sitio web. Más información (Política de cookies)
Portada del artículo «SEO para editores», con una captura del software Sorank junto al título
Herramientas
En esta página
En resumen
El SEO para editores es el conjunto de prácticas que ayudan a los medios de noticias y de comunicación a obtener tráfico de la búsqueda de Google, de Top Stories, de Google Noticias, de Discover y, ya, de los asistentes de IA. Se apoya en cuatro pilares: indexación rápida de los artículos recientes (sitemap de noticias, URL limpias, enlazado interno), señales de confianza (firmas, fechas, correcciones, páginas de autor), marcado técnico (Article, requisitos de muro de pago e imágenes) y una política deliberada hacia los rastreadores de IA y las licencias. Los contenidos perennes y los canales de audiencia directa protegen el negocio cuando caen las visitas desde los buscadores.
3 días gratis y luego lo dejas cuando quieras. Garantía de resultados o devolución de 90 días.
El SEO para editores se diferencia del SEO clásico porque un medio publica decenas o cientos de páginas al día, la mayoría de las cuales pierde valor en 48 horas, mientras que su archivo perenne sigue generando visitas durante años. Lo que está en juego ha crecido: el informe Journalism, Media and Technology Trends and Predictions 2026 del Reuters Institute (enero de 2026) cita datos de Chartbeat según los cuales el tráfico de búsqueda de Google hacia más de 2500 medios cayó un 33 % interanual entre noviembre de 2024 y noviembre de 2025. Los 280 directivos encuestados prevén una nueva caída del 43 % en las derivaciones desde buscadores en tres años. Optimizar bien hoy significa conservar el tráfico que queda y ser citado allí adonde van los lectores después. Esta guía explica qué cambia para las empresas de edición y medios, desde las superficies de noticias hasta las respuestas de IA.
¿Qué es el SEO para editores y en qué se diferencia?
El SEO para editores aplica la optimización para buscadores a sitios cuyo producto es el contenido editorial: periódicos, revistas, medios nativos digitales, publicaciones profesionales y grandes blogs que viven de la publicidad o de las suscripciones. Tres condicionantes lo distinguen.
Velocidad: una noticia de última hora tiene más valor en sus primeras horas. Google debe descubrirla, rastrearla e indexarla en minutos, así que las rutas de rastreo y los sitemaps importan más que en una web de presentación.
Volumen: miles de artículos, páginas de etiquetas, páginas de autor y archivos generan páginas duplicadas o delgadas que desperdician el presupuesto de rastreo y provocan canibalización de palabras clave entre varios artículos sobre la misma noticia.
Confianza: la actualidad y los temas de interés público son ámbitos en los que Google pondera mucho la fiabilidad. Los autores visibles, las fuentes citadas y las correcciones apoyan la E-E-A-T (experiencia, pericia, autoridad y confianza).
Un editor también depende de superficies que la mayoría de los sitios nunca ve: los carruseles de Top Stories, la pestaña de Noticias, la aplicación de Google Noticias y Discover, un feed que empuja contenidos a los usuarios sin ninguna búsqueda.
¿Qué superficies de Google importan a los editores?
Cada superficie tiene su propia lógica de selección. La tabla resume qué impulsa la visibilidad y dónde medirla.
Superficie
Cómo entra el contenido
Palancas principales
Dónde medir
Resultados de búsqueda (enlaces azules)
Rastreo y clasificación estándar
Relevancia, profundidad, enlaces, experiencia de página
Search Console, tipo de búsqueda: Web
Top Stories
Automático, para consultas con intención informativa de actualidad
Frescura, autoridad sobre el tema, reportaje original
Search Console, filtros de apariencia de la búsqueda
Aplicación de Google Noticias y pestaña Noticias
Automático, según las políticas de contenido de Google Noticias
Transparencia, fechas, firmas, cumplimiento de las políticas
Search Console, informe de Google Noticias
Discover
Automático, según los intereses del usuario
Imágenes grandes, titulares honestos, historias oportunas o inéditas
Search Console, informe de Discover
Resúmenes de IA y asistentes de IA
Recuperación desde páginas indexadas o rastreadas
Hechos claros, respuestas estructuradas, acceso de rastreadores, autoridad de marca
Seguimiento de prompts, analítica de referencias
Google indica en su centro de ayuda para editores que no hay formulario de solicitud: los sitios que encuentra el rastreo normal se consideran automáticamente para Top Stories y la pestaña de Noticias si producen contenido de calidad y cumplen las políticas de contenido de Google Noticias. El Publisher Center sigue siendo útil para gestionar el nombre de la publicación, su logotipo y sus secciones en la aplicación de Google Noticias.
¿Cómo conseguir que los artículos se indexen rápido?
1. Publicar un sitemap de noticias
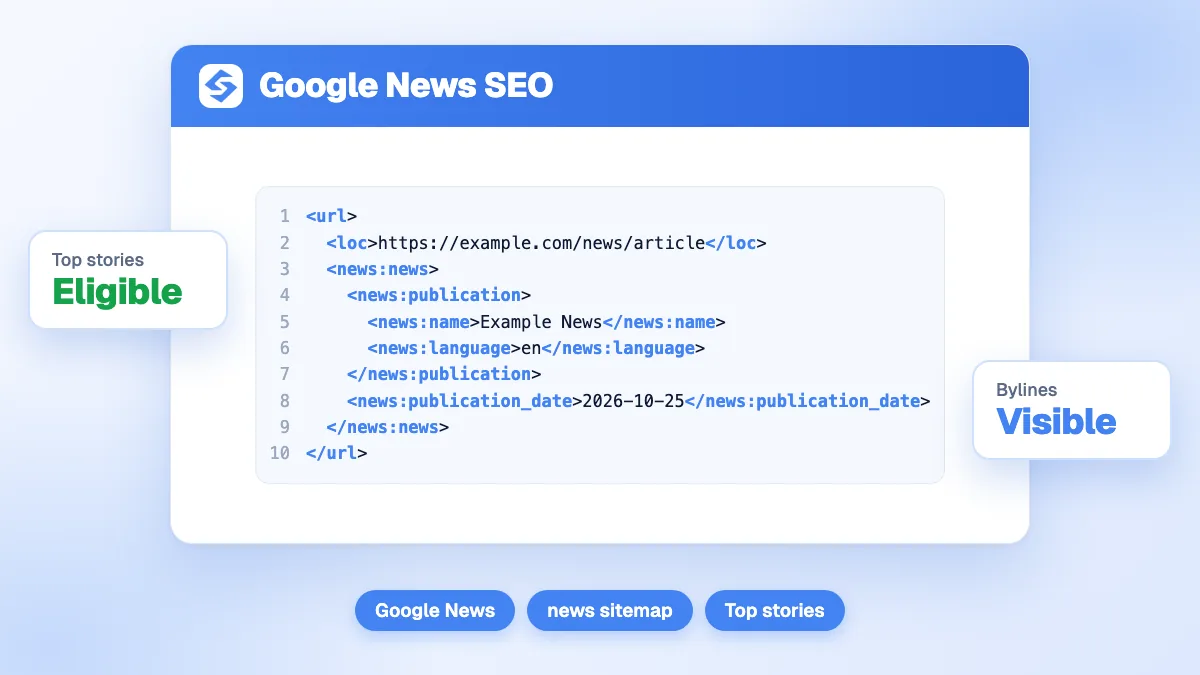
Un sitemap de noticias solo incluye artículos recientes. La documentación de Google sobre sitemaps de noticias pide incluir solo URL de artículos creados en los últimos dos días, hasta 1000 entradas news:news por archivo, y exige las etiquetas news:publication (nombre e idioma), news:publication_date y news:title. El nombre de la publicación debe coincidir con el que se muestra en Google Noticias. Mantenga además un sitemap XML normal para todo el archivo.
2. Enlazar las noticias nuevas desde hubs rastreados
Googlebot revisita a menudo la portada y las páginas de sección. Enlazar cada noticia nueva desde estos hubs y desde páginas activas relacionadas hace que se rastree antes que cualquier aviso de sitemap. Las páginas de tema (una por asunto recurrente, persona o equipo) acumulan enlaces y dan a Google una URL estable donde posicionarse en las consultas que se repiten.
3. Mantener una sola URL por historia
Actualice una historia en desarrollo en la misma URL en lugar de publicar un artículo nuevo por cada novedad, y muestre tanto la fecha de publicación como la de la última actualización. Cuando varios medios de un grupo republican la misma pieza, una etiqueta canonical que apunte al original evita duplicados que compiten entre sí.
4. Controlar el desperdicio de rastreo
Las combinaciones infinitas de etiquetas, las páginas de búsqueda interna, los archivos de calendario y los parámetros de seguimiento diluyen el rastreo. Bloquee o marque con noindex lo que no tiene valor de búsqueda, y audite las páginas de etiquetas delgadas (una etiqueta con dos artículos no ayuda a nadie).
Consejo
Revise el informe de Estadísticas de rastreo en Search Console tras un gran día de noticias. Si sube el tiempo medio de respuesta, Googlebot reduce el ritmo y sus historias nuevas esperan detrás de las páginas de archivo.
¿Qué datos estructurados debería usar un medio de noticias?
Tres tipos de marcado hacen la mayor parte del trabajo para los editores.
Article o NewsArticle: titular, imágenes, datePublished, dateModified y author con un enlace a la página del autor. Ayuda a Google a mostrar la fecha correcta y a atribuir la noticia.
Marcado de muro de pago: para contenido de suscripción, las directrices de Google sobre contenido de pago piden poner isAccessibleForFree en false y apuntar hasPart a la sección restringida con un cssSelector. Así Googlebot puede leer el texto completo, y Google distingue tu muro de pago del cloaking, que infringe sus políticas antispam.
Organization y Person: identidad del editor, logotipo, perfiles sociales y perfiles de autor, que conectan tus contenidos con entidades conocidas.
Los datos estructurados no hacen posicionar un artículo por sí solos, pero eliminan la ambigüedad sobre quién escribió qué y cuándo, tanto para Google como para los modelos de lenguaje que analizan tus páginas. Nuestra guía sobre datos estructurados para la búsqueda con IA explica qué propiedades usan de verdad los sistemas de IA.
¿Cómo conseguir tráfico de Google Discover?
Discover es una fuente de tráfico importante para muchos medios de noticias y de estilo de vida, y también la más volátil. La documentación de Discover de Google (actualizada en marzo de 2026) fija condiciones claras:
usar imágenes grandes de al menos 1200 px de ancho, por encima de 300.000 píxeles, en proporción 16x9, activadas con el ajuste de robots max-image-preview:large;
evitar logotipos e imágenes con mucho texto como visual principal;
escribir titulares que capten la esencia de la noticia y evitar el clickbait, la exageración o la información retenida;
publicar historias oportunas, ángulos originales y una buena experiencia de página.
El informe de Discover en Search Console muestra clics, impresiones y CTR durante 16 meses una vez alcanzado un umbral mínimo, e incluye el tráfico procedente de Chrome. Nuestra guía dedicada a la optimización para Google Discover profundiza en las pruebas de imagen y de titular.
Atención
Los titulares sensacionalistas pueden subir los clics de Discover durante una semana y luego recortar tu alcance. Google enumera explícitamente los titulares engañosos y las tácticas que explotan la indignación o la curiosidad como motivos para mostrar menos el contenido de un sitio.
¿Qué hace a un editor fiable para Google?
La confianza se construye página a página y en todo el sitio.
Firmas y páginas de autor con biografías reales, experiencia, datos de contacto y enlaces a sus trabajos.
Fechas visibles junto al titular, coherentes con el marcado y el sitemap.
Transparencia editorial: una página «Quiénes somos», la propiedad del medio, una política editorial, una política de correcciones y una forma de contactar con la redacción.
Reportaje propio en lugar de textos de agencia reescritos: Top Stories tiende a favorecer al medio que destapó o amplió la historia.
Monetización limpia: una densidad publicitaria que mantenga los Core Web Vitals en verde, y scripts de seguimiento cargados de forma asíncrona.
Las secciones monetizadas también requieren cuidado. Las políticas antispam de Google definen el abuso de reputación del sitio como contenido de terceros publicado principalmente para aprovechar las señales de posicionamiento del dominio anfitrión. Las secciones de cupones, reseñas de productos o patrocinados gestionadas por socios externos sin integración editorial exponen a todo el dominio, mientras que una sección curada editorialmente y claramente identificada no es objetivo.
¿Cómo equilibrar la última hora y el contenido perenne?
La última hora trae picos, el contenido perenne trae un suelo. Un editor sano planifica ambos.
Explicaciones y guías («qué es», «cómo», cronologías, glosarios) que responden a las preguntas estables detrás de las noticias recurrentes. Consulta nuestra guía sobre contenido perenne.
Hubs temáticos que enlazan las últimas noticias con piezas de contexto.
Actualizaciones periódicas de páginas de archivo muy visitadas: renueva datos, fechas y enlaces en lugar de publicar un casi duplicado. Nuestro método de actualización de contenido se aplica directamente a los archivos de noticias.
Investigación de palabras clave sobre eventos recurrentes (elecciones, presupuestos, temporadas deportivas, lanzamientos de productos) para que la explicación exista antes del pico.
¿Cómo cambian las respuestas de IA el SEO para editores?
Los resúmenes de IA, ChatGPT, Perplexity y Gemini resumen la actualidad y responden preguntas factuales directamente, lo que reduce los clics en muchas consultas informativas (véase Google AI Overviews). Los editores toman hoy tres decisiones.
Acceso de los rastreadores
El robots.txt permite autorizar o bloquear cada rastreador de IA por separado: GPTBot para el entrenamiento de OpenAI, OAI-SearchBot para la búsqueda de ChatGPT, PerplexityBot, ClaudeBot y otros. Google-Extended es un token aparte que controla el uso de tu contenido para el entrenamiento y el anclaje de Gemini; Google indica que no afecta a la inclusión ni al posicionamiento en la búsqueda de Google. Bloquear los rastreadores orientados a la búsqueda te saca de sus respuestas, por eso muchos editores bloquean los rastreadores de entrenamiento y permiten los de búsqueda. Nuestra guía sobre robots.txt para rastreadores de IA enumera los user agents.
Licencias
Grandes empresas de IA han firmado acuerdos de contenido con editores (OpenAI con la Associated Press y Axel Springer, por ejemplo), y están apareciendo modelos de pago por rastreo. La concesión de licencias es una decisión de negocio tanto como de SEO: un acuerdo puede traer ingresos y atribución, mientras que un bloqueo general protege la exclusividad a costa de la visibilidad.
Citabilidad
Los asistentes de IA citan las fuentes que exponen hechos con claridad, arriba, con fechas y fuentes nombradas. Los datos originales, las citas exclusivas y las explicaciones bien estructuradas se citan más que los cables reescritos. Nuestro estudio sobre citas de medios en IA muestra qué medios citan con más frecuencia los asistentes de IA.
¿Cómo medir el SEO para editores?
Separa los informes por superficie y tipo de contenido: última hora, perenne, hubs temáticos. Sigue en Search Console los informes de Web, Discover y Google Noticias por separado, el retraso de indexación de los artículos nuevos (tiempo entre la publicación y las primeras impresiones) y la proporción de tráfico procedente de páginas perennes. Para la visibilidad en IA, sigue una lista fija de preguntas sobre tus temas y comprueba si tu publicación es citada y qué competidor lo es en su lugar.
Sorank reúne estas señales: el panel de GEO y SEO sigue tus clics, impresiones y posiciones de Search Console, y el seguimiento de menciones en IA comprueba cada mes si ChatGPT, Claude y Gemini citan tu publicación en las preguntas que hacen tus lectores. El software también redacta y publica artículos perennes en autopilot, lo que encaja con el lado explicativo de una redacción más que con la última hora.
El SEO para editores significa hoy ser encontrado rápido en Google y ser la fuente que citan los asistentes de IA. Arregla primero la indexación y la confianza, protege el tráfico perenne y luego define con la dirección tu política de rastreadores de IA y de licencias. Para seguir la visibilidad en Google y en IA en un mismo lugar, consulta los planes de Sorank, con una prueba gratuita de 3 días.
Preguntas frecuentes
¿Hay que solicitar el alta para aparecer en Google Noticias?
No. Google encuentra los medios de noticias mediante su rastreo normal y los considera automáticamente para Top Stories, la pestaña de Noticias y la aplicación de Google Noticias si publican contenido de calidad y cumplen las políticas de contenido de Google Noticias. El Publisher Center es opcional y ayuda a gestionar el nombre de la publicación, su logotipo y sus secciones.
¿Debe un medio de noticias bloquear a los rastreadores de IA?
Depende del modelo de negocio. Bloquear rastreadores de entrenamiento como GPTBot protege el contenido del entrenamiento de modelos, mientras que bloquear rastreadores de búsqueda como OAI-SearchBot o PerplexityBot retira el sitio de las respuestas y citas de esos asistentes. Muchos editores bloquean los rastreadores de entrenamiento, permiten los de búsqueda y negocian las licencias por separado.
¿Cuánto tarda Google en indexar un artículo de noticias?
Los artículos bien enlazados en medios de noticias establecidos suelen rastrearse e indexarse en minutos, mientras que los sitios nuevos o lentos pueden esperar horas o días. Enlazar las noticias nuevas desde la portada y las páginas de sección, incluirlas en un sitemap de noticias y mantener bajos los tiempos de respuesta del servidor acorta el retraso.
y!
Auditoría SEO y GEO gratuita
Consiga gratis su plan de contenidos para 30 días
Analizamos a sus competidores, su sitio web y su visibilidad en las IA para crear gratis un plan de contenidos a medida.
“He probado Sorank en el sitio real de un cliente y es una locura. Hace todo aquello por lo que una agencia cobra 1.500 € al mes. Ahora se pone en producción en ese cliente.”Guillaume Guersanguersanguillaume.com
“Somos una agencia de publicidad y queríamos poner en marcha nuestro SEO de una vez por todas. Sorank nos dio una visión clara de nuestro sitio, nos ayudó a priorizar las optimizaciones y a estructurar correctamente nuestro contenido. La herramienta es fácil de usar, bien diseñada para un equipo y muy práctica para centralizar el seguimiento sin tener que hacer malabares entre varias plataformas. Una base muy sólida para empezar de nuevo con nuestro SEO.”Gaspard MadouiAgencia de Publicidad
“Me especialicé en GEO gracias a Sorank. El GEO Leaderboard me permite mostrar a mis clientes su posicionamiento frente a sus competidores en ChatGPT. Es un verdadero diferenciador comercial.”MélanieFreelancer SEO
Crecimiento orgánicoGeneración de leads para instaladores
“Excelente servicio, funciona bien para nuestro sitio web y nos ayuda a entender cómo mejorarlo para posicionarnos mejor en Google y en otros lugares. Felicitaciones, continúen así, se lo recomiendo.”Hugo T.Comerciante e-commerce