設定
当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら

当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら

パブリッシャー向けSEOガイド。Top Stories、Discover、ニュースサイトマップ、記事とペイウォールのマークアップ、AI回答での引用、ライセンス判断を解説します。
ツール

要点
パブリッシャー向けSEOとは、ニュースやメディアのサイトがGoogle検索、Top Stories、Google News、Discover、そして今ではAIアシスタントから集客するための一連の施策です。4つの柱に支えられています。新着記事の迅速なインデックス登録(ニュースサイトマップ、わかりやすいURL、内部リンク)、信頼のシグナル(署名、日付、訂正、執筆者ページ)、技術的なマークアップ(Article、ペイウォールと画像の要件)、そしてAIクローラーとライセンスに対する計画的な方針です。検索からの流入が減ったときは、長く読まれるコンテンツと読者への直接の導線がビジネスを守ります。
さらに詳しく知るには、こちらに質問
クイック診断
SEOはあなたに向いている?どう始めるべき?
Sorankはあなたの回答にぴったりです


ご自身のサイトで3日間お試しいただき、Google、ChatGPT、その他のAIでの現状をご確認ください。
3日間の無料トライアルを開始3日間無料、いつでも解約できます。90日間成果保証(成果が出なければ返金)。
パブリッシャー向けSEOが従来のSEOと違うのは、ニュースサイトが毎日数十から数百ページを公開し、その大半は48時間で価値を失う一方、長く読まれるアーカイブは何年にもわたって訪問を集め続けるからです。賭け金は大きくなっています。ロイター・ジャーナリズム研究所(Reuters Institute)のレポートJournalism, Media and Technology Trends and Predictions 2026(2026年1月)は、Chartbeatのデータを引用し、2500以上のニュースサイトへのGoogle検索トラフィックが2024年11月から2025年11月にかけて前年比33%減少したことを示しています。調査対象となった280人のメディア責任者は、検索からの参照がさらに3年で43%減ると見込んでいます。今日うまく最適化するとは、残っているトラフィックを守り、読者が次に訪れる場所で引用されることを意味します。本ガイドでは、ニュース面からAIの回答まで、出版社・メディア企業にとって何が変わるのかを扱います。
パブリッシャー向けSEOは、製品が編集コンテンツであるサイトに検索エンジン最適化を適用するものです。対象は新聞、雑誌、デジタルネイティブのメディア、業界専門誌、広告や購読で運営される大規模ブログなどです。3つの制約がこれを特徴づけます。
パブリッシャーは、ほとんどのサイトが決して目にすることのない面にも依存しています。Top Storiesのカルーセル、ニュースタブ、Google Newsアプリ、そして検索なしでユーザーにコンテンツを届けるフィードであるDiscoverです。
それぞれの面には固有の選定ロジックがあります。下の表は、表示を左右するものと、その測定場所をまとめたものです。
| 面 | コンテンツが入る経路 | 主なレバー | 測定場所 |
|---|---|---|---|
| 検索結果(青いリンク) | 通常のクロールと順位付け | 関連性、深さ、リンク、ページ体験 | Search Console、検索タイプ:ウェブ |
| Top Stories | ニュース性のある検索語句で自動的に表示 | 鮮度、そのトピックでの権威性、独自の取材 | Search Console、検索結果の表示形式フィルター |
| Google Newsアプリとニュースタブ | Google Newsのコンテンツポリシーに従って自動的に表示 | 透明性、日付、執筆者名、ポリシーへの準拠 | Search Console、Google Newsレポート |
| Discover | ユーザーの関心に基づいて自動的に表示 | 大きな画像、誠実なタイトル、タイムリーまたは独自のストーリー | Search Console、Discoverレポート |
| AIの概要とAIアシスタント | インデックス済みまたはクロール済みのページから取得 | 明確な事実、構造化された回答、クローラーのアクセス性、ブランドの権威性 | プロンプトのトラッキング、参照元の分析 |
Googleはパブリッシャー向けのヘルプセンターで、申し込みフォームは存在しないと説明しています。通常のクロールで見つかったサイトは、高品質なコンテンツを発信し、Google Newsのコンテンツポリシーに従っていれば、Top Storiesとニュースタブの対象として自動的に検討されます。Publisher Centerは、Google Newsアプリ上で媒体名、ロゴ、セクションを管理するために引き続き役立ちます。
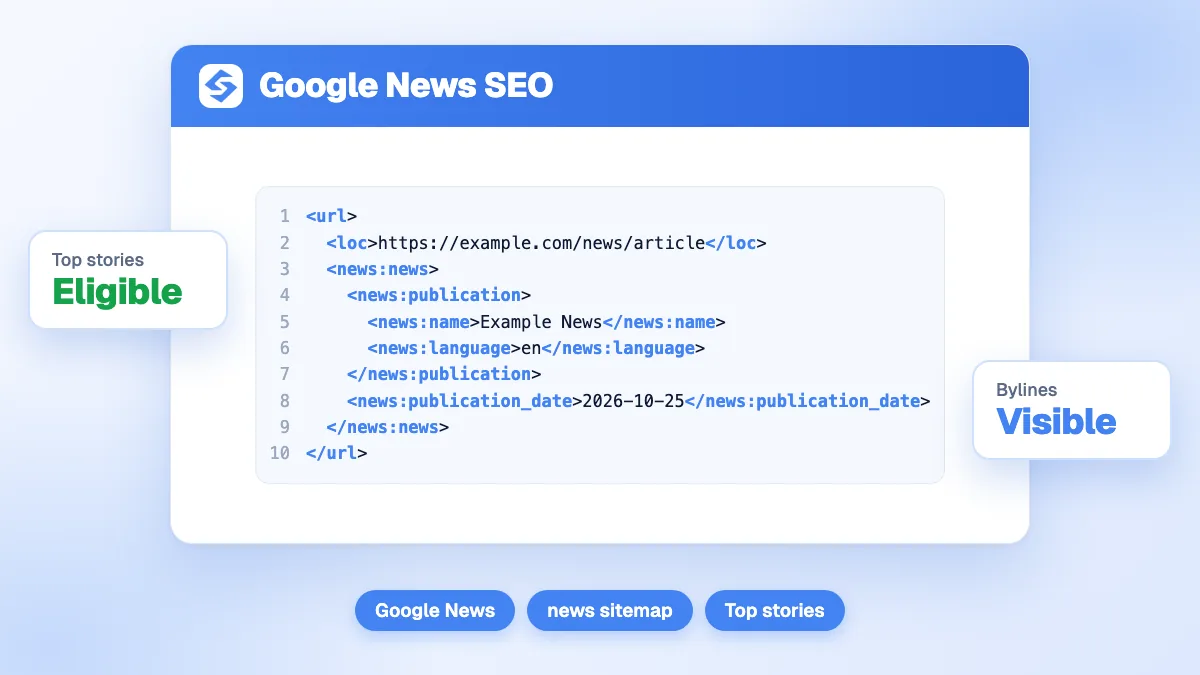
ニュースサイトマップには新しい記事だけを載せます。Googleのニュースサイトマップのドキュメントは、過去2日以内に作成された記事のURLだけを含めること、1ファイルあたり最大1000件のnews:newsエントリーを含めること、そしてnews:publication(名前と言語)、news:publication_date、news:titleのタグを必須とすることを求めています。媒体名はGoogle Newsに表示される名前と一致させる必要があります。アーカイブ全体のために、通常のXMLサイトマップも並行して維持してください。
Googlebotはトップページやセクションページに頻繁に戻ってきます。新しいストーリーを、これらのハブや関連する稼働中のページからリンクすると、どのサイトマップの通知よりも速くクロールされます。トピックページ(繰り返し登場するテーマ、人物、チームごとに1つ)はリンクを集め、繰り返し検索されるクエリで順位を得るための安定したURLをGoogleに提供します。
進展するニュースは、進展のたびに新しい記事を公開するのではなく、同じURLで更新し、公開日と最終更新日の両方を表示します。同じグループの複数の媒体が同じ記事を転載する場合は、元記事を指すcanonicalタグを使うと、互いに競合する重複を避けられます。
無限に組み合わさるタグ、サイト内検索ページ、カレンダーのアーカイブ、トラッキングパラメーターはクロールを薄めます。検索価値のないものはブロックするかnoindexにし、薄いタグページを監査してください(記事が2本しかないタグは誰の役にも立ちません)。
ヒント
大きなニュースの日の後は、Search Consoleのクロール統計レポートを確認してください。平均応答時間が上がると、Googlebotは速度を落とし、新しいストーリーはアーカイブページの後ろで順番待ちになります。
パブリッシャーにとって、3種類のマークアップが大部分の作業を担います。
datePublished、dateModified、そして執筆者ページへのリンクを持つauthor。Googleが正しい日付を表示し、ストーリーを正しく帰属させるのに役立ちます。isAccessibleForFreeをfalseに設定し、hasPartからcssSelectorで限定セクションを指すよう求めています。これによりGooglebotは全文を読めるようになり、Googleはペイウォールを、スパムポリシーに違反するクローキングと区別できます。構造化データだけで記事が順位を上げるわけではありませんが、誰が何をいつ書いたかについての曖昧さを取り除きます。これはGoogleにとっても、ページを解析する言語モデルにとっても重要です。AI検索のための構造化データのガイドでは、AIシステムが実際にどのプロパティを使っているかを説明しています。
Discoverは、多くのニュースやライフスタイルのパブリッシャーにとって重要な流入元ですが、もっとも変動の激しい流入元でもあります。GoogleのDiscoverのドキュメント(2026年3月更新)は、明確な条件を定めています。
max-image-preview:largeを有効にする。Search ConsoleのDiscoverレポートには、一定の最低基準に達すると、16か月分のクリック、表示回数、CTRが表示され、Chromeからのトラフィックも含まれます。Google Discoverの最適化に関する専用ガイドでは、画像とタイトルのテストをさらに詳しく扱っています。
注意
扇情的な見出しは、1週間ほどDiscoverのクリックを増やしたあと、リーチを減らしてしまうことがあります。Googleは、誤解を招くタイトルや、怒りや好奇心に訴える手法を、サイトのコンテンツの表示を減らす理由として明示しています。
信頼は、ページごとに、そしてサイト全体で築かれます。
収益化されたセクションにも注意が必要です。Googleのスパムポリシーは、サイトの評判の悪用を、ホストのランキングシグナルを主に利用する目的で第三者のコンテンツを公開することと定義しています。外部パートナーが編集的な統合なしに運営するクーポン、製品レビュー、スポンサーコンテンツのセクションは、ドメイン全体を危険にさらします。一方、編集部が選別し、明確に表示されたセクションは対象にはなりません。
速報はピークを生み、長く読まれるコンテンツは底堅い基盤を生みます。健全なパブリッシャーは両方を計画します。
AIの概要、ChatGPT、Perplexity、Geminiはニュースを要約し、事実に関する質問に直接答えるため、多くの情報系クエリでのクリックが減ります(Google AI Overviewsを参照)。パブリッシャーは現在、3つの判断を迫られています。
robots.txtでは、AIクローラーごとに許可またはブロックを個別に設定できます。OpenAIの学習用のGPTBot、ChatGPT検索用のOAI-SearchBot、PerplexityBot、ClaudeBotなどです。Google-Extendedは、コンテンツをGeminiの学習と根拠づけに使うかどうかを制御する別のトークンです。Googleによれば、これはGoogle検索でのインデックス登録やランキングには影響しません。検索を目的としたボットをブロックすると、それらの回答から外れてしまうため、多くのパブリッシャーは学習用ボットをブロックし、検索用ボットは許可しています。AIクローラー向けのrobots.txtのガイドには、ユーザーエージェントの一覧があります。
大手AI企業はパブリッシャーとコンテンツ契約を結んでおり(たとえばOpenAIとAssociated Press、Axel Springerなど)、クロールごとに支払う新しいモデルも登場しています。パブリッシャーのライセンス供与は、SEOの判断であると同時に事業の判断です。契約は収益と出典表示をもたらす可能性がある一方、全面的なブロックは、独占性を守る代わりに可視性を犠牲にします。
AIアシスタントは、事実を明確に、冒頭近くで示し、日付と出典を明記しているソースを引用します。独自データ、独占的な引用、よく構成された解説は、書き直された通信記事よりも引用されやすくなります。メディアのAI引用に関する調査では、AIアシスタントがもっとも頻繁に引用するメディアを示しています。
レポートを面とコンテンツの種類ごとに分けてください。速報、長く読まれるコンテンツ、トピックのハブです。Search Consoleでは、ウェブ、Discover、Google Newsのレポートを個別に追跡し、新しい記事のインデックス遅延(公開から最初の表示までの時間)と、長く読まれるページからのトラフィックの割合を確認します。AIの可視性については、自社のテーマに関する固定の質問リストを追跡し、自社の媒体が引用されているか、代わりにどの競合が引用されているかを確認してください。

Sorankはこれらのシグナルを一つにまとめます。GEOとSEOのダッシュボードはSearch Consoleのクリック、表示回数、掲載順位を追跡し、AIでの言及のトラッキングは、読者が尋ねる質問に対してChatGPT、Claude、Geminiが自社の媒体を毎月引用しているかどうかを確認します。このソフトウェアは、長く読まれる記事をautopilotで作成・公開することもでき、速報よりも編集部の解説面に向いています。
今日のパブリッシャー向けSEOとは、Googleで素早く見つけてもらえるようになり、AIアシスタントが引用する情報源になることを意味します。まずインデックス登録と信頼を整え、長く読まれるトラフィックを守り、そのうえで経営陣とともにAIクローラーとライセンスの方針を決めてください。GoogleとAIの両方の可視性を一か所で追跡するには、Sorankのプランをご覧ください。3日間の無料トライアルがあります。

いいえ。Googleは通常のクロールでニュースサイトを見つけ、高品質なコンテンツを発信し、Google Newsのコンテンツポリシーに従っていれば、Top Stories、ニュースタブ、Google Newsアプリの対象として自動的に検討します。Publisher Centerは任意で、媒体名、ロゴ、セクションを管理するのに役立ちます。
それはビジネスモデルによります。GPTBotのような学習用クローラーをブロックすれば、コンテンツをモデルの学習から守れます。一方、OAI-SearchBotやPerplexityBotのような検索用クローラーをブロックすると、そのアシスタントの回答や引用からサイトが外れてしまいます。多くのパブリッシャーは学習用ボットをブロックし、検索用ボットは許可し、ライセンスは別途交渉しています。
確立されたニュースサイトで適切にリンクされた記事は、数分以内にクロールされ、インデックスされることがよくあります。一方、新しいサイトや遅いサイトでは、数時間から数日待たされることもあります。新しいストーリーをトップページやセクションページからリンクし、ニュースサイトマップに掲載し、サーバーの応答時間を低く保つことで、この遅れは短くなります。
競合、あなたのサイト、AIでの可視性を分析し、あなた専用のコンテンツプランを無料で作成します。
 AI コンテンツブリーフ生成ツール
 FAQ スキーマ生成ツール
 AI ブログ記事アイデア生成ツール
 構造化データ検証ツール(スキーマバリデーター)
 代替テキストチェッカー
 内部リンク分析ツール
 被リンクチャレンジ
 AI メタディスクリプション生成ツール
 AI ブログタイトル生成ツール
 Google インデックス可否チェッカー
 AI 記事構成案生成ツール
 UTM リンク作成ツール
 キーワードのグループ化ツール
 canonical タグチェッカー
 XML サイトマップ生成ツール
 リンク切れチェッカー
 AI SEO タイトル生成ツール
 見出しアナライザー
 検索結果プレビューツール
 リダイレクトチェッカー
 hreflang タグ生成ツール
 見出し構造チェッカー
 HTTP ヘッダーチェッカー
 Favicon 抽出ツール
 SEO トラフィック・売上予測計算ツール
 SEO 予算計算ツール
 順位上昇シミュレーター
 キーワード機会スコア計算ツール
 GEO コンテンツ投資計算ツール
 顧客生涯価値計算ツール
 CTR 計算ツール
 AI トラフィック価値計算ツール
 AI シェア・オブ・ボイス計算ツール
 Gemini ランキングツール
 ROAS 計算ツール
 自然検索トラフィック価値計算ツール
 ローカル SEO ROI 計算ツール
 被リンク獲得コスト計算ツール
 キーワード密度計算ツール
 顧客獲得コスト計算ツール
 記事単価計算ツール
 直帰率計算ツール
 AI 引用率計算ツール
 LLM 向け構造化データ監査
 llms.txt ジェネレーター
 Sitemap チェッカー
 SERP 変動センサー
 文字数カウンター
 Schema マークアップ生成ツール
 キーワード調査ツール
 SEO 損益分岐点計算ツール
 読了時間計算ツール
 自然検索トラフィック予測ツール・サイトのアクセス数チェック
 ChatGPT 参照トラフィック予測ツール
 AI 可視性スコア計算ツール
 AI 可読性チェッカー
 SearchGPT 対応チェッカー
 ChatGPT が自社サイトを推薦しない理由
 URL 抽出ツール
 ウェブページ Markdown 変換ツール
 robots.txt 生成ツール
 Open Graph プレビュー
 オンページ SEO 監査:SEO チェッカーと SEO 分析ツール
 LTV:CAC 比率計算ツール
 GEO ROI 計算ツール
 コンバージョン率計算ツール
 AI クローラー巡回監査
 AI 検索可視性テスト
 ページサイズチェッカー
 URL スラッグ生成ツール
 メタタグ生成ツール
 画像圧縮ツール
 ファビコン生成ツール
 ドメインオーソリティチェッカー
 検索結果 CTR 計算ツール
 EC SEO ROI 計算ツール
 コンテンツマーケティング ROI 計算ツール
 AI での不可視コスト計算ツール
 AI Overviews チェッカーと AI Overviews 順位チェック
 robots.txt チェッカー
 SEO・AI 監査
 Perplexity ランキングチェッカー
 アンサーエンジン最適化の監査
 ChatGPT 可視性チェッカー
 被リンク分析ツール
 SEO とリスティング広告の節約額計算ツール
 SEO シェア・オブ・ボイス計算ツール
 SaaS SEO ROI 計算ツール
 被リンク ROI 計算ツール
 llms.txt バリデーター
 LLM 引用チェッカー
 GEO 監査
 SEO ROI 計算ツール
 キーワード価値計算ツール
先行導入企業のご紹介
 “2年間、クライアントの100%がLinkedIn経由でした。毎日の投稿、コメント、DMでのフォローアップ…完全にアルゴリズム頼みでした。SEOに取り組むべきだとわかっていても、時間がかかる、技術的すぎる、自分の仕事ではないと、いつも後回しにしていました。Sorankでようやく一歩を踏み出しました。4か月で、何も投稿しなくても毎月15件のオーガニックリードを獲得しています。まだLinkedInと半々ではありませんが、自動で育つ2つ目のリード源ができたことで安心して眠れるようになりました。”
 Valentin Thomyコールドメール専門エージェンシー“Sorankは、クライアントに提供する成果を大きく変えてくれました。AIが実際に使っているキーワードを特定し、特定の競合が引用される理由を理解し、以前は完全に見落としていたチャンスを見つけられるようになりました。クライアントは、より早い順位上昇、AIの回答での可視性向上、そしてすべての施策のROIがより明確になったことを実感しています。”
 Benjamin Rouxovirank.com
 “私はマーケターではなく開発者です。私のShopifyテーマは口コミと広告だけで売れていました。Sorankのおかげで、SEOの組み立て方と上位表示される記事の書き方がようやくわかりました。監査で商品ページが遅すぎることも判明しました。2か月でオーガニックトラフィックは2倍になり、ShopifyテーマについてChatGPTで検索されたときの回答にも表示され始めています。しかも、週に約2時間の作業だけです。”
 Thème FullStackgo.themefullstack.com“Sorankのおかげで、私たちのSEOエージェンシーの働き方は大きく変わりました。すべてが一元化・自動化されたため、クライアント1社あたりにかける時間が大幅に減りました。以前は何時間もかかっていた作業が今では数分で終わり、ようやくビジネスの中で働くのではなく、ビジネスそのものに取り組めるようになりました。”
 Océane Bondismaison-leverage.com