העדפות
הפרטיות חשובה לנו, ולכן יש לך אפשרות להשבית סוגים מסוימים של אחסון שייתכן שאינם נחוצים לתפקוד הבסיסי של האתר. חסימת קטגוריות עלולה להשפיע על חווית השימוש שלך באתר. מידע נוסף

הפרטיות חשובה לנו, ולכן יש לך אפשרות להשבית סוגים מסוימים של אחסון שייתכן שאינם נחוצים לתפקוד הבסיסי של האתר. חסימת קטגוריות עלולה להשפיע על חווית השימוש שלך באתר. מידע נוסף

מדריך SEO ל-Next.js: בחירה בין SSG, SSR ו-ISR, הגדרת מטא-דאטה וקנוניקל, יצירת sitemap.xml, בלוג שמוזן ב-webhook ותוכן שה-AI יכולה לקרוא.
כלים


בקצרה
Next.js הוא אחד מתשתיות ה-React הטובות ביותר ל-SEO, כי הוא שולח לסורקים HTML מלא במקום מעטפת ריקה. כדי להתברג גבוה, רנדרו מראש את עמודי התוכן (יצירה סטטית או ISR), הגדירו כותרות, תיאורים וקנוניקל עם Metadata API, צרו את sitemap.xml ואת robots.txt מתוך תיקיית app, השתמשו בקישורים אמיתיים ובקודי סטטוס נכונים, והשאירו את התוכן המרכזי מחוץ לקוד שרץ רק בדפדפן, כי רוב הסורקים של ה-AI לא מריצים JavaScript.
רוצים להעמיק? שאלו את
שאלון קצר
האם SEO מתאים לכם, ואיך להתחיל?
4 שאלות קצרות כדי לראות אם Google יכול להביא לכם לקוחות.
ההמלצה שלנו עבורכם
Sorank הוא הפתרון הנכון עבורכם
אנשים מחפשים את מה שאתם מוכרים ואתם יכולים לחכות כמה חודשים: Sorank מוצא את החיפושים הנכונים, כותב ומפרסם את המאמרים ומשיג לכם קישורים.
Sorank מתאים לתשובות שלכם
נסו אותו 3 ימים באתר שלכם, או התחילו בבדיקה חינמית כדי לראות איפה אתם עומדים.
3 ימים חינם, ואז מפסיקים מתי שרוצים. אחריות להחזר כספי למשך 90 יום.
SEO ב-Next.js הוא בעיקר בחירה נכונה בכל נתיב: מה מרונדר בשרת, מה נשמר במטמון, ומה מגיע ל-HTML לפני שסקריפט כלשהו רץ. Google מסבירה ביסודות ה-SEO ל-JavaScript שהיא מעבדת אפליקציות JavaScript בשלושה שלבים (סריקה, רינדור, הוספה לאינדקס) ושרינדור בצד השרת או רינדור מוקדם "הוא עדיין רעיון מצוין". Next.js עושה זאת כברירת מחדל. המדריך עוסק ב-App Router (מ-Next.js 13 ואילך), עם הערות ל-Pages Router הישן.
כן. אפליקציית React רגילה שמרונדרת בצד הלקוח שולחת קובץ HTML כמעט ריק ובונה את העמוד בדפדפן; מנועי החיפוש צריכים לרנדר אותו, ובוטים רבים לא עושים זאת אף פעם. Next.js מרנדר את React בשרת, כך שתגובת ה-HTML כבר כוללת כותרות, טקסט, קישורים ומטא-דאטה. המדריך שלנו ל-SEO ל-JavaScript מסביר למה ההבדל הזה חשוב להוספה לאינדקס.
ב-App Router הרכיבים הם Server Components כברירת מחדל. גם רכיבים שמסומנים ב-'use client' מרונדרים מראש ל-HTML בשרת. נקודת התורפה היא הנתונים: כל מה שנטען בתוך useEffect, או רק אחרי לחיצה, חסר ב-HTML הראשוני. טענו את התוכן ב-Server Components ושמרו את רכיבי הלקוח לאינטראקטיביות.
Next.js מאפשר לשלב מצבים שונים בכל נתיב. הבחירה משפיעה על עדכניות, מהירות ועל מה שהסורקים מקבלים.
| מצב | מתי נוצר ה-HTML | שורה תחתונה ל-SEO | מתאים ל |
|---|---|---|---|
| יצירה סטטית (SSG) | בזמן ה-build | הטוב ביותר: HTML מלא, מהיר מאוד | דפי נחיתה, תיעוד, מאמרים נצחיים |
| Incremental Static Regeneration (ISR) | ב-build, ואז מתרענן ברקע או לפי דרישה | הטוב ביותר לאתרים גדולים או משתנים | בלוגים, קטלוגי מוצרים, עמודי CMS |
| רינדור בצד השרת (SSR) | בכל בקשה | טוב: HTML מלא, תלוי במהירות השרת | עמודים מותאמים אישית או בזמן אמת |
| רינדור בצד הלקוח (CSR) | בדפדפן | חלש: התוכן לא נראה לרוב הבוטים | לוחות בקרה מאחורי התחברות |
התיעוד של Next.js על ISR מונה את היתרונות: עדכון תוכן סטטי "בלי לבנות מחדש את כל האתר" וניהול כמויות גדולות של עמודים בלי זמני build ארוכים. נתיב עם export const revalidate = 3600 נוצר מחדש לכל היותר פעם בשעה; לשליטה מדויקת, קראו ל-revalidatePath או ל-revalidateTag כשהתוכן משתנה. ISR לא עובד עם ייצוא סטטי (output: 'export'). לאפליקציות שחייבות להישאר מרונדרות בצד הלקוח, המדריך שלנו ל-SEO לאפליקציות עמוד יחיד מציג את הפתרונות.
טיפ
בדקו מה הבוטים מקבלים ולא מה שהדפדפן שלכם מציג: הריצו curl על הכתובת או פתחו view-source וחפשו משפט מהמאמר. אם הוא לא מופיע ב-HTML הגולמי, הוא תלוי ב-JavaScript.
Metadata API מחליף את next/head ב-App Router. לפי התיעוד של Next.js על מטא-דאטה, מייצאים אובייקט metadata סטטי מ-layout או מעמוד, או פונקציה generateMetadata כשהערכים תלויים בנתונים, ו-Next.js מייצר את תגיות ה-head. שניהם נתמכים רק ב-Server Components.
export async function generateMetadata({ params }) {
  const { slug } = await params
  const post = await getPost(slug)
  return {
    title: post.title,
    description: post.excerpt,
    alternates: { canonical: `/blog/${slug}` },
    openGraph: { images: [post.cover] },
  }
}
חמישה כללים שמונעים את רוב הבעיות:
בעמודים דינמיים Next.js משדר את המטא-דאטה בזרם אחרי הבייטים הראשונים כדי להאיץ את הרינדור. לפי התיעוד, השידור בזרם מושבת לבוטים שמצפים למטא-דאטה בתוך ה-head ומזוהים לפי ה-user agent (Bingbot, Twitterbot ו-Slackbot הם חלק מהדוגמאות), והאפשרות htmlLimitedBots מאפשרת להתאים את הרשימה. אם סורק שחשוב לכם לא מופיע בה, הוסיפו אותו. ב-Pages Router המקבילה היא רכיב Head מ-next/head, עם מאפיין key כדי למנוע תגיות כפולות.
שניהם קבצים מיוחדים בתיקיית app. קובץ sitemap.ts שמייצא פונקציה שמחזירה כתובות הופך ל-/sitemap.xml; קובץ robots.ts הופך ל-/robots.txt. התיעוד של מפת האתר מציין שהקובץ נשמר במטמון כברירת מחדל ושהמגבלה של Google היא 50,000 כתובות למפת אתר; מעבר לכך, generateSitemaps מפצל אותה לכמה קבצים.
import type { MetadataRoute } from 'next'

export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  const posts = await getPosts()
  return posts.map((p) => ({
    url: `https://example.com/blog/${p.slug}`,
    lastModified: p.updatedAt,
  }))
}
כללו רק כתובות קנוניות, שניתנות לאינדוקס ומחזירות 200, עם תאריך העדכון האמיתי ב-lastModified. מפת האתר מקבלת גם alternates.languages לאתרים רב-לשוניים. ב-robots.ts הפנו למפת האתר והחליטו אילו בוטים של AI רשאים לסרוק את האתר; המאמר שלנו על robots.txt לסורקי AI מפרט אותם. עוד על הפורמט בערך שלנו על מפת אתר XML.
| בעיה | מה קורה | פתרון |
|---|---|---|
| ניווט עם onClick ו-router.push | Google עוקבת רק אחרי רכיבי a עם href | להשתמש ברכיב Link מ-next/link, שמייצר קישור אמיתי |
| תוכן שלא קיים מוגש כעמוד 200 | "Soft 404" ב-Search Console | לקרוא ל-notFound() כדי שהנתיב יחזיר סטטוס 404 |
| הפניות זמניות לעמודים שעברו | redirect() שולח 307 | להשתמש ב-permanentRedirect() או ב-permanent: true ב-next.config (308) |
| לוכסנים מעורבים בסוף הכתובת | שתי כתובות לאותו עמוד | לבחור אחת עם האפשרות trailingSlash ולשמור על קנוניקל עקבי |
| סביבות תצוגה מקדימה או staging באינדקס | עותקים כפולים של האתר ב-Google | לשלוח noindex בדומיינים שאינם סביבת ייצור |
| תוכן לשוניות שנטען בלחיצה | הטקסט חסר ב-HTML | לרנדר את כל התוכן בשרת ולהסתיר ב-CSS אם צריך |
כל הבעיות האלה פוגעות ביכולת הסריקה: סורק צריך לגלות כל כתובת דרך קישורים ולקבל קוד סטטוס נקי.
התיעוד של Next.js ממליץ לרנדר JSON-LD בתגית script מסוג application/ld+json ישירות ברכיב העמוד או ה-layout, מאותם נתונים של העמוד, ולבצע escape לתו < ב-JSON המסודר כדי למנוע הזרקה. מכיוון שהוא מרונדר בשרת, Google וסורקי ה-AI רואים אותו ב-HTML הגולמי. השתמשו ב-Article (או BlogPosting) לפוסטים, ב-Organization ב-layout הראשי, ב-BreadcrumbList לעמודים עמוקים וב-Product במסחר מקוון. מחולל schema נותן לכם בלוק תקין להתחלה, ואחר כך בדקו את העמוד בבדיקת התוצאות העשירות של Google.
Next.js מגיע עם רכיבים שמטפלים בגורמים הנפוצים לציוני Core Web Vitals נמוכים:
מדדו נתוני שטח ולא רק ציון מעבדה: המדריך שלנו ל-PageSpeed Insights מראה איך לקרוא את שניהם.
בלוג ב-Next.js מגיע בדרך כלל באחת משלוש צורות: קובצי MDX או Markdown במאגר הקוד (פשוט, אבל כל פוסט דורש commit ופריסה), CMS ללא ראש (Sanity, Contentful, Strapi, Payload) שנשאל מתוך Server Components, או webhook לפרסום שמקבל מאמרים מכלי חיצוני. בשלושת המקרים דפוס ה-SEO זהה: נתיב דינמי app/blog/[slug] עם generateStaticParams, generateMetadata, ISR, מפת אתר שמוזנת מאותו מקור ועמוד אינדקס שמקשר לכל הפוסטים.
ה-webhook מנתק את הפרסום ממחזור הפריסה. Route Handler מקבל את המאמר, שומר אותו ואז מאמת מחדש את העמודים הרלוונטיים:
// app/api/publish/route.ts
import { revalidatePath } from 'next/cache'

export async function POST(request) {
  if (request.headers.get('authorization') !== `Bearer ${process.env.PUBLISH_SECRET}`) {
    return new Response('Unauthorized', { status: 401 })
  }
  const article = await request.json()
  await savePost(article)
  revalidatePath('/blog')
  revalidatePath(`/blog/${article.slug}`)
  return Response.json({ ok: true })
}
שימו לב
הגנו על נקודת הקצה באמצעות סוד, ואמתו מחדש את הנתיב הציבורי המדויק. התיעוד של ISR מזהיר שעם כמה מופעי שרת ומטמון הקבצים שמוגדר כברירת מחדל, אימות מחדש לפי דרישה מנקה רק את המופע שמקבל את הקריאה; השתמשו במנהל מטמון משותף.
רינדור בשרת הוא התנאי הראשון ל-GEO (אופטימיזציה למנועים גנרטיביים). הניתוח של Vercel מדצמבר 2024, The rise of the AI crawler, מצא ש"אף אחד מסורקי ה-AI הגדולים לא מרנדר כיום JavaScript", מנה את GPTBot, ChatGPT-User, OAI-SearchBot, ClaudeBot ו-PerplexityBot, וספר 569 מיליון בקשות של GPTBot ו-370 מיליון של Claude ברשת שלו בחודש אחד. עמוד Next.js שמרנדר מראש את הטקסט, הכותרות וה-JSON-LD קריא לכולם; עמוד שמרונדר בצד הלקוח לא.
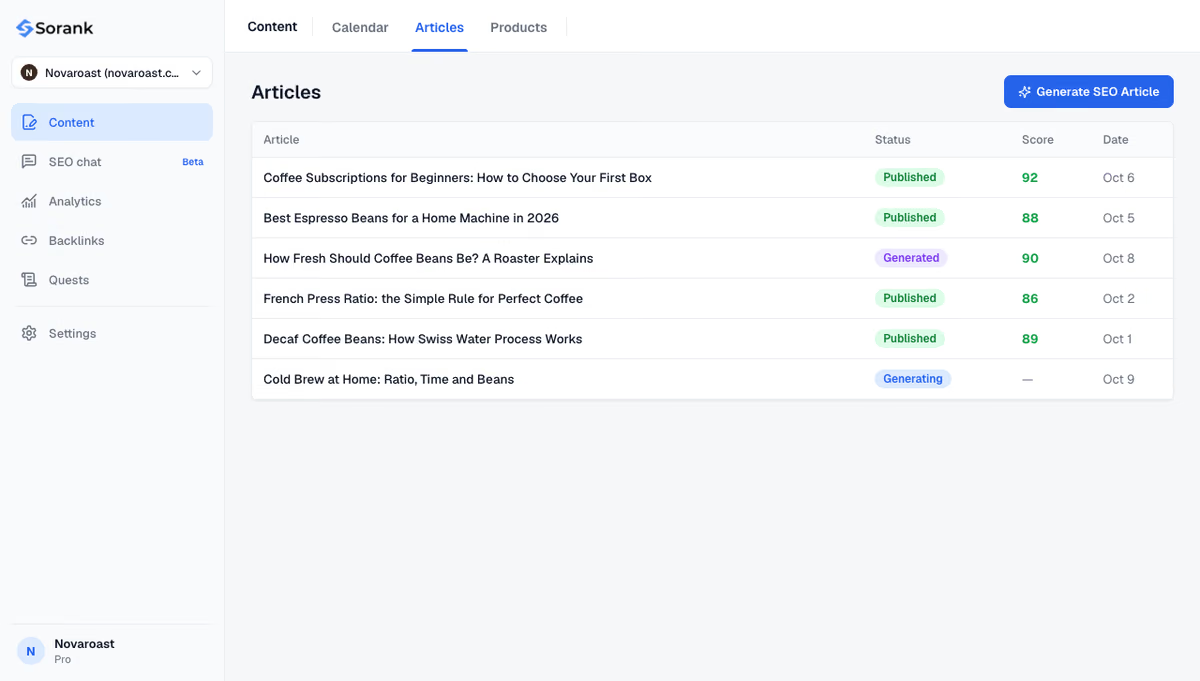
התנאי השני הוא תוכן שראוי לציטוט: מאמרים שעונים על שאלה אחת בכל חלק, עם מקורות, נתונים והגדרות ברורות, שמתפרסמים באופן קבוע. את החלק הזה Sorank, המוצר שלנו, הופכת לאוטומטי. Sorank היא תוכנת SEO ו-GEO במצב autopilot: היא מוצאת את מילות המפתח שלכם, ומחולל מאמרי הבלוג שלה כותב 20, 60 או 120 מאמרים בחודש עם מקורות, קישורים פנימיים ותמונות. באתר Next.js היא מתחברת דרך ה-webhook המותאם שמתואר בעמוד ההתקנה: ה-Route Handler שלכם מקבל כל מאמר, שומר אותו ומאמת מחדש את הבלוג. מעקב האזכורים ב-AI בודק לאחר מכן כל שבוע אם ChatGPT, Claude ו-Gemini מצטטים את המותג שלכם.
בשורה התחתונה: רנדרו מראש כל עמוד שאתם רוצים שימצאו, הגדירו מטא-דאטה בשרת והזינו את מפת האתר מאותו מקור כמו התוכן. Next.js נותן את הכלים; הדירוגים והציטוטים ב-AI נובעים ממה שאתם מפרסמים בעזרתם. כדי להזין בלוג Next.js במאמרים באופן שוטף, ראו את התוכניות של Sorank, החל מ-49$ לחודש עם 3 ימי ניסיון חינם.

Next.js בנוי על React, ולכן ההשוואה היא בין שיטות רינדור. אפליקציית React רגילה מסוג עמוד יחיד מרונדרת בדפדפן ושולחת HTML כמעט ריק, ואילו Next.js מרנדר מראש את העמודים בשרת או בזמן ה-build. סורקים, כולל בוטים של AI שלא מריצים JavaScript, מקבלים מ-Next.js תוכן מלא בלי הגדרות נוספות.
לא מעצמו. ב-App Router מוסיפים לתיקיית app קובץ sitemap.ts שמחזיר את הכתובות שלכם, ו-Next.js מגיש אותו בכתובת /sitemap.xml. באתרים גדולים, generateSitemaps מפצל את הרשימה לכמה קבצים, כי Google מקבלת עד 50,000 כתובות למפת אתר.
שניהם יכולים להתברג היטב כי שניהם מרנדרים HTML מראש. App Router הוא הבחירה המומלצת לפרויקטים חדשים: Server Components מצמצמים את ה-JavaScript בצד הלקוח, ו-Metadata API, sitemap.ts ו-robots.ts מטפלים בקובצי ה-SEO באופן מובנה. באתר קיים על Pages Router, מעבר משתלם רק לעיתים רחוקות בשביל SEO בלבד.
 מחולל תדריך תוכן בבינה מלאכותית
 מחולל סכמת FAQ
 מחולל רעיונות למאמרים בבינה מלאכותית
 בודק נתונים מובנים
 בודק טקסט חלופי
 מנתח קישורים פנימיים
 אתגר הבקלינקים
 מחולל תיאורי מטא ב-AI
 מחולל כותרות לבלוג ב-AI
 בודק יכולת אינדוקס ב-Google
 מחולל מבנה מאמר ב-AI
 מחולל קישורי UTM
 כלי לקיבוץ מילות מפתח
 בודק תגית קנונית
 מחולל מפת אתר XML
 בודק קישורים שבורים
 מחולל כותרות SEO ב-AI
 מנתח כותרות
 תצוגה מקדימה של תוצאות Google
 בודק הפניות
 מחולל תגיות hreflang
 מנתח מבנה כותרות
 בודק כותרות HTTP
 מחלץ Favicon
 מחשבון נתח קול ב-SEO
 מחשבון תחזית תנועה והכנסות SEO
 מחשבון תקציב SEO
 סימולטור שיפור דירוג
 מחשבון השקעה בתוכן GEO
 מחשבון CTR
 מחשבון חיסכון: SEO מול חיפוש ממומן
 מחשבון ציון הזדמנות למילת מפתח
 מחשבון תנועת הפניה מ-ChatGPT
 מחשבון נתח קול ב-AI
 כלי דירוג Gemini
 מחולל llms.txt
 בודק Sitemap
 ממיר עמודי אינטרנט ל-Markdown
 מונה מילים
 מחולל Schema
 תצוגה מקדימה של Open Graph
 כלי לדחיסת תמונות
 כלי לניתוח קישורים נכנסים
 מחשבון נקודת איזון ל-SEO
 מחשבון זמן קריאה
 מחשבון ROI ל-GEO
 מחשבון ROI לקישורים נכנסים
 בדיקת נתונים מובנים עבור LLM
 ביקורת GEO
 חיישן תנודתיות בתוצאות החיפוש
 מחולל כתובות URL
 מחולל תגיות מטא
 כלי מחקר מילות מפתח
 מחשבון CTR בתוצאות החיפוש
 מחשבון ROI ל-SEO
 מחשבון יחס LTV ל-CAC
 מעריך תנועה אורגנית
 מחשבון עלות בניית קישורים
 מחשבון ערך חיי לקוח
 מחשבון עלות למאמר
 מחשבון שיעור המרה
 מחשבון שיעור נטישה
 מחשבון ערך התנועה מ-AI
 בודק AI Overview
 ביקורת AI SEO
 אודיט אופטימיזציה למנועי תשובות
 מחשבון ROI ל-SEO של SaaS
 מחשבון ROAS
 מחשבון ROI ל-SEO מקומי
 מחשבון ערך מילת מפתח
 מחשבון צפיפות מילות מפתח
 מחשבון ROI ל-SEO בסחר אלקטרוני
 מחשבון עלות רכישת לקוח
 מחשבון ROI לשיווק תוכן
 מחשבון ציון נראות ב-AI
 מחשבון עלות ההיעדרות מתשובות ה-AI
 מחשבון שיעור ציטוט בבינה מלאכותית
 בודק ציטוטי LLM
 בדיקת SEO בעמוד
 מחשבון ערך תנועה אורגנית
 מאמת llms.txt
 בודק קריאות ל-LLM
 בדיקת מוכנות ל-SearchGPT
 בדיקת סריקה לסורקי בינה מלאכותית
 למה ChatGPT לא ממליץ על האתר שלי
 בודק דירוג ב-Perplexity
 בדיקת נראות בחיפוש מבוסס AI
 בודק נראות ב-ChatGPT
 מחלץ כתובות URL
 בודק גודל עמוד
 מחולל robots.txt
 מחולל Favicon
 בודק robots.txt
 בודק סמכות דומיין
הם ניסו את Sorank לפניכם
 “אנחנו סוכנות פרסום (Ads) ורצינו סוף סוף להחזיר את ה-SEO שלנו למסלול. Sorank נתנה לנו תמונה ברורה של האתר שלנו, עזרה לנו לתעדף אופטימיזציות ולבנות נכון את התוכן. הכלי קל לשימוש, מעוצב היטב לעבודת צוות, ומאוד מעשי לריכוז המעקב בלי לקפוץ בין מספר פלטפורמות. בסיס איתן מאוד לפתיחת דף חדש עם ה-SEO שלנו.”
 Gaspard Madouiסוכנות פרסום (Ads)“במשך שנתיים, 100% מהלקוחות שלי הגיעו מ-LinkedIn. פרסום יומי, תגובות, מעקבים בהודעות פרטיות... תלות מוחלטת באלגוריתם. ידעתי שאני צריך לעבוד על SEO אבל תמיד דחיתי את זה: ארוך מדי, טכני מדי, לא התחום שלי. עם Sorank, סוף סוף עשיתי את הצעד. בתוך 4 חודשים, אני מייצר 15 לידים אורגניים בחודש בלי לפרסם כלום. זה עדיין לא 50/50 מול LinkedIn, אבל אני ישן טוב יותר בידיעה שיש לי עכשיו מקור לידים שני שגדל באופן אוטומטי.”
 Valentin Thomyסוכנות ColdMailing
 “פשוט נתתי לתוכנה של Sorank לעשות את שלה, ועכשיו ציון DR של האתר שלי הוא 25 והדף שלי מדורג גבוה יותר.”
 Lucas Flandrefoundertrace.fr“פתרון מצוין לניהול SEO בלי כאב ראש. הביקורות מהירות, הממשק ברור, ואתה רואה במהירות אילו פעולות ליישם. זה הפך לכלי חיוני למעקב ולשיפור ה-SEO של האתרים שלי. ממליץ בחום.”
 Xavיזם