設定
当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら

当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら

Next.js SEOガイド:SSG・SSR・ISRの選び方、メタデータとcanonicalの設定、sitemap.xmlの生成、webhookで更新するブログ、AIクローラーに読まれるページ作り。
ツール


要点
Next.jsは、クローラーに空の枠ではなく完全なHTMLを返すため、SEOに最も適したReactフレームワークのひとつです。上位表示を狙うなら、コンテンツページを事前レンダリング(静的生成またはISR)し、Metadata APIでタイトル・説明文・canonicalを定義し、appフォルダからsitemap.xmlとrobots.txtを生成し、本物のリンクと正しいステータスコードを使い、主要なコンテンツをブラウザでしか動かないコードの外に置いてください。多くのAIクローラーはJavaScriptを実行しないからです。
さらに詳しく知るには、こちらに質問
クイック診断
SEOはあなたに向いている?どう始めるべき?
4つの簡単な質問で、Googleから集客できるかがわかります。
あなたへのおすすめ
Sorank があなたに合ったソリューションです
あなたの商品が検索されていて、数か月待てる方へ。Sorankは適切な検索語を見つけ、記事を書いて公開し、リンクも獲得します。
Sorankはあなたの回答にぴったりです
ご自身のサイトで3日間お試しいただくか、まず無料の診断で現状をご確認ください。
3日間無料、いつでも解約できます。90日間返金保証。
Next.js SEOの本質は、ルートごとに正しく選ぶことです。何をサーバーでレンダリングし、何をキャッシュし、どのスクリプトが動く前に何をHTMLに含めるか。GoogleはJavaScript SEOの基本で、JavaScriptアプリをクロール、レンダリング、インデックス登録の3段階で処理すると説明し、サーバーサイドレンダリングや事前レンダリングは「今でも優れた方法」だと述べています。Next.jsはこれを標準で行います。本ガイドはApp Router(Next.js 13以降)を対象に、旧来のPages Routerについても補足します。
はい。クライアントサイドレンダリングの一般的なReactアプリは、ほぼ空のHTMLを送り、ブラウザでページを組み立てます。検索エンジンはそれをレンダリングする必要があり、多くのボットはまったくレンダリングしません。Next.jsはReactをサーバーでレンダリングするため、HTMLレスポンスの時点で見出し、本文、リンク、メタデータが含まれています。この違いがインデックス登録にどう影響するかは、JavaScript SEOのガイドで解説しています。
App Routerでは、コンポーネントはデフォルトでServer Componentsです。'use client'を付けたコンポーネントも、サーバーでHTMLとして事前レンダリングされます。弱点はデータです。useEffectの中や、クリック後に初めて読み込む内容は、初期HTMLに含まれません。コンテンツはServer Componentsで取得し、クライアントコンポーネントはインタラクションだけに使いましょう。
Next.jsではルートごとに方式を組み合わせられます。選択は鮮度、速度、そしてクローラーが受け取る内容に影響します。
| 方式 | HTMLが作られるタイミング | SEOの評価 | 向いている用途 |
|---|---|---|---|
| 静的生成(SSG) | ビルド時 | 最良:完全なHTMLで非常に高速 | ランディングページ、ドキュメント、定番記事 |
| インクリメンタル静的再生成(ISR) | ビルド時、その後バックグラウンドまたはオンデマンドで更新 | 大規模・更新の多いサイトに最良 | ブログ、商品カタログ、CMSのページ |
| サーバーサイドレンダリング(SSR) | リクエストごと | 良好:完全なHTML、サーバー速度に依存 | パーソナライズやリアルタイムのページ |
| クライアントサイドレンダリング(CSR) | ブラウザ内 | 弱い:多くのボットに内容が見えない | ログイン後の管理画面 |
Next.jsのISRドキュメントは、その利点として「サイト全体を再ビルドせずに」静的コンテンツを更新できること、大量のページを長いビルド時間なしで扱えることを挙げています。export const revalidate = 3600 を指定したルートは、最大で1時間に1回再生成されます。正確に制御したい場合は、コンテンツ変更時にrevalidatePathまたはrevalidateTagを呼び出します。ISRは静的エクスポート(output: 'export')では動作しません。クライアントレンダリングのままにせざるを得ないアプリについては、シングルページアプリケーションのSEOのガイドで対処法を紹介しています。
ヒント
確認すべきはブラウザの表示ではなく、ボットが受け取る内容です。URLにcurlを実行するか、view-sourceを開いて記事中の一文を検索してください。生のHTMLに見つからなければ、その文はJavaScriptに依存しています。
App RouterではMetadata APIがnext/headに代わります。Next.jsのメタデータに関するドキュメントによると、layoutやpageから静的なmetadataオブジェクトを、値がデータに依存する場合はgenerateMetadata関数をエクスポートすれば、Next.jsがheadタグを生成します。どちらもServer Componentsでのみ使えます。
export async function generateMetadata({ params }) {
  const { slug } = await params
  const post = await getPost(slug)
  return {
    title: post.title,
    description: post.excerpt,
    alternates: { canonical: `/blog/${slug}` },
    openGraph: { images: [post.cover] },
  }
}
ほとんどの問題を防ぐ5つのルール:
動的ページでは、Next.jsは描画を速めるため、最初のバイトの後にメタデータをストリーミングします。ドキュメントによると、headにメタデータがあることを前提とするボット(user agentで判定され、例としてBingbot、Twitterbot、Slackbotが挙げられています)にはストリーミングが無効になり、htmlLimitedBotsオプションで対象リストを変更できます。重視するクローラーが含まれていなければ追加してください。Pages Routerでの同等の仕組みはnext/headのHeadコンポーネントで、重複タグを避けるためにkey属性を付けます。
どちらもappフォルダの特殊ファイルです。URLの配列を返す関数をエクスポートするsitemap.tsは/sitemap.xmlに、robots.tsは/robots.txtになります。サイトマップのリファレンスによると、このファイルはデフォルトでキャッシュされ、Googleの上限はサイトマップ1つにつき50,000 URLです。それを超える場合はgenerateSitemapsで複数ファイルに分割します。
import type { MetadataRoute } from 'next'

export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  const posts = await getPosts()
  return posts.map((p) => ({
    url: `https://example.com/blog/${p.slug}`,
    lastModified: p.updatedAt,
  }))
}含めるのは、canonicalでインデックス可能かつ200を返すURLだけにし、lastModifiedには実際の更新日を入れます。多言語サイト向けにalternates.languagesも指定できます。robots.tsではサイトマップの場所を示し、どのAIボットにクロールを許可するかを決めます。対象のボットはAIクローラー向けrobots.txtの記事で一覧にしています。形式の詳細はXMLサイトマップの用語解説をご覧ください。
| 問題 | 起きること | 対策 |
|---|---|---|
| onClickとrouter.pushによる遷移 | Googleはhref付きのa要素しかたどらない | 本物のリンクを出力するnext/linkのLinkコンポーネントを使う |
| 存在しないコンテンツを200で返す | Search Consoleで「ソフト404」 | notFound()を呼び、ルートが404を返すようにする |
| 移転したページに一時的なリダイレクト | redirect()は307を返す | permanentRedirect()かnext.configのpermanent: true(308)を使う |
| 末尾スラッシュの混在 | 同じページに2つのURL | trailingSlashオプションでどちらかに統一し、canonicalも揃える |
| プレビューやステージング環境のインデックス | Googleにサイトの複製が載る | 本番以外のドメインでnoindexを返す |
| クリックで読み込むタブ内のコンテンツ | HTMLに本文がない | すべてサーバーでレンダリングし、必要ならCSSで隠す |
これらはすべてクロール可能性を下げます。クローラーはリンクから各URLを発見でき、正しいステータスコードを受け取れなければなりません。
Next.jsのドキュメントは、JSON-LDをtypeがapplication/ld+jsonのscriptタグとしてpageやlayoutコンポーネント内で直接レンダリングし、ページと同じデータから作り、シリアライズしたJSON内の < をエスケープしてインジェクションを防ぐよう推奨しています。サーバーでレンダリングされるので、GoogleもAIクローラーも生のHTMLで読み取れます。記事にはArticle(またはBlogPosting)、ルートlayoutにはOrganization、深い階層のページにはBreadcrumbList、ECにはProductを使います。schemaジェネレーターで有効なひな形を作り、Googleのリッチリザルトテストでページを検証しましょう。
Next.jsには、Core Web Vitalsが悪化するよくある原因に対処するコンポーネントが用意されています。
ラボのスコアだけでなく実ユーザーのデータを測りましょう。両方の読み方はPageSpeed Insightsのガイドで解説しています。
Next.jsブログには主に3つの形があります。リポジトリ内のMDXやMarkdownファイル(シンプルですが記事ごとにコミットとデプロイが必要)、Server Componentsから取得するヘッドレスCMS(Sanity、Contentful、Strapi、Payload)、そして外部ツールから記事を受け取る公開用webhookです。どの場合もSEOの型は同じで、generateStaticParams、generateMetadata、ISRを備えた動的ルートapp/blog/[slug]、同じデータソースから作るサイトマップ、全記事にリンクする一覧ページで構成します。
webhookを使えば、公開作業をデプロイの流れから切り離せます。Route Handlerが記事を受け取って保存し、関係するページを再検証します。
// app/api/publish/route.ts
import { revalidatePath } from 'next/cache'

export async function POST(request) {
  if (request.headers.get('authorization') !== `Bearer ${process.env.PUBLISH_SECRET}`) {
    return new Response('Unauthorized', { status: 401 })
  }
  const article = await request.json()
  await savePost(article)
  revalidatePath('/blog')
  revalidatePath(`/blog/${article.slug}`)
  return Response.json({ ok: true })
}
注意
エンドポイントはシークレットで保護し、公開URLのパスを正確に再検証してください。ISRのドキュメントは、複数のサーバーインスタンスでデフォルトのファイルキャッシュを使う場合、オンデマンド再検証はリクエストを受けたインスタンスしかクリアしないと警告しています。共有のキャッシュハンドラーを使いましょう。
サーバーレンダリングはGEO(生成エンジン最適化)の第一条件です。Vercelが2024年12月に公開した分析The rise of the AI crawlerは、「主要なAIクローラーはいずれも現在JavaScriptをレンダリングしていない」と結論づけ、GPTBot、ChatGPT-User、OAI-SearchBot、ClaudeBot、PerplexityBotを挙げ、同社ネットワーク上で1か月にGPTBotが5億6,900万回、Claudeが3億7,000万回のリクエストを行ったと集計しています。本文、見出し、JSON-LDを事前レンダリングしたNext.jsのページはそのすべてに読まれますが、クライアントレンダリングのページは読まれません。
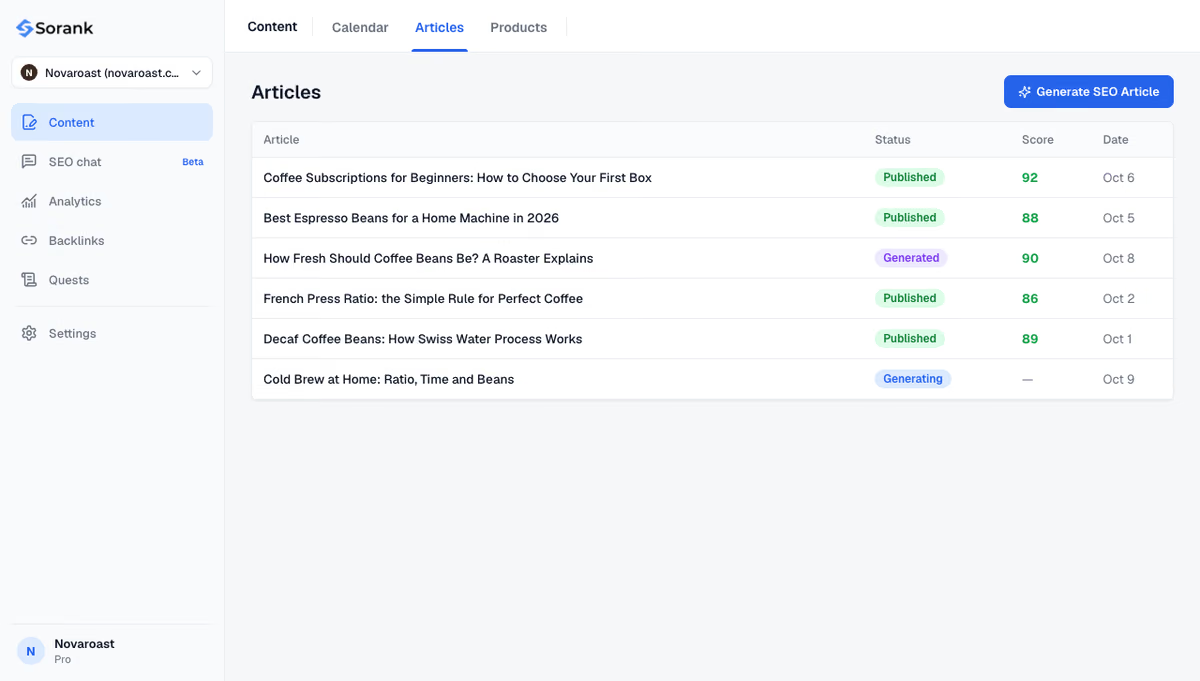
第二の条件は、引用に値するコンテンツです。セクションごとにひとつの質問に答え、出典、数値、明確な定義を備え、定期的に公開される記事です。この部分を自動化するのが、私たちの製品Sorankです。SorankはautopilotでSEOとGEOを進めるソフトウェアで、キーワードを見つけ、ブログ記事ジェネレーターが出典、内部リンク、画像付きの記事を月20本、60本、または120本作成します。Next.jsサイトとは、導入ページで説明しているカスタムwebhookで連携します。あなたのRoute Handlerが各記事を受け取って保存し、ブログを再検証します。さらにAIでの言及トラッキングが、ChatGPT、Claude、Geminiがあなたのブランドを引用しているかを毎週確認します。
まとめると、見つけてほしいページはすべて事前レンダリングし、メタデータはサーバーで定義し、サイトマップはコンテンツと同じデータソースから生成することです。Next.jsは道具を提供し、順位やAIでの引用はそれを使って何を公開するかで決まります。Next.jsブログに記事を継続的に供給するなら、Sorankの料金プランをご覧ください。月額49ドルからで、3日間の無料トライアルがあります。

Next.jsはReactの上に構築されているため、比較の対象はレンダリング方式です。標準的なReactのシングルページアプリはブラウザでレンダリングされ、ほぼ空のHTMLを送りますが、Next.jsはサーバーまたはビルド時にページを事前レンダリングします。JavaScriptを実行しないAIボットを含むクローラーも、Next.jsなら追加設定なしで完全なコンテンツを受け取れます。
自動ではありません。App Routerでは、URLを返すsitemap.tsファイルをappフォルダに追加すると、Next.jsがそれを/sitemap.xmlで配信します。大規模サイトでは、Googleがサイトマップ1つにつき最大50,000 URLまで受け付けるため、generateSitemapsでリストを複数ファイルに分割します。
どちらもHTMLを事前レンダリングするので、どちらでも上位表示は可能です。新規プロジェクトにはApp Routerが推奨です。Server ComponentsでクライアントのJavaScriptが減り、Metadata API、sitemap.ts、robots.tsがSEO関連ファイルを標準で扱えます。既存のPages Routerのサイトでは、SEOだけを理由に移行する価値はあまりありません。
 AI コンテンツブリーフ生成ツール
 FAQ スキーマ生成ツール
 AI ブログ記事アイデア生成ツール
 構造化データ検証ツール
 代替テキストチェッカー
 内部リンク分析ツール
 被リンクチャレンジ
 AI メタディスクリプション生成ツール
 AI ブログタイトル生成ツール
 Google インデックス可否チェッカー
 AI 記事構成案生成ツール
 UTM リンク作成ツール
 キーワードのグループ化ツール
 canonical タグチェッカー
 XML サイトマップ生成ツール
 リンク切れチェッカー
 AI SEO タイトル生成ツール
 見出しアナライザー
 検索結果プレビューツール
 リダイレクトチェッカー
 hreflang タグ生成ツール
 見出し構造チェッカー
 HTTP ヘッダーチェッカー
 Favicon 抽出ツール
 SEO トラフィック・売上予測計算ツール
 SEO 予算計算ツール
 順位上昇シミュレーター
 キーワード機会スコア計算ツール
 GEO コンテンツ投資計算ツール
 顧客生涯価値計算ツール
 CTR 計算ツール
 AI トラフィック価値計算ツール
 AI シェア・オブ・ボイス計算ツール
 Gemini ランキングツール
 ROAS 計算ツール
 自然検索トラフィック価値計算ツール
 ローカル SEO ROI 計算ツール
 被リンク獲得コスト計算ツール
 キーワード密度計算ツール
 顧客獲得コスト計算ツール
 記事単価計算ツール
 直帰率計算ツール
 AI 引用率計算ツール
 LLM 向け構造化データ監査
 llms.txt ジェネレーター
 Sitemap チェッカー
 SERP 変動センサー
 文字数カウンター
 Schema マークアップ生成ツール
 キーワード調査ツール
 SEO 損益分岐点計算ツール
 読了時間計算ツール
 自然検索トラフィック予測ツール
 ChatGPT 参照トラフィック予測ツール
 AI 可視性スコア計算ツール
 AI 可読性チェッカー
 SearchGPT 対応チェッカー
 ChatGPT が自社サイトを推薦しない理由
 URL 抽出ツール
 ウェブページ Markdown 変換ツール
 robots.txt 生成ツール
 Open Graph プレビュー
 オンページ SEO 監査
 LTV:CAC 比率計算ツール
 GEO ROI 計算ツール
 コンバージョン率計算ツール
 AI クローラー巡回監査
 AI 検索可視性テスト
 ページサイズチェッカー
 URL スラッグ生成ツール
 メタタグ生成ツール
 画像圧縮ツール
 ファビコン生成ツール
 ドメインオーソリティチェッカー
 検索結果 CTR 計算ツール
 EC SEO ROI 計算ツール
 コンテンツマーケティング ROI 計算ツール
 AI での不可視コスト計算ツール
 AI Overviews チェッカー
 robots.txt チェッカー
 SEO・AI 監査
 Perplexity ランキングチェッカー
 アンサーエンジン最適化の監査
 ChatGPT 可視性チェッカー
 被リンク分析ツール
 SEO とリスティング広告の節約額計算ツール
 SEO シェア・オブ・ボイス計算ツール
 SaaS SEO ROI 計算ツール
 被リンク ROI 計算ツール
 llms.txt バリデーター
 LLM 引用チェッカー
 GEO 監査
 SEO ROI 計算ツール
 キーワード価値計算ツール
先行導入企業のご紹介
 “2年間、クライアントの100%がLinkedIn経由でした。毎日の投稿、コメント、DMでのフォローアップ…完全にアルゴリズム頼みでした。SEOに取り組むべきだとわかっていても、時間がかかる、技術的すぎる、自分の仕事ではないと、いつも後回しにしていました。Sorankでようやく一歩を踏み出しました。4か月で、何も投稿しなくても毎月15件のオーガニックリードを獲得しています。まだLinkedInと半々ではありませんが、自動で育つ2つ目のリード源ができたことで安心して眠れるようになりました。”
 Valentin Thomyコールドメール専門エージェンシー“Sorankは、クライアントに提供する成果を大きく変えてくれました。AIが実際に使っているキーワードを特定し、特定の競合が引用される理由を理解し、以前は完全に見落としていたチャンスを見つけられるようになりました。クライアントは、より早い順位上昇、AIの回答での可視性向上、そしてすべての施策のROIがより明確になったことを実感しています。”
 Benjamin Rouxovirank.com
 “私はマーケターではなく開発者です。私のShopifyテーマは口コミと広告だけで売れていました。Sorankのおかげで、SEOの組み立て方と上位表示される記事の書き方がようやくわかりました。監査で商品ページが遅すぎることも判明しました。2か月でオーガニックトラフィックは2倍になり、ShopifyテーマについてChatGPTで検索されたときの回答にも表示され始めています。しかも、週に約2時間の作業だけです。”
 Thème FullStackthemefullstack.com“Sorankのおかげで、私たちのSEOエージェンシーの働き方は大きく変わりました。すべてが一元化・自動化されたため、クライアント1社あたりにかける時間が大幅に減りました。以前は何時間もかかっていた作業が今では数分で終わり、ようやくビジネスの中で働くのではなく、ビジネスそのものに取り組めるようになりました。”
 Océane Bondismaison-leverage.com