Next.js SEO 가이드: SSG, SSR, ISR 선택, 메타데이터와 canonical 설정, sitemap.xml 생성, webhook 기반 블로그 운영, AI 크롤러가 읽을 수 있는 페이지 만들기.
도구


요약
Next.js는 크롤러에 빈 껍데기 대신 완전한 HTML을 보내기 때문에 SEO에 가장 유리한 React 프레임워크 중 하나입니다. 상위 노출을 원한다면 콘텐츠 페이지를 사전 렌더링(정적 생성 또는 ISR)하고, Metadata API로 제목, 설명, canonical을 정의하고, app 폴더에서 sitemap.xml과 robots.txt를 생성하고, 실제 링크와 올바른 상태 코드를 사용하며, 핵심 콘텐츠를 브라우저에서만 실행되는 코드 밖에 두십시오. 대부분의 AI 크롤러는 JavaScript를 실행하지 않기 때문입니다.
더 알아보고 싶다면 물어보세요
간단 퀴즈
SEO가 맞습니까? 어떻게 시작해야 합니까?
간단한 질문 4개로 Google이 고객을 데려올 수 있는지 확인하십시오.
추천 결과
Sorank가 가장 알맞은 솔루션입니다
사람들이 귀사의 상품을 검색하고 몇 달을 기다릴 수 있습니다. Sorank가 알맞은 검색어를 찾고, 글을 작성해 게시하고, 링크를 확보해 드립니다.
Sorank가 답변에 잘 맞습니다
귀사의 사이트에서 3일 동안 사용해 보시거나, 무료 진단으로 현재 상황부터 확인하십시오.
3일 무료, 이후 언제든 해지할 수 있습니다. 90일 환불 보장.
Next.js SEO의 핵심은 경로마다 올바른 선택을 하는 것입니다. 무엇을 서버에서 렌더링하고, 무엇을 캐시하며, 어떤 스크립트가 실행되기 전에 무엇이 HTML에 들어가는지가 중요합니다. Google은 JavaScript SEO 기본사항에서 JavaScript 앱을 크롤링, 렌더링, 색인 생성의 세 단계로 처리하며, 서버 측 렌더링이나 사전 렌더링은 "여전히 좋은 방법"이라고 설명합니다. Next.js는 이를 기본으로 수행합니다. 이 가이드는 App Router(Next.js 13 이상)를 다루며, 이전 Pages Router에 대한 설명도 덧붙입니다.
그렇습니다. 클라이언트 측에서 렌더링하는 일반 React 앱은 거의 비어 있는 HTML 파일을 보내고 브라우저에서 페이지를 만듭니다. 검색엔진은 이를 렌더링해야 하며, 많은 봇은 아예 렌더링하지 않습니다. Next.js는 React를 서버에서 렌더링하므로 HTML 응답에 이미 제목, 본문, 링크, 메타데이터가 포함됩니다. 이 차이가 색인 생성에 왜 중요한지는 JavaScript SEO 가이드에서 설명합니다.
App Router에서 컴포넌트는 기본적으로 Server Components입니다. 'use client'로 표시한 컴포넌트도 서버에서 HTML로 사전 렌더링됩니다. 약점은 데이터입니다. useEffect 안에서 가져오거나 클릭한 뒤에야 불러오는 내용은 초기 HTML에 없습니다. 콘텐츠는 Server Components에서 가져오고, 클라이언트 컴포넌트는 상호작용에만 사용하십시오.
Next.js에서는 경로별로 방식을 섞어 쓸 수 있습니다. 선택에 따라 최신성, 속도, 크롤러가 받는 내용이 달라집니다.
| 방식 | HTML 생성 시점 | SEO 평가 | 적합한 용도 |
|---|---|---|---|
| 정적 생성(SSG) | 빌드 시 | 최상: 완전한 HTML, 매우 빠름 | 랜딩 페이지, 문서, 오래 읽히는 글 |
| 증분 정적 재생성(ISR) | 빌드 시 생성 후 백그라운드 또는 요청 시 갱신 | 규모가 크거나 자주 바뀌는 사이트에 최상 | 블로그, 상품 카탈로그, CMS 페이지 |
| 서버 측 렌더링(SSR) | 요청마다 | 양호: 완전한 HTML, 서버 속도에 좌우 | 개인화 또는 실시간 페이지 |
| 클라이언트 측 렌더링(CSR) | 브라우저에서 | 취약: 대부분의 봇에 콘텐츠가 보이지 않음 | 로그인 뒤의 대시보드 |
Next.js ISR 문서는 "전체 사이트를 다시 빌드하지 않고" 정적 콘텐츠를 갱신하고, 긴 빌드 시간 없이 많은 페이지를 처리할 수 있다는 점을 장점으로 꼽습니다. export const revalidate = 3600을 지정한 경로는 최대 한 시간에 한 번 재생성됩니다. 정확하게 제어하려면 콘텐츠가 바뀔 때 revalidatePath 또는 revalidateTag를 호출하십시오. ISR은 정적 내보내기(output: 'export')에서는 동작하지 않습니다. 클라이언트 렌더링을 유지해야 하는 앱이라면 싱글 페이지 애플리케이션 SEO 가이드에서 해결 방법을 확인하십시오.
팁
브라우저 화면이 아니라 봇이 받는 내용을 확인하십시오. URL에 curl을 실행하거나 view-source를 열고 글의 한 문장을 검색합니다. 원본 HTML에 없다면 그 문장은 JavaScript에 의존하는 것입니다.
App Router에서는 Metadata API가 next/head를 대신합니다. Next.js 메타데이터 문서에 따르면 layout이나 page에서 정적 metadata 객체를 내보내거나, 값이 데이터에 따라 달라지면 generateMetadata 함수를 내보내면 Next.js가 head 태그를 생성합니다. 두 방식 모두 Server Components에서만 지원됩니다.
export async function generateMetadata({ params }) {
  const { slug } = await params
  const post = await getPost(slug)
  return {
    title: post.title,
    description: post.excerpt,
    alternates: { canonical: `/blog/${slug}` },
    openGraph: { images: [post.cover] },
  }
}
대부분의 문제를 막는 다섯 가지 규칙:
동적 페이지에서 Next.js는 렌더링 속도를 높이기 위해 첫 바이트 이후에 메타데이터를 스트리밍합니다. 문서에 따르면 head에 메타데이터가 있어야 하는 봇(user agent로 감지하며 Bingbot, Twitterbot, Slackbot이 예시로 나옵니다)에는 스트리밍이 비활성화되며, htmlLimitedBots 옵션으로 목록을 조정할 수 있습니다. 중요하게 여기는 크롤러가 목록에 없다면 추가하십시오. Pages Router에서는 next/head의 Head 컴포넌트가 같은 역할을 하며, 중복 태그를 막기 위해 key 속성을 사용합니다.
둘 다 app 폴더의 특수 파일입니다. URL 목록을 반환하는 함수를 내보내는 sitemap.ts는 /sitemap.xml이 되고, robots.ts는 /robots.txt가 됩니다. 사이트맵 레퍼런스에 따르면 이 파일은 기본적으로 캐시되며, Google의 한도는 사이트맵 하나당 50,000개 URL입니다. 이를 넘으면 generateSitemaps로 여러 파일로 나눕니다.
import type { MetadataRoute } from 'next'

export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  const posts = await getPosts()
  return posts.map((p) => ({
    url: `https://example.com/blog/${p.slug}`,
    lastModified: p.updatedAt,
  }))
}
canonical이면서 색인 가능하고 200을 반환하는 URL만 넣고, lastModified에는 실제 수정일을 기록하십시오. 다국어 사이트라면 alternates.languages도 지정할 수 있습니다. robots.ts에서는 사이트맵 위치를 알리고 어떤 AI 봇의 크롤링을 허용할지 정합니다. 해당 봇 목록은 AI 크롤러를 위한 robots.txt 글에 정리했습니다. 형식에 대한 자세한 내용은 XML 사이트맵 용어 설명을 참고하십시오.
| 문제 | 결과 | 해결 |
|---|---|---|
| onClick과 router.push로 이동 | Google은 href가 있는 a 요소만 따라감 | 실제 링크를 출력하는 next/link의 Link 컴포넌트 사용 |
| 없는 콘텐츠를 200 페이지로 응답 | Search Console의 "소프트 404" | notFound()를 호출해 404 상태를 반환 |
| 이전된 페이지에 임시 리디렉션 사용 | redirect()는 307을 보냄 | permanentRedirect() 또는 next.config의 permanent: true(308) 사용 |
| 끝 슬래시 혼용 | 같은 페이지에 URL 두 개 | trailingSlash 옵션으로 하나를 정하고 canonical을 일관되게 유지 |
| 미리보기나 스테이징 배포가 색인됨 | Google에 사이트 사본이 중복 노출 | 운영 외 도메인에서 noindex 전송 |
| 클릭해야 불러오는 탭 콘텐츠 | HTML에 텍스트가 없음 | 모든 콘텐츠를 서버에서 렌더링하고 필요하면 CSS로 숨김 |
이 문제들은 모두 크롤링 가능성을 떨어뜨립니다. 크롤러는 링크를 통해 모든 URL을 발견하고 깔끔한 상태 코드를 받아야 합니다.
Next.js 문서는 JSON-LD를 type이 application/ld+json인 script 태그로 page나 layout 컴포넌트 안에서 직접 렌더링하고, 페이지와 같은 데이터로 만들며, 직렬화한 JSON의 < 문자를 이스케이프해 삽입 공격을 막으라고 권장합니다. 서버에서 렌더링되므로 Google과 AI 크롤러 모두 원본 HTML에서 이를 읽을 수 있습니다. 글에는 Article(또는 BlogPosting), 루트 layout에는 Organization, 깊은 페이지에는 BreadcrumbList, 전자상거래에는 Product를 사용하십시오. schema 생성기로 유효한 기본 블록을 만든 뒤 Google 리치 결과 테스트로 페이지를 검증하십시오.
Next.js에는 Core Web Vitals가 나빠지는 흔한 원인을 해결하는 컴포넌트가 들어 있습니다.
실험실 점수만이 아니라 실제 사용자 데이터를 측정하십시오. 두 가지를 읽는 법은 PageSpeed Insights 가이드에서 설명합니다.
Next.js 블로그는 보통 세 가지 형태 중 하나입니다. 저장소 안의 MDX 또는 Markdown 파일(간단하지만 글마다 커밋과 배포가 필요), Server Components에서 조회하는 헤드리스 CMS(Sanity, Contentful, Strapi, Payload), 그리고 외부 도구에서 글을 받는 게시용 webhook입니다. 세 경우 모두 SEO 패턴은 같습니다. generateStaticParams, generateMetadata, ISR을 갖춘 동적 경로 app/blog/[slug], 같은 데이터 소스로 만든 사이트맵, 모든 글로 연결되는 목록 페이지입니다.
webhook을 쓰면 게시가 배포 주기와 분리됩니다. Route Handler가 글을 받아 저장한 뒤 관련 페이지를 재검증합니다.
// app/api/publish/route.ts
import { revalidatePath } from 'next/cache'

export async function POST(request) {
  if (request.headers.get('authorization') !== `Bearer ${process.env.PUBLISH_SECRET}`) {
    return new Response('Unauthorized', { status: 401 })
  }
  const article = await request.json()
  await savePost(article)
  revalidatePath('/blog')
  revalidatePath(`/blog/${article.slug}`)
  return Response.json({ ok: true })
}
주의
엔드포인트는 비밀 키로 보호하고 공개 경로를 정확히 재검증하십시오. ISR 문서는 서버 인스턴스가 여러 개이고 기본 파일 캐시를 쓰는 경우, 요청 시 재검증이 호출을 받은 인스턴스만 비운다고 경고합니다. 공유 캐시 핸들러를 사용하십시오.
서버 렌더링은 GEO(생성형 엔진 최적화)의 첫 번째 조건입니다. Vercel이 2024년 12월에 발표한 분석 The rise of the AI crawler는 "주요 AI 크롤러 중 현재 JavaScript를 렌더링하는 것은 없다"고 밝히며 GPTBot, ChatGPT-User, OAI-SearchBot, ClaudeBot, PerplexityBot을 언급했고, 한 달 동안 자사 네트워크에서 GPTBot 요청 5억 6,900만 건, Claude 요청 3억 7,000만 건을 집계했습니다. 본문, 제목, JSON-LD를 사전 렌더링한 Next.js 페이지는 이들 모두가 읽을 수 있지만, 클라이언트에서 렌더링한 페이지는 그렇지 않습니다.
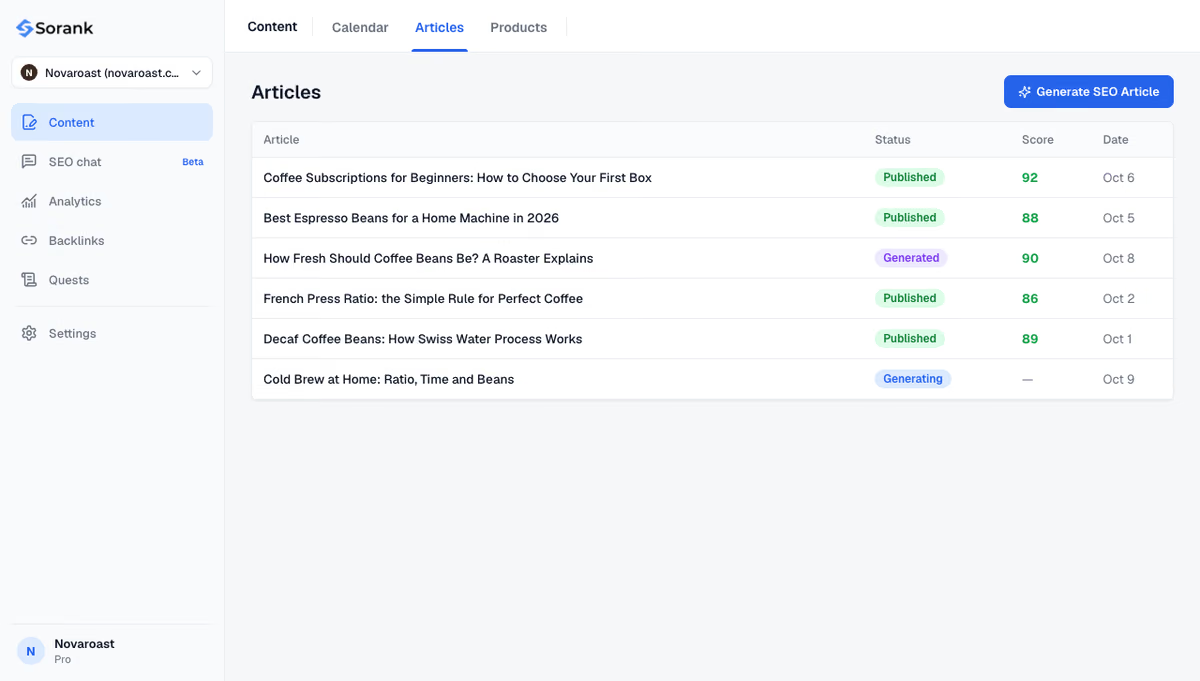
두 번째 조건은 인용할 가치가 있는 콘텐츠입니다. 섹션마다 질문 하나에 답하고, 출처와 수치와 명확한 정의를 갖추고, 꾸준히 게시되는 글입니다. 이 부분을 자동화하는 것이 저희 제품 Sorank입니다. Sorank는 autopilot으로 SEO와 GEO를 수행하는 소프트웨어로, 키워드를 찾아내고 블로그 글 생성기가 출처, 내부 링크, 이미지를 갖춘 글을 매월 20개, 60개 또는 120개 작성합니다. Next.js 사이트에는 설치 페이지에서 설명하는 사용자 지정 webhook으로 연결됩니다. Route Handler가 각 글을 받아 저장하고 블로그를 재검증합니다. 이후 AI 언급 추적이 ChatGPT, Claude, Gemini가 브랜드를 인용하는지 매주 확인합니다.
정리하면 노출되기를 원하는 모든 페이지를 사전 렌더링하고, 메타데이터는 서버에서 정의하며, 사이트맵은 콘텐츠와 같은 데이터 소스에서 생성하는 것입니다. Next.js는 도구를 제공하고, 순위와 AI 인용은 그 도구로 무엇을 게시하느냐에 달려 있습니다. Next.js 블로그에 글을 꾸준히 공급하려면 Sorank 요금제를 확인하십시오. 월 49달러부터 시작하며 3일 무료 체험을 제공합니다.

Next.js는 React를 기반으로 하므로 비교 대상은 렌더링 방식입니다. 기본 React 싱글 페이지 앱은 브라우저에서 렌더링되어 거의 빈 HTML을 보내지만, Next.js는 서버나 빌드 시점에 페이지를 사전 렌더링합니다. JavaScript를 실행하지 않는 AI 봇을 포함한 크롤러도 Next.js에서는 별도 설정 없이 완전한 콘텐츠를 받습니다.
저절로 생성하지는 않습니다. App Router에서는 URL을 반환하는 sitemap.ts 파일을 app 폴더에 추가하면 Next.js가 /sitemap.xml에서 제공합니다. 대규모 사이트는 Google이 사이트맵 하나당 최대 50,000개 URL을 받으므로 generateSitemaps로 목록을 여러 파일로 나눕니다.
둘 다 HTML을 사전 렌더링하므로 모두 좋은 순위를 얻을 수 있습니다. 새 프로젝트에는 App Router가 권장됩니다. Server Components가 클라이언트 JavaScript를 줄이고, Metadata API, sitemap.ts, robots.ts가 SEO 파일을 기본으로 처리합니다. 이미 Pages Router로 운영 중인 사이트라면 SEO만을 위해 이전할 가치는 크지 않습니다.
 AI 콘텐츠 브리프 생성기
 FAQ 스키마 생성기
 AI 블로그 글 아이디어 생성기
 구조화 데이터 검사기
 대체 텍스트 검사기
 내부 링크 분석기
 백링크 챌린지
 AI 메타 설명 생성기
 AI 블로그 제목 생성기
 Google 색인 가능성 검사기
 AI 글 개요 생성기
 UTM 링크 생성기
 키워드 클러스터링 도구
 canonical 태그 검사기
 XML 사이트맵 생성기
 깨진 링크 검사기
 AI SEO 제목 생성기
 제목 점수 분석기
 검색 결과 미리보기
 리디렉션 검사기
 hreflang 생성기
 제목 구조 분석기
 HTTP 헤더 검사기
 Favicon 추출기
 SEO 트래픽·매출 예측 계산기
 SEO 예산 계산기
 순위 상승 시뮬레이터
 키워드 기회 점수 계산기
 GEO 콘텐츠 투자 계산기
 고객 생애 가치 계산기
 CTR 계산기
 AI 트래픽 가치 계산기
 AI 점유율(SOV) 계산기
 Gemini 순위 도구
 ROAS 계산기
 오가닉 트래픽 가치 계산기
 로컬 SEO ROI 계산기
 링크 빌딩 비용 계산기
 키워드 밀도 계산기
 고객 획득 비용 계산기
 글 1편당 비용 계산기
 이탈률 계산기
 AI 인용률 계산기
 LLM용 구조화 데이터 진단
 llms.txt 생성기
 사이트맵 검사기
 SERP 변동성 센서
 단어 카운터
 Schema 마크업 생성기
 키워드 리서치 도구
 SEO 손익분기점 계산기
 읽기 시간 계산기
 오가닉 트래픽 추정기
 ChatGPT 추천 트래픽 추정기
 AI 가시성 점수 계산기
 AI 가독성 검사기
 SearchGPT 준비도 검사기
 ChatGPT가 내 웹사이트를 추천하지 않는 이유
 URL 추출기
 웹페이지 Markdown 변환기
 robots.txt 생성기
 Open Graph 미리보기
 온페이지 SEO 점검
 LTV 대비 CAC 비율 계산기
 GEO ROI 계산기
 전환율 계산기
 AI 크롤러 접근 감사
 AI 검색 가시성 테스트
 페이지 용량 검사기
 URL 슬러그 생성기
 메타 태그 생성기
 이미지 압축기
 파비콘 생성기
 도메인 권위 검사기
 SERP CTR 계산기
 이커머스 SEO ROI 계산기
 콘텐츠 마케팅 ROI 계산기
 AI 비가시성 비용 계산기
 AI 개요 검사기
 robots.txt 검사기
 AI SEO 진단
 Perplexity 순위 검사기
 답변 엔진 최적화(AEO) 진단
 ChatGPT 가시성 체커
 백링크 분석 도구
 SEO 대 유료 검색 절감액 계산기
 SEO 점유율(SOV) 계산기
 SaaS SEO ROI 계산기
 백링크 ROI 계산기
 llms.txt 검증 도구
 LLM 인용 검사기
 GEO 진단
 SEO ROI 계산기
 키워드 가치 계산기
먼저 Sorank를 경험한 사람들
 “2년 동안 제 고객의 100%는 LinkedIn에서 왔습니다. 매일 게시물을 올리고, 댓글을 달고, DM으로 후속 연락을 하고… 알고리즘에 완전히 의존하는 방식이었습니다. SEO를 해야 한다는 것은 알았지만 늘 미뤘습니다. 시간이 오래 걸리고, 너무 기술적이며, 제 일이 아니라고 생각했기 때문입니다. Sorank와 함께 드디어 첫걸음을 내디뎠습니다. 4개월 만에 아무것도 게시하지 않고도 매달 15건의 오가닉 리드를 확보하고 있습니다. 아직 LinkedIn과 50 대 50은 아니지만, 자동 운영으로 성장하는 두 번째 리드 채널이 생겼다는 사실에 훨씬 마음이 놓입니다.”
 Valentin Thomy콜드메일 대행사“Sorank는 저희가 고객사에 제공하는 성과를 완전히 바꿔 놓았습니다. 이제 AI가 실제로 사용하는 키워드를 파악하고, 특정 경쟁사가 인용되는 이유를 이해하며, 이전에는 전혀 보지 못했던 기회를 발견합니다. 고객사는 더 빠른 순위 상승, AI 답변에서의 더 나은 가시성, 그리고 실행하는 모든 작업에 대한 더 명확한 ROI를 확인합니다.”
 Benjamin Rouxovirank.com
 “저는 마케터가 아니라 개발자입니다. 제 Shopify 테마는 입소문과 광고로만 팔리고 있었습니다. Sorank 덕분에 드디어 SEO를 어떻게 구조화하고 상위에 노출되는 글을 어떻게 써야 하는지 이해했습니다. 진단 결과 제품 페이지가 너무 느리다는 사실이 드러났습니다. 2개월 만에 오가닉 트래픽이 두 배가 되었고, 사람들이 Shopify 테마를 검색할 때 ChatGPT 답변에 등장하기 시작했습니다. 그 모든 것을 주당 약 2시간으로 해냈습니다.”
 Thème FullStackthemefullstack.com“Sorank는 저희 SEO 대행사의 운영 방식을 완전히 바꿔 놓았습니다. 모든 것이 한곳에 모이고 자동화되어 고객사마다 들이는 시간이 훨씬 줄었습니다. 예전에 몇 시간씩 걸리던 작업이 이제 몇 분이면 끝나고, 덕분에 드디어 사업 안에서 일하는 것을 멈추고 사업 위에서 일하기 시작할 수 있게 되었습니다.”
 Océane Bondismaison-leverage.com