La privacy è importante per noi, quindi hai la possibilità di disabilitare alcuni tipi di archiviazione che potrebbero non essere necessari per il funzionamento di base del sito web. Il blocco delle categorie può influire sulla tua esperienza sul sito web. Ulteriori informazioni (Politica sui cookie)
SEO con Next.js: rendering, metadati, sitemap e un blog che si posiziona
Guida SEO per Next.js: scegliere SSG, SSR o ISR, impostare metadati e canonical, generare sitemap.xml, alimentare un blog via webhook e restare leggibili dalle IA.
Pubblicato il:
25/10/2026
-
Aggiornato il:
25/10/2026
Copertina della guida Sorank alla SEO con Next.js, con una pagina renderizzata lato server, i suoi metadati, la sitemap e le route del blog
Next.js è uno dei migliori framework React per la SEO perché invia ai crawler un HTML completo invece di un guscio vuoto. Per posizionarti, prerenderizza le pagine di contenuto (generazione statica o ISR), definisci title, description e canonical con la Metadata API, genera sitemap.xml e robots.txt dalla cartella app, usa link veri e codici di stato corretti, e tieni il contenuto principale fuori dal codice eseguito solo nel browser, perché la maggior parte dei crawler delle IA non esegue JavaScript.
3 giorni gratis, poi smetti quando vuoi. Garanzia soddisfatti o rimborsati di 90 giorni.
La SEO con Next.js consiste soprattutto nel fare la scelta giusta per ogni route: cosa viene renderizzato sul server, cosa viene messo in cache e cosa arriva nell'HTML prima che giri qualsiasi script. Google spiega nelle sue nozioni di base sulla SEO per JavaScript che elabora le app JavaScript in tre fasi (scansione, rendering, indicizzazione) e che il rendering lato server o il pre-rendering «resta un'ottima idea». Next.js lo fa di default. Questa guida copre l'App Router (Next.js 13 e successivi), con note per il vecchio Pages Router.
Next.js va bene per la SEO?
Sì. Una classica app React renderizzata lato client invia un file HTML quasi vuoto e costruisce la pagina nel browser; i motori di ricerca devono renderizzarla e molti bot non lo fanno mai. Next.js renderizza React sul server, quindi la risposta HTML contiene già titoli, testo, link e metadati. La nostra guida alla SEO per JavaScript spiega perché questa differenza conta per l'indicizzazione.
Nell'App Router i componenti sono Server Components di default. Anche i componenti marcati con 'use client' vengono prerenderizzati in HTML sul server. Il punto debole sono i dati: tutto ciò che carichi in useEffect, o solo dopo un clic, manca dall'HTML iniziale. Recupera i contenuti nei Server Components e riserva i componenti client all'interattività.
SSG, SSR, ISR o CSR: quale modalità di rendering scegliere?
Next.js permette di combinare le modalità route per route. La scelta incide su freschezza, velocità e su ciò che ricevono i crawler.
Modalità
Quando viene creato l'HTML
Giudizio SEO
Ideale per
Generazione statica (SSG)
Al build
Il migliore: HTML completo, molto veloce
Landing page, documentazione, articoli evergreen
Incremental Static Regeneration (ISR)
Al build, poi aggiornato in background o su richiesta
Il migliore per siti grandi o che cambiano
Blog, cataloghi prodotti, pagine da CMS
Rendering lato server (SSR)
A ogni richiesta
Buono: HTML completo, dipende dalla velocità del server
Pagine personalizzate o in tempo reale
Rendering lato client (CSR)
Nel browser
Debole: contenuto invisibile alla maggior parte dei bot
Dashboard dietro login
La documentazione Next.js sull'ISR ne elenca i vantaggi: aggiornare contenuti statici «senza ricostruire l'intero sito» e gestire grandi quantità di pagine senza build lunghissimi. Una route con export const revalidate = 3600 viene rigenerata al massimo una volta all'ora; per un controllo esatto, chiama revalidatePath o revalidateTag quando il contenuto cambia. L'ISR non funziona con un export statico (output: 'export'). Per le app che devono restare renderizzate lato client, la nostra guida alla SEO delle single page application illustra le soluzioni.
Consiglio
Controlla cosa ricevono i bot, non cosa mostra il tuo browser: esegui curl sull'URL o apri view-source e cerca una frase dell'articolo. Se non è nell'HTML grezzo, dipende da JavaScript.
Come si impostano title, description e canonical con la Metadata API?
La Metadata API sostituisce next/head nell'App Router. Secondo la documentazione Next.js sui metadati, esporti un oggetto metadata statico da un layout o da una pagina, oppure una funzione generateMetadata quando i valori dipendono dai dati, e Next.js genera i tag dell'head. Entrambi sono supportati solo nei Server Components.
Cinque regole che evitano la maggior parte dei problemi:
Imposta metadataBase nel layout radice (il tuo dominio di produzione), così canonical relative e URL Open Graph diventano assolute.
Usa un modello di titolo nel layout radice, ad esempio '%s | Brand', così ogni pagina ha un titolo unico con il brand una sola volta.
Dai a ogni pagina indicizzabile una canonical autoreferenziale tramite alternates.canonical; protegge dai duplicati creati da parametri URL e slash finali. La nostra voce di glossario sul tag canonical riassume le regole.
Scrivi una description per pagina, generata dal contenuto in generateMetadata, mai un valore predefinito per tutto il sito.
Aggiungi immagini Open Graph con un file opengraph-image nella cartella della route e verifica il risultato con uno strumento di anteprima Open Graph.
Sulle pagine dinamiche, Next.js invia i metadati in streaming dopo i primi byte per velocizzare il rendering. La documentazione precisa che lo streaming è disattivato per i bot che si aspettano i metadati nell'head, riconosciuti dallo user agent (Bingbot, Twitterbot e Slackbot sono tra gli esempi), e che l'opzione htmlLimitedBots permette di personalizzare l'elenco. Se manca un crawler che ti interessa, aggiungilo. Nel Pages Router l'equivalente è il componente Head di next/head, con un attributo key per evitare tag duplicati.
Come si generano sitemap.xml e robots.txt in Next.js?
Sono entrambi file speciali della cartella app. Un file sitemap.ts che esporta una funzione che restituisce URL diventa /sitemap.xml; un file robots.ts diventa /robots.txt. Il riferimento sulla sitemap segnala che il file è in cache di default e che il limite di Google è di 50.000 URL per sitemap; oltre, generateSitemaps la divide in più file.
import type { MetadataRoute } from 'next'

export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  const posts = await getPosts()
  return posts.map((p) => ({
    url: `https://example.com/blog/${p.slug}`,
    lastModified: p.updatedAt,
  }))
}
Inserisci solo URL canonical, indicizzabili e che rispondono 200, con la vera data di aggiornamento in lastModified. La sitemap accetta anche alternates.languages per i siti multilingue. In robots.ts indica la sitemap e decidi quali bot delle IA possono scansionare il sito; il nostro articolo su robots.txt per i crawler delle IA li elenca. Il formato è spiegato nella nostra voce sulla sitemap XML.
Quali dettagli tecnici rovinano più spesso la SEO di un sito Next.js?
Problema
Cosa succede
Soluzione
Navigazione con onClick e router.push
Google segue solo elementi a con href
Usare il componente Link di next/link, che genera un vero link
Contenuto inesistente servito come pagina 200
«Soft 404» in Search Console
Chiamare notFound() perché la route restituisca uno stato 404
Redirect temporanei per pagine spostate
redirect() invia un 307
Usare permanentRedirect() o permanent: true in next.config (308)
Slash finali misti
Due URL per la stessa pagina
Sceglierne uno con l'opzione trailingSlash e mantenere canonical coerenti
Deploy di anteprima o staging indicizzati
Copie duplicate del sito su Google
Inviare noindex sui domini non di produzione
Contenuto delle schede caricato al clic
Testo assente dall'HTML
Renderizzare tutto il contenuto sul server e nasconderlo con CSS se serve
Tutti questi problemi riducono la scansionabilità: un crawler deve poter scoprire ogni URL tramite link e ottenere un codice di stato pulito.
Come si aggiungono i dati strutturati in Next.js?
La documentazione Next.js consiglia di renderizzare il JSON-LD in un tag script di tipo application/ld+json direttamente nel componente di pagina o di layout, partendo dagli stessi dati della pagina, e di fare l'escape del carattere < nel JSON serializzato per evitare iniezioni. Essendo renderizzato sul server, Google e i crawler delle IA lo vedono nell'HTML grezzo. Usa Article (o BlogPosting) per gli articoli, Organization nel layout radice, BreadcrumbList per le pagine profonde e Product nell'e-commerce. Un generatore di schema ti dà un blocco valido di partenza; poi verifica la pagina con il test dei risultati multimediali di Google.
Come rendere un sito Next.js abbastanza veloce per i Core Web Vitals?
Next.js fornisce i componenti che risolvono le cause abituali di Core Web Vitals scadenti:
next/image: ridimensiona le immagini, serve formati moderni, usa il lazy loading di default e richiede le dimensioni, evitando gli spostamenti del layout. Segna l'immagine principale above the fold come prioritaria perché non venga caricata in differita (di solito è l'elemento del Largest Contentful Paint).
next/font: ospita i font sul tuo dominio ed evita lo spostamento dovuto alla sostituzione tardiva dei font.
next/script: carica gli script di terze parti con una strategia (afterInteractive, lazyOnload) invece di bloccare la pagina.
Meno JavaScript lato client: ogni confine 'use client' aggiunge codice da scaricare e idratare, che pesa sull'Interaction to Next Paint da mobile.
Misura i dati reali, non solo un punteggio di laboratorio: la nostra guida a PageSpeed Insights spiega come leggerli entrambi.
Come gestire un blog su Next.js che si posiziona?
Un blog su Next.js assume di solito una di tre forme: file MDX o Markdown nel repository (semplice, ma ogni articolo richiede un commit e un deploy), un CMS headless (Sanity, Contentful, Strapi, Payload) interrogato nei Server Components, oppure un webhook di pubblicazione che riceve articoli da uno strumento esterno. In tutti e tre i casi lo schema SEO è lo stesso: una route dinamica app/blog/[slug] con generateStaticParams, generateMetadata, ISR, una sitemap alimentata dalla stessa fonte e una pagina indice che collega ogni articolo.
Il webhook separa la pubblicazione dal ciclo di deploy. Un Route Handler riceve l'articolo, lo salva e poi rivalida le pagine interessate:
Proteggi l'endpoint con un segreto e rivalida il percorso pubblico esatto. La documentazione ISR avverte che, con più istanze del server e la cache su file predefinita, la rivalidazione su richiesta svuota solo l'istanza che riceve la chiamata; usa un gestore di cache condiviso.
Come aiuta la SEO con Next.js a essere citati dalle IA?
Il rendering lato server è la prima condizione della GEO (ottimizzazione per i motori generativi). L'analisi di Vercel del dicembre 2024, The rise of the AI crawler, ha rilevato che «nessuno dei principali crawler delle IA esegue attualmente il rendering di JavaScript», citando GPTBot, ChatGPT-User, OAI-SearchBot, ClaudeBot e PerplexityBot, e ha contato 569 milioni di richieste di GPTBot e 370 milioni di Claude sulla sua rete in un mese. Una pagina Next.js che prerenderizza testo, titoli e JSON-LD è leggibile da tutti; una pagina renderizzata lato client no.
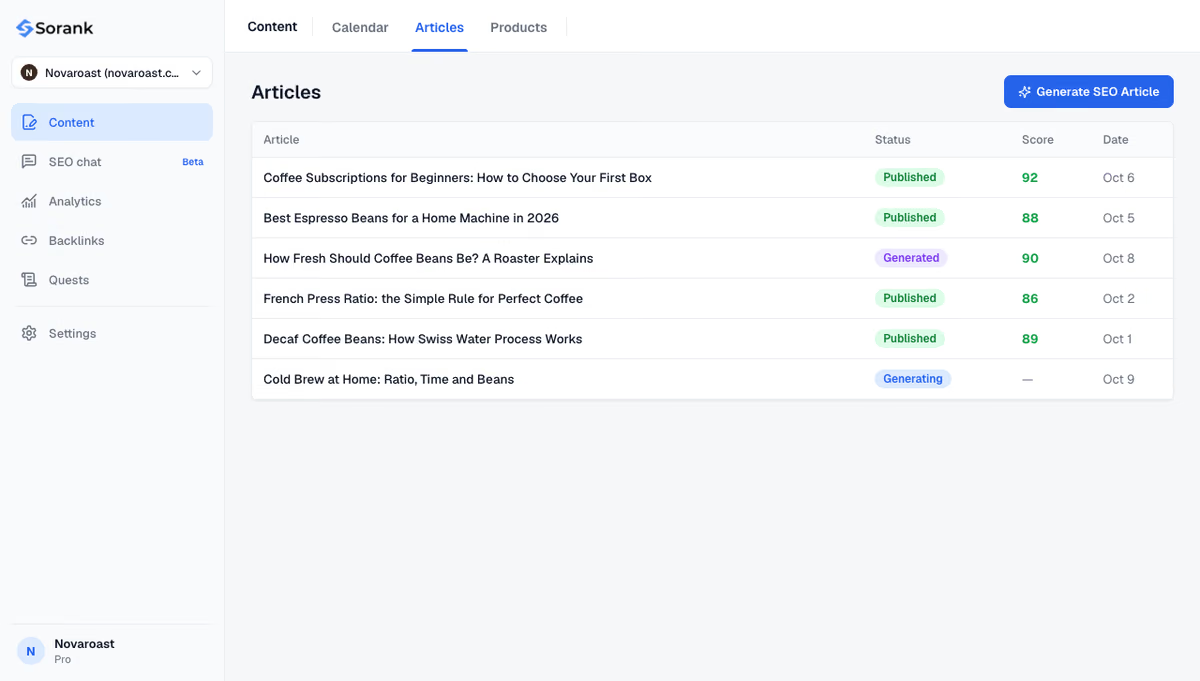
La seconda condizione è un contenuto degno di essere citato: articoli che rispondono a una domanda per sezione, con fonti, dati e definizioni chiare, pubblicati con regolarità. È la parte che automatizza Sorank, il nostro prodotto. Sorank è un software SEO e GEO in autopilot: trova le tue parole chiave e il suo generatore di articoli per il blog scrive 20, 60 o 120 articoli al mese con fonti, link interni e immagini. Su un sito Next.js si collega tramite il webhook personalizzato descritto nella pagina di installazione: il tuo Route Handler riceve ogni articolo, lo salva e rivalida il blog. Il monitoraggio delle menzioni nelle IA verifica poi ogni settimana se ChatGPT, Claude e Gemini citano il tuo brand.
In sintesi: prerenderizza ogni pagina che vuoi far trovare, definisci i metadati sul server e alimenta la sitemap dalla stessa fonte dei contenuti. Next.js fornisce gli strumenti; posizionamenti e citazioni delle IA dipendono da ciò che pubblichi. Per rifornire di articoli un blog Next.js, scopri i piani di Sorank, da 49 € al mese con 3 giorni di prova gratuita.
Domande frequenti
Next.js è meglio di React per la SEO?
Next.js è costruito su React, quindi il confronto riguarda il tipo di rendering. Una single page app React standard viene renderizzata nel browser e invia un HTML quasi vuoto, mentre Next.js prerenderizza le pagine sul server o al build. I crawler, compresi i bot delle IA che non eseguono JavaScript, ricevono con Next.js il contenuto completo senza configurazioni aggiuntive.
Next.js genera una sitemap in automatico?
Non da solo. Nell'App Router aggiungi alla cartella app un file sitemap.ts che restituisce i tuoi URL, e Next.js lo serve all'indirizzo /sitemap.xml. Per i siti grandi, generateSitemaps divide l'elenco in più file, dato che Google accetta fino a 50.000 URL per sitemap.
Per la SEO conviene l'App Router o il Pages Router?
Entrambi possono posizionarsi bene perché entrambi prerenderizzano l'HTML. L'App Router è la scelta consigliata per i nuovi progetti: i Server Components riducono il JavaScript lato client, e Metadata API, sitemap.ts e robots.ts gestiscono nativamente i file SEO. Su un sito esistente in Pages Router, migrare raramente conviene per la sola SEO.
“Ho testato Sorank sul sito reale di un cliente ed è pazzesco. Fa tutto quello che un'agenzia fa pagare 1.500 € al mese. Ora va in produzione su quel cliente.”Guillaume Guersanguersanguillaume.com
“Siamo un'agenzia pubblicitaria e volevamo rimettere in carreggiata il nostro SEO una volta per tutte. Sorank ci ha dato una visione chiara del nostro sito, ci ha aiutato a dare priorità alle ottimizzazioni e a strutturare correttamente i nostri contenuti. Lo strumento è facile da usare, ben progettato per un team e molto pratico per centralizzare il monitoraggio senza dover destreggiarsi tra più piattaforme. Una base molto solida per ripartire da zero con il nostro SEO.”Gaspard MadouiAgenzia Pubblicitaria
“Mi sono specializzata in GEO grazie a Sorank. Il GEO Leaderboard mi permette di mostrare ai miei clienti il loro posizionamento rispetto ai concorrenti su ChatGPT. È un vero differenziatore commerciale.”MélanieFreelancer SEO
“Ottimo servizio, funziona bene per il nostro sito web e ci aiuta a capire come migliorarlo per posizionarci meglio su Google e altrove. Complimenti, continuate così, ve lo consiglio.”Hugo T.Commerciante e-commerce