La privacy è importante per noi, quindi hai la possibilità di disabilitare alcuni tipi di archiviazione che potrebbero non essere necessari per il funzionamento di base del sito web. Il blocco delle categorie può influire sulla tua esperienza sul sito web. Ulteriori informazioni (Politica sui cookie)
GEO tecnico: la checklist 2026 per far leggere e citare il tuo sito dall'IA
GEO tecnico nel 2026: accesso dei crawler IA, rendering lato server, llms.txt, dati strutturati, velocità e freschezza, con checklist per essere citati dall'IA.
Copertina dell’articolo «GEO tecnico», con uno screenshot del software Sorank accanto al titolo
Strumenti
In questa pagina
In breve
Il GEO tecnico è l'insieme delle impostazioni di un sito che permettono ad assistenti IA come ChatGPT, Claude, Perplexity e Gemini di recuperare, leggere e citare le tue pagine. Si riduce a sei verifiche: lasciare entrare i crawler di ricerca IA (robots.txt, firewall, CDN), servire il contenuto principale nell'HTML iniziale, perché la maggior parte dei crawler IA non esegue il JavaScript, tenere le pagine veloci e senza errori, aggiungere dati strutturati coerenti con il testo visibile, pubblicare un file llms.txt come extra a basso costo, e segnalare la freschezza con date esatte e sitemap. Nulla di tutto questo garantisce una citazione, ma un errore su uno di questi punti toglie la tua pagina dalla lista dei candidati.
3 giorni gratis, poi smetti quando vuoi. Garanzia risultati o rimborsati di 90 giorni.
Il GEO tecnico è la parte infrastrutturale della generative engine optimization: tutto ciò che accade prima che un modello IA giudichi se il tuo contenuto vale una citazione. Contenuto e autorevolezza decidono chi viene citato, ma una pagina che un crawler IA non raggiunge, o che legge come un guscio JavaScript vuoto, non entra mai in gara. Google riassume da sé la base per le sue funzioni IA: una pagina deve essere indicizzata e idonea a un frammento, e non ci sono requisiti tecnici aggiuntivi per AI Overviews o AI Mode. Gli altri assistenti IA usano crawler propri, con limiti propri, ed è lì che molti siti perdono visibilità senza accorgersene. Questa guida copre ogni livello, dall'accesso dei bot alla freschezza, con una checklist che puoi applicare in un pomeriggio.
Che cos'è il GEO tecnico e in cosa si differenzia dalla SEO tecnica?
La SEO tecnica rende un sito scansionabile e indicizzabile per Googlebot. Il GEO tecnico estende lo stesso lavoro a una decina di altri bot che si comportano in modo diverso: renderizzano meno, scansionano meno spesso e seguono meno regole. La sovrapposizione è ampia (codici di stato, canonical, sitemap, velocità), quindi un sito con una SEO tecnica solida ha già gran parte delle basi. Le differenze stanno in quattro punti.
Tema
SEO tecnica (Googlebot)
GEO tecnico (crawler IA)
Bot da gestire
Googlebot, Bingbot
OAI-SearchBot, GPTBot, ChatGPT-User, Claude-SearchBot, ClaudeBot, Claude-User, PerplexityBot, Google-Extended e altri
JavaScript
Renderizzato, con ritardo
Non eseguito dalla maggior parte dei crawler IA
Unità di valore
La pagina e il suo posizionamento
Il passaggio che viene citato in una risposta
Logica di esclusione
Bloccare o usare noindex su una pagina
Scelte separate per addestramento, ricerca e visite avviate dall'utente
Misurazione
Search Console
Log del server e monitoraggio dei prompt
La conseguenza pratica: un sito può posizionarsi bene su Google e restare invisibile a ChatGPT o Claude, perché il contenuto è costruito in JavaScript oppure perché una regola del firewall blocca i bot sconosciuti.
Quali crawler IA consentire nel robots.txt?
Ogni azienda IA gestisce ormai più bot, e ciascuno ha un compito diverso. Bloccare quello sbagliato può toglierti dalle risposte IA quando volevi solo escludere l'addestramento dei modelli.
OpenAI
Secondo la documentazione sui crawler di OpenAI (verificata nell'ottobre 2026), OAI-SearchBot decide se le tue pagine compaiono nelle risposte della ricerca di ChatGPT, GPTBot raccoglie contenuti che possono servire ad addestrare i modelli, e ChatGPT-User recupera una pagina quando un utente la richiede. Bloccare GPTBot tiene i tuoi contenuti fuori dall'addestramento senza toglierti dalla ricerca di ChatGPT. Le modifiche al robots.txt richiedono circa 24 ore per essere applicate ai risultati di ricerca, e le regole del robots.txt potrebbero non valere per ChatGPT-User, perché la visita è attivata da una persona.
Anthropic
Anthropic adotta la stessa separazione in tre, come spiega il suo centro assistenza: ClaudeBot per l'addestramento, Claude-SearchBot per l'indicizzazione di ricerca e Claude-User per le pagine recuperate durante una conversazione. Bloccare Claude-SearchBot o Claude-User riduce la tua visibilità nelle risposte di Claude. Anthropic avverte inoltre che bloccare i suoi indirizzi IP non è un opt-out affidabile, perché il bot potrebbe non riuscire a leggere affatto il tuo robots.txt.
Google e gli altri
Gli AI Overviews e l'AI Mode di Google usano il normale indice di Googlebot. Il token Google-Extended controlla solo l'uso dei tuoi contenuti per l'addestramento di Gemini e per il grounding in alcuni altri sistemi Google, e Google precisa che non influisce sull'inclusione né sul posizionamento nella Ricerca Google. Perplexity usa PerplexityBot per il suo indice. Per una configurazione pronta per ogni bot, consulta la nostra guida alle regole robots.txt per i crawler IA e l'elenco dei crawler IA e dei loro user agent.
Obiettivo
Consentire
Blocco facoltativo
Essere citati in ChatGPT
OAI-SearchBot, ChatGPT-User
GPTBot (solo addestramento)
Essere citati in Claude
Claude-SearchBot, Claude-User
ClaudeBot (solo addestramento)
Essere citati in Perplexity
PerplexityBot
Nessuno
Comparire in AI Overviews e AI Mode
Googlebot
Google-Extended (nessun effetto sulla Ricerca)
Attenzione
Il robots.txt è solo metà del controllo. Dal luglio 2025 Cloudflare blocca di default i crawler IA in molte configurazioni, e altri firewall e strumenti di protezione dai bot fanno lo stesso. Controlla il tuo CDN e le impostazioni di sicurezza, poi verifica nei log del server che i bot di ricerca IA ricevano un codice 200.
I crawler IA leggono i contenuti in JavaScript?
Nella maggior parte dei casi no, ed è l'errore di GEO tecnico più comune. Un'analisi di Vercel sulla propria rete (dicembre 2024) ha rilevato che nessuno dei principali crawler IA renderizzava il JavaScript: i bot di OpenAI, Anthropic, Meta, ByteDance e Perplexity scaricano l'HTML grezzo e si fermano lì. ChatGPT e Claude scaricavano i file JavaScript, ma non li eseguivano. Gemini è l'eccezione, perché si appoggia all'infrastruttura di rendering di Googlebot. Lo stesso studio ha misurato il volume di questo traffico: in un mese GPTBot ha fatto 569 milioni di richieste e Claude 370 milioni, contro i 4,5 miliardi di Googlebot.
Se le descrizioni dei prodotti, i prezzi, gli articoli o le FAQ vengono inseriti da un'app React, Vue o Angular dopo il caricamento della pagina, i crawler IA vedono un modello vuoto. La soluzione è servire il contenuto essenziale nella risposta HTML iniziale:
Rendering lato server (SSR) o generazione statica per ogni pagina che vuoi far citare: testo principale, titoli, tabelle, prezzi, autore e date.
Pre-rendering per le vecchie single-page app che non possono passare rapidamente a SSR.
Rendering lato client solo per gli elementi secondari: widget di chat, contatori, personalizzazione.
Un test rapido: apri il codice sorgente della pagina (non l'ispettore) oppure richiedi l'URL con curl. Se il tuo paragrafo principale manca nell'HTML grezzo, i crawler IA non possono citarlo. La nostra guida alla SEO per JavaScript descrive le opzioni di rendering framework per framework, e il controllo gratuito della scansionabilità per l'IA verifica cosa riceve un bot.
In che modo velocità, codici di stato e struttura HTML influiscono sulle citazioni IA?
Gli assistenti IA che navigano in tempo reale recuperano più pagine per domanda e lavorano con tempi stretti. Una pagina lenta o rotta viene saltata e al suo posto si cita un'altra fonte. Lo studio di Vercel ha anche rilevato che i crawler di ChatGPT e Claude incontrano pagine 404 in circa il 34% delle loro richieste, contro l'8% di Googlebot, spesso perché chiedono URL datati. Tre punti contano di più:
Codici di stato: le pagine chiave rispondono con 200, i reindirizzamenti fanno un solo salto e le pagine eliminate che ricevono ancora richieste dei bot vengono reindirizzate al loro equivalente più vicino.
Tempo di risposta: una risposta del server rapida e un documento HTML leggero. Le pagine grandi piene di script inline spingono il testo utile più in basso nel file.
HTML semantico: titoli reali (h2, h3), paragrafi, liste e tabelle. Crawler e modelli dividono le pagine in passaggi seguendo questi tag, quindi una struttura chiara produce passaggi autonomi che si possono citare così come sono.
Le tabelle meritano una menzione a parte: i dati di confronto in una tabella HTML si estraggono facilmente, mentre gli stessi dati in un'immagine o in un grafico canvas vanno persi per ogni crawler IA.
I dati strutturati aiutano la visibilità IA?
I dati strutturati indicano alle macchine di cosa parla una pagina (un articolo, un prodotto, un'organizzazione, una persona) e la collegano a entità note. Google è chiaro: per le sue funzioni IA non serve uno schema speciale, e il markup deve corrispondere al testo visibile. Il loro valore per il GEO tecnico sta nella chiarezza, non in un bonus di ranking. I tipi da implementare sulla maggior parte dei siti:
Organization con link sameAs ai tuoi profili ufficiali, così i modelli collegano il nome del tuo marchio a una sola entità.
Article o BlogPosting con author, datePublished e dateModified.
Product e Offer per le pagine e-commerce, con prezzo e disponibilità coerenti con la pagina.
BreadcrumbList per descrivere la struttura del sito.
Tieni il JSON-LD nell'HTML iniziale, non inserito da un tag manager, per la stessa ragione legata al JavaScript vista sopra. Il controllo dei dati strutturati per LLM confronta il tuo markup con ciò che un modello può leggere, e il nostro articolo sui dati strutturati per la ricerca IA illustra quali tipi contano ancora.
Suggerimento
Scrivi gli stessi dati chiave (nome dell'azienda, anno di fondazione, prezzi, sedi) in modo identico nel testo visibile, nello schema e nei tuoi profili ufficiali. Dati coerenti tra le fonti aiutano un modello a descrivere il tuo marchio senza confonderlo con un altro.
Vale la pena aggiungere un llms.txt?
La proposta llms.txt, pubblicata da Jeremy Howard nel settembre 2024, è un file Markdown nella radice di un sito che elenca le sue pagine più utili con una breve descrizione, così un agente IA trova il contenuto giusto senza analizzare i menu di navigazione. È una proposta e non uno standard formale: non controlla né l'accesso né l'indicizzazione, e Google non lo include tra i requisiti per le sue funzioni IA. Consideralo un extra a basso costo: richiede meno di un'ora, aiuta gli agenti e gli assistenti di programmazione che lo cercano, e ti costringe a decidere quali pagine rappresentano il tuo sito. Puoi redigerlo con il generatore di llms.txt e offrire versioni Markdown pulite delle pagine chiave, se il tuo stack lo consente.
Come segnalare la freschezza agli assistenti IA?
Gli assistenti IA che cercano sul web preferiscono fonti recenti e datate per qualsiasi domanda in cui il tempo conta (prezzi, strumenti, regole, statistiche). La freschezza del contenuto dipende in parte dalla redazione, ma i segnali sono tecnici:
Una data di ultimo aggiornamento visibile nella pagina, coincidente con dateModified nello schema.
Una sitemap XML con valori lastmod accurati, modificati solo quando il contenuto cambia davvero.
Ping IndexNow per Bing e gli altri motori che lo supportano, dato che diversi assistenti IA si affidano all'indice di Bing. Google non usa IndexNow.
URL stabili: aggiornare un articolo allo stesso indirizzo conserva link e storico, mentre un nuovo URL riparte da zero e lascia un 404 dietro di sé.
La checklist del GEO tecnico
Verifica
Come controllare
Priorità
Bot di ricerca IA consentiti nel robots.txt
Leggere il robots.txt per OAI-SearchBot, Claude-SearchBot, PerplexityBot
Alta
Nessun blocco da firewall o CDN
I log del server mostrano risposte 200 ai bot IA
Alta
Contenuto principale nell'HTML grezzo
Visualizzare il sorgente o fare curl dell'URL
Alta
Pagine chiave indicizzate da Google e Bing
Search Console e Bing Webmaster Tools
Alta
Stato 200, reindirizzamenti con un solo salto
Scansione con un crawler SEO
Media
Titoli, liste e tabelle semantiche
Leggere la struttura HTML
Media
Schema Organization e Article
Validatore di dati strutturati
Media
Date visibili e lastmod accurato
Confrontare pagina, schema e sitemap
Media
llms.txt nella radice
Aprire /llms.txt
Bassa
Eseguila una volta sulle 20 pagine più importanti, poi dopo ogni restyling, cambio di CMS o aggiornamento di sicurezza. I log dei crawler IA sono l'unica prova diretta che i bot raggiungono le tue pagine; tutto il resto è inferenza.
Come capire se il GEO tecnico funziona?
Le correzioni tecniche aprono la porta; il risultato si vede nelle risposte IA. Due misurazioni chiudono il cerchio. Primo, i log del server: le visite di OAI-SearchBot, Claude-SearchBot e PerplexityBot dovrebbero aumentare sulle pagine che hai sistemato. Secondo, le citazioni: segui un insieme fisso di domande che fanno i tuoi clienti e verifica, settimana dopo settimana, se il tuo marchio viene nominato e quali fonti vengono citate al suo posto. I modelli tratti da campioni ampi aiutano a fissare le aspettative, come nel nostro studio sulle citazioni di ChatGPT.
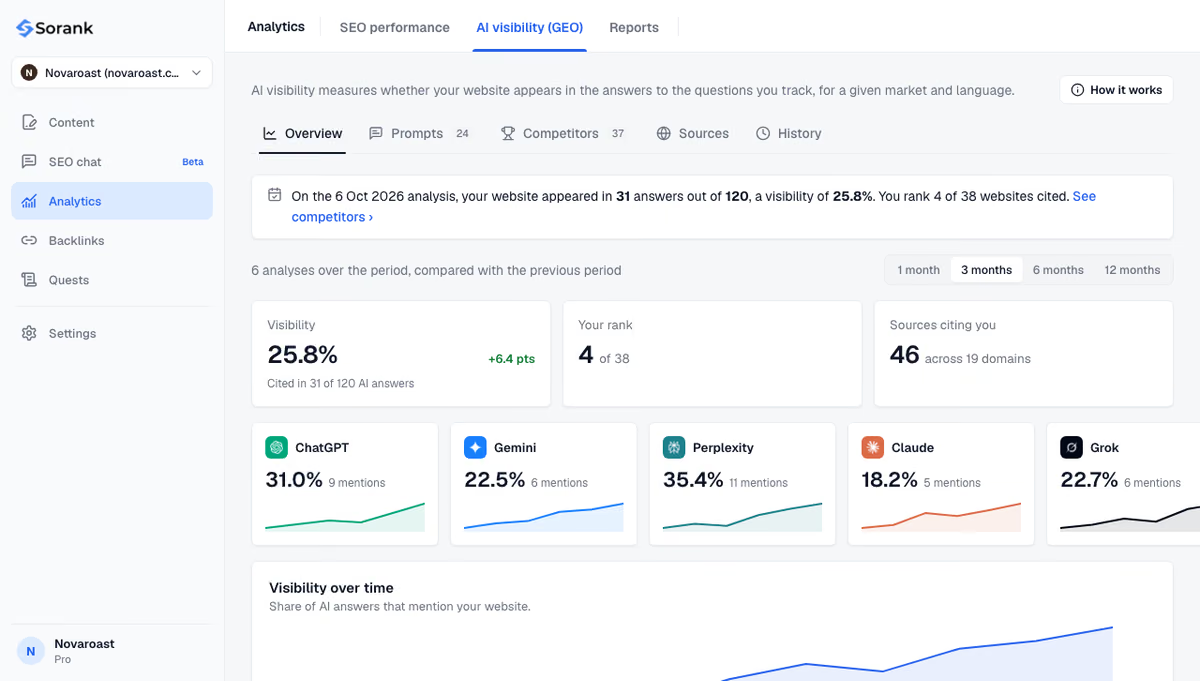
Sorank, il nostro software, copre questa seconda parte con il tracciamento delle menzioni IA: da 10 - 50 prompt monitorati a seconda del piano, su ChatGPT, Claude e Gemini, più Grok dal piano Pro, con il tuo tasso di visibilità e i concorrenti citati al tuo posto.
Una volta pulita la base tecnica, il limite successivo è il contenuto: pagine che rispondono con chiarezza e con fonti. Il generatore di articoli scrive e pubblica in autopilot articoli ottimizzati per Google e per l'IA, con link interni e fonti.
Il GEO tecnico decide se gli assistenti IA possono leggere il tuo sito; contenuto e autorevolezza decidono se lo citano. Sistema prima accesso, rendering e struttura, poi misura le citazioni. Piani e prova gratuita di 3 giorni sono sulla pagina dei prezzi.
Domande frequenti
Devo bloccare GPTBot per proteggere i miei contenuti?
Bloccare GPTBot dice solo a OpenAI di non usare i tuoi contenuti per addestrare i suoi modelli. Il tuo sito non scompare dalle risposte della ricerca di ChatGPT, che dipendono da OAI-SearchBot. Se vuoi essere citato in ChatGPT, lascia OAI-SearchBot consentito, qualunque sia la tua scelta su GPTBot.
Google usa llms.txt per gli AI Overviews?
No. Google indica che gli AI Overviews e l'AI Mode non hanno requisiti tecnici oltre all'essere indicizzati e idonei a un frammento nella Ricerca. llms.txt può aiutare altri agenti IA a trovare le tue pagine chiave, ma non ha alcun effetto sul posizionamento Google né sugli AI Overviews.
Qual è la differenza tra GEO tecnico e AEO?
AEO (ottimizzazione per i motori di risposta) e GEO descrivono lo stesso obiettivo: essere citati nelle risposte generate dagli assistenti IA. Il GEO tecnico, a volte chiamato AEO tecnico, copre la parte infrastrutturale di questo lavoro: accesso dei bot, rendering, velocità, dati strutturati e freschezza. Contenuto e autorevolezza vengono dopo.
y!
Audit SEO e GEO gratuito
Ricevi gratis il tuo piano di contenuti per 30 giorni
Analizziamo i tuoi concorrenti, il tuo sito web e la tua visibilità nelle IA per creare gratuitamente un piano di contenuti su misura.
“Ho testato Sorank sul sito reale di un cliente ed è pazzesco. Fa tutto quello che un'agenzia fa pagare 1.500 € al mese. Ora va in produzione su quel cliente.”Guillaume Guersanguersanguillaume.com
“Siamo un'agenzia pubblicitaria e volevamo rimettere in carreggiata il nostro SEO una volta per tutte. Sorank ci ha dato una visione chiara del nostro sito, ci ha aiutato a dare priorità alle ottimizzazioni e a strutturare correttamente i nostri contenuti. Lo strumento è facile da usare, ben progettato per un team e molto pratico per centralizzare il monitoraggio senza dover destreggiarsi tra più piattaforme. Una base molto solida per ripartire da zero con il nostro SEO.”Gaspard MadouiAgenzia Pubblicitaria
“Mi sono specializzata in GEO grazie a Sorank. Il GEO Leaderboard mi permette di mostrare ai miei clienti il loro posizionamento rispetto ai concorrenti su ChatGPT. È un vero differenziatore commerciale.”MélanieFreelancer SEO
Crescita organicaGenerazione di lead per installatori
“Ottimo servizio, funziona bene per il nostro sito web e ci aiuta a capire come migliorarlo per posizionarci meglio su Google e altrove. Complimenti, continuate così, ve lo consiglio.”Hugo T.Commerciante e-commerce