Налаштування
Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше

Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше

Технічний GEO у 2026: доступ ШІ-краулерів, серверний рендеринг, llms.txt, структуровані дані, швидкість і актуальність, з чек-листом для цитування ШІ.


Інструменти

Коротко
Технічний GEO це набір налаштувань сайту, які дозволяють ШІ-асистентам на кшталт ChatGPT, Claude, Perplexity і Gemini отримувати, читати та цитувати ваші сторінки. Усе зводиться до шести перевірок: пустити пошукові ШІ-краулери (robots.txt, файрвол, CDN), віддавати основний вміст у початковому HTML, бо більшість ШІ-краулерів не виконують JavaScript, тримати сторінки швидкими та без помилок, додати структуровані дані, що відповідають видимому тексту, опублікувати файл llms.txt як недороге доповнення та показувати актуальність точними датами і картами сайту. Жодна з цих речей не гарантує цитування, але збій на будь-якому з цих пунктів виключає сторінку зі списку кандидатів.
Хочете дізнатися більше? Запитайте
Швидкий тест
Як домогтися, щоб вас згадували ChatGPT та інші ШІ-асистенти?
Sorank відповідає вашим відповідям


Спробуйте його 3 дні на власному сайті й дізнайтеся, де ви зараз у Google, ChatGPT та інших ШІ.
Спробувати 3 дні безкоштовно3 дні безкоштовно, потім зупиніть, коли захочете. Гарантія результату або повернення коштів протягом 90 днів.
Технічний GEO це інфраструктурна частина оптимізації для генеративних пошукових систем: усе, що відбувається до того, як ШІ-модель вирішить, чи варт ваш вміст цитування. Кого цитують, вирішують вміст і авторитетність, але сторінка, до якої не може дістатися ШІ-краулер або яку він бачить як порожній каркас JavaScript, у перегонах не бере участі. Google сам описує базові вимоги до своїх ШІ-функцій: сторінка має бути проіндексована і придатна для сніпета, а для AI Overviews та AI Mode жодних додаткових технічних вимог немає. Інші ШІ-асистенти працюють зі своїми краулерами та зі своїми обмеженнями, і саме тут багато сайтів втрачають видимість, навіть не помічаючи цього. Цей посібник розглядає кожен рівень, від доступу ботів до актуальності, з чек-листом, який можна пройти за один день.
Технічне SEO робить сайт доступним для сканування та індексації Googlebot. Технічний GEO поширює цю роботу на десятки інших ботів, які поводяться інакше: вони рендерять менше, сканують рідше і дотримуються менше правил. Перетин великий (коди статусу, канонічні адреси, карти сайту, швидкість), тож у сайту з хорошим технічним SEO уже є більша частина фундаменту. Різниці в чотирьох місцях.
| Тема | Технічне SEO (Googlebot) | Технічний GEO (ШІ-краулери) |
|---|---|---|
| Якими ботами керувати | Googlebot, Bingbot | OAI-SearchBot, GPTBot, ChatGPT-User, Claude-SearchBot, ClaudeBot, Claude-User, PerplexityBot, Google-Extended та інші |
| JavaScript | Рендериться із затримкою | Не виконується більшістю ШІ-краулерів |
| Одиниця цінності | Сторінка та її позиція | Фрагмент, який цитується у відповіді |
| Логіка виключення | Блокування або noindex для сторінки | Окремі рішення для навчання, пошуку і візитів, ініційованих користувачем |
| Вимірювання | Search Console | Логи сервера та відстеження промптів |
Практичний висновок: сайт може добре ранжуватися в Google і залишатися невидимим для ChatGPT або Claude, бо вміст побудовано на JavaScript або бо правило файрвола блокує невідомих ботів.
Кожна ШІ-компанія зараз використовує кілька ботів, і кожен має свою задачу. Блокування не того бота може прибрати вас із відповідей ШІ, хоча ви хотіли лише заборонити навчання моделей.
Згідно з документацією OpenAI про краулери (перевірено в жовтні 2026), OAI-SearchBot вирішує, чи з'являються ваші сторінки у відповідях пошуку ChatGPT, GPTBot збирає вміст, який може бути використаний для навчання моделей, а ChatGPT-User завантажує сторінку, коли її запитує користувач. Блокування GPTBot тримає ваш вміст поза навчанням, але не прибирає вас з пошуку ChatGPT. Зміни в robots.txt застосовуються до результатів пошуку приблизно за 24 години, а правила robots.txt можуть не поширюватися на ChatGPT-User, бо візит ініціює людина.
Anthropic використовує той самий поділ на три види, як пояснює його центр довідки: ClaudeBot для навчання, Claude-SearchBot для індексації пошуку та Claude-User для сторінок, які завантажуються під час розмови. Блокування Claude-SearchBot або Claude-User знижує вашу видимість у відповідях Claude. Anthropic також попереджає, що блокування його IP-адрес не є надійною відмовою, бо бот може взагалі не прочитати ваш robots.txt.
AI Overviews і AI Mode у Google використовують звичайний індекс Googlebot. Токен Google-Extended керує лише використанням вашого вмісту для навчання Gemini та для grounding в деяких інших системах Google, і Google зазначає, що це не впливає на включення до Пошуку Google чи на ранжування. Perplexity для свого індексу використовує PerplexityBot. Готову конфігурацію для кожного бота дивіться в нашому посібнику з правил robots.txt для ШІ-краулерів і в списку ШІ-краулерів та їхніх user agent.
| Мета | Дозволити | Блокування за бажанням |
|---|---|---|
| Цитування в ChatGPT | OAI-SearchBot, ChatGPT-User | GPTBot (лише навчання) |
| Цитування в Claude | Claude-SearchBot, Claude-User | ClaudeBot (лише навчання) |
| Цитування в Perplexity | PerplexityBot | Немає |
| Поява в AI Overviews і AI Mode | Googlebot | Google-Extended (без впливу на Пошук) |
Увага
robots.txt це лише половина перевірки. Із липня 2025 року Cloudflare за замовчуванням блокує ШІ-краулери в багатьох конфігураціях, і те саме роблять інші файрволи та інструменти захисту від ботів. Перевірте CDN і налаштування безпеки, а потім у логах сервера переконайтеся, що пошукові боти ШІ отримують код 200.
Здебільшого ні, і це найпоширеніша помилка технічного GEO. Аналіз Vercel щодо його мережі (грудень 2024) показав, що жоден із великих ШІ-краулерів не рендерив JavaScript: боти OpenAI, Anthropic, Meta, ByteDance і Perplexity завантажують сирий HTML і на цьому зупиняються. ChatGPT і Claude завантажували файли JavaScript, але не виконували їх. Gemini є винятком, бо спирається на інфраструктуру рендерингу Googlebot. Те саме дослідження виміряло масштаб цього трафіку: за місяць GPTBot зробив 569 мільйонів запитів, Claude 370 мільйонів, тоді як Googlebot 4,5 мільярда.
Якщо описи товарів, ціни, статті чи FAQ додаються застосунком React, Vue або Angular вже після завантаження сторінки, ШІ-краулери бачать порожній шаблон. Рішення полягає в тому, щоб віддавати основний вміст у початковій HTML-відповіді:
Швидка перевірка: відкрийте вихідний код сторінки (а не інспектор) або завантажте URL через curl. Якщо основного абзацу немає в сирому HTML, ШІ-краулери не можуть його процитувати. Наш посібник з SEO для JavaScript розглядає варіанти рендерингу для кожного фреймворка, а безкоштовний аудит доступності для ШІ перевіряє, що отримує бот.
ШІ-асистенти, що переглядають веб у реальному часі, завантажують кілька сторінок на одне запитання і працюють у жорстких часових межах. Повільна або зламана сторінка пропускається, а замість неї цитується інше джерело. Дослідження Vercel також показало, що краулери ChatGPT і Claude натрапляють на сторінки 404 приблизно в 34 % своїх запитів, тоді як у Googlebot це 8 %, часто тому, що запитують застарілі адреси. Найважливіші три моменти:
Таблицям варто приділити окрему увагу: порівняльні дані в HTML-таблиці легко витягти, а ті самі дані в зображенні чи на графіку canvas втрачаються для кожного ШІ-краулера.
Структуровані дані показують машинам, про що сторінка (стаття, товар, організація, людина), і пов'язують її з відомими сутностями. Google чітко каже: для його ШІ-функцій спеціальна схема не потрібна, а розмітка має відповідати видимому тексту. Їхня цінність для технічного GEO полягає в ясності, а не в підвищенні позицій. Типи, які варто впровадити на більшості сайтів:
Тримайте JSON-LD у початковому HTML, а не додавайте його менеджером тегів, з тієї ж причини, що й вище. Аудит структурованих даних для LLM перевіряє вашу розмітку на те, що може прочитати модель, а наша стаття про структуровані дані для ШІ-пошуку пояснює, які типи ще мають значення.
Порада
Пишіть однакові ключові факти (назву компанії, рік заснування, ціни, локації) ідентично у видимому тексті, у розмітці та в офіційних профілях. Узгоджені факти з різних джерел допомагають моделі описувати ваш бренд, не плутаючи його з іншим.
Пропозиція llms.txt, опублікована Джеремі Говардом у вересні 2024, це файл Markdown у корені сайту, який перелічує його найкорисніші сторінки з короткими описами, щоб ШІ-агент знаходив потрібний вміст без розбору навігаційних меню. Це пропозиція, а не офіційний стандарт: він не керує ні доступом, ні індексацією, і Google не вносить його до вимог своїх ШІ-функцій. Вважайте його недорогим доповненням: на нього йде менше години, він допомагає агентам і помічникам для програмістів, які його шукають, і змушує вирішити, які сторінки представляють ваш сайт. Чернетку можна скласти за допомогою генератора llms.txt, а якщо ваша система дозволяє, запропонуйте чисті Markdown-версії ключових сторінок.
ШІ-асистенти, які шукають у вебі, надають перевагу свіжим і датованим джерелам для будь-якого запитання, де важливий час (ціни, інструменти, правила, статистика). Актуальність вмісту частково є редакційним питанням, але сигнали технічні:
| Перевірка | Як перевірити | Пріоритет |
|---|---|---|
| Пошукові боти ШІ дозволені в robots.txt | Прочитати robots.txt для OAI-SearchBot, Claude-SearchBot, PerplexityBot | Високий |
| Немає блокування файрволом або CDN | Логи сервера показують відповіді 200 для ШІ-ботів | Високий |
| Основний вміст у сирому HTML | Переглянути вихідний код або завантажити URL через curl | Високий |
| Ключові сторінки проіндексовано в Google і Bing | Search Console і Bing Webmaster Tools | Високий |
| Статус 200, перенаправлення в один перехід | Просканувати SEO-краулером | Середній |
| Семантичні заголовки, списки і таблиці | Прочитати структуру HTML | Середній |
| Схема Organization і Article | Валідатор схем | Середній |
| Видимі дати і точний lastmod | Порівняти сторінку, схему і карту сайту | Середній |
| llms.txt у корені | Відкрити /llms.txt | Низький |
Проведіть її один раз на 20 найважливіших сторінках, а потім після кожного редизайну, зміни CMS чи оновлення безпеки. Логи ШІ-краулерів це єдиний прямий доказ того, що боти доходять до ваших сторінок; усе інше є припущенням.
Технічні виправлення відчиняють двері, а результат з'являється у відповідях ШІ. Два вимірювання замикають цикл. По-перше, логи сервера: відвідування OAI-SearchBot, Claude-SearchBot і PerplexityBot мають зростати на виправлених сторінках. По-друге, цитування: відстежуйте сталий набір запитань, які ставлять ваші клієнти, і перевіряйте щотижня, чи згадується ваш бренд і які джерела цитуються замість нього. Закономірності з великих вибірок допомагають встановити очікування, як у нашому дослідженні цитувань ChatGPT.
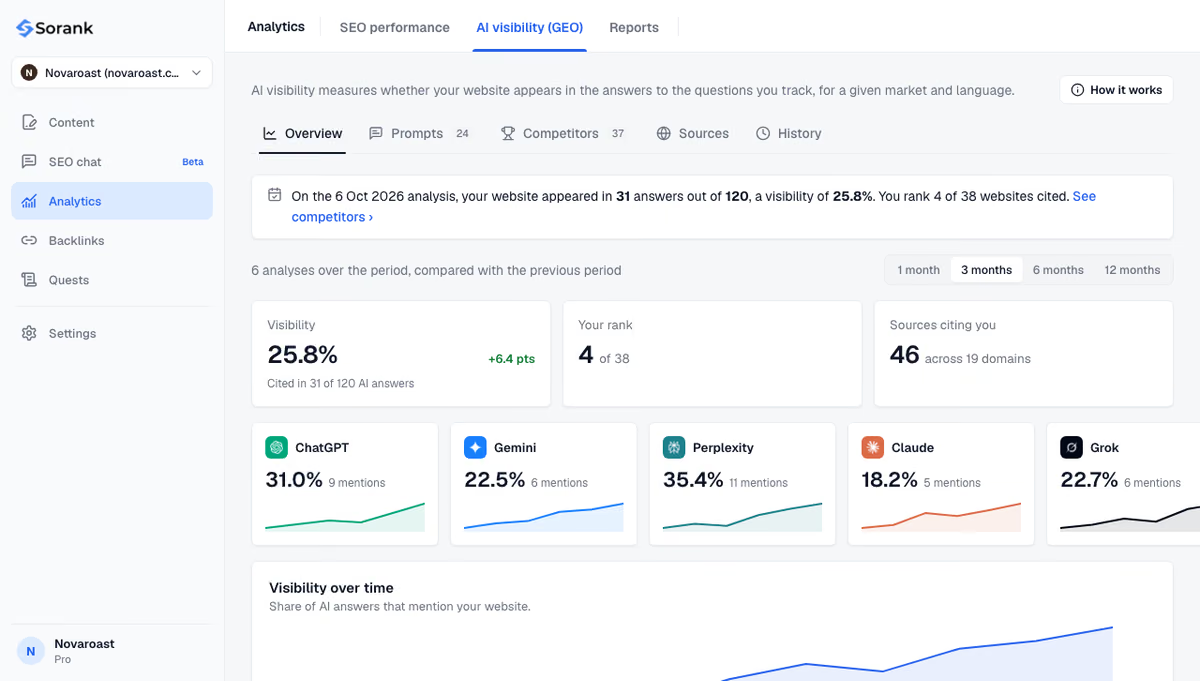
Sorank, наш софт, закриває цю другу частину за допомогою відстеження згадок у ШІ: від 10 - 50 відстежуваних промптів залежно від тарифу, у ChatGPT, Claude і Gemini, а також Grok на тарифі Pro, з вашою часткою видимості та конкурентами, які цитуються замість вас.
Коли технічна база чиста, наступне обмеження це вміст: сторінки, які ясно відповідають на запитання і спираються на джерела. Генератор статей пише і публікує оптимізовані для Google та ШІ статті у режимі autopilot, з внутрішніми посиланнями та джерелами.
Технічний GEO визначає, чи можуть ШІ-асистенти читати ваш сайт; вміст і авторитетність визначають, чи вони його цитують. Спершу виправте доступ, рендеринг і структуру, а потім вимірюйте цитування. Тарифи і 3-денна безкоштовна пробна версія є на сторінці цін.

Блокування GPTBot лише повідомляє OpenAI, що не слід використовувати ваш вміст для навчання моделі. Ваш сайт не зникає з відповідей пошуку ChatGPT, який залежить від OAI-SearchBot. Якщо ви хочете цитуватися в ChatGPT, залиште OAI-SearchBot дозволеним, яке б рішення ви не прийняли щодо GPTBot.
Ні. Google зазначає, що для AI Overviews і AI Mode немає технічних вимог, окрім того, що сторінка проіндексована і придатна для сніпета в пошуку. llms.txt може допомогти іншим ШІ-агентам знайти ваші ключові сторінки, але на ранжування в Google чи на AI Overviews він не впливає.
AEO (оптимізація для систем відповідей) і GEO описують одну й ту саму мету: бути процитованим у відповідях, які генерують ШІ-асистенти. Технічний GEO, який інколи називають технічним AEO, охоплює інфраструктурну частину цієї роботи: доступ ботів, рендеринг, швидкість, структуровані дані та актуальність. Вміст і авторитетність будуються поверх цього.
Ми аналізуємо ваших конкурентів, ваш сайт і вашу видимість у ШІ, щоб безкоштовно скласти персоналізований контент-план.
 ШІ-генератор брифів для контенту
 Генератор FAQ-розмітки
 ШІ-генератор ідей для статей у блозі
 Валідатор структурованих даних (валідатор Schema)
 Перевірка alt-тексту
 Аналізатор внутрішніх посилань
 Челендж із зворотних посилань
 ШІ-генератор мета-описів
 ШІ-генератор заголовків для блогу
 Перевірка індексованості в Google
 ШІ-генератор плану статті для блогу
 Конструктор UTM-посилань
 Інструмент кластеризації ключових слів
 Перевірка тегу canonical
 Генератор XML-карти сайту
 Перевірка битих посилань
 ШІ-генератор SEO-заголовків
 Аналізатор заголовків
 Попередній перегляд пошукової видачі
 Перевірка перенаправлень
 Генератор тегів hreflang
 Аналізатор структури заголовків
 Перевірка HTTP-заголовків
 Екстрактор фавіконок
 Калькулятор CTR у видачі
 Калькулятор економії SEO порівняно з платним пошуком
 Калькулятор частки голосу в SEO
 Калькулятор ROI від SEO
 Калькулятор прогнозу трафіку та доходу від SEO
 Калькулятор бюджету SEO
 Калькулятор беззбитковості SEO
 Калькулятор ROI від SEO для SaaS
 Калькулятор ROAS
 Калькулятор часу читання
 Симулятор приросту позицій
 Калькулятор вартості органічного трафіку
 Оцінювач органічного трафіку та перевірка відвідуваності сайту
 Калькулятор співвідношення LTV до CAC
 Калькулятор ROI локального SEO
 Калькулятор вартості лінкбілдингу
 Калькулятор вартості ключового слова
 Калькулятор оцінки можливостей ключових слів
 Калькулятор щільності ключових слів
 Калькулятор ROI GEO
 Калькулятор інвестицій у GEO-контент
 Калькулятор ROI SEO для інтернет-магазину
 Калькулятор пожиттєвої цінності клієнта
 Калькулятор вартості залучення клієнта
 Калькулятор CTR
 Калькулятор вартості статті
 Калькулятор коефіцієнта конверсії
 Калькулятор ROI контент-маркетингу
 Оцінювач реферального трафіку з ChatGPT
 Калькулятор показника відмов
 Калькулятор ROI зворотних посилань
 Калькулятор оцінки видимості у ШІ
 Калькулятор вартості AI-трафіку
 Калькулятор частки голосу в ШІ
 Калькулятор вартості невидимості в ШІ
 Калькулятор частоти цитування в ШІ
 Валідатор llms.txt
 Перевірка AI Overview і позицій в AI Overviews
 Перевірка robots.txt
 SEO-аудит для ШІ
 Перевірка читабельності для LLM
 Перевірка готовності до SearchGPT
 Аудит структурованих даних для LLM
 ШІ-аудит доступності сайту для краулерів
 Чому ChatGPT не рекомендує мій сайт
 Інструмент позицій у Gemini
 Перевірка позицій у Perplexity
 Перевірка цитування в LLM
 Аудит оптимізації для відповідних систем (AEO)
 GEO-аудит
 Тест видимості в ШІ-пошуку
 Перевірка видимості в ChatGPT
 Генератор llms.txt
 Екстрактор URL
 Веб-сторінка в Markdown
 Перевірка карти сайту
 Сенсор волатильності видачі
 Перевірка розміру сторінки
 Лічильник слів
 Генератор слагів
 Генератор Schema
 Генератор Robots
 Попередній перегляд Open Graph
 Генератор мета-тегів
 Компресор зображень
 Генератор фавіконок
 SEO-аудит сторінки: SEO-перевірка та SEO-аналіз
 Інструмент аналізу зворотних посилань
 Інструмент підбору ключових слів
 Перевірка авторитету домену
ВОНИ ПРОБУВАЛИ SORANK ДО ВАС
 “Я протестував Sorank на реальному сайті клієнта, і це неймовірно. Він робить усе, за що агенція виставила б вам рахунок на 1500 доларів на місяць. Тепер його запускають у роботу на цьому клієнті.”

 Guillaume Guersanguersanguillaume.com“Ми рекламна агенція і хотіли раз і назавжди повернути своє SEO в нормальне русло. Sorank дав нам чітке уявлення про наш сайт, допоміг розставити пріоритети оптимізацій і належним чином структурувати наш контент. Інструмент простий у використанні, добре продуманий для команди й дуже зручний для централізованого відстеження без жонглювання кількома платформами. Дуже міцна основа, щоб почати наше SEO з нуля.”
 Gaspard MadouiРекламна агенція
 “Я просто дозволив програмі Sorank повністю робити свою справу, і тепер мій показник DR дорівнює 25, а моя сторінка піднялася вище в пошуку.”
 Lucas Flandrefoundertrace.fr“Я спеціалізувалася на GEO завдяки Sorank. Рейтинг GEO дає змогу показувати клієнтам їхню позицію щодо конкурентів у ChatGPT. Це справжня комерційна перевага.”
 MélanieSEO-фрілансерка“Чудовий сервіс, добре працює для нашого сайту й допомагає зрозуміти, як його покращити, щоб вище ранжуватися в Google та поза ним. Вітаю, так тримати, рекомендую.”
 Hugo T.Власник інтернет-магазину