Předvolby
Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

Technické GEO v 2026: přístup crawlerů AI, vykreslování na serveru, llms.txt, strukturovaná data, rychlost a aktuálnost, s kontrolním seznamem pro citace v AI.


Nástroje

Stručně
Technické GEO je soubor nastavení webu, která asistentům AI, jako jsou ChatGPT, Claude, Perplexity a Gemini, umožní načíst, přečíst a citovat vaše stránky. Sestává ze šesti kontrol: pusťte dovnitř crawlery vyhledávání AI (robots.txt, firewall, CDN), podávejte hlavní obsah už v počátečním HTML, protože většina crawlerů AI JavaScript nespouští, udržujte stránky rychlé a bez chyb, přidejte strukturovaná data, která odpovídají viditelnému textu, publikujte soubor llms.txt jako levný doplněk a signalizujte aktuálnost přesnými daty a mapami webu. Nic z toho citaci nezaručí, ale selhání v kterémkoli z těchto bodů vaši stránku vyřadí z kandidátů.
Chcete jít dál? Zeptejte se
Rychlý kvíz
Jak se dostat do zmínek v ChatGPT a dalších AI asistentech?
Sorank odpovídá vašim odpovědím


Vyzkoušejte to 3 dny na svém webu a zjistěte, kde stojíte na Googlu, v ChatGPT a v ostatních AI.
Spustit 3denní bezplatnou zkušební verzi3 dny zdarma, poté můžete kdykoli přestat. Garance výsledků nebo vrácení peněz do 90 dnů.
Technické GEO je infrastrukturní stránka optimalizace pro generativní vyhledávače: vše, co se děje dříve, než model AI posoudí, zda váš obsah stojí za citaci. Obsah a autorita rozhodují, kdo bude citován, ale stránka, kterou crawler AI nedosáhne, nebo ji načte jako prázdnou kostru v JavaScriptu, do závodu vůbec nevstoupí. Google sám shrnuje základ pro své funkce AI: stránka musí být zaindexovaná a způsobilá k úryvku a pro přehledy AI ani režim AI nejsou žádné další technické požadavky. Ostatní asistenti AI provozují vlastní crawlery s vlastními limity a právě tam většina webů ztrácí viditelnost, aniž o tom ví. Tento průvodce pokrývá každou vrstvu, od přístupu botů po aktuálnost, s kontrolním seznamem, který lze projít za odpoledne.
Technické SEO zpřístupňuje web pro procházení a indexaci Googlebotem. Technické GEO rozšiřuje stejnou práci na tucet dalších botů, kteří se chovají jinak: vykreslují méně, procházejí méně často a dodržují méně pravidel. Překryv je velký (stavové kódy, kanonické značky, mapy webu, rychlost), takže web s čistým technickým SEO už má většinu základů. Rozdíly leží na čtyřech místech.
| Téma | Technické SEO (Googlebot) | Technické GEO (crawlery AI) |
|---|---|---|
| Boti ke správě | Googlebot, Bingbot | OAI-SearchBot, GPTBot, ChatGPT-User, Claude-SearchBot, ClaudeBot, Claude-User, PerplexityBot, Google-Extended a další |
| JavaScript | Vykresluje se se zpožděním | Většina crawlerů AI ho nespouští |
| Jednotka hodnoty | Stránka a její pořadí | Pasáž, která je citována v odpovědi |
| Logika odhlášení | Zablokovat nebo označit stránku noindex | Samostatná rozhodnutí pro trénink, vyhledávání a návštěvy vyvolané uživatelem |
| Měření | Search Console | Serverové logy a sledování promptů |
Praktický důsledek: web se může na Googlu dobře umisťovat a přesto být neviditelný pro ChatGPT nebo Claude, protože obsah je postaven v JavaScriptu nebo proto, že pravidlo firewallu blokuje neznámé boty.
Každá firma s AI dnes provozuje několik botů a každý má jiný úkol. Zablokování špatného může vyřadit vaši značku z odpovědí AI, i když jste chtěli jen odmítnout trénování modelů.
Podle dokumentace OpenAI ke crawlerům (ověřeno v říjnu 2026) OAI-SearchBot rozhoduje, zda se vaše stránky objeví v odpovědích vyhledávání ChatGPT, GPTBot sbírá obsah, který může sloužit k trénování jejich modelů, a ChatGPT-User stáhne stránku, když o ni uživatel požádá. Zakázání GPTBot udrží váš obsah mimo trénink, aniž by vás odstranilo z vyhledávání ChatGPT. Změny v robots.txt se v výsledcích vyhledávání projeví zhruba za 24 hodin a pravidla robots.txt se nemusí vztahovat na ChatGPT-User, protože návštěvu spouští člověk.
Anthropic používá stejné třístupňové rozdělení, jak vysvětluje jeho centrum nápovědy: ClaudeBot pro trénink, Claude-SearchBot pro indexaci vyhledávání a Claude-User pro stránky stažené během konverzace. Zablokování Claude-SearchBot nebo Claude-User snižuje vaši viditelnost v odpovědích Claude. Anthropic také varuje, že blokování jeho IP adres není spolehlivé odhlášení, protože bot pak nemusí přečíst váš robots.txt vůbec.
Přehledy AI od Google a režim AI používají běžný index Googlebotu. Token Google-Extended řídí jen použití vašeho obsahu pro trénink a ukotvení Gemini v některých dalších systémech Google a Google uvádí, že neovlivňuje zařazení ani pořadí ve vyhledávání Google. Perplexity pro svůj index používá PerplexityBot. Hotovou konfiguraci pro jednotlivé boty najdete v našem průvodci pravidly robots.txt pro crawlery AI a v přehledu crawlerů AI a jejich uživatelských agentů.
| Cíl | Povolit | Volitelně blokovat |
|---|---|---|
| Být citován v ChatGPT | OAI-SearchBot, ChatGPT-User | GPTBot (jen trénink) |
| Být citován v Claude | Claude-SearchBot, Claude-User | ClaudeBot (jen trénink) |
| Být citován v Perplexity | PerplexityBot | Nic |
| Objevit se v přehledech AI a režimu AI | Googlebot | Google-Extended (bez vlivu na vyhledávání) |
Pozor
Robots.txt je jen polovina kontroly. Od července 2025 Cloudflare u mnoha konfigurací blokuje crawlery AI ve výchozím nastavení a stejně to dělají další firewally a nástroje pro ochranu proti botům. Podívejte se do nastavení CDN a zabezpečení a potom v serverových logách potvrďte, že boti vyhledávání AI dostávají stavový kód 200.
Většinou ne, a to je nejčastější chyba technického GEO. Analýza sítě Vercel (prosinec 2024) zjistila, že žádný z hlavních crawlerů AI nevykresloval JavaScript: boti OpenAI, Anthropic, Meta, ByteDance a Perplexity stáhnou surové HTML a tam se zastaví. ChatGPT a Claude sice stahovali soubory JavaScriptu, ale nespouštěli je. Výjimkou je Gemini, který se opírá o vykreslovací infrastrukturu Googlebotu. Stejná studie změřila rozsah tohoto provozu: za jeden měsíc GPTBot vytvořil 569 milionů požadavků a Claude 370 milionů, proti 4,5 miliardy u Googlebotu.
Pokud vaše popisy produktů, ceny, články nebo FAQ vkládá aplikace React, Vue nebo Angular až po načtení stránky, crawlery AI vidí prázdnou šablonu. Oprava spočívá v tom, že podstatný obsah je obsažen v počáteční odpovědi HTML:
Rychlý test: otevřete zdrojový kód stránky (ne inspektor) nebo si URL stáhněte příkazem curl. Pokud váš hlavní odstavec v surovém HTML chybí, crawlery AI ho nemohou citovat. Náš průvodce SEO pro JavaScript popisuje možnosti vykreslování framework po frameworku a bezplatný audit procházitelnosti pro AI kontroluje, co bot dostane.
Asistenti AI, kteří procházejí web v reálném čase, stahují na jednu otázku několik stránek a pracují pod přísnými časovými limity. Pomalá nebo rozbitá stránka se přeskočí a citován je jiný zdroj. Studie Vercel také zjistila, že crawlery ChatGPT a Claude narážely na stránky 404 přibližně u 34 % svých stahování, oproti 8 % u Googlebotu, často proto, že žádaly zastaralé URL. Nejdůležitější jsou tři body:
Tabulky si zaslouží zvláštní zmínku: srovnávací data v tabulce HTML se snadno extrahují, kdežto stejná data v obrázku nebo v grafu canvas jsou pro každý crawler AI ztracená.
Strukturovaná data pomáhají strojům určit, o čem stránka je (článek, produkt, organizace, osoba), a propojit ji s známými entitami. Google jasně říká, že pro jeho funkce AI není zapotřebí žádné zvláštní schema a že značkování musí odpovídat viditelnému textu. Jeho hodnota pro technické GEO spočívá v jasnosti, ne v zisku pořadí. Typy, které stojí za implementaci na většině webů:
Držte JSON-LD v počátečním HTML, ne vložený správcem značek, a to ze stejného důvodu jako výše, tedy kvůli JavaScriptu. audit strukturovaných dat pro LLM ověřuje vaše značkování proti tomu, co model dokáže přečíst, a náš článek o strukturovaných datech pro vyhledávání AI popisuje, které typy stále mají váhu.
Tip
Stejné klíčové údaje (název firmy, rok založení, ceny, lokality) pište identicky ve viditelném textu, ve schema i na oficiálních profilech. Konzistentní údaje napříč zdroji usnadňují modelu popsat vaši značku, aniž by ji zaměnil s jinou.
Návrh llms.txt, který v září 2024 zveřejnil Jeremy Howard, je soubor Markdown v kořeni webu, který vypisuje jeho nejužitečnější stránky s krátkým popisem, aby agent AI našel správný obsah bez čtení navigačních menu. Je to návrh, nikoli formální standard, neřídí přístup ani indexaci a Google ho mezi požadavky na své funkce AI neuvádí. Berte ho jako levný doplněk: zabere méně než hodinu, pomáhá agentům a asistentům pro programování, kteří ho hledají, a nutí vás rozhodnout, které stránky reprezentují váš web. Koncept můžete sestavit pomocí generátoru llms.txt a pokud to váš systém dovolí, nabídněte čisté verze klíčových stránek v Markdownu.
Asistenti AI, kteří na webu vyhledávají, u každé otázky, kde záleží na čase (ceny, nástroje, pravidla, statistiky), upřednostňují čerstvé a datované zdroje. Aktuálnost obsahu je částečně redakční záležitost, ale signály jsou technické:
| Kontrola | Jak ověřit | Priorita |
|---|---|---|
| Boti vyhledávání AI povoleni v robots.txt | Přečíst robots.txt pro OAI-SearchBot, Claude-SearchBot, PerplexityBot | Vysoká |
| Žádné blokování firewallem nebo CDN | Serverové logy ukazují odpovědi 200 pro boty AI | Vysoká |
| Hlavní obsah v surovém HTML | Zobrazit zdroj nebo curl na URL | Vysoká |
| Klíčové stránky zaindexované Googlem a Bingem | Search Console a Bing Webmaster Tools | Vysoká |
| Stav 200, přesměrování jedním skokem | Procházení SEO crawlerem | Střední |
| Sémantické nadpisy, seznamy a tabulky | Přečíst osnovu HTML | Střední |
| Schema Organization a Article | Validátor schema | Střední |
| Viditelná data a přesný lastmod | Porovnat stránku, schema a mapu webu | Střední |
| llms.txt v kořeni | Otevřít /llms.txt | Nízká |
Spusťte ji jednou na 20 nejdůležitějších stránkách a potom po každém redesignu, změně CMS nebo bezpečnostní aktualizaci. Logy crawlerů AI jsou jediný přímý důkaz, že boti na vaše stránky docházejí; vše ostatní je odhad.
Technické opravy otevírají dveře; výsledek se ukáže v odpovědích AI. Smyčku uzavírají dvě měření. Za prvé serverové logy: návštěvy od OAI-SearchBot, Claude-SearchBot a PerplexityBot by měly na opravených stránkách růst. Za druhé citace: sledujte pevně danou sadu otázek, které kladou vaši zákazníci, a kontrolujte každý týden, zda je vaše značka zmíněna a jaké zdroje jsou místo ní citovány. Vzorce z velkých vzorků pomáhají nastavit očekávání, jako v naší studii citací ChatGPT.
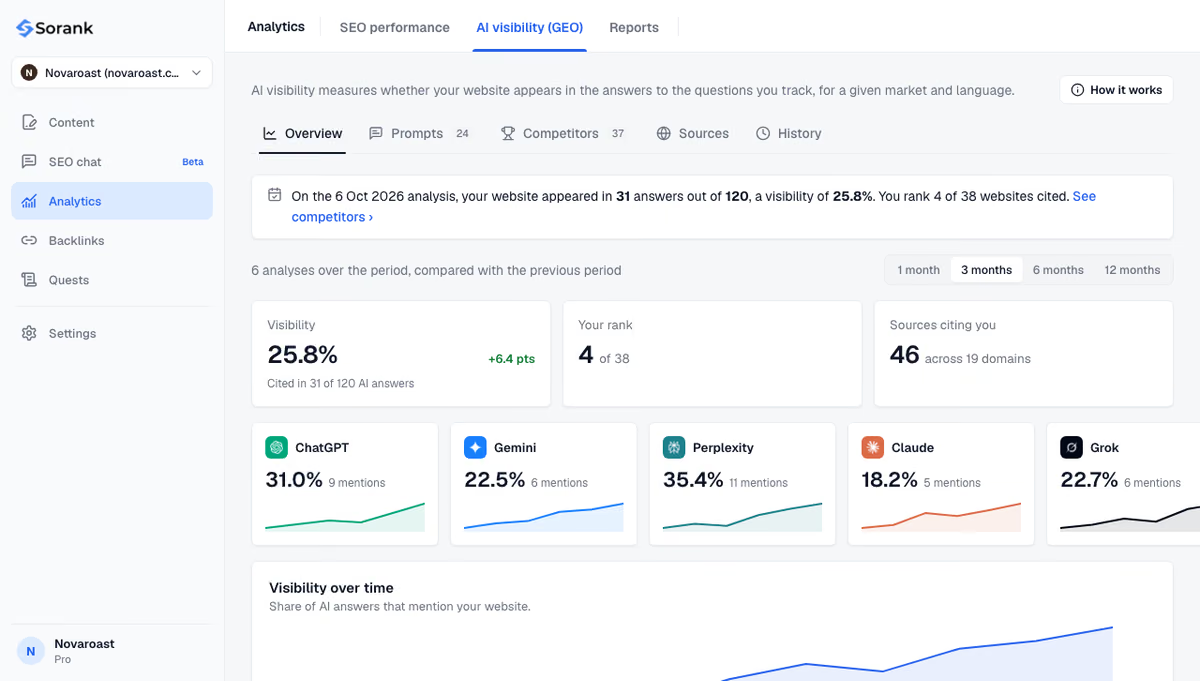
Sorank, náš software, zvládá tu druhou část pomocí sledování zmínek v AI: podle tarifu 10 až 50 sledovaných promptů na ChatGPT, Claude a Gemini, plus Grok u tarifu Pro, s vaší mírou viditelnosti a konkurenty citovanými místo vás.
Jakmile je technický základ čistý, dalším limitem je obsah: stránky, které jasně odpovídají na otázky, s uvedenými zdroji. generátor článků píše a publikuje optimalizované články pro Google i AI na autopilotovi, s interními odkazy a zdroji.
Technické GEO rozhoduje, zda asistenti AI mohou váš web číst; obsah a autorita rozhodují, zda ho citují. Nejprve opravte přístup, vykreslování a strukturu, pak měřte citace. Tarify a 3denní bezplatná zkušební verze jsou na stránce s cenami.

Zablokování GPTBot jen říká OpenAI, aby váš obsah nepoužívala k trénování jejich modelů. Nevyřadí váš web z odpovědí vyhledávání ChatGPT, které závisí na OAI-SearchBot. Chcete-li být citováni v ChatGPT, nechte OAI-SearchBot povolený bez ohledu na to, jak se rozhodnete u GPTBot.
Ne. Google uvádí, že přehledy AI a režim AI nemají žádné technické požadavky nad rámec zaindexování a způsobilosti k úryvku ve vyhledávání. llms.txt může pomoci jiným agentům AI najít vaše klíčové stránky, ale na pořadí na Googlu ani na přehledy AI nemá vliv.
AEO (optimalizace pro answer engines) a GEO popisují stejný cíl: být citován v odpovědích generovaných asistenty AI. Technické GEO, někdy nazývané technické AEO, pokrývá infrastrukturní část této práce: přístup botů, vykreslování, rychlost, strukturovaná data a aktuálnost. Části o obsahu a autoritě přicházejí navíc.
Analyzujeme vaši konkurenci, váš web a vaši viditelnost v AI, abychom pro vás zdarma připravili obsahový plán na míru.
 Generátor zadání článku s AI
 Generátor schématu FAQ
 Generátor nápadů na blogové články s AI
 Validátor strukturovaných dat (validátor schématu)
 Kontrola alternativních textů
 Analyzátor interních odkazů
 Výzva zpětných odkazů
 Generátor meta popisů s AI
 Generátor titulků blogu s AI
 Kontrola indexovatelnosti pro Google
 Generátor osnovy článku s AI
 Tvůrce UTM odkazů
 Nástroj pro clustering klíčových slov
 Kontrola kanonické značky
 Generátor XML sitemap
 Kontrola nefunkčních odkazů
 Generátor SEO titulků s AI
 Analyzátor nadpisů
 Nástroj pro náhled SERP
 Kontrola přesměrování
 Generátor značek hreflang
 Analyzátor struktury nadpisů
 Kontrola HTTP hlaviček
 Extraktor favicon
 Kalkulačka CTR v SERP
 Kalkulačka úspor SEO oproti placenému vyhledávání
 Kalkulačka podílu hlasu v SEO
 Kalkulačka ROI SEO
 Kalkulačka předpovědi návštěvnosti a tržeb SEO
 Kalkulačka rozpočtu SEO
 Kalkulačka bodu zvratu SEO
 Kalkulačka ROI SEO pro SaaS
 Kalkulačka ROAS
 Kalkulačka doby čtení
 Simulátor zisku pozic
 Kalkulátor hodnoty organické návštěvnosti
 Odhad organické návštěvnosti a kontrola návštěvnosti webu
 Kalkulátor poměru LTV a CAC
 Kalkulátor ROI lokálního SEO
 Kalkulátor nákladů na budování zpětných odkazů
 Kalkulátor hodnoty klíčových slov
 Kalkulačka skóre příležitosti klíčových slov
 Kalkulačka hustoty klíčových slov
 Kalkulačka ROI GEO
 Kalkulačka investice do obsahu GEO
 Kalkulačka návratnosti SEO pro e-shop
 Kalkulačka celoživotní hodnoty zákazníka
 Kalkulačka nákladů na získání zákazníka
 Kalkulátor CTR
 Kalkulátor ceny za článek
 Kalkulátor míry konverze
 Kalkulátor ROI obsahového marketingu
 Odhad návštěvnosti z ChatGPT
 Kalkulátor míry odchodů
 Kalkulátor ROI zpětných odkazů
 Kalkulátor skóre viditelnosti v AI
 Kalkulačka hodnoty návštěvnosti z AI
 Kalkulačka podílu hlasů v AI
 Kalkulačka ceny neviditelnosti v AI
 Kalkulačka míry citování v AI
 Validátor llms.txt
 Kontrola AI Overviews a kontrola pozic v AI Overviews
 Kontrola robots.txt
 Audit AI SEO
 Kontrola čitelnosti pro LLM
 Kontrola připravenosti pro SearchGPT
 Audit strukturovaných dat pro LLM
 Audit procházení webu pro AI
 Proč ChatGPT nedoporučuje můj web
 Nástroj pro kontrolu pozic v Gemini
 Kontrola pořadí v Perplexity
 Kontrola citací v LLM
 Audit optimalizace pro odpovědní enginy
 Audit GEO
 Test viditelnosti ve vyhledávání AI
 Kontrola viditelnosti v ChatGPT
 Generátor llms.txt
 Extraktor URL
 Převod stránky do Markdownu
 Kontrola sitemapy
 Senzor volatility SERP
 Kontrola velikosti stránky
 Počítadlo slov
 Generátor slugů
 Generátor schema
 Generátor robots
 Náhled OG
 Generátor meta značek
 Kompresor obrázků
 Generátor favicon
 Audit on-page SEO: kontrola a analýza SEO
 Nástroj pro analýzu zpětných odkazů
 Nástroj pro výzkum klíčových slov
 Kontrola autority domény
VYZKOUŠELI SORANK PŘED VÁMI
 “Sorank jsem otestoval na skutečném webu klienta a je to neuvěřitelné. Dělá všechno, za co by vám agentura účtovala 1500 $ měsíčně. Právě ho nasazujeme do provozu na tomto klientovi.”

 Guillaume Guersanguersanguillaume.com“Jsme reklamní agentura a chtěli jsme konečně dostat naše SEO na pravou míru. Sorank nám poskytl jasný pohled na náš web, pomohl nám určit priority optimalizací a správně strukturovat náš obsah. Nástroj se snadno používá, je dobře navržený pro tým a velmi praktický, protože centralizuje sledování bez nutnosti žonglovat s více platformami. Velmi pevný základ pro nový start našeho SEO.”
 Gaspard MadouiReklamní agentura
 “Nechal jsem software Sorank dělat svou práci a teď je moje DR 25 a moje stránka se umisťuje výš.”
 Lucas Flandrefoundertrace.fr“Díky Sorank se specializuji na GEO. Žebříček GEO mi umožňuje ukázat klientům jejich postavení oproti konkurenci v ChatGPT. Je to skutečná obchodní výhoda.”
 MélanieSEO freelancer“Skvělá služba, dobře funguje pro náš web a pomáhá nám pochopit, jak ho zlepšit, aby se lépe umisťoval ve výsledcích Google a jinde. Gratulujeme, pokračujte, doporučuji.”
 Hugo T.Majitel e-shopu