Настройки
Конфиденциальность важна для нас, поэтому вы можете отключить отдельные виды хранения данных, которые не нужны для базовой работы сайта. Блокировка некоторых категорий может повлиять на ваше впечатление от сайта. Подробнее

Конфиденциальность важна для нас, поэтому вы можете отключить отдельные виды хранения данных, которые не нужны для базовой работы сайта. Блокировка некоторых категорий может повлиять на ваше впечатление от сайта. Подробнее

Технический GEO в 2026: доступ ИИ-краулеров, серверный рендеринг, llms.txt, структурированные данные, скорость и актуальность, с чек-листом для цитирования ИИ.


Инструменты

Коротко
Технический GEO это набор настроек сайта, которые позволяют ИИ-ассистентам вроде ChatGPT, Claude, Perplexity и Gemini получать, читать и цитировать ваши страницы. Всё сводится к шести проверкам: пустить краулеры ИИ-поиска (robots.txt, файервол, CDN), отдавать основной контент в исходном HTML, потому что большинство ИИ-краулеров не выполняют JavaScript, держать страницы быстрыми и без ошибок, добавить структурированные данные, соответствующие видимому тексту, опубликовать файл llms.txt как недорогое дополнение и показывать актуальность точными датами и картами сайта. Ничто из этого не гарантирует цитирование, но сбой в любом из этих пунктов исключает страницу из списка кандидатов.
Хотите узнать больше? Спросите
Короткий тест
Как добиться, чтобы ChatGPT и другие ИИ упоминали вас?
Sorank подходит под ваши ответы


Попробуйте его 3 дня на своём сайте и узнайте, где вы находитесь в Google, ChatGPT и других ИИ.
Попробовать 3 дня бесплатно3 дня бесплатно, потом вы можете остановиться в любой момент. Гарантия возврата денег 90 дней, на определённых условиях.
Технический GEO это инфраструктурная часть оптимизации для генеративных поисковых систем: всё, что происходит до того, как ИИ-модель решит, стоит ли ваш контент цитирования. Кого цитируют, решают контент и авторитетность, но страница, до которой не может добраться ИИ-краулер или которую он видит как пустой каркас JavaScript, в гонке не участвует. Google сам описывает базовые требования к своим ИИ-функциям: страница должна быть проиндексирована и подходить для сниппета, а для AI Overviews и AI Mode никаких дополнительных технических требований нет. Остальные ИИ-ассистенты работают со своими краулерами и со своими ограничениями, и именно здесь многие сайты теряют видимость, даже не замечая этого. В этом руководстве разобран каждый уровень, от доступа ботов до актуальности, с чек-листом, который можно пройти за один день.
Техническое SEO делает сайт доступным для сканирования и индексации Googlebot. Технический GEO распространяет ту же работу на десяток других ботов, которые ведут себя по-другому: они рендерят меньше, сканируют реже и соблюдают меньше правил. Пересечение большое (коды статуса, канонические адреса, карты сайта, скорость), поэтому у сайта с хорошим техническим SEO уже есть большая часть фундамента. Различия в четырёх местах.
| Тема | Техническое SEO (Googlebot) | Технический GEO (ИИ-краулеры) |
|---|---|---|
| Какими ботами управлять | Googlebot, Bingbot | OAI-SearchBot, GPTBot, ChatGPT-User, Claude-SearchBot, ClaudeBot, Claude-User, PerplexityBot, Google-Extended и другие |
| JavaScript | Рендерится с задержкой | Не выполняется большинством ИИ-краулеров |
| Единица ценности | Страница и её позиция | Фрагмент, который цитируется в ответе |
| Логика исключения | Блокировка или noindex для страницы | Отдельные решения для обучения, поиска и визитов по инициативе пользователя |
| Измерение | Search Console | Логи сервера и отслеживание промптов |
Практический вывод: сайт может хорошо ранжироваться в Google и при этом оставаться невидимым для ChatGPT или Claude, потому что контент построен на JavaScript или потому что правило файервола блокирует неизвестных ботов.
Каждая ИИ-компания сегодня использует несколько ботов, и у каждого своя задача. Блокировка не того бота может убрать вас из ответов ИИ, хотя вы хотели лишь запретить обучение моделей.
Согласно документации OpenAI о краулерах (проверено в октябре 2026), OAI-SearchBot решает, появляются ли ваши страницы в ответах поиска ChatGPT, GPTBot собирает контент, который может использоваться для обучения моделей, а ChatGPT-User загружает страницу, когда её запрашивает пользователь. Блокировка GPTBot держит ваш контент вне обучения, но не убирает вас из поиска ChatGPT. Изменения в robots.txt применяются к результатам поиска примерно за 24 часа, а правила robots.txt могут не распространяться на ChatGPT-User, потому что визит инициирует человек.
Anthropic использует то же разделение на три вида, как объясняет его центр поддержки: ClaudeBot для обучения, Claude-SearchBot для индексации поиска и Claude-User для страниц, загружаемых во время разговора. Блокировка Claude-SearchBot или Claude-User снижает вашу видимость в ответах Claude. Anthropic также предупреждает, что блокировка его IP-адресов не является надёжным отказом, потому что бот может вовсе не прочитать ваш robots.txt.
AI Overviews и AI Mode в Google используют обычный индекс Googlebot. Токен Google-Extended управляет только использованием вашего контента для обучения Gemini и для grounding в некоторых других системах Google, и Google указывает, что это не влияет на включение в поиск Google или на ранжирование. Perplexity использует PerplexityBot для своего индекса. Готовую конфигурацию для каждого бота смотрите в нашем руководстве по правилам robots.txt для ИИ-краулеров и в списке ИИ-краулеров и их user agent.
| Цель | Разрешить | Блокировка по желанию |
|---|---|---|
| Цитирование в ChatGPT | OAI-SearchBot, ChatGPT-User | GPTBot (только обучение) |
| Цитирование в Claude | Claude-SearchBot, Claude-User | ClaudeBot (только обучение) |
| Цитирование в Perplexity | PerplexityBot | Нет |
| Появление в AI Overviews и AI Mode | Googlebot | Google-Extended (не влияет на поиск) |
Внимание
robots.txt это лишь половина проверки. С июля 2025 года Cloudflare по умолчанию блокирует ИИ-краулеров во многих конфигурациях, и то же делают другие файерволы и инструменты защиты от ботов. Проверьте CDN и настройки безопасности, а затем в логах сервера убедитесь, что поисковые боты ИИ получают код 200.
В большинстве случаев нет, и это самая частая ошибка технического GEO. Анализ Vercel их сети (декабрь 2024) показал, что ни один крупный ИИ-краулер не рендерил JavaScript: боты OpenAI, Anthropic, Meta, ByteDance и Perplexity скачивают сырой HTML и на этом останавливаются. ChatGPT и Claude загружали файлы JavaScript, но не выполняли их. Gemini здесь исключение, потому что опирается на инфраструктуру рендеринга Googlebot. Тот же исследование измерило масштаб этого трафика: за месяц GPTBot сделал 569 миллионов запросов, Claude 370 миллионов, против 4,5 миллиарда у Googlebot.
Если описания товаров, цены, статьи или FAQ добавляются приложением React, Vue или Angular уже после загрузки страницы, ИИ-краулеры видят пустой шаблон. Решение в том, чтобы отдавать основной контент в исходном HTML-ответе:
Быстрая проверка: откройте исходный код страницы (не инспектор) или загрузите URL через curl. Если основного абзаца нет в сыром HTML, ИИ-краулеры не могут его процитировать. Наше руководство по SEO для JavaScript разбирает варианты рендеринга для каждого фреймворка, а бесплатный аудит доступности для ИИ проверяет, что получает бот.
ИИ-ассистенты, которые просматривают веб в реальном времени, загружают несколько страниц на один вопрос и работают в жёстких временных рамках. Медленная или сломанная страница пропускается, и вместо неё цитируется другой источник. Исследование Vercel также показало, что краулеры ChatGPT и Claude попадают на страницы 404 примерно в 34 % своих запросов, против 8 % у Googlebot, часто потому что запрашивают устаревшие адреса. Важнее всего три момента:
Таблицам стоит уделить отдельное внимание: данные для сравнения в HTML-таблице легко извлечь, а те же данные в изображении или на графике canvas теряются для каждого ИИ-краулера.
Структурированные данные показывают машинам, о чём страница (статья, товар, организация, человек), и связывают её с известными сущностями. Google ясно говорит: для его ИИ-функций специальная схема не нужна, а разметка должна соответствовать видимому тексту. Их ценность для технического GEO в ясности, а не в повышении позиций. Типы, которые стоит внедрить на большинстве сайтов:
Держите JSON-LD в исходном HTML, а не добавляйте его менеджером тегов, по той же причине, что и выше. Аудит структурированных данных для LLM сверяет вашу разметку с тем, что может прочитать модель, а наша статья о структурированных данных для ИИ-поиска объясняет, какие типы всё ещё важны.
Совет
Пишите одни и те же ключевые факты (название компании, год основания, цены, адреса) одинаково в видимом тексте, в разметке и в официальных профилях. Согласованные факты из разных источников помогают модели описывать ваш бренд, не путая его с другим.
Предложение llms.txt, опубликованное Джереми Ховардом в сентябре 2024, это файл Markdown в корне сайта, который перечисляет его самые полезные страницы с краткими описаниями, чтобы ИИ-агент находил нужный контент, не разбирая навигационные меню. Это предложение, а не официальный стандарт: он не управляет ни доступом, ни индексацией, и Google не включает его в требования к своим ИИ-функциям. Считайте его недорогим дополнением: на него уходит меньше часа, он помогает агентам и ассистентам для программистов, которые его ищут, и заставляет решить, какие страницы представляют ваш сайт. Черновик можно составить с генератором llms.txt, а если ваша система позволяет, предложите чистые Markdown-версии ключевых страниц.
ИИ-ассистенты, которые ищут в вебе, предпочитают свежие и датированные источники для любого вопроса, где важно время (цены, инструменты, правила, статистика). Актуальность контента отчасти вопрос редакционной работы, но сигналы технические:
| Проверка | Как проверить | Приоритет |
|---|---|---|
| Поисковые боты ИИ разрешены в robots.txt | Прочитать robots.txt для OAI-SearchBot, Claude-SearchBot, PerplexityBot | Высокий |
| Нет блокировки файерволом или CDN | Логи сервера показывают ответы 200 для ИИ-ботов | Высокий |
| Основной контент в сыром HTML | Посмотреть исходный код или загрузить URL через curl | Высокий |
| Ключевые страницы проиндексированы в Google и Bing | Search Console и Bing Webmaster Tools | Высокий |
| Статус 200, перенаправления в один переход | Просканировать SEO-краулером | Средний |
| Семантические заголовки, списки и таблицы | Прочитать структуру HTML | Средний |
| Схема Organization и Article | Валидатор схем | Средний |
| Видимые даты и точный lastmod | Сравнить страницу, схему и карту сайта | Средний |
| llms.txt в корне | Открыть /llms.txt | Низкий |
Проведите её один раз на 20 самых важных страницах, а затем после каждого редизайна, смены CMS или обновления безопасности. Логи ИИ-краулеров это единственное прямое доказательство того, что боты доходят до ваших страниц; всё остальное это предположения.
Технические исправления открывают дверь, а результат появляется в ответах ИИ. Два измерения замыкают цикл. Во-первых, логи сервера: визиты OAI-SearchBot, Claude-SearchBot и PerplexityBot должны расти на исправленных страницах. Во-вторых, цитирование: отслеживайте постоянный набор вопросов, которые задают ваши клиенты, и проверяйте из недели в неделю, называют ли ваш бренд и какие источники цитируют вместо него. Закономерности из больших выборок помогают задать ожидания, как в нашем исследовании цитирования ChatGPT.
Sorank, наш софт, закрывает эту вторую часть с помощью отслеживания упоминаний в ИИ: от 10 - 50 отслеживаемых промптов в зависимости от тарифа, в ChatGPT, Claude и Gemini, а также Grok на тарифе Pro, с вашей долей видимости и конкурентами, которые цитируются вместо вас.
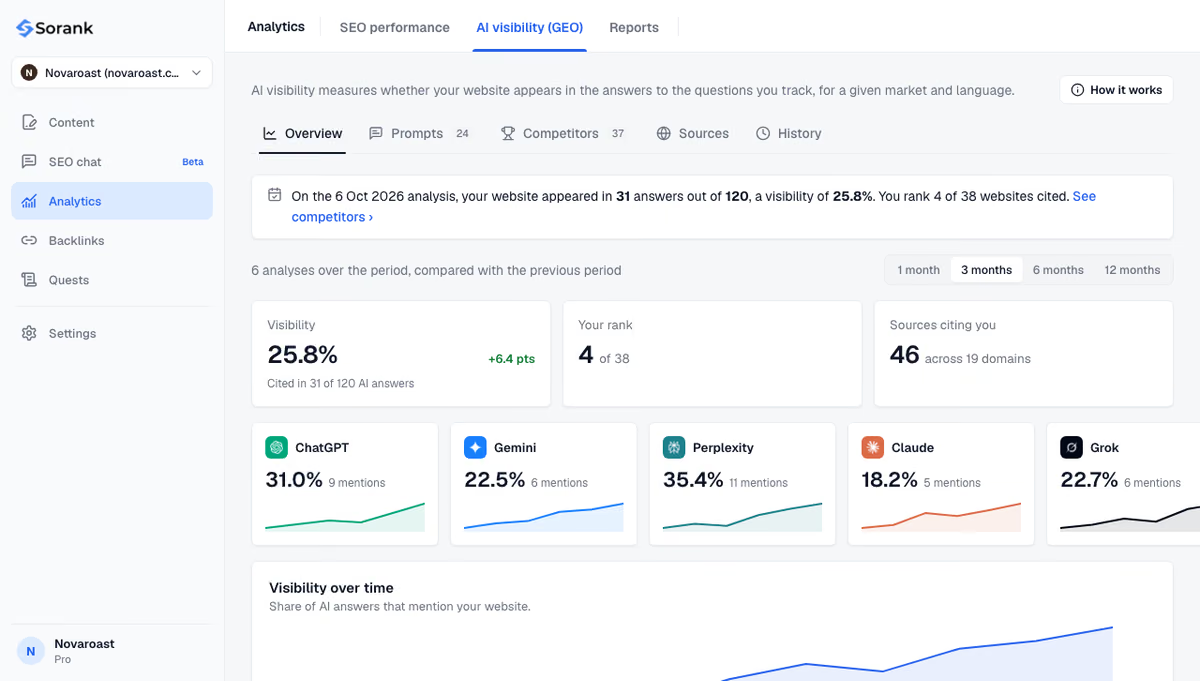
Когда техническая база чистая, следующий предел это контент: страницы, которые ясно отвечают на вопросы и опираются на источники. Генератор статей пишет и публикует оптимизированные для Google и ИИ статьи в режиме autopilot, со внутренними ссылками и источниками.
Технический GEO определяет, могут ли ИИ-ассистенты читать ваш сайт; контент и авторитетность определяют, цитируют ли они его. Сначала исправьте доступ, рендеринг и структуру, а затем измеряйте цитирование. Тарифы и 3-дневная бесплатная пробная версия указаны на странице цен.

Блокировка GPTBot лишь сообщает OpenAI, что не нужно использовать ваш контент для обучения модели. Ваш сайт не исчезает из ответов поиска ChatGPT, который зависит от OAI-SearchBot. Если вы хотите цитироваться в ChatGPT, оставьте OAI-SearchBot разрешённым, какое бы решение вы ни приняли по GPTBot.
Нет. Google указывает, что для AI Overviews и AI Mode нет технических требований, кроме индексации страницы и её пригодности для сниппета в поиске. llms.txt может помочь другим ИИ-агентам найти ваши ключевые страницы, но на ранжирование в Google и на AI Overviews он не влияет.
AEO (оптимизация для поисковых ответов) и GEO описывают одну и ту же цель: быть процитированным в ответах, которые генерируют ИИ-ассистенты. Технический GEO, который иногда называют техническим AEO, покрывает инфраструктурную часть этой работы: доступ ботов, рендеринг, скорость, структурированные данные и актуальность. Контент и авторитетность строятся поверх этого.
Мы бесплатно анализируем ваших конкурентов, ваш сайт и вашу видимость в ИИ и составляем персональный контент-план.
 ИИ-генератор брифа для контента
 Генератор схемы FAQ
 ИИ-генератор идей для постов в блоге
 Валидатор структурированных данных (валидатор Schema)
 Проверка альтернативного текста
 Анализатор внутренних ссылок
 Челлендж по обратным ссылкам
 ИИ-генератор метаописаний
 ИИ-генератор заголовков для блога
 Проверка индексируемости в Google
 ИИ-генератор плана статьи для блога
 Конструктор UTM-ссылок
 Инструмент кластеризации ключевых слов
 Проверка тега canonical
 Генератор XML-карты сайта
 Проверка битых ссылок
 ИИ-генератор SEO-заголовков
 Анализатор заголовков
 Предпросмотр поисковой выдачи
 Проверка редиректов
 Генератор тегов hreflang
 Анализатор структуры заголовков
 Проверка HTTP-заголовков
 Экстрактор фавиконок
 Калькулятор CTR в выдаче
 Калькулятор экономии SEO в сравнении с платным поиском
 Калькулятор доли голоса в SEO
 Калькулятор ROI от SEO
 Калькулятор прогноза трафика и выручки от SEO
 Калькулятор бюджета на SEO
 Калькулятор точки безубыточности SEO
 Калькулятор ROI от SEO для SaaS
 Калькулятор ROAS
 Калькулятор времени чтения
 Симулятор прироста позиций
 Калькулятор стоимости органического трафика
 Оценка органического трафика и проверка посещаемости сайта
 Калькулятор соотношения LTV к CAC
 Калькулятор ROI от локального SEO
 Калькулятор стоимости линкбилдинга
 Калькулятор ценности ключевого слова
 Калькулятор оценки возможностей ключевого слова
 Калькулятор плотности ключевых слов
 Калькулятор ROI от GEO
 Калькулятор инвестиций в GEO-контент
 Калькулятор ROI от SEO для интернет-магазина
 Калькулятор пожизненной ценности клиента
 Калькулятор стоимости привлечения клиента
 Калькулятор CTR
 Калькулятор стоимости статьи
 Калькулятор коэффициента конверсии
 Калькулятор ROI контент-маркетинга
 Оценка реферального трафика из ChatGPT
 Калькулятор показателя отказов
 Калькулятор ROI обратных ссылок
 Калькулятор AI Visibility Score
 Калькулятор стоимости AI-трафика
 Калькулятор доли голоса в ИИ
 Калькулятор стоимости невидимости в ИИ
 Калькулятор частоты цитирования в ИИ
 Валидатор llms.txt
 Проверка AI Overview и позиций в AI Overviews
 Проверка robots.txt
 ИИ SEO-аудит
 Проверка читаемости для LLM
 Проверка готовности к SearchGPT
 Аудит структурированных данных для LLM
 Аудит доступности сайта для ИИ-роботов
 Почему ChatGPT не рекомендует мой сайт
 Инструмент позиций в Gemini
 Проверка позиций в Perplexity
 Проверка цитирования в LLM
 Аудит Answer Engine Optimization
 GEO-аудит
 Тест видимости в ИИ-поиске
 Проверка видимости в ChatGPT
 Генератор llms.txt
 Извлечение URL
 Веб-страница в Markdown
 Проверка карты сайта
 Датчик волатильности выдачи
 Проверка размера страницы
 Счётчик слов
 Генератор slug
 Генератор Schema
 Генератор robots
 Предпросмотр OG
 Генератор метатегов
 Компрессор изображений
 Генератор фавиконок
 Аудит внутренней SEO-оптимизации: SEO-проверка и SEO-анализ
 Инструмент анализа обратных ссылок
 Инструмент подбора ключевых слов
 Проверка авторитета домена
ОНИ ПОПРОБОВАЛИ SORANK ДО ВАС
 “Я протестировал Sorank на реальном клиентском сайте, и это потрясающе. Он делает всё то, за что агентство выставило бы вам счёт на $1500 в месяц. Теперь он запускается в работу на этом клиенте.”

 Guillaume Guersanguersanguillaume.com“Мы рекламное агентство и хотели раз и навсегда вернуть своё SEO в нужное русло. Sorank дал нам чёткое представление о нашем сайте, помог расставить приоритеты в оптимизации и правильно структурировать наш контент. Инструмент прост в использовании, хорошо продуман для работы в команде и очень удобен для централизованного отслеживания без необходимости жонглировать несколькими платформами. Очень прочная основа, чтобы начать наше SEO с чистого листа.”
 Gaspard MadouiРекламное агентство
 “Я просто позволил программе Sorank делать своё дело, и теперь мой показатель DR равен 25, а моя страница ранжируется выше.”
 Lucas Flandrefoundertrace.fr“Я специализировался на GEO благодаря Sorank. Рейтинг GEO позволяет мне показывать клиентам их позицию относительно конкурентов в ChatGPT. Это реальное коммерческое преимущество.”
 MélanieФрилансер по SEO“Отличный сервис, хорошо подходит для нашего сайта и помогает понять, как его улучшить, чтобы лучше ранжироваться в Google и не только. Поздравляю, так держать, рекомендую.”
 Hugo T.Владелец интернет-магазина