Præferencer
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Teknisk GEO i 2026: adgang for AI-crawlere, serverrendering, llms.txt, strukturerede data, hastighed og friskhed, med en tjekliste til at blive citeret af AI.


Værktøjer

Kort fortalt
Teknisk GEO er det sæt af websteds-indstillinger, der gør det muligt for AI-assistenter som ChatGPT, Claude, Perplexity og Gemini at hente, læse og citere dine sider. Det handler om seks kontroller: lad AI-søgecrawlerne komme ind (robots.txt, firewall, CDN), lever dit hovedindhold i den indledende HTML, fordi de fleste AI-crawlere ikke kører JavaScript, hold siderne hurtige og fri for fejl, tilføj strukturerede data, der matcher den synlige tekst, udgiv en llms.txt-fil som et billigt ekstra, og signalér friskhed med korrekte datoer og sitemaps. Intet af dette garanterer en citering, men en fejl på et af punkterne fjerner din side fra kandidaterne.
Vil du vide mere? Spørg
Hurtig quiz
Hvordan får du nævnt af ChatGPT og andre AI-assistenter?
Sorank matcher dine svar


Test det i 3 dage på dit eget site, og se, hvor du står på Google, ChatGPT og de andre AI'er.
Start prøveperiode på 3 dage3 dage gratis, derefter stopper du, når du vil. 90 dages garanti: resultater eller pengene tilbage.
Teknisk GEO er infrastruktursiden af generativ motoroptimering: alt det, der sker, før en AI-model vurderer, om dit indhold er værd at citere. Indhold og autoritet afgør, hvem der bliver citeret, men en side, som en AI-crawler ikke kan nå, eller som den kun når som en tom JavaScript-skal, kommer aldrig med i kapløbet. Google selv opsummerer grundlaget for sine AI-funktioner: en side skal være indekseret og kvalificeret til et uddrag, og der findes ingen yderligere tekniske krav til AI Overviews eller AI Mode. De andre AI-assistenter kører deres egne crawlere med egne begrænsninger, og det er der, de fleste websteder mister synlighed uden at vide det. Denne guide dækker hvert lag, fra botadgang til friskhed, med en tjekliste, du kan køre på en eftermiddag.
Teknisk SEO gør et websted crawlbart og indekserbart for Googlebot. Teknisk GEO udvider det samme arbejde til et dusin andre bots, der opfører sig forskelligt: de renderer mindre, crawler sjældnere og følger færre regler. Overlappet er stort (statuskoder, canonicals, sitemaps, hastighed), så et websted med en ren teknisk SEO har allerede det meste af fundamentet. Forskellene ligger på fire punkter.
| Emne | Teknisk SEO (Googlebot) | Teknisk GEO (AI-crawlere) |
|---|---|---|
| Bots at styre | Googlebot, Bingbot | OAI-SearchBot, GPTBot, ChatGPT-User, Claude-SearchBot, ClaudeBot, Claude-User, PerplexityBot, Google-Extended og andre |
| JavaScript | Renderet, med forsinkelse | Ikke kørt af de fleste AI-crawlere |
| Enhed for værdi | Siden og dens rangering | Passagen, der bliver citeret i et svar |
| Logik for fravalg | Blokér eller noindex en side | Separate valg for træning, søgning og besøg udløst af brugeren |
| Måling | Search Console | Serverlogs og sporing af forespørgsler |
Den praktiske konsekvens: et websted kan rangere godt på Google og stadig være usynligt for ChatGPT eller Claude, fordi indholdet er bygget i JavaScript, eller fordi en firewall-regel blokerer ukendte bots.
Hvert AI-selskab kører nu flere bots, og hver har sit eget job. Blokerer du den forkerte, kan du forsvinde fra AI-svarene, selvom du kun ville frasige dig træning af modeller.
Ifølge OpenAIs dokumentation for crawlere (tjekket oktober 2026) afgør OAI-SearchBot, om dine sider vises i svar fra ChatGPT-søgning, GPTBot indsamler indhold, der må bruges til at træne modellerne, og ChatGPT-User henter en side, når en bruger beder om det. Hvis du afviser GPTBot, holdes dit indhold ude af træningen, uden at du forsvinder fra ChatGPT-søgningen. Ændringer i robots.txt træder i kraft i søgeresultaterne efter cirka 24 timer, og robots.txt-reglerne gælder muligvis ikke for ChatGPT-User, fordi besøget udløses af et menneske.
Anthropic følger den samme tredelte opdeling, som hjælpecenteret forklarer: ClaudeBot til træning, Claude-SearchBot til indeksering i søgning og Claude-User til sider, der hentes under en samtale. Blokerer du Claude-SearchBot eller Claude-User, mindskes din synlighed i Claudes svar. Anthropic advarer også om, at blokering af deres IP-adresser ikke er et pålideligt fravalg, da botten så måske slet ikke kan læse din robots.txt.
Googles AI Overviews og AI Mode bruger det almindelige Googlebot-indeks. Tokenet Google-Extended styrer kun, om dit indhold må bruges til træning og forankring af Gemini i nogle andre Google-systemer, og Google oplyser, at det ikke påvirker optagelse eller rangering i Google-søgning. Perplexity bruger PerplexityBot til sit indeks. Til en færdig opsætning for hver bot, se vores guide til robots.txt-regler for AI-crawlere og listen over AI-crawlere og deres user agents.
| Mål | Tillad | Valgfrit at blokere |
|---|---|---|
| Blive citeret i ChatGPT | OAI-SearchBot, ChatGPT-User | GPTBot (kun træning) |
| Blive citeret i Claude | Claude-SearchBot, Claude-User | ClaudeBot (kun træning) |
| Blive citeret i Perplexity | PerplexityBot | Ingen |
| Optræde i AI Overviews og AI Mode | Googlebot | Google-Extended (ingen effekt på søgning) |
Pas på
Robots.txt er kun halvdelen af kontrollen. Siden juli 2025 blokerer Cloudflare AI-crawlere som standard i mange opsætninger, og andre firewalls og værktøjer til botbeskyttelse gør det samme. Kig på dit CDN og dine sikkerhedsindstillinger, og bekræft derefter i dine serverlogs, at AI-søgebotterne får en 200-statuskode.
For det meste nej, og det er den hyppigste fejl i teknisk GEO. En analyse fra Vercel af sit netværk (december 2024) fandt, at ingen af de store AI-crawlere renderede JavaScript: botterne fra OpenAI, Anthropic, Meta, ByteDance og Perplexity henter den rå HTML og stopper der. ChatGPT og Claude hentede JavaScript-filer, men kørte dem ikke. Gemini er undtagelsen, fordi den bygger på Googlebots renderingsinfrastruktur. Den samme undersøgelse målte omfanget af denne trafik: på én måned lavede GPTBot 569 millioner anmodninger og Claude 370 millioner, mod 4,5 milliarder for Googlebot.
Hvis dine produktbeskrivelser, priser, artikler eller FAQ indsættes af en React-, Vue- eller Angular-app efter sideindlæsning, ser AI-crawlerne en tom skabelon. Rettelsen er at levere det væsentlige indhold i det indledende HTML-svar:
En hurtig test: åbn sidens kildekode (ikke inspektøren) eller hent URL'en med curl. Mangler dit hovedafsnit i den rå HTML, kan AI-crawlerne ikke citere det. Vores guide til JavaScript-SEO dækker renderingsmulighederne framework for framework, og den gratis revision af AI-crawlbarhed kontrollerer, hvad en bot modtager.
AI-assistenter, der surfer i realtid, henter flere sider pr. spørgsmål og arbejder under stramme tidsgrænser. En langsom eller ødelagt side springes over, og en anden kilde bliver citeret. Vercel-undersøgelsen fandt også, at crawlerne fra ChatGPT og Claude ramte 404-sider i cirka 34% af deres hentninger, mod 8% for Googlebot, ofte fordi de efterspurgte forældede URL'er. Tre punkter vejer tungest:
Tabeller fortjener en særlig omtale: sammenligningsdata i en HTML-tabel er let at udtrække, mens de samme data i et billede eller et canvas-diagram går tabt for alle AI-crawlere.
Strukturerede data hjælper maskiner med at identificere, hvad en side handler om (en artikel, et produkt, en organisation, en person), og forbinde det med kendte entiteter. Google er klar på, at der ikke kræves særlig schema til dets AI-funktioner, og at markup skal matche den synlige tekst. Værdien for teknisk GEO er klarhed, ikke en rangeringsfordel. Typerne, der er værd at implementere på de fleste websteder:
Hold JSON-LD i den indledende HTML i stedet for at lade en tag manager indsætte den, af samme JavaScript-grund som ovenfor. Den revision af strukturerede data for LLM'er kontrollerer din markup mod det, en model kan læse, og vores artikel om strukturerede data til AI-søgning forklarer, hvilke typer der stadig betyder noget.
Tip
Skriv de samme centrale fakta (virksomhedens navn, stiftelsesår, priser, lokationer) ens i din synlige tekst, dit schema og dine officielle profiler. Konsistente fakta på tværs af kilder gør det lettere for en model at beskrive dit brand uden at blande det sammen med et andet.
Forslaget om llms.txt, udgivet af Jeremy Howard i september 2024, er en Markdown-fil i roden af et websted, der lister dets mest nyttige sider med en kort beskrivelse, så en AI-agent finder det rette indhold uden at analysere navigationsmenuer. Det er et forslag og ikke en formel standard, det styrer hverken adgang eller indeksering, og Google nævner det ikke blandt kravene til sine AI-funktioner. Betragt det som et billigt ekstra: det tager under en time, det hjælper agenter og kodeassistenter, der leder efter det, og det tvinger dig til at beslutte, hvilke sider der repræsenterer dit websted. Du kan udkaste en fil med generatoren af llms.txt, og tilbyde rene Markdown-versioner af centrale sider, hvis din opsætning tillader det.
AI-assistenter, der søger på nettet, foretrækker nye og daterede kilder til ethvert spørgsmål, hvor tiden betyder noget (priser, værktøjer, regler, statistikker). Indholdets friskhed er delvist et redaktionelt anliggende, men signalerne er tekniske:
| Kontrol | Sådan verificerer du | Prioritet |
|---|---|---|
| AI-søgebotter tilladt i robots.txt | Læs robots.txt for OAI-SearchBot, Claude-SearchBot, PerplexityBot | Høj |
| Ingen blokering af firewall eller CDN | Serverlogs viser 200-svar til AI-botter | Høj |
| Hovedindhold i den rå HTML | Vis kildekoden eller curl URL'en | Høj |
| Centrale sider indekseret af Google og Bing | Search Console og Bing Webmaster Tools | Høj |
| 200-status, omdirigeringer med ét hop | Crawl med et SEO-crawlerværktøj | Medium |
| Semantiske overskrifter, lister og tabeller | Læs HTML-oversigten | Medium |
| Organization- og Article-schema | Validator for schema | Medium |
| Synlige datoer og korrekt lastmod | Sammenlign side, schema og sitemap | Medium |
| llms.txt i roden | Åbn /llms.txt | Lav |
Kør den én gang på dine 20 vigtigste sider, og derefter efter hver redesign-, CMS-ændring eller sikkerhedsopdatering. Logs fra AI-crawlere er det eneste direkte bevis på, at botterne når dine sider; alt andet er slutninger.
Tekniske rettelser åbner døren; resultatet viser sig i AI-svarene. To målinger lukker kredsløbet. For det første serverlogs: besøg fra OAI-SearchBot, Claude-SearchBot og PerplexityBot bør stige på de sider, du har rettet. For det andet citeringer: følg et fast sæt spørgsmål, dine kunder stiller, og kontroller uge efter uge, om dit brand bliver nævnt, og hvilke kilder der citeres i stedet. Mønstre fra store datasæt hjælper med at sætte forventninger, som i vores undersøgelse af ChatGPT-citeringer.
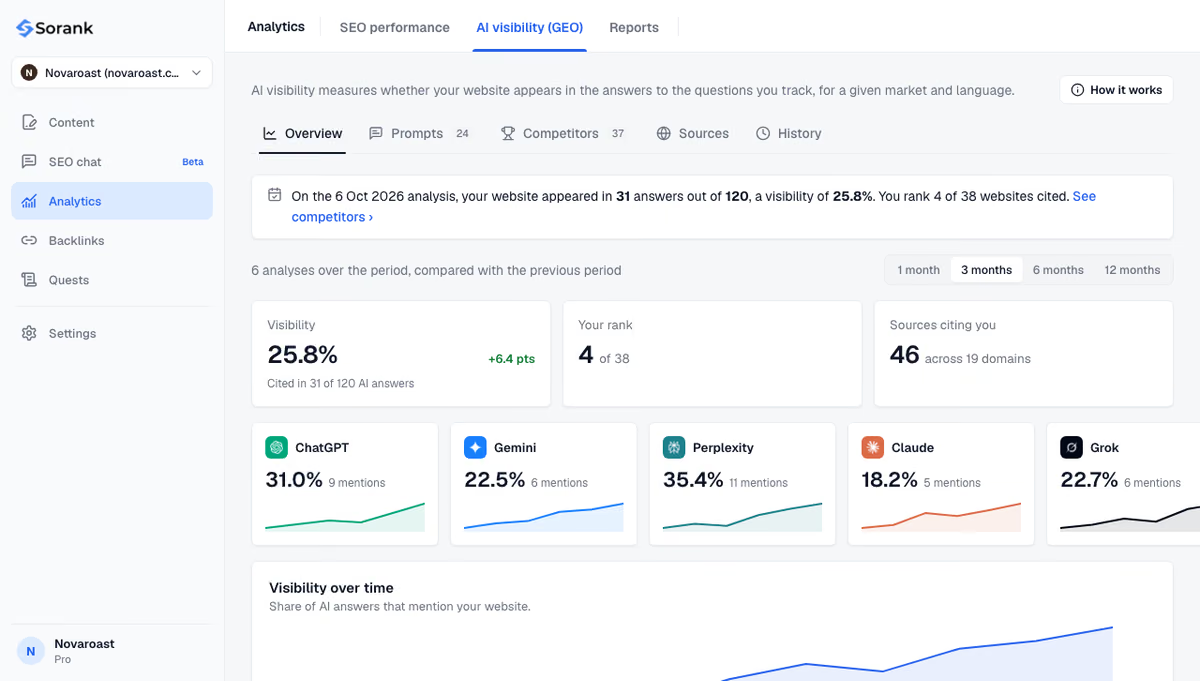
Sorank, vores software, dækker den anden del med sporing af AI-omtaler: 10 til 50 sporede forespørgsler afhængigt af abonnementet, på ChatGPT, Claude og Gemini, plus Grok fra Pro-abonnementet, med din synlighedsrate og de konkurrenter, der citeres i dit sted.
Når det tekniske grundlag er rent, er den næste grænse indholdet: sider, der besvarer spørgsmål klart og med kilder. generatoren af artikler skriver og udgiver optimerede artikler til Google og AI på autopilot, med interne links og kilder.
Teknisk GEO afgør, om AI-assistenter kan læse dit websted; indhold og autoritet afgør, om de citerer det. Ret adgang, rendering og struktur først, og mål derefter citeringerne. Abonnementerne og den gratis prøveperiode på 3 dage findes på prissiden.

Blokering af GPTBot fortæller kun OpenAI, at det ikke må bruge dit indhold til at træne sine modeller. Det fjerner ikke dit websted fra svarene i ChatGPT-søgning, som afhænger af OAI-SearchBot. Vil du citeres i ChatGPT, skal du holde OAI-SearchBot tilladt, uanset hvad du beslutter for GPTBot.
Nej. Google oplyser, at AI Overviews og AI Mode ikke har tekniske krav ud over at være indekseret og kvalificeret til et uddrag i søgningen. llms.txt kan hjælpe andre AI-agenter med at finde dine centrale sider, men det har ingen effekt på Googles rangeringer eller på AI Overviews.
AEO (answer engine optimization) og GEO beskriver det samme mål: at blive citeret i svar genereret af AI-assistenter. Teknisk GEO, som somme tider kaldes teknisk AEO, dækker infrastrukturdelen af det arbejde: botadgang, rendering, hastighed, strukturerede data og friskhed. Indholds- og autoritetsdelene kommer oven i det.
Vi analyserer dine konkurrenter, dit website og din synlighed i AI for at lave en skræddersyet indholdsplan gratis.
 AI-generator til indholdsbrief
 FAQ-schemagenerator
 AI-generator til blogidéer
 Validator for struktureret data (schema-validator)
 Tjek af alt-tekst
 Analyse af interne links
 Backlink-udfordringen
 AI-generator til metabeskrivelser
 AI-generator til blogtitler
 Tjek af indekserbarhed
 AI-generator til blogdispositioner
 UTM-linkgenerator
 Værktøj til søgeordsclustering
 Tjek af canonical-tag
 XML-sitemap-generator
 Tjek af ødelagte links
 AI-generator til SEO-titler
 Overskriftsanalysator
 SERP-forhåndsvisning
 Redirect-tjekker
 Hreflang-generator
 Overskriftsanalysator
 HTTP-headertjekker
 Favicon-udtrækker
 SERP CTR-beregner
 Beregner for besparelse ved SEO vs. betalt søgning
 Beregner af SEO-synlighedsandel
 Beregner af SEO-afkast
 Beregner af SEO-trafik- og omsætningsprognose
 Beregner af SEO-budget
 Beregner af SEO-break-even
 Beregner af SaaS-SEO-afkast
 Beregner af ROAS
 Beregner af læsetid
 Simulator for placeringsgevinst
 Beregner for værdi af organisk trafik
 Estimator for organisk trafik og tjek af webstedstrafik
 Beregner for LTV/CAC-forhold
 Beregner for lokal SEO-afkast
 Beregner for linkbuilding-omkostninger
 Beregner for søgeordsværdi
 Beregner for søgeordsmulighed
 Beregner for nøgleordstæthed
 Beregner for GEO-ROI
 Beregner for investering i GEO-indhold
 Ecommerce SEO-ROI-beregner
 Beregner for kundens levetidsværdi
 CAC-beregner
 Beregner for CTR
 Beregner for omkostning pr. artikel
 Beregner for konverteringsrate
 Beregner for ROI på content marketing
 Estimator for henvisningstrafik fra ChatGPT
 Beregner for bounce rate
 Beregner for backlinks ROI
 Beregner for AI-synlighedsscore
 AI-trafikværdi-beregner
 AI-share of voice-beregner
 Beregner for omkostningen ved AI-usynlighed
 AI-citationsrate-beregner
 llms.txt-validator
 AI Overview-tjekker og rangeringstjekker for AI Overviews
 Robots.txt-tjekker
 AI-SEO-audit
 LLM-læsbarhedstjek
 SearchGPT-klartjek
 LLM-audit af strukturerede data
 AI-crawlbarhedsaudit for websites
 Hvorfor anbefaler ChatGPT ikke mit website?
 Gemini-rangeringsværktøj
 Perplexity-placeringstjek
 LLM-citeringstjek
 AEO-audit
 GEO-audit
 Test af synlighed i AI-søgning
 Tjek af ChatGPT-synlighed
 llms.txt-generator
 URL-udtrækker
 Webside til Markdown
 Sitemap-tjek
 SERP-volatilitetsmåler
 Sidestørrelsestjek
 Ordtæller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Metatag-generator
 Billedkompressor
 Favicon-generator
 On-page SEO-audit: SEO-tjek og SEO-analyse
 Backlinkanalyseværktøj
 Værktøj til søgeordsanalyse
 Domain Authority-tjek
DE PRØVEDE SORANK, FØR DU GJORDE DET
 “Jeg testede Sorank på en rigtig kundes site, og det er vanvittigt. Det gør alt, et bureau ville opkræve dig 1500 dollar om måneden for. Det går nu i produktion på den kunde.”

 Guillaume Guersanguersanguillaume.com“Vi er et annoncebureau, og vi ville have vores SEO på rette spor en gang for alle. Sorank gav os et klart overblik over vores site, hjalp os med at prioritere optimeringer og strukturere vores indhold ordentligt. Værktøjet er nemt at bruge, velegnet til et team og meget praktisk til at samle opfølgningen et sted uden at jonglere med flere platforme. Et meget solidt fundament til at starte forfra med vores SEO.”
 Gaspard MadouiAnnoncebureau
 “Jeg lod bare Sorank-softwaren gøre sit arbejde, og nu er min DR 25, og min side rangerer højere.”
 Lucas Flandrefoundertrace.fr“Jeg specialiserede mig i GEO takket være Sorank. GEO-ranglisten gør det muligt at vise mine kunder deres placering i forhold til konkurrenterne på ChatGPT. Det er en reel kommerciel fordel.”
 MélanieSEO-freelancer“Fantastisk service, den virker godt til vores hjemmeside og hjælper os med at forstå, hvordan vi kan forbedre den for at rangere bedre på Google og andre steder. Tillykke, bliv ved, jeg anbefaler det.”
 Hugo T.Netbutiksejer