Innstillinger
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Teknisk GEO i 2026: tilgang for KI-crawlere, gjengivelse på serveren, llms.txt, strukturerte data, hastighet og aktualitet, med en sjekkliste for å bli sitert av KI.


Verktøy

Kort fortalt
Teknisk GEO er settet med innstillinger på nettstedet som lar KI-assistenter som ChatGPT, Claude, Perplexity og Gemini hente, lese og sitere sidene dine. Det kommer ned til seks kontroller: slipp inn KI-søkecrawlerne (robots.txt, brannmur, CDN), vis hovedinnholdet ditt i den første HTML-en fordi de fleste KI-crawlere ikke kjører JavaScript, hold sidene raske og fri for feil, legg til strukturerte data som stemmer med den synlige teksten, publiser en llms.txt-fil som en billig tilleggsting, og signaliser aktualitet med riktige datoer og sitemaps. Ingenting av dette garanterer en sitering, men ethvert svikt på disse punktene fjerner siden din fra kandidatene.
Vil du vite mer? Spør
Rask quiz
Hvordan får du omtale fra ChatGPT og andre AI-assistenter?
Sorank passer til svarene dine


Prøv det i 3 dager på ditt eget nettsted, og se hvor du står på Google, ChatGPT og de andre AI-assistentene.
Start en gratis prøveperiode på 3 dager3 dager gratis, deretter kan du stoppe når du vil. Resultatgaranti i 90 dager, ellers pengene tilbake.
Teknisk GEO er infrastruktursiden av generativ motoroptimalisering: alt som skjer før en KI-modell vurderer om innholdet ditt er verdt å sitere. Innhold og autoritet avgjør hvem som blir sitert, men en side som en KI-crawler ikke kommer til, eller bare kommer til som et tomt JavaScript-skall, kommer aldri med i konkurransen. Google selv oppsummerer grunnlaget for KI-funksjonene sine: en side må være indeksert og kvalifisert for et utdrag, og det finnes ingen tilleggskrav på det tekniske området for AI Overviews eller AI Mode. De andre KI-assistentene kjører sine egne crawlere, med egne begrensninger, og det er der de fleste nettsteder mister synlighet uten å vite det. Denne guiden dekker hvert lag, fra tilgang for robotene til aktualitet, med en sjekkliste du kan gjennomføre på en ettermiddag.
Teknisk SEO gjør et nettsted crawlbart og indekserbart for Googlebot. Teknisk GEO utvider det samme arbeidet til et dusin andre roboter som oppfører seg annerledes: de gjengir mindre, crawler sjeldnere og følger færre regler. Overlappingen er stor (statuskoder, kanoniske adresser, sitemaps, hastighet), så et nettsted med ren teknisk SEO har allerede det meste av grunnlaget. Forskjellene ligger på fire steder.
| Tema | Teknisk SEO (Googlebot) | Teknisk GEO (KI-crawlere) |
|---|---|---|
| Roboter å styre | Googlebot, Bingbot | OAI-SearchBot, GPTBot, ChatGPT-User, Claude-SearchBot, ClaudeBot, Claude-User, PerplexityBot, Google-Extended og andre |
| JavaScript | Gjengitt, med forsinkelse | Ikke kjørt av de fleste KI-crawlere |
| Enhet for verdi | Siden og rangeringen | Avsnittet som blir sitert i et svar |
| Logikk for å velge bort | Blokkere eller noindex en side | Egne valg for trening, søk og besøk utløst av brukeren |
| Måling | Search Console | Serverlogger og sporing av spørsmål |
Den praktiske konsekvensen: et nettsted kan rangere godt på Google og likevel være usynlig for ChatGPT eller Claude, fordi innholdet er bygget i JavaScript, eller fordi en brannmurregel blokkerer ukjente roboter.
Hvert KI-selskap kjører nå flere roboter, og hver har en egen jobb. Hvis du blokkerer feil en, kan du forsvinne fra KI-svarene mens du bare ville velge bort trening av modeller.
Ifølge OpenAIs dokumentasjon for crawlere (kontrollert oktober 2026) avgjør OAI-SearchBot om sidene dine dukker opp i svarene fra ChatGPT-søk, GPTBot samler innhold som kan brukes til å trene modellene, og ChatGPT-User henter en side når en bruker ber om den. Å avvise GPTBot holder innholdet ditt ute av treningen uten å fjerne deg fra søket i ChatGPT. Endringer i robots.txt tar omtrent 24 timer å slå inn i søkeresultatene, og regler i robots.txt gjelder kanskje ikke ChatGPT-User, fordi besøket utløses av en person.
Anthropic følger den samme tredelingen, slik hjelpesenteret forklarer: ClaudeBot for trening, Claude-SearchBot for indeksering til søk og Claude-User for sider som hentes under en samtale. Blokkerer du Claude-SearchBot eller Claude-User, reduseres synligheten din i svarene fra Claude. Anthropic advarer også om at å blokkere IP-adressene deres ikke er et pålitelig valg for å si nei, fordi roboten da kan mislykkes i å lese robots.txt i det hele tatt.
AI Overviews og AI Mode fra Google bruker den vanlige Googlebot-indeksen. Tokenet Google-Extended styrer bare bruken av innholdet ditt til trening og forankring av Gemini i noen andre systemer hos Google, og Google sier at det ikke påvirker innholdet eller rangeringen i Google Søk. Perplexity bruker PerplexityBot til indeksen sin. For en ferdig konfigurasjon per robot, se veiledningen vår om regler i robots.txt for KI-crawlere og listen over KI-crawlere og deres user agents.
| Mål | Tillat | Valgfritt å blokkere |
|---|---|---|
| Bli sitert i ChatGPT | OAI-SearchBot, ChatGPT-User | GPTBot (kun trening) |
| Bli sitert i Claude | Claude-SearchBot, Claude-User | ClaudeBot (kun trening) |
| Bli sitert i Perplexity | PerplexityBot | Ingen |
| Vises i AI Overviews og AI Mode | Googlebot | Google-Extended (ingen effekt på søk) |
Vær oppmerksom
Robots.txt er bare halvparten av kontrollen. Siden juli 2025 blokkerer Cloudflare KI-crawlere som standard i mange oppsett, og andre brannmurer og verktøy for botbeskyttelse gjør det samme. Se på innstillingene for CDN og sikkerhet, og bekreft deretter i serverloggene at KI-søkerobotene får statuskode 200.
Stort sett nei, og dette er den vanligste feilen i teknisk GEO. En analyse fra Vercel av nettverket sitt (desember 2024) fant at ingen av de store KI-crawlerne gjengav JavaScript: robotene til OpenAI, Anthropic, Meta, ByteDance og Perplexity laster ned den rå HTML-en og stopper der. ChatGPT og Claude hentet JavaScript-filer, men kjørte dem ikke. Gemini er unntaket, fordi det bruker gjengivelsesinfrastrukturen til Googlebot. Den samme studien målte omfanget av denne trafikken: på én måned gjorde GPTBot 569 millioner forespørsler og Claude 370 millioner, mot 4,5 milliarder for Googlebot.
Hvis produktbeskrivelsene, prisene, artiklene eller FAQ-en din settes inn av en React-, Vue- eller Angular-app etter at siden er lastet, ser KI-crawlere en tom mal. Løsningen er å levere det viktigste innholdet i den første HTML-responsen:
En rask test: åpne kildekoden til siden (ikke inspektøren) eller hent URL-en med curl. Mangler hovedavsnittet ditt i den rå HTML-en, kan ikke KI-crawlere sitere det. Veiledningen vår om SEO for JavaScript dekker gjengivelsesalternativene rammeverk for rammeverk, og den gratis revisjonen av crawlbarhet for KI sjekker hva en robot får.
KI-assistenter som surfer i sanntid henter flere sider per spørsmål og jobber under stramme tidsgrenser. En treg eller ødelagt side hoppes over, og en annen kilde siteres i stedet. Vercel-studien fant også at crawlere for ChatGPT og Claude traff 404-sider i omtrent 34% av hentingene sine, mot 8% for Googlebot, ofte fordi de ba om utdaterte URL-er. Tre punkter veier tyngst:
Tabeller fortjener en egen omtale: sammenligningsdata i en HTML-tabell er enkel å hente ut, mens de samme dataene i et bilde eller et canvas-diagram går tapt for alle KI-crawlere.
Strukturerte data hjelper maskiner med å identifisere hva en side handler om (en artikkel, et produkt, en organisasjon, en person) og knytte den til kjente enheter. Google er tydelig på at det ikke trengs spesielt skjema for KI-funksjonene deres, og at merkingen må samsvare med den synlige teksten. Verdien for teknisk GEO er klarhet, ikke et løft i rangeringen. Typene som er verdt å implementere på de fleste nettsteder:
Behold JSON-LD i den første HTML-en, ikke injisert av en tag-manager, av samme JavaScript-grunn som over. revisjonen av strukturerte data for LLM-er sjekker merkingen din mot det en modell kan lese, og artikkelen vår om strukturerte data for KI-søk går nærmere inn på hvilke typer som fortsatt betyr noe.
Tips
Skriv de samme nøkkelopplysningene (firmanavn, grunnleggelsesår, priser, lokasjoner) likt i den synlige teksten, i skjemaet og i de offisielle profilene dine. Konsistente fakta på tvers av kilder gjør det lettere for en modell å beskrive merket ditt uten å blande det sammen med et annet.
Forslaget llms.txt, publisert av Jeremy Howard i september 2024, er en Markdown-fil i roten av et nettsted som lister opp de mest nyttige sidene med en kort beskrivelse, slik at en KI-agent finner riktig innhold uten å analysere navigasjonsmenyene. Det er et forslag og ikke en formell standard, den styrer verken tilgang eller indeksering, og Google nevner den ikke blant kravene til KI-funksjonene sine. Behandle den som et billig tillegg: det tar under en time, den hjelper agenter og kodeassistenter som leter etter den, og den tvinger deg til å bestemme hvilke sider som representerer nettstedet ditt. Du kan lage et utkast med generatoren for llms.txt, og tilby rene Markdown-versjoner av viktige sider hvis oppsettet ditt tillater det.
KI-assistenter som søker på nettet foretrekker nye og datoerte kilder for ethvert spørsmål der tid betyr noe (priser, verktøy, regler, statistikk). Aktualitet i innholdet er delvis en redaksjonell sak, men signalene er tekniske:
| Kontroll | Hvordan du sjekker | Prioritet |
|---|---|---|
| KI-søkerobotene er tillatt i robots.txt | Les robots.txt for OAI-SearchBot, Claude-SearchBot, PerplexityBot | Høy |
| Ingen blokkering i brannmur eller CDN | Serverlogger viser 200-svar til KI-robotene | Høy |
| Hovedinnholdet i rå HTML | Vis kildekode eller curl på URL-en | Høy |
| Viktige sider indeksert av Google og Bing | Search Console og Bing Webmaster Tools | Høy |
| Statuskode 200, omdirigeringer med ett hopp | Crawl med en SEO-crawler | Middels |
| Semantiske overskrifter, lister og tabeller | Les HTML-disposisjonen | Middels |
| Skjema for Organization og Article | Validator for skjema | Middels |
| Synlige datoer og korrekt lastmod | Sammenlign side, skjema og sitemap | Middels |
| llms.txt i roten | Åpne /llms.txt | Lav |
Kjør den én gang på de 20 viktigste sidene dine, og deretter etter hver redesign, endring i CMS eller sikkerhetsoppdatering. Logger fra KI-crawlere er det eneste direkte beviset på at robotene når sidene dine; alt annet er slutninger.
Tekniske rettinger åpner døren; resultatet vises i KI-svarene. To målinger lukker sløyfen. For det første serverlogger: besøk fra OAI-SearchBot, Claude-SearchBot og PerplexityBot bør øke på sidene du har rettet. For det andre sitater: følg et fast sett med spørsmål kundene dine stiller, og sjekk uke for uke om merket ditt nevnes, og hvilke kilder som siteres i stedet. Mønstre fra store utvalg hjelper med å sette forventninger, slik som i vår studie av sitater i ChatGPT.
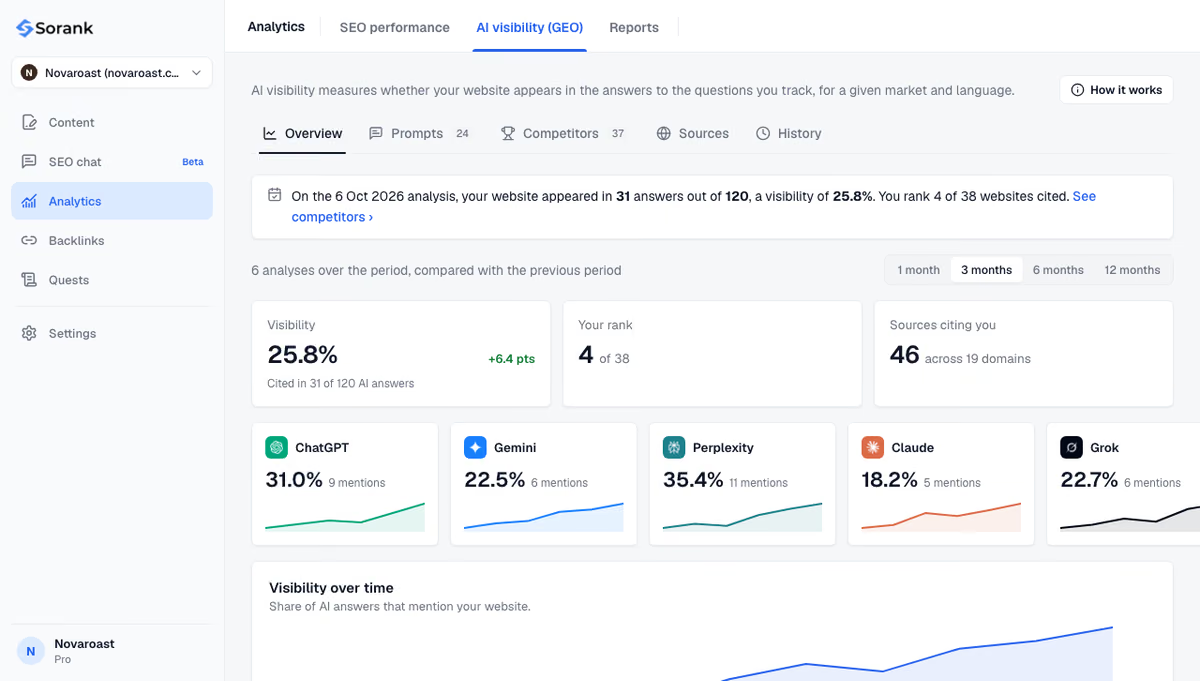
Sorank, vår programvare, tar seg av den andre delen med overvåking av KI-omtaler: 10 til 50 sporede spørsmål avhengig av abonnementet, i ChatGPT, Claude og Gemini, pluss Grok fra Pro-abonnementet, med synlighetsraten din og konkurrentene som siteres i stedet for deg.
Når det tekniske grunnlaget er rent, er neste begrensning innholdet: sider som svarer tydelig på spørsmål, med kilder. generatoren for artikler skriver og publiserer optimaliserte artikler for Google og KI på autopilot, med interne lenker og kilder.
Teknisk GEO avgjør om KI-assistenter kan lese nettstedet ditt; innhold og autoritet avgjør om de siterer det. Fiks tilgang, gjengivelse og struktur først, og mål deretter sitatene. Abonnementene og den gratis prøveperioden på 3 dager finner du på prissiden.

Å blokkere GPTBot forteller bare OpenAI at de ikke skal bruke innholdet ditt til å trene modellene sine. Det fjerner ikke nettstedet ditt fra svarene i ChatGPT-søk, som avhenger av OAI-SearchBot. Vil du bli sitert i ChatGPT, hold OAI-SearchBot tillatt uansett hva du bestemmer for GPTBot.
Nei. Google sier at AI Overviews og AI Mode ikke har noen tekniske krav utover å være indeksert og kvalifisert for et utdrag i Søk. llms.txt kan hjelpe andre KI-agenter med å finne de viktigste sidene dine, men den har ingen effekt på rangeringen i Google eller på AI Overviews.
AEO (answer engine optimization) og GEO beskriver samme mål: å bli sitert i svar generert av KI-assistenter. Teknisk GEO, noen ganger kalt teknisk AEO, dekker infrastrukturdelen av dette arbeidet: robottilgang, gjengivelse, hastighet, strukturerte data og aktualitet. Innhold- og autoritetsdelene kommer i tillegg.
Vi analyserer konkurrentene dine, nettstedet ditt og synligheten din i AI for å lage en skreddersydd innholdsplan, gratis.
 KI-generator for innholdsbrief
 Generator for FAQ-schema
 Generator for blogg-ideer med AI
 Validator for strukturerte data (schema-validator)
 Sjekk av alt-tekst
 Analyse av interne lenker
 Lenkeutfordringen
 KI-generator for metabeskrivelser
 KI-generator for bloggtitler
 Indekserbarhetssjekker for Google
 KI-generator for bloggdisposisjon
 Generator for UTM-lenker
 Verktøy for gruppering av søkeord
 Sjekk av kanonisk tagg
 XML-sitemap-generator
 Sjekk av ødelagte lenker
 KI-generator for SEO-tittel
 Overskriftsanalyse
 SERP-forhåndsvisning
 Kontroll av omdirigeringer
 Generator for hreflang-tagger
 Analyse av overskriftsstruktur
 Kontroll av HTTP-headere
 Favikon-henter
 SERP CTR-kalkulator
 Sparekalkulator: SEO mot betalt søk
 Kalkulator for SEO-synlighetsandel
 ROI-kalkulator for SEO
 SEO-prognosekalkulator for trafikk og inntekter
 SEO-budsjettkalkulator
 SEO-nullpunktkalkulator
 ROI-kalkulator for SaaS-SEO
 ROAS-kalkulator
 Lesetidskalkulator
 Simulator for rangeringsgevinst
 Kalkulator for verdien av organisk trafikk
 Estimator for organisk trafikk og sjekk av nettstedstrafikk
 Kalkulator for LTV til CAC-forhold
 Kalkulator for avkastning på lokal SEO
 Kalkulator for kostnad ved lenkebygging
 Kalkulator for søkeordverdi
 Kalkulator for poengsum for søkeordmuligheter
 Kalkulator for tetthet av søkeord
 Kalkulator for GEO-avkastning
 Kalkulator for investering i GEO-innhold
 Kalkulator for SEO-avkastning i netthandel
 Kalkulator for kundens levetidsverdi
 Kalkulator for kundeanskaffelseskostnad
 CTR-kalkulator
 Kalkulator for kostnad per artikkel
 Kalkulator for konverteringsrate
 Kalkulator for ROI i innholdsmarkedsføring
 Estimator for ChatGPT-trafikk
 Kalkulator for avvisningsrate
 Kalkulator for backlink-ROI
 Kalkulator for AI-synlighetspoeng
 Kalkulator for verdien av AI-trafikk
 Kalkulator for AI-synlighetsandel
 Kalkulator for kostnaden av AI-usynlighet
 Kalkulator for AI-siteringsrate
 llms.txt-validator
 AI Overview-sjekker og rangeringssjekker for AI Overviews
 Robots.txt-sjekker
 KI-SEO-revisjon
 Sjekk av lesbarhet for LLM
 Sjekk av klargjøring for SearchGPT
 Revisjon av strukturerte data for LLM
 KI-revisjon av crawlbarhet
 Hvorfor ChatGPT ikke anbefaler nettstedet mitt
 Gemini-rangeringsverktøy
 Sjekk av rangering i Perplexity
 Sjekk av LLM-sitater
 AEO-revisjon
 GEO-revisjon
 Test av synlighet i AI-søk
 Sjekk av synlighet i ChatGPT
 llms.txt-generator
 URL-uttrekker
 Nettside til Markdown
 Sjekk av sitemap
 Sensor for SERP-volatilitet
 Sidestørrelsessjekk
 Ordteller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Generator for metatagger
 Bildekomprimerer
 Favicon-generator
 Revisjon av on-page SEO: SEO-sjekk og SEO-analyse
 Verktøy for analyse av tilbakelenker
 Verktøy for søkeordforslag
 Sjekk av domeneautoritet
DE PRØVDE SORANK FØR DEG
 “Jeg testet Sorank på et ekte kundenettsted, og det er helt utrolig. Det gjør alt et byrå ville tatt deg $1500 i måneden for. Nå går det i produksjon på den kunden.”

 Guillaume Guersanguersanguillaume.com“Vi er et annonsebyrå, og vi ville få SEO-en vår på rett spor en gang for alle. Sorank ga oss en tydelig oversikt over nettstedet vårt, hjalp oss å prioritere optimaliseringene og å strukturere innholdet vårt på riktig måte. Verktøyet er enkelt å bruke, godt utformet for et team, og veldig praktisk for å samle oppfølgingen på ett sted uten å jonglere med flere plattformer. Et veldig solid grunnlag for å starte på nytt med SEO.”
 Gaspard MadouiAnnonsebyrå
 “Jeg lot bare Sorank-programvaren gjøre jobben sin, og nå er DR-en min 25, og siden min rangerer høyere.”
 Lucas Flandrefoundertrace.fr“Jeg spesialiserte meg på GEO takket være Sorank. GEO-rangeringen lar meg vise kundene mine hvor de står mot konkurrentene på ChatGPT. Det er en reell kommersiell fordel.”
 MélanieSEO-frilanser“Kjempebra service, den fungerer godt for nettstedet vårt og hjelper oss å forstå hvordan vi kan forbedre det for å rangere bedre på Google og andre steder. Gratulerer, fortsett slik, jeg anbefaler det.”
 Hugo T.Netthandler