Jouw privacy is belangrijk voor ons, daarom kun je bepaalde soorten opslag uitschakelen die niet nodig zijn voor de basiswerking van de website. Het blokkeren van categorieën kan invloed hebben op je ervaring op de website. Meer informatie (Cookiebeleid)
Technische GEO: de checklist van 2026 om je site door AI te laten lezen en citeren
Technische GEO in 2026: toegang voor AI-crawlers, server-rendering, llms.txt, gestructureerde data, snelheid en actualiteit, met checklist voor AI-citaten.
Omslag van het artikel ‘Technische GEO’, met een schermafbeelding van de Sorank-software naast de titel
Tools
Op deze pagina
Kort gezegd
Technische GEO is de set sitinstellingen waarmee AI-assistenten zoals ChatGPT, Claude, Perplexity en Gemini je pagina's kunnen ophalen, lezen en citeren. Het komt neer op zes controles: laat de AI-zoekcrawlers toe (robots.txt, firewall, CDN), lever je hoofdinhoud in de eerste HTML, want de meeste AI-crawlers voeren geen JavaScript uit, houd pagina's snel en vrij van fouten, voeg gestructureerde data toe die overeenkomt met de zichtbare tekst, publiceer een llms.txt-bestand als goedkope aanvulling, en geef actualiteit aan met juiste datums en sitemaps. Niets hiervan garandeert een citaat, maar een fout op deze punten haalt je pagina uit de kandidaten.
3 dagen gratis, daarna stop je wanneer je wilt. 90 dagen resultaat-of-geld-terug-garantie.
Technische GEO is de infrastructuurkant van generative engine optimization: alles wat gebeurt voordat een AI-model beoordeelt of je inhoud het waard is om te citeren. Inhoud en autoriteit bepalen wie geciteerd wordt, maar een pagina die een AI-crawler niet kan bereiken, of die hij als lege JavaScript-shell ziet, komt nooit in de race. Google vat de basis voor zijn AI-functies zelf samen: een pagina moet geïndexeerd zijn en in aanmerking komen voor een snippet, en voor AI Overviews en AI Mode gelden geen extra technische eisen. De andere AI-assistenten draaien hun eigen crawlers, met hun eigen beperkingen, en daar verliezen veel sites zonder dat ze het merken zichtbaarheid. Deze gids behandelt elke laag, van bottoegang tot actualiteit, met een checklist die je in een middag kunt doorlopen.
Wat is technische GEO, en hoe verschilt het van technische SEO?
Technische SEO maakt een site crawlbaar en indexeerbaar voor Googlebot. Technische GEO breidt datzelfde werk uit naar een tiental andere bots die zich anders gedragen: ze renderen minder, crawlen minder vaak en volgen minder regels. De overlap is groot (statuscodes, canonicals, sitemaps, snelheid), dus een site met goede technische SEO heeft al het grootste deel van de basis. De verschillen zitten op vier punten.
Onderwerp
Technische SEO (Googlebot)
Technische GEO (AI-crawlers)
Te beheren bots
Googlebot, Bingbot
OAI-SearchBot, GPTBot, ChatGPT-User, Claude-SearchBot, ClaudeBot, Claude-User, PerplexityBot, Google-Extended en andere
JavaScript
Gerenderd, met vertraging
Niet uitgevoerd door de meeste AI-crawlers
Eenheid van waarde
De pagina en de ranking
De passage die in een antwoord wordt geciteerd
Logica van uitsluiting
Een pagina blokkeren of noindex geven
Aparte keuzes voor training, zoeken en bezoeken die door de gebruiker worden gestart
Meting
Search Console
Serverlogs en promptmonitoring
De praktische gevolgtrekking: een site kan goed scoren op Google en toch onzichtbaar blijven voor ChatGPT of Claude, omdat de inhoud in JavaScript is gebouwd of omdat een firewallregel onbekende bots blokkeert.
Welke AI-crawlers moet je toestaan in robots.txt?
Elk AI-bedrijf draait tegenwoordig meerdere bots, en elk heeft een andere taak. Als je de verkeerde blokkeert, kun je uit AI-antwoorden verdwijnen terwijl je alleen de training van modellen wilde uitsluiten.
OpenAI
Volgens de crawlerdocumentatie van OpenAI (gecontroleerd in oktober 2026) bepaalt OAI-SearchBot of je pagina's in ChatGPT-zoekantwoorden verschijnen, verzamelt GPTBot inhoud die kan worden gebruikt om de modellen te trainen, en haalt ChatGPT-User een pagina op wanneer een gebruiker erom vraagt. GPTBot blokkeren houdt je inhoud uit de training zonder je uit de ChatGPT-zoekfunctie te halen. Wijzigingen in robots.txt hebben ongeveer 24 uur nodig om in de zoekresultaten door te werken, en de regels van robots.txt gelden mogelijk niet voor ChatGPT-User, omdat het bezoek door een persoon wordt getriggerd.
Anthropic
Anthropic hanteert dezelfde drievoudige splitsing, zoals het helpcentrum uitlegt: ClaudeBot voor de training, Claude-SearchBot voor de zoekindexering en Claude-User voor pagina's die tijdens een gesprek worden opgehaald. Claude-SearchBot of Claude-User blokkeren vermindert je zichtbaarheid in de antwoorden van Claude. Anthropic waarschuwt bovendien dat het blokkeren van zijn IP-adressen geen betrouwbare opt-out is, omdat de bot dan mogelijk je robots.txt helemaal niet kan lezen.
Google en de rest
De AI Overviews en AI Mode van Google gebruiken de gewone Googlebot-index. Het Google-Extended-token bepaalt alleen of je inhoud mag worden gebruikt voor de training en grounding van Gemini en in enkele andere Google-systemen, en Google stelt dat het de opname of ranking in Google Zoeken niet beïnvloedt. Perplexity gebruikt PerplexityBot voor zijn index. Voor een kant-en-klare configuratie per bot, zie onze gids over robots.txt-regels voor AI-crawlers en de lijst met AI-crawlers en hun user agents.
Doel
Toestaan
Optioneel blokkeren
Geciteerd worden in ChatGPT
OAI-SearchBot, ChatGPT-User
GPTBot (alleen training)
Geciteerd worden in Claude
Claude-SearchBot, Claude-User
ClaudeBot (alleen training)
Geciteerd worden in Perplexity
PerplexityBot
Geen
Verschijnen in AI Overviews en AI Mode
Googlebot
Google-Extended (geen effect op Zoeken)
Let op
Robots.txt is maar de helft van de controle. Sinds juli 2025 blokkeert Cloudflare AI-crawlers in veel configuraties standaard, en andere firewalls en bot-beschermingstools doen hetzelfde. Controleer je CDN en beveiligingsinstellingen en bevestig daarna in je serverlogs dat de AI-zoekbots een statuscode 200 krijgen.
Kunnen AI-crawlers JavaScript-inhoud lezen?
Meestal niet, en dit is de meest voorkomende fout bij technische GEO. Een analyse van Vercel van zijn netwerk (december 2024) toonde dat geen van de grote AI-crawlers JavaScript renderde: de bots van OpenAI, Anthropic, Meta, ByteDance en Perplexity downloaden de ruwe HTML en stoppen daar. ChatGPT en Claude haalden wel JavaScript-bestanden op, maar voerden ze niet uit. Gemini is de uitzondering, omdat het leunt op de renderinginfrastructuur van Googlebot. Dezelfde studie mat de omvang van dit verkeer: in een maand deed GPTBot 569 miljoen verzoeken en Claude 370 miljoen, tegenover 4,5 miljard voor Googlebot.
Als je productbeschrijvingen, prijzen, artikelen of FAQ's na het laden van de pagina door een React-, Vue- of Angular-app worden ingevoegd, zien AI-crawlers een lege sjabloon. De oplossing is om de essentiële inhoud in het eerste HTML-antwoord te leveren:
Server-side rendering (SSR) of statische generatie voor elke pagina die je geciteerd wilt zien: hoofdtekst, koppen, tabellen, prijzen, auteur en datums.
Pre-rendering voor oudere single-page apps die niet snel naar SSR kunnen overstappen.
Client-side rendering alleen voor secundaire elementen: chatwidgets, tellers, personalisatie.
Een snelle test: open de broncode van de pagina (niet de inspector) of haal de URL op met curl. Ontbreekt je hoofdalinea in de ruwe HTML, dan kunnen AI-crawlers die niet citeren. Onze gids over JavaScript-SEO behandelt de renderingopties framework per framework, en de gratis AI-crawlbaarheidsaudit controleert wat een bot ontvangt.
Hoe beïnvloeden snelheid, statuscodes en HTML-structuur AI-citaten?
AI-assistenten die in real time browsen, halen per vraag meerdere pagina's op en werken onder strakke tijdslimieten. Een trage of kapotte pagina wordt overgeslagen en er wordt een andere bron geciteerd. De studie van Vercel stelde ook vast dat de crawlers van ChatGPT en Claude in ongeveer 34% van hun verzoeken op 404-pagina's uitkomen, tegenover 8% bij Googlebot, vaak omdat ze verouderde URL's opvragen. Drie punten tellen het zwaarst:
Statuscodes: belangrijke pagina's geven 200 terug, redirects maken één sprong en verwijderde pagina's die nog botverzoeken krijgen, worden doorgestuurd naar hun dichtstbijzijnde equivalent.
Responstijd: een snel serverantwoord en een licht HTML-document. Grote pagina's vol inline scripts duwen de nuttige tekst verder naar beneden in het bestand.
Semantische HTML: echte koppen (h2, h3), alinea's, lijsten en tabellen. Crawlers en modellen splitsen pagina's langs die tags op in passages, dus een heldere structuur levert zelfstandige passages op die als zodanig kunnen worden geciteerd.
Tabellen verdienen een aparte vermelding: vergelijkingsdata in een HTML-tabel zijn makkelijk uit te lezen, terwijl dezelfde data in een afbeelding of een canvas-grafiek voor elke AI-crawler verloren gaat.
Helpen gestructureerde data bij AI-zichtbaarheid?
Gestructureerde data laten machines zien waar een pagina over gaat (een artikel, een product, een organisatie, een persoon) en koppelen die aan bekende entiteiten. Google is duidelijk: voor zijn AI-functies is geen speciaal schema nodig, en de markup moet overeenkomen met de zichtbare tekst. De waarde voor technische GEO zit in duidelijkheid, niet in een rankingvoordeel. De typen die op de meeste sites de moeite waard zijn:
Organization met sameAs-links naar je officiële profielen, zodat modellen je merknaam aan één entiteit koppelen.
Article of BlogPosting met author, datePublished en dateModified.
Product en Offer voor e-commercepagina's, met prijs en beschikbaarheid die overeenkomen met de pagina.
BreadcrumbList om de sitestructuur te beschrijven.
Houd de JSON-LD in de eerste HTML en laat hem niet door een tagmanager invoegen, om dezelfde JavaScript-reden als hierboven. De audit van gestructureerde data voor LLM's vergelijkt je markup met wat een model kan lezen, en ons artikel over gestructureerde data voor AI-zoeken beschrijft welke typen nog tellen.
Tip
Schrijf dezelfde kernfeiten (bedrijfsnaam, oprichtingsjaar, prijzen, vestigingen) identiek op in je zichtbare tekst, je schema en je officiële profielen. Consistente feiten over alle bronnen heen helpen een model je merk te beschrijven zonder het met een ander te verwarren.
Is llms.txt de moeite waard?
Het llms.txt-voorstel, gepubliceerd door Jeremy Howard in september 2024, is een Markdown-bestand in de root van een site dat de nuttigste pagina's opsomt met een korte beschrijving, zodat een AI-agent de juiste inhoud vindt zonder navigatiemenu's te ontleden. Het is een voorstel en geen formele standaard: het regelt geen toegang en geen indexering, en Google noemt het niet bij de eisen voor zijn AI-functies. Zie het als een goedkope aanvulling: het kost minder dan een uur, het helpt agents en codeerassistenten die ernaar zoeken, en je moet kiezen welke pagina's je site representeren. Je kunt een concept maken met de llms.txt-generator, en schone Markdown-versies van belangrijke pagina's aanbieden als je stack dat toelaat.
Hoe geef je actualiteit aan AI-assistenten?
AI-assistenten die het web doorzoeken, geven de voorkeur aan recente en gedateerde bronnen bij elke vraag waarbij tijd telt (prijzen, tools, regels, statistieken). Actualiteit van inhoud is deels een redactionele kwestie, maar de signalen zijn technisch:
Een zichtbare datum van laatste update op de pagina, gelijk aan dateModified in het schema.
Een XML-sitemap met juiste lastmod-waarden, alleen gewijzigd wanneer de inhoud echt verandert.
IndexNow-pings voor Bing en de andere zoekmachines die het ondersteunen, omdat meerdere AI-assistenten op de Bing-index leunen. Google gebruikt IndexNow niet.
Stabiele URL's: een artikel updaten op hetzelfde adres behoudt links en historie, terwijl een nieuwe URL van nul begint en een 404 achterlaat.
De checklist voor technische GEO
Controle
Hoe controleren
Prioriteit
AI-zoekbots toegestaan in robots.txt
robots.txt lezen op OAI-SearchBot, Claude-SearchBot, PerplexityBot
Hoog
Geen blokkade door firewall of CDN
Serverlogs tonen 200-antwoorden voor AI-bots
Hoog
Hoofdinhoud in de ruwe HTML
Broncode bekijken of de URL met curl ophalen
Hoog
Belangrijke pagina's geïndexeerd door Google en Bing
Search Console en Bing Webmaster Tools
Hoog
Status 200, redirects in één sprong
Crawlen met een SEO-crawler
Gemiddeld
Semantische koppen, lijsten en tabellen
De HTML-opbouw lezen
Gemiddeld
Organization- en Article-schema
Schemavalidator
Gemiddeld
Zichtbare datums en juiste lastmod
Pagina, schema en sitemap vergelijken
Gemiddeld
llms.txt in de root
/llms.txt openen
Laag
Doe dit één keer op je 20 belangrijkste pagina's, en daarna na elke herontwerp, CMS-wijziging of beveiligingsupdate. De logs van AI-crawlers zijn het enige directe bewijs dat de bots je pagina's bereiken; al het andere is gevolgtrekking.
Hoe weet je of technische GEO werkt?
Technische fixes openen de deur; het resultaat zie je in AI-antwoorden. Twee metingen sluiten de lus. Ten eerste de serverlogs: bezoeken van OAI-SearchBot, Claude-SearchBot en PerplexityBot moeten toenemen op de pagina's die je hebt verbeterd. Ten tweede de citaten: volg een vaste set vragen die je klanten stellen en controleer, week na week, of je merk wordt genoemd en welke bronnen er in plaats daarvan worden geciteerd. Patronen uit grote steekproeven helpen om verwachtingen te bepalen, zoals in onze studie naar ChatGPT-citaten.
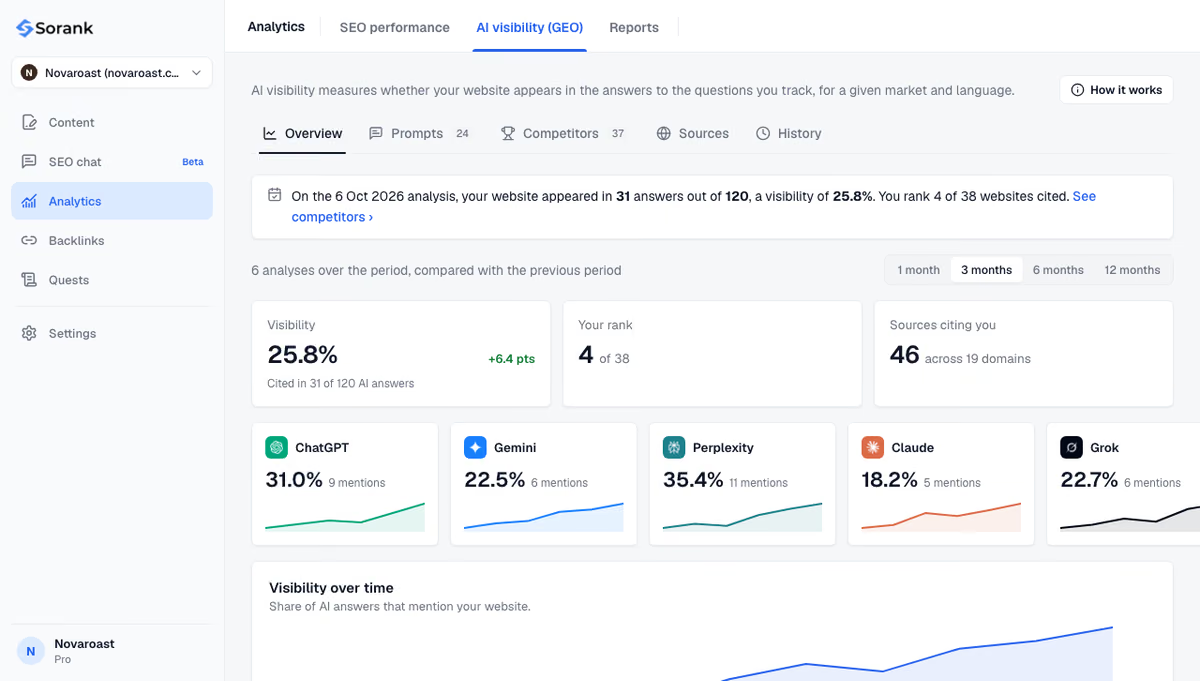
Sorank, onze software, neemt dat tweede deel voor zijn rekening met de tracking van AI-vermeldingen: 10 - 50 gevolgde prompts afhankelijk van het abonnement, op ChatGPT, Claude en Gemini, plus Grok vanaf het Pro-abonnement, met je zichtbaarheidspercentage en de concurrenten die in jouw plaats worden geciteerd.
Zodra de technische basis op orde is, is de volgende grens de inhoud: pagina's die vragen helder beantwoorden, met bronnen. De artikelgenerator schrijft en publiceert geoptimaliseerde artikelen voor Google en AI op autopilot, met interne links en bronnen.
Technische GEO bepaalt of AI-assistenten je site kunnen lezen; inhoud en autoriteit bepalen of ze ernaar verwijzen. Los eerst toegang, rendering en structuur op, en meet daarna de citaten. Abonnementen en de proefperiode van 3 dagen vind je op de prijspagina.
Veelgestelde vragen
Moet ik GPTBot blokkeren om mijn inhoud te beschermen?
GPTBot blokkeren betekent alleen dat je OpenAI vraagt je inhoud niet voor de training van zijn modellen te gebruiken. Je site verdwijnt daarmee niet uit de antwoorden van de ChatGPT-zoekfunctie, die afhangen van OAI-SearchBot. Wil je geciteerd worden in ChatGPT, laat OAI-SearchBot dan toe, wat je ook beslist over GPTBot.
Gebruikt Google llms.txt voor AI Overviews?
Nee. Google stelt dat AI Overviews en AI Mode geen technische eisen hebben behalve dat een pagina geïndexeerd is en in aanmerking komt voor een snippet in Zoeken. llms.txt kan andere AI-agents helpen je belangrijkste pagina's te vinden, maar het heeft geen effect op de Google-ranking of op AI Overviews.
Wat is het verschil tussen technische GEO en AEO?
AEO (optimalisatie voor antwoordmachines) en GEO beschrijven hetzelfde doel: geciteerd worden in antwoorden die AI-assistenten genereren. Technische GEO, soms technische AEO genoemd, dekt het infrastructuurdeel van dat werk: bottoegang, rendering, snelheid, gestructureerde data en actualiteit. Inhoud en autoriteit komen daarbovenop.
y!
Gratis SEO- en GEO-audit
Ontvang gratis je contentplan voor 30 dagen
We analyseren je concurrenten, je website en je AI-zichtbaarheid om gratis een contentplan op maat voor je te maken.
“Ik heb Sorank getest op de site van een echte klant en het is waanzinnig. Het doet alles waar een bureau je $1500 per maand voor rekent. Het gaat nu bij die klant in productie.”Guillaume Guersanguersanguillaume.com
“Wij zijn een advertentiebureau en wilden onze SEO eens en voor altijd weer op de rails krijgen. Sorank gaf ons een helder beeld van onze site, hielp ons optimalisaties te prioriteren en onze content goed te structureren. De tool is makkelijk in gebruik, goed ontworpen voor een team en erg handig om het volgen te centraliseren zonder met meerdere platforms te hoeven jongleren. Een heel solide basis om met onze SEO opnieuw te beginnen.”Gaspard MadouiAdvertentiebureau
“Dankzij Sorank heb ik me gespecialiseerd in GEO. Met de GEO-ranglijst kan ik mijn klanten hun positie ten opzichte van concurrenten in ChatGPT laten zien. Het is een echt commercieel onderscheidend vermogen.”MélanieFreelance SEO-specialist
“Geweldige service, werkt goed voor onze website en helpt ons begrijpen hoe we die kunnen verbeteren om beter te scoren in Google en elders. Gefeliciteerd, ga zo door, ik raad het aan.”Hugo T.E-commerce-ondernemer