التفضيلات
خصوصيتك مهمة بالنسبة لنا، لذلك لديك خيار تعطيل أنواع معينة من التخزين التي قد لا تكون ضرورية للوظائف الأساسية للموقع. قد يؤثر حظر الفئات على تجربتك في الموقع. مزيد من المعلومات

خصوصيتك مهمة بالنسبة لنا، لذلك لديك خيار تعطيل أنواع معينة من التخزين التي قد لا تكون ضرورية للوظائف الأساسية للموقع. قد يؤثر حظر الفئات على تجربتك في الموقع. مزيد من المعلومات

السيو للمطورين: HTML تقرؤه برامج الزحف، ورموز HTTP صحيحة، ووسوم head الأساسية، واجتياز مؤشرات Core Web Vitals، والظهور لدى الذكاء الاصطناعي.

أدوات


باختصار
بالنسبة إلى المطور، يعني السيو جعل كل صفحة مهمة قابلة للوصول والعرض وواضحة لا لبس فيها لبرامج الزحف. قدّم المحتوى الرئيسي في HTML الأولي (العرض من جهة الخادم أو التوليد الثابت)، وأعد رموز HTTP صادقة، وضع title وmeta description وcanonical وتعليمات robots في استجابة الخادم، واربط بعناصر <a href> حقيقية، والتزم بحدود مؤشرات Core Web Vitals، وأضف بيانات منظمة بصيغة JSON-LD. معظم برامج زحف الذكاء الاصطناعي لا تنفّذ JavaScript، لذا فالمحتوى الذي لا يظهر إلا بعد مرحلة hydration غير مرئي لـ ChatGPT وClaude وPerplexity.
هل تريد التعمق أكثر؟ اسأل
اختبار سريع
هل السيو مناسب لك، وكيف تبدأ؟
4 أسئلة سريعة لترى إن كان Google قادرًا على جلب العملاء لك.
نصيحتنا لك
Sorank هو الحل المناسب لك
الناس يبحثون عمّا تبيعه ويمكنك الانتظار بضعة أشهر: يجد Sorank عمليات البحث المناسبة، ويكتب المقالات وينشرها، ويحصل لك على روابط.
Sorank يناسب إجاباتك
جرّبه 3 أيام على موقعك، أو ابدأ بتدقيق مجاني لتعرف أين تقف.
3 أيام مجانًا، ثم توقف متى شئت. ضمان استرداد الأموال لمدة 90 يومًا.
السيو للمطورين هو الجزء من تحسين محركات البحث الذي يعيش داخل الشيفرة: القوالب والتوجيه والعرض والترويسات والأداء. يختار فريق التسويق الكلمات المفتاحية ويكتب المحتوى، لكن رمز حالة خاطئًا أو مسارًا يُعرض في المتصفح فقط أو وسم noindex منسيًا قد يمحو هذا الجهد في عملية نشر واحدة. وتصف أساسيات تحسين JavaScript لمحركات البحث من Google ثلاث مراحل (الزحف والعرض والفهرسة)، ولكل مرحلة أعطال لا يصلحها إلا المطورون. يعالجها هذا الدليل بالترتيب الذي تتعطل به.
| المجال | مسؤولية المطور | العَرَض المعتاد عند الخلل |
|---|---|---|
| العرض | المحتوى الرئيسي والروابط موجودة في HTML القادم من الخادم | صفحات مفهرسة فارغة أو ناقصة |
| رموز الحالة | إعادة 200 و301 و404 و410 و5xx بصدق | Soft 404، وصفحات أخطاء مفهرسة، وصفحات محذوفة ما زالت تظهر |
| وسوم head | title وdescription وcanonical وrobots وhreflang فريدة | تكرار، وظهور عنوان URL خاطئ، وصفحات خارج الفهرس |
| التحكم في الزحف | robots.txt وخريطة موقع XML والروابط الداخلية والمعاملات | صفحات مهمة غير مكتشفة، وزحف مهدر على عوامل التصفية |
| الأداء | Core Web Vitals لدى مستخدمي الجوال الحقيقيين | تجربة صفحة ضعيفة وتحويلات أقل |
| البيانات المنظمة | JSON-LD صالح ومطابق للمحتوى الظاهر | لا نتائج غنية، والتباس حول الكيان |
| وصول الذكاء الاصطناعي | السماح لبرامج زحف الذكاء الاصطناعي، ومحتوى مقروء بدون JavaScript | غياب العلامة التجارية عن إجابات ChatGPT وPerplexity |
يعرض Googlebot شيفرة JavaScript، لكن في خطوة ثانية قد تتأخر، وتكتب Google نفسها أن العرض من جهة الخادم أو العرض المسبق ما زال فكرة ممتازة، لأنه أسرع للمستخدمين وبرامج الزحف ولأن الروبوتات لا تنفّذ كلها JavaScript. وهذه النقطة الأخيرة أهم اليوم من أي وقت مضى: ففي تحليل The rise of the AI crawler الصادر في ديسمبر 2024، وجدت Vercel أن أيًّا من برامج زحف الذكاء الاصطناعي الكبرى لا يعرض JavaScript حاليًا، وذكرت منها GPTBot وOAI-SearchBot وChatGPT-User وClaudeBot وPerplexityBot. ويُستثنى Gemini الذي يعتمد على بنية Google التحتية.
| نمط العرض | ما تتلقاه برامج الزحف | الملاءمة للسيو |
|---|---|---|
| العرض من جهة العميل (CSR) | هيكل HTML شبه فارغ، والمحتوى بعد تشغيل JavaScript | ضعيفة: متأخر لدى Google وغير مرئي لمعظم برامج زحف الذكاء الاصطناعي |
| العرض من جهة الخادم (SSR) | HTML كامل مع كل طلب | قوية للصفحات الديناميكية |
| التوليد الثابت (SSG) | HTML كامل يُبنى وقت النشر | الأقوى للمحتوى قليل التغيّر |
| إعادة التوليد التدريجي (ISR) | HTML ثابت يتجدد وفق جدول أو عند الطلب | قوية للكتالوجات الكبيرة والمدونات |
تنطبق قاعدتان أيًّا كان إطار العمل. يجب أن تكون الروابط عناصر <a> تحمل السمة href: تذكر Google أنها لا تكتشف الروابط إلا بهذا الشكل، لذا فالأزرار ذات معالجات النقر والمسارات القائمة على الأجزاء (#) طرق مسدودة. ويحتاج كل مسار إلى عنوان URL خاص به بدون # يعيد محتواه مباشرة. وتتناول أدلتنا حول سيو JavaScript وسيو تطبيقات الصفحة الواحدة وسيو Next.js تفاصيل كل إطار.
رموز الحالة تعليمات لبرامج الزحف. وتصف وثائق Google حول رموز حالة HTTP وأخطاء الشبكة كيفية التعامل مع كل فئة:
تحقّق مما يرسله خادمك فعلًا باستخدام أداة فحص ترويسات HTTP، واجعل سلاسل إعادة التوجيه قفزة واحدة: يتناول مقالنا حول إعادة التوجيه في السيو سيناريوهات الترحيل.
تحتاج كل صفحة قابلة للفهرسة إلى title وdescription فريدين، ووسم canonical يشير إلى الصفحة نفسها، وفي المواقع متعددة اللغات إلى إشارات hreflang. أبقها في استجابة الخادم:
<title>Running shoes for flat feet | Example</title>
<meta name="description" content="Tested picks, sizes and prices.">
<link rel="canonical" href="https://example.com/running-shoes-flat-feet">
<link rel="alternate" hreflang="fr" href="https://example.com/fr/chaussures-pieds-plats">
<meta name="robots" content="index, follow">
يجب أن يشير وسم canonical إلى العنوان الذي تريد ظهوره في الترتيب، بنفس البروتوكول والمضيف وقاعدة الشرطة المائلة الختامية التي يعتمدها موقعك تمامًا.
تنبيه
لا تعتمد أبدًا على JavaScript لإزالة noindex. تذكر Google أنها قد تتخطى مرحلة العرض عندما تجد وسم noindex، لذا قد تبقى خارج الفهرس صفحةٌ تُرسل مع noindex في HTML ثم تزيله من جهة العميل.
تفهرس محركات البحث عناوين URL، لذا فإن مخطط العناوين قرار سيو. استخدم مسارات مقروءة بأحرف صغيرة تفصل بينها شرطات، واختر قاعدة واحدة للشرطة المائلة الختامية وأعد توجيه الأخرى، واحتفظ بعنوان واحد لكل محتوى. تضاعف عوامل التصفية والترتيب ومعاملات التتبع عدد العناوين دون إضافة محتوى: وجّه canonical الخاص بها إلى النسخة النظيفة، ولا تضع روابط لتركيبات معاملات لا تريد زحفها.
تحمل الروابط الداخلية الاكتشاف والأهمية معًا. اعرض التنقل ومسار التنقل وكتل المحتوى ذي الصلة من الخادم، وامنح القوائم المقسّمة إلى صفحات روابط بسيطة إلى كل صفحة، وتجنب التمرير اللانهائي بلا عناوين صفحات خلفه. المنتج أو المقال الذي لا يمكن الوصول إليه إلا عبر البحث الداخلي أو عامل تصفية بلغة JavaScript هو صفحة يتيمة بالنسبة لبرنامج الزحف.
يتحكم robots.txt في الزحف لا في الفهرسة: قد يظهر عنوان محظور في النتائج إذا أشارت إليه صفحات أخرى. لإبقاء صفحة خارج الفهرس، اسمح بالزحف إليها وأعد noindex. ولّد خريطة موقع XML من المسارات أو قاعدة البيانات، ولا تدرج فيها إلا العناوين الأساسية التي تعيد 200، ولا تحدّث lastmod إلا عند تغيّر المحتوى فعلًا. اختبر قواعدك باستخدام أداة فحص robots.txt قبل كل إصدار، ولا تنشر أبدًا في بيئة الإنتاج ملف robots.txt خاصًا بالاختبار يحتوي على "Disallow: /".
تستخدم Google مؤشرات Core Web Vitals ضمن إشارات تجربة الصفحة. ووفق web.dev، تكون الصفحة جيدة عندما تبلغ هذه الحدود عند المئين 75 من عمليات التحميل الحقيقية، على الجوال وسطح المكتب:
| المؤشر | ما يقيسه | الحد الجيد | إصلاحات شائعة من جهة التطوير |
|---|---|---|---|
| LCP (Largest Contentful Paint) | التحميل | 2.5 ثانية أو أقل | التحميل المسبق للصورة الرئيسية، وعرض الجزء العلوي من الخادم، واستخدام CDN |
| INP (Interaction to Next Paint) | الاستجابة | 200 ملي ثانية أو أقل | تقسيم المهام الطويلة، وتأجيل نصوص الجهات الخارجية، وخفض كلفة hydration |
| CLS (Cumulative Layout Shift) | الثبات البصري | 0.1 أو أقل | تحديد عرض الوسائط وارتفاعها، وحجز مساحة للإعلانات والعناصر المضمّنة |
حلّ INP محل First Input Delay كمؤشر مستقر ضمن Core Web Vitals في عام 2024. احكم بناءً على البيانات الميدانية (Search Console وChrome UX Report) وصحّح الأخطاء بأدوات المختبر. ويسرد مدخل المسرد لدينا حول Core Web Vitals الأدوات.
استخدم JSON-LD داخل وسم script، معروضًا من الخادم، يصف ما هو ظاهر في الصفحة:
<script type="application/ld+json">
{"@context": "https://schema.org", "@type": "Article",
 "headline": "Running shoes for flat feet",
 "datePublished": "2026-10-01",
 "author": {"@type": "Person", "name": "Jane Doe"}}
</script>
ولّده من البيانات نفسها التي تُبنى منها الصفحة حتى لا يختلفا أبدًا، وتحقق من صحته في التكامل المستمر، وتجنب حقنه عبر مدير الوسوم. يقدّم مولّد schema قالبًا أوليًا للأنواع الشائعة.
نصيحة
أضف فحوص السيو إلى خط النشر: اجعل البناء يفشل إذا خلا قالب قابل للفهرسة من title أو canonical، أو إذا أعاد مسارٌ 200 لمعرّف slug غير معروف، أو إذا احتوى ملف robots.txt في الإنتاج على "Disallow: /". التقاط هذه التراجعات قبل النشر رخيص، وبعده مكلف.
تبدأ الرؤية في الذكاء الاصطناعي من الوصول. حدّد برامج زحف الذكاء الاصطناعي التي تسمح بها (GPTBot وOAI-SearchBot وClaudeBot وPerplexityBot وغيرها) واكتب قواعد صريحة في robots.txt؛ ويشرح دليلنا حول robots.txt لبرامج زحف الذكاء الاصطناعي الفرق بين روبوتات التدريب وروبوتات البحث. ثم تأكد من أن النصوص والأسعار والمواصفات والأسئلة الشائعة موجودة في HTML الأولي، واستخدم عناوين دلالية وجداول بدل النصوص داخل الصور، وأبقِ الصفحات خفيفة بما يكفي لجلبها بسرعة. يمكن لملف llms.txt أن يلخّص صفحاتك الرئيسية لأدوات الذكاء الاصطناعي، لكن لم يؤكد أي مساعد كبير اعتماده عليه، فتعامل معه كخيار إضافي.
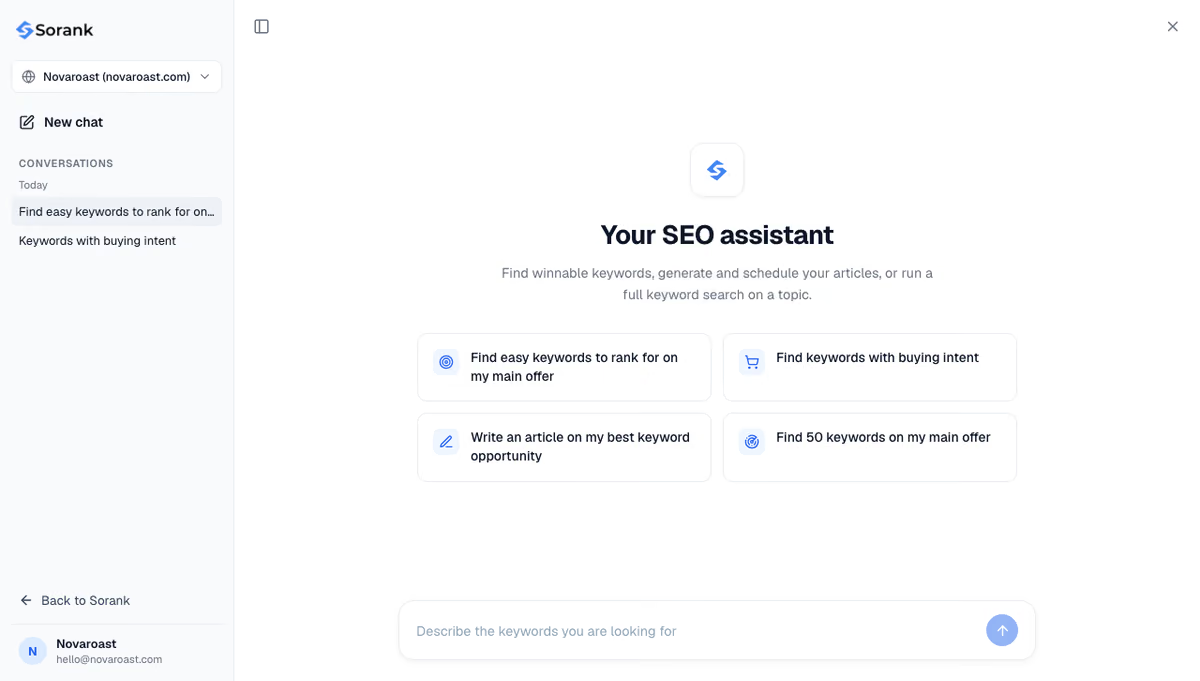
Sorank هو منتجنا: برنامج للسيو وGEO يعمل بنظام autopilot. يتعرّف إليه المطورون غالبًا عبر التكاملات: فهو ينشر المقالات على WordPress أو Shopify أو Webflow أو Wix، أو على أي بنية خاصة عبر webhook، كما هو موضح في صفحة التثبيت. ويجيب SEO Chat على أسئلتك حول موقعك في محادثة، ويتحقق تتبّع الإشارات في الذكاء الاصطناعي كل أسبوع مما إذا كانت ChatGPT وClaude وGemini تذكر علامتك التجارية.
الخلاصة: أرسل من الخادم HTML كاملًا ورموز حالة صادقة ووسومًا صحيحة، ثم قِس الأداء لدى المستخدمين الحقيقيين. هذا يخدم Googlebot وبرامج زحف الذكاء الاصطناعي التي لا تنفّذ JavaScript. لملء موقع مبني جيدًا بمحتوى يتصدر النتائج، اطّلع على خطط Sorank، بدءًا من $49 شهريًا مع تجربة مجانية لمدة 3 أيام.

ليس دائمًا بالنسبة إلى Google التي تعرض JavaScript، لكنه يضيف تأخيرًا ومخاطرة، ومعظم برامج زحف الذكاء الاصطناعي لا تنفّذ JavaScript إطلاقًا. للصفحات التي يجب أن تتصدر أو يُستشهد بها، قدّم المحتوى الرئيسي والروابط في HTML الأولي عبر العرض من الخادم أو التوليد الثابت أو العرض المسبق، واترك العرض من جهة العميل للأجزاء التفاعلية.
كلاهما يخبر Google بأن الصفحة لم تعد موجودة، وفي الحالتين تتوقف Google عن استخدام العنوان مع الوقت. يشير 410 إلى حذف مقصود ونهائي، وتفضّله بعض الفرق للمحتوى المحذوف عمدًا. الأهم ألا تعيد 200 مع رسالة خطأ، لأن ذلك ينتج soft 404.
هي جزء من إشارات تجربة الصفحة التي تصفها Google بأنها عامل من عوامل كثيرة، فيما تحظى الملاءمة وجودة المحتوى بوزن أكبر. وهي تحسم غالبًا بين الصفحات المتشابهة وتؤثر بقوة في التحويلات، لذلك يستحق بلوغ حدودها الجهد.
 مولد موجز المحتوى بالذكاء الاصطناعي
 مولد مخطط الأسئلة الشائعة
 مولد أفكار المقالات بالذكاء الاصطناعي
 مدقق البيانات المنظمة
 مدقق النص البديل
 محلل الروابط الداخلية
 تحدي الروابط الخلفية
 مولّد الوصف التعريفي بالذكاء الاصطناعي
 مولّد عناوين المدونات بالذكاء الاصطناعي
 أداة فحص قابلية الفهرسة في Google
 مولّد مخطط المقالات بالذكاء الاصطناعي
 مولّد روابط UTM
 أداة تجميع الكلمات المفتاحية
 أداة فحص وسم الرابط الأساسي
 مولّد خريطة موقع XML
 أداة فحص الروابط المعطلة
 مولّد عناوين SEO بالذكاء الاصطناعي
 محلل العناوين
 أداة معاينة نتائج البحث
 فاحص إعادة التوجيه
 مولّد وسوم hreflang
 محلّل بنية العناوين
 أداة فحص ترويسات HTTP
 أداة استخراج Favicon
 حاسبة حصة الصوت في SEO
 حاسبة توقّعات زيارات وإيرادات SEO
 حاسبة ميزانية SEO
 حاسبة محاكاة الارتقاء في الترتيب
 حاسبة الاستثمار في محتوى GEO
 حاسبة CTR
 حاسبة توفير SEO مقابل البحث المدفوع
 حاسبة درجة فرصة الكلمة المفتاحية
 أداة تقدير الزيارات الواردة من ChatGPT
 حاسبة حصة الصوت في الذكاء الاصطناعي
 أداة الترتيب في Gemini
 مولّد llms.txt
 أداة فحص خريطة الموقع
 محول صفحات الويب إلى Markdown
 عدّاد الكلمات
 مولّد ترميز Schema
 معاينة Open Graph
 أداة ضغط الصور
 أداة تحليل الروابط الخلفية
 حاسبة نقطة التعادل في SEO
 حاسبة وقت القراءة
 حاسبة GEO ROI
 حاسبة ROI الروابط الخلفية
 تدقيق البيانات المنظّمة لنماذج LLM
 تدقيق GEO
 مستشعر تقلّب نتائج البحث
 مولّد روابط URL
 مولّد وسوم الميتا
 أداة البحث عن الكلمات المفتاحية
 حاسبة SERP CTR
 حاسبة ROI في SEO
 حاسبة نسبة LTV إلى CAC
 أداة تقدير الزيارات الطبيعية
 حاسبة تكلفة بناء الروابط
 حاسبة القيمة الدائمة للعميل
 حاسبة تكلفة المقال
 حاسبة معدل التحويل
 حاسبة معدل الارتداد
 حاسبة قيمة الزيارات القادمة من الذكاء الاصطناعي
 أداة فحص AI Overview من Google
 تدقيق SEO بالذكاء الاصطناعي
 تدقيق تحسين الظهور في إجابات الذكاء الاصطناعي
 حاسبة ROI في SEO لشركات SaaS
 حاسبة ROAS
 حاسبة ROI لـSEO المحلي
 حاسبة قيمة الكلمة المفتاحية
 حاسبة كثافة الكلمات المفتاحية
 حاسبة ROI في SEO للتجارة الإلكترونية
 حاسبة تكلفة اكتساب العميل
 حاسبة ROI في تسويق المحتوى
 حاسبة درجة الظهور في الذكاء الاصطناعي
 حاسبة تكلفة الغياب عن إجابات الذكاء الاصطناعي
 حاسبة معدل الاستشهاد في إجابات الذكاء الاصطناعي
 أداة فحص الاستشهاد في نماذج LLM
 تدقيق السيو داخل الصفحة
 حاسبة قيمة الزيارات الطبيعية
 أداة التحقق من llms.txt
 اختبار قابلية القراءة للذكاء الاصطناعي
 اختبار الجاهزية لـ SearchGPT
 تدقيق زحف روبوتات الذكاء الاصطناعي
 لماذا لا يوصي ChatGPT بموقعكم
 أداة فحص الترتيب في Perplexity
 اختبار الظهور في البحث بالذكاء الاصطناعي
 فاحص الظهور في ChatGPT
 مستخرج الروابط
 أداة فحص حجم الصفحة
 مولّد robots.txt
 مولّد Favicon
 أداة فحص robots.txt
 فاحص سلطة النطاق
لقد جربوا SORANK قبلك
 “نحن وكالة إعلانات (Ads) وأردنا أخيرًا إعادة تنظيم الـ SEO لدينا بشكل نهائي. قدّمت لنا Sorank رؤية واضحة لموقعنا، وساعدتنا على ترتيب أولويات التحسينات وهيكلة المحتوى بشكل صحيح. الأداة سهلة الاستخدام، ومصممة جيدًا للعمل الجماعي، وعملية جدًا لتجميع المتابعة دون الحاجة إلى التنقل بين عدة منصات. أساس متين جدًا لبداية جديدة مع الـ SEO لدينا.”
 Gaspard Madouiوكالة إعلانات (Ads)“على مدى عامين، جاء 100% من عملائي من LinkedIn. النشر يوميًا، والتعليق، ومتابعات الرسائل المباشرة... اعتماد كامل على الخوارزمية. كنت أعلم أنني بحاجة إلى العمل على SEO لكنني كنت أؤجله دائمًا: طويل جدًا، وتقني جدًا، وليس مجال عملي. مع Sorank، اتخذت الخطوة أخيرًا. خلال 4 أشهر، أصبحت أولد 15 عميلًا محتملًا عضويًا شهريًا دون نشر أي شيء. لا يزال الأمر ليس مناصفة مع LinkedIn، لكنني أنام بشكل أفضل لعلمي أن لدي الآن مصدر عملاء ثانيًا ينمو تلقائيًا.”
 Valentin Thomyوكالة ColdMailing
 “تركت برنامج Sorank يقوم بعمله فقط، والآن أصبح تقييم DR لموقعي 25 وصفحتي تحتل مرتبة أعلى.”
 Lucas Flandrefoundertrace.fr“حل ممتاز لإدارة SEO دون صداع. عمليات التدقيق سريعة، والواجهة واضحة، وترى بسرعة الإجراءات التي يجب تنفيذها. لقد أصبح أداة أساسية لتتبع وتحسين SEO الخاص بمواقعي. أوصي به بشدة.”
 Xavرائد أعمال