La privacy è importante per noi, quindi hai la possibilità di disabilitare alcuni tipi di archiviazione che potrebbero non essere necessari per il funzionamento di base del sito web. Il blocco delle categorie può influire sulla tua esperienza sul sito web. Ulteriori informazioni (Politica sui cookie)
Grazie! La tua richiesta è stata ricevuta!
Ops! Qualcosa è andato storto durante l'invio del modulo.
Grafi di conoscenza: come i fatti strutturati fondano le risposte dell'IA nel 2027
I grafi di conoscenza conservano entità e relazioni come fatti collegati che l'IA può interrogare. Come funzionano, come li usa GraphRAG e cosa cambiano per il GEO.
I grafi di conoscenza sono reti di entità, come persone, aziende o prodotti, collegate da relazioni con un nome. I sistemi consultano questi collegamenti per ragionare sui fatti invece di confrontare testi approssimativi. Così le risposte diventano più precise e più facili da verificare, e i motori di ricerca e i sistemi di IA possono citarle con più facilità.
I grafi di conoscenza conservano le informazioni come una rete invece che in righe e colonne. Ogni nodo è un'entità, ogni arco è una relazione tra due entità, e entrambi possono avere attributi descrittivi. Il risultato è una mappa di fatti che il software può percorrere, interrogare e verificare, ed è per questo che motori di ricerca e assistenti di IA si basano su questa idea.
Che cos'è un grafo di conoscenza?
Un grafo di conoscenza è un insieme di dati collegati su cose del mondo reale e sul modo in cui sono in relazione tra loro. Queste cose, chiamate entità, possono essere persone, aziende, prodotti, luoghi o concetti. L'esempio più noto è il Google Knowledge Graph, ma il modello è generale e viene usato anche per i dati aziendali, le banche dati di ricerca e i sistemi di ricerca interna.
Google ha presentato il suo grafo nel maggio 2012 come un modello capace di comprendere le cose e le loro relazioni, non solo stringhe di testo. Nel suo annuncio, Google scriveva che il grafo conteneva più di 500 milioni di oggetti e più di 3,5 miliardi di fatti su di essi e sulle relazioni tra loro.
Come funzionano nodi, archi e triple?
L'unità di base è la tripla, un'affermazione composta da soggetto, predicato e oggetto. Il W3C RDF 1.1 Primer spiega che le affermazioni RDF sono composte da tre elementi, chiamati triple, e che soggetti e oggetti diventano i nodi del grafo, mentre i predicati ne sono gli archi.
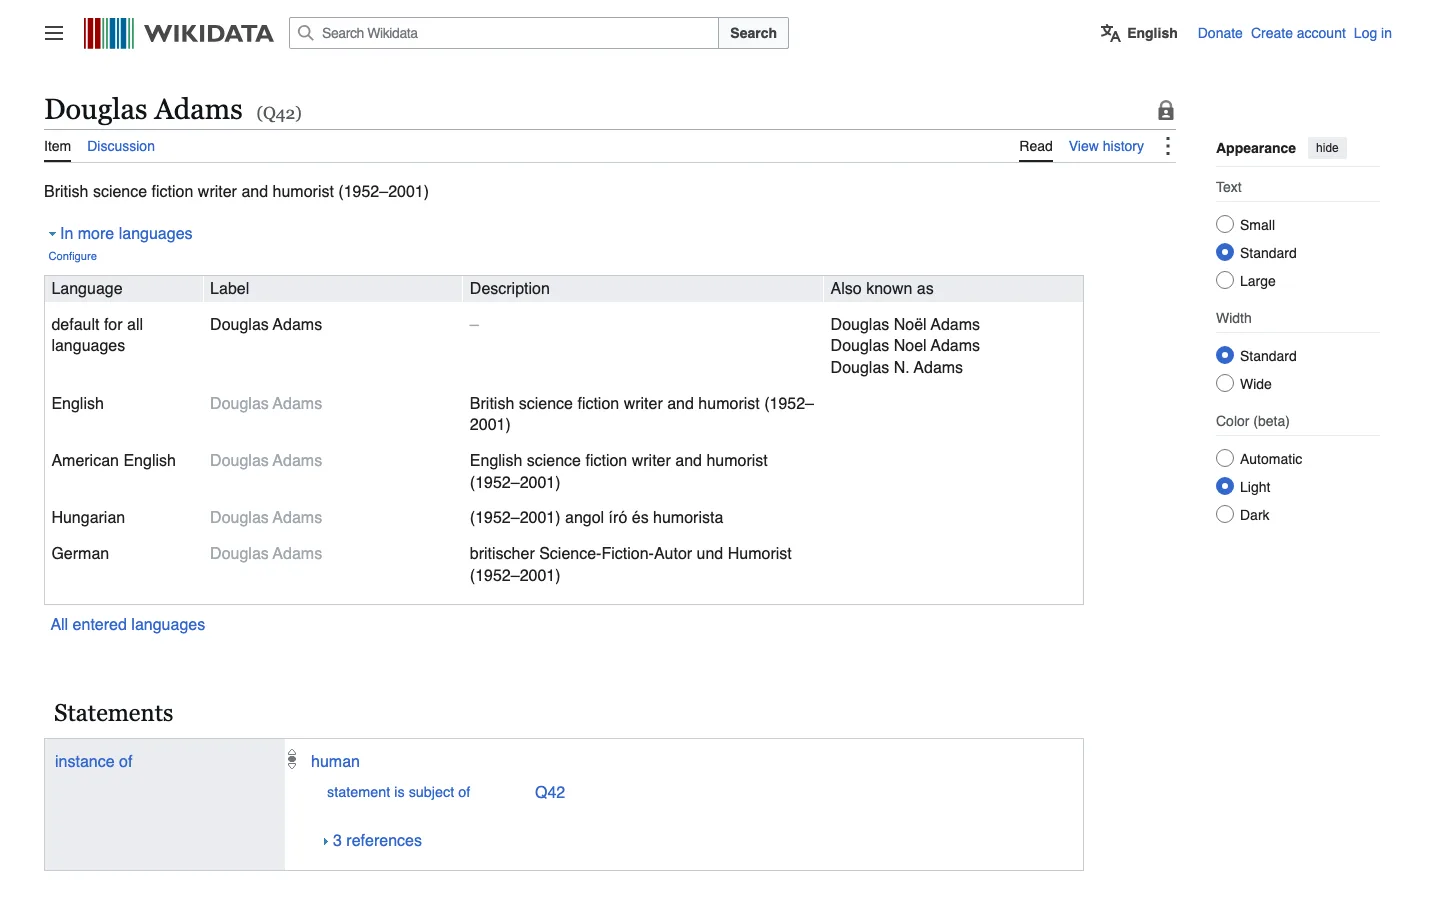
Una tripla si legge come una frase breve. La schermata qui sotto mostra la scheda pubblica di Wikidata dedicata allo scrittore Douglas Adams, dove l'affermazione «istanza di: essere umano» collega un'entità a una categoria più ampia. La stessa entità può essere collegata a molte altre, e ogni collegamento aggiunge un arco al grafo.
Una scheda pubblica di Wikidata mostra una tripla: il soggetto Douglas Adams, il predicato istanza di e l'oggetto essere umano (screenshot di wikidata.org).
Un'ontologia è il progetto del grafo. Definisce quali tipi di entità esistono, quali relazioni sono ammesse e quali regole si applicano, ad esempio che ogni ordine deve contenere almeno un prodotto. In questo modo il grafo resta coerente e il software può ragionarci sopra invece di tirare a indovinare.
Come vengono conservati e interrogati i grafi di conoscenza?
I grafi di conoscenza di solito risiedono in database a grafo o triplestore, come Neo4j, Amazon Neptune o GraphDB. Questi sistemi sono costruiti per passare da un nodo ai suoi vicini, e poi ai vicini di questi, cosa che risulta complicata da esprimere in un database relazionale quando la catena di relazioni è lunga.
Questo percorso attraverso più passaggi è il punto di forza principale di un grafo. Una domanda come «quali fornitori di un prodotto servono anche un concorrente?» richiede più join in un modello a tabelle, mentre un grafo segue semplicemente gli archi tra i nodi coinvolti.
In cosa un grafo di conoscenza si distingue da un database normale?
Un database normale conserva i dati in tabelle e tratta le relazioni come join calcolati al momento della query. Un grafo di conoscenza conserva le relazioni come dati a sé stanti, quindi le connessioni possono essere percorse, aggiunte e spiegate direttamente. Motori di ricerca e sistemi di IA lo usano per rispondere a domande che dipendono dal modo in cui più fatti si collegano.
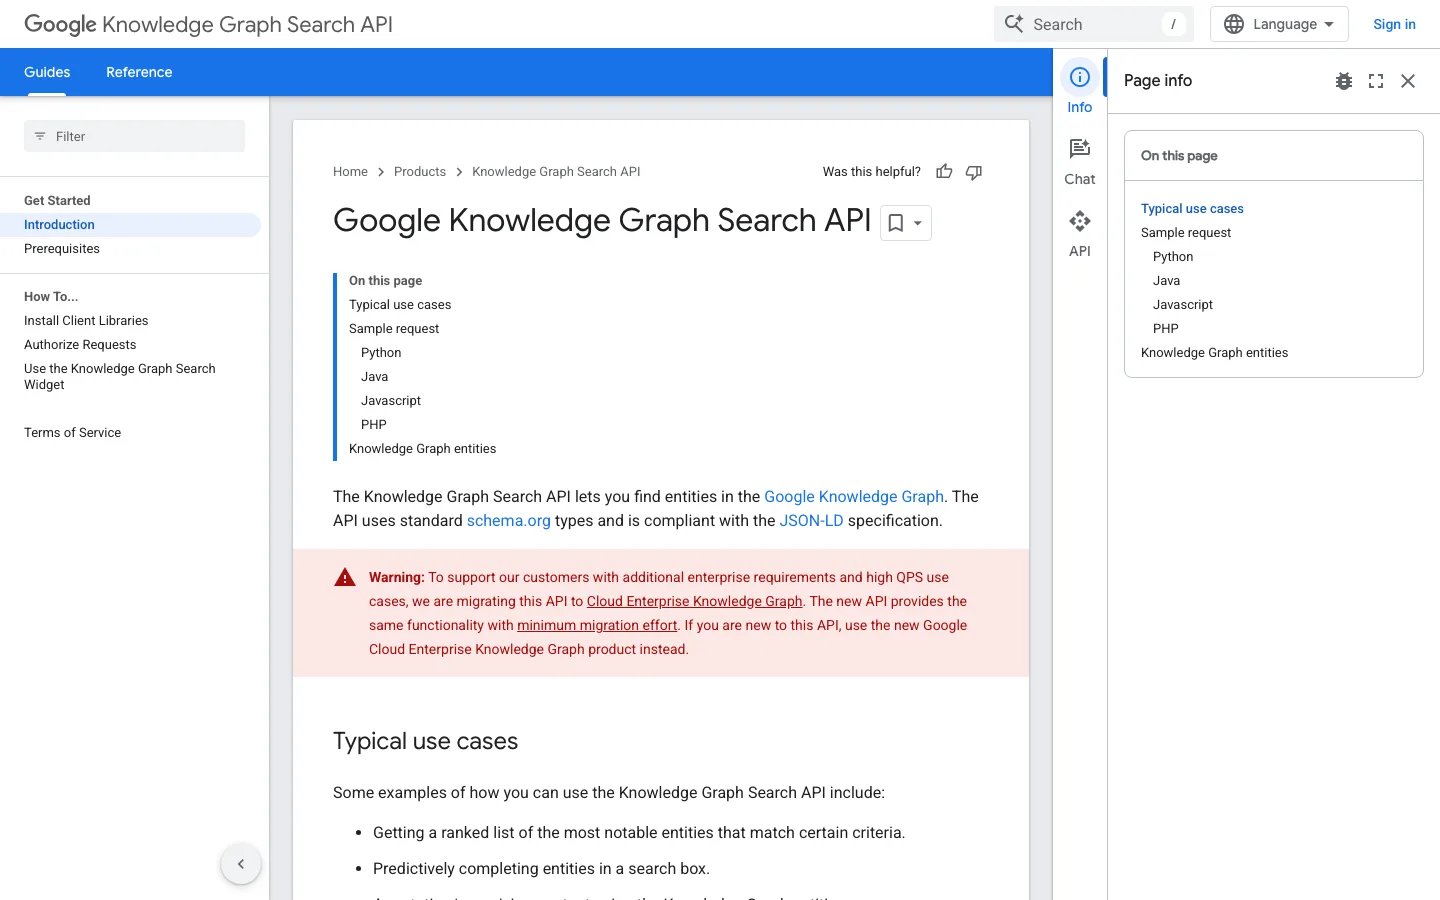
Anche gli sviluppatori possono interrogare il grafo di Google. La API Knowledge Graph Search permette di trovare entità nel Google Knowledge Graph, usa i tipi standard di schema.org e restituisce JSON-LD. La documentazione avverte inoltre che Google sta migrando questa API verso Cloud Enterprise Knowledge Graph, quindi verifica le opzioni attuali prima di costruirci sopra. La schermata qui sotto mostra la parte iniziale di quella pagina di documentazione.
Documentazione di Google sull'API Knowledge Graph Search (screenshot di developers.google.com).
Come GraphRAG combina un grafo con un modello linguistico?
La generazione aumentata dal recupero di solito trova passaggi di testo con una formulazione simile e lascia che sia il modello a metterli insieme. GraphRAG aggiunge un grafo di conoscenza a questo processo. Il sistema recupera un insieme collegato di entità e relazioni correlate e passa questa struttura al modello come contesto.
I vantaggi sono concreti. Un grafo che registra che un prodotto ha il pezzo A e il pezzo B permette al modello di elencare esattamente quei pezzi. Molte pipeline abbinano inoltre i grafi alla ricerca vettoriale: i vettori trovano testi simili e il grafo verifica come si collegano i fatti.
Come riducono i grafi di conoscenza le allucinazioni dell'IA?
I grafi di conoscenza riducono le allucinazioni dell'IA limitando una risposta alle relazioni già presenti nei dati. Quando il grafo non ha alcun collegamento tra due fatti, il modello ha meno margine per inventarne uno. L'effetto è più forte nelle domande precise, dove un collegamento sbagliato costa caro.
La struttura rende anche le risposte tracciabili. Ogni affermazione può essere ricondotta ai nodi e agli archi che la sostengono, così un team può verificare perché un sistema ha detto una certa cosa. Con una ricerca basata solo sul testo, questo percorso è molto più difficile da controllare. Un grafo, però, non elimina da solo gli errori: una tripla sbagliata produce una risposta sbagliata con la stessa sicurezza di una giusta.
Errori comuni con i grafi di conoscenza
Saltare l'ontologia: senza tipi di entità e regole condivise, la stessa idea viene salvata in più forme e il grafo perde coerenza.
Usare i nomi come identificatori: «Jaguar» può indicare una casa automobilistica o un animale, quindi ogni entità ha bisogno di un ID univoco prima che si aggiungano le sue relazioni.
Fatti in conflitto tra pagine diverse: se una pagina indica un anno di fondazione che un'altra contraddice, le macchine non possono capire quale dato sia affidabile.
Markup che non corrisponde alla pagina: i dati strutturati che descrivono fatti non mostrati nella pagina visibile rendono la pagina meno credibile.
Pensare che un grafo sostituisca i contenuti: un grafo organizza i fatti, ma le pagine devono comunque rispondere in modo chiaro alle domande che le persone cercano davvero.
Perché i grafi di conoscenza contano per la SEO e il GEO?
I grafi di conoscenza premiano i contenuti che le macchine possono scomporre in entità e relazioni. Quando le pagine nominano chiaramente le proprie entità, usano il markup schema e mantengono i fatti coerenti, motori di ricerca e sistemi di IA possono collegare il vostro marchio al grafo su cui si appoggiano. È l'idea centrale della SEO delle entità.
I grafi di conoscenza trasformano fatti sparsi in una struttura collegata su cui le macchine possono interrogare e ragionare, ed è per questo che stanno dietro a molte risposte accurate dell'IA. Codificando in modo esplicito entità e relazioni, riducono le allucinazioni, rendono possibile il ragionamento in più passaggi e rendono i risultati più facili da tracciare. Mantenete i vostri fatti coerenti e chiaramente denominati, così il vostro marchio si inserisce nei grafi che motori di ricerca e assistenti di IA già usano.
Qual è la differenza tra un grafo di conoscenza e un database normale?
Un database normale conserva i dati in tabelle e calcola le relazioni al momento della query. Un grafo di conoscenza conserva le relazioni come dati, quindi le connessioni possono essere percorse, aggiunte e spiegate direttamente.
Che cos'è GraphRAG e in cosa si differenzia dal RAG normale?
Il RAG normale trova passaggi di testo con una formulazione simile. GraphRAG aggiunge un grafo di conoscenza, così il sistema recupera un insieme collegato di entità e relazioni invece di frammenti isolati, e la risposta si basa su fatti strutturati.
I grafi di conoscenza aiutano i miei contenuti a essere citati dall'IA?
Indirettamente, sì. Le pagine con entità chiare, fatti coerenti e dati strutturati validi sono più facili da collegare ai grafi usati da motori di ricerca e sistemi di IA. Le informazioni chiare e affidabili hanno più probabilità di essere mostrate e citate.
“Ho testato Sorank sul sito reale di un cliente ed è pazzesco. Fa tutto quello che un'agenzia fa pagare 1.500 € al mese. Ora va in produzione su quel cliente.”Guillaume Guersanguersanguillaume.com
“Siamo un'agenzia pubblicitaria e volevamo rimettere in carreggiata il nostro SEO una volta per tutte. Sorank ci ha dato una visione chiara del nostro sito, ci ha aiutato a dare priorità alle ottimizzazioni e a strutturare correttamente i nostri contenuti. Lo strumento è facile da usare, ben progettato per un team e molto pratico per centralizzare il monitoraggio senza dover destreggiarsi tra più piattaforme. Una base molto solida per ripartire da zero con il nostro SEO.”Gaspard MadouiAgenzia Pubblicitaria
“Mi sono specializzata in GEO grazie a Sorank. Il GEO Leaderboard mi permette di mostrare ai miei clienti il loro posizionamento rispetto ai concorrenti su ChatGPT. È un vero differenziatore commerciale.”MélanieFreelancer SEO
“Ottimo servizio, funziona bene per il nostro sito web e ci aiuta a capire come migliorarlo per posizionarci meglio su Google e altrove. Complimenti, continuate così, ve lo consiglio.”Hugo T.Commerciante e-commerce