設定
当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら

当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら

ナレッジグラフは、AI が推論して事実を引用できるよう、エンティティと関係を保存します。その仕組み、GraphRAG を支える方法、GEO の可視性をどう形づくるかを学びましょう。






ツール


要約
ナレッジグラフとは、エンティティをノード、エンティティ間の関係をエッジとして保存する、ネットワーク型のデータ構造です。ばらばらのテキストの山ではなく、機械が推論に使える、つながった検索可能な事実の地図を提供します。
さらに詳しく知るには、こちらに質問
ナレッジグラフとは、エンティティとそれらの関係を表現する、グラフ構造のデータモデルです。情報を行と列で保存したり、独立した文書として保存したりする代わりに、事実同士の関係をとらえる、相互につながったノードと種類付きのエッジのネットワークとして整理します。
このつながった構造があるからこそ、ナレッジグラフは大規模言語モデルと組み合わせて使われることが増えています。AI システムに推論の材料となる関連事実の網を与え、正確性と説明可能性を高めます。ナレッジグラフを理解すると、現代の検索エンジンがどのように根拠のある回答を組み立てるのか、そして構造化された機械可読なコンテンツがなぜ可視性にとって重要なのかがはっきりします。
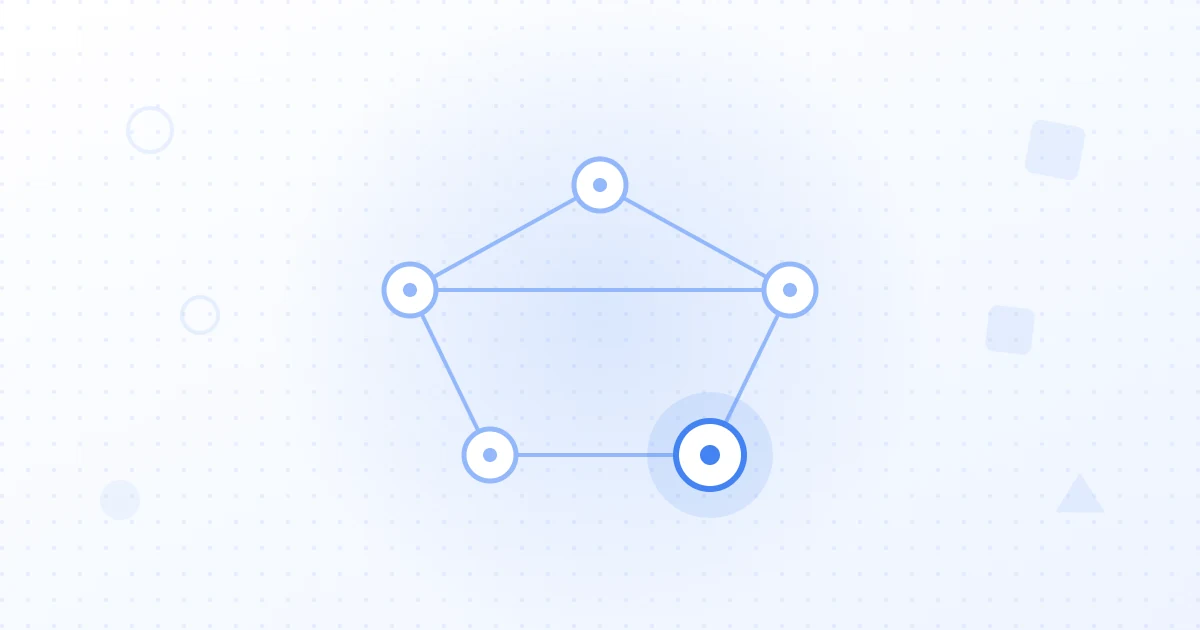
ナレッジグラフは、現実世界の知識をネットワークとして表現したもので、各ノードがエンティティ、各エッジがエンティティ間の関係です。エンティティは人、組織、製品、概念などで、エッジは「設立した」「所在地」「一部である」のように、それらのつながり方を表します。
関係そのものが一級のデータであり、読み手が推測しなければならないものではない点で、フラットなデータベースや文書のフォルダとは異なります。Google 自身のナレッジグラフが最も有名な例ですが、この概念は汎用的で、幅広い機械学習やデータシステムを支えています。
ナレッジグラフの基本単位はトリプルで、「企業 X の CEO は Y である」のように、主語、関係、目的語から成ります。多くのトリプルがつながってグラフを形づくります。ノードはエンティティを、エッジは種類付きの関係を保持し、プロパティは両者に説明的な属性を付け加えます。
オントロジーは設計図の役割を果たします。どのエンティティの種類が存在し、どの関係が許され、どんな論理的制約が適用されるか(たとえば、すべての注文には少なくとも一つの製品が含まれなければならない)を定義します。このスキーマがグラフの一貫性を保ち、ソフトウェアが推測ではなく確実にグラフを推論に使えるようにしています。
ナレッジグラフは通常、Neo4j、Amazon Neptune、あるいは GraphDB や Stardog のような RDF ストアなど、専用のグラフデータベースやトリプルストアに保存されます。これらのシステムは、関係のたどり、隣接ノードの探索、そして従来のリレーショナルデータベースでは遅くなるグラフクエリの実行に最適化されています。
大きな強みはマルチホップの探索です。データベースはあるノードから隣接ノードへ、さらにその隣接ノードへと移動でき、複数の事実をつなげる必要がある質問に自然に答えられます。この関係の連鎖をたどる能力が、グラフを複雑な推論に強いものにし、ベクトル検索とのハイブリッドにも自然に適したものにしています。
標準的な検索拡張生成(RAG)は、取得した文書を個別の構造化されていない塊として扱います。意味的な類似性を使って関連する一節を見つけ、それらを組み合わせる作業はモデルに任せます。単純な質問ならこれで機能しますが、多くの情報源に散らばった事実をつなげる必要がある回答では苦戦します。
ナレッジグラフは、欠けている構造を補います。通常の検索が似て見えるテキストを見つけるのに対し、グラフは事実が実際にどう関係しているかをエンコードしているため、システムは断片ではなく、つながった情報の網を取得できます。二つの手法は補完的で、現代の多くのパイプラインは両者を組み合わせています。
GraphRAG は、テキストの検索と並行してグラフベースの検索を統合します。質問に答える際、システムはナレッジグラフから関連するエンティティとそのつながりを取得し、その構造化された文脈をモデルに渡します。その結果、回答は明示的な事実に基づき、グラフ全体にわたるマルチホップの推論も可能になります。
これにはいくつかの利点があります。まず一貫性が高まります。ある製品に部品 A と部品 B があると知っているグラフなら、ハルシネーションを起こさず、まさにその部品だけを挙げられるからです。説明可能性も高まります。システムが回答を導くのに使ったノードとエッジをたどれるからです。さらにナレッジグラフは用語の曖昧さを解消し、関係を通じて自動車メーカーの Jaguar と動物のジャガーを区別します。
最大の魅力の一つは、誤った回答が減ることです。構造化され検証された関係に生成の根拠を置くことで、グラフはモデルが主張できる内容を制約し、AI のハルシネーションを直接減らします。グラフがすでにつながりをエンコードしているので、モデルは散らばった一節がどう組み合わさるかを推測する必要がなくなります。
同じ構造は、明確な推論の筋道も加えます。すべての回答を特定のノードとエッジまでさかのぼれるため、チームはシステムがなぜそう答えたかを監査でき、それが信頼を築きます。この説明可能性は、情報源から回答までの経路が不透明で検証しにくい、テキストだけの検索では実現が難しいものです。
ナレッジグラフは、機械がエンティティと関係に分解できるコンテンツを評価します。ページが構造化データと一貫した事実を使っていれば、検索エンジンや AI システムが頼るグラフに組み込まれやすくなり、表示され引用される可能性が高まります。これがエンティティ SEO の中核にある考え方です。
実務的には、エンティティをマークアップし、ページ間で事実を一貫させ、本物のトピックの深さを築いて、コンテンツがグラフにきれいに対応するようにすることです。これを質の高い構造化コンテンツや焦点を絞ったキーワード調査とコンテンツ計画と組み合わせれば、従来の検索エンジンと生成 AI の両方がブランドを理解し、信頼しやすくなります。
検索以外にも、ナレッジグラフはエージェント型の AI アシスタント、不正検知、セキュリティグラフ、金融コンプライアンスのマッピング、レコメンドシステムを支えています。いずれの場合も、その価値は、本来ならサイロに閉じ込められたままのデータをつなぎ、そのつながりを検索して洞察を引き出すことから生まれます。
特に言語モデルのアプリケーションでは、誤ったつながりが大きな損失につながる、精度が重要なタスクでグラフが真価を発揮します。複雑な分野での質問応答、多くのシステムにまたがる企業内検索、一貫して監査可能な回答を求められるチャットボットは、いずれもモデルの背後にグラフのレイヤーを置くことで恩恵を受けます。
ナレッジグラフは、散らばった事実を、機械が推論に使えるつながった検索可能な構造に変えます。だからこそ、信頼できる AI の回答の背後に置かれることが増えています。エンティティと関係を明示的にエンコードすることで、ハルシネーションを減らし、マルチホップの推論を支え、結果を説明可能にします。
さらに踏み込むには、これを検索拡張生成(RAG)やエンティティ SEO と結びつけ、構造化された事実が根拠のある AI と検索での可視性の両方をどう動かすかを理解しましょう。参考資料:IBM、GoodData。
出典

通常のデータベースはデータを行と列で保存し、関係はクエリの時点で結合するものとして扱います。ナレッジグラフは関係を第一級のデータとして、エンティティのノード間のラベル付きの線として保存します。これにより、つながりをたどり、複数の段階をまたぐ質問に答え、分野全体で事実同士がどう関係するかを推論することがはるかに容易になります。
通常の検索拡張生成は、意味の類似度で文章を見つけ、モデルにそれを組み立てさせます。GraphRAG はナレッジグラフを加えるので、システムは孤立した断片ではなく、関連するエンティティと関係のつながった網を取り出します。これにより、答えが構造化された事実に基づき、複数の段階の推論が可能になり、複雑な質問でのハルシネーションが減ります。
間接的には役立ちます。明確なエンティティ、構造化データ、一貫した事実を持つコンテンツは、エンジンと AI のシステムが答えの根拠に使うグラフに対応づけやすくなります。情報が機械に読めて信頼できるものであれば、表示され引用される可能性が高まり、それはエンティティに基づく最適化と生成AI最適化の中心的な目標です。
先行導入企業のご紹介
 “2年間、クライアントの100%がLinkedIn経由でした。毎日の投稿、コメント、DMでのフォローアップ…完全にアルゴリズム頼みでした。SEOに取り組むべきだとわかっていても、時間がかかる、技術的すぎる、自分の仕事ではないと、いつも後回しにしていました。Sorankでようやく一歩を踏み出しました。4か月で、何も投稿しなくても毎月15件のオーガニックリードを獲得しています。まだLinkedInと半々ではありませんが、自動で育つ2つ目のリード源ができたことで安心して眠れるようになりました。”
 Valentin Thomyコールドメール専門エージェンシー“Sorankは、クライアントに提供する成果を大きく変えてくれました。AIが実際に使っているキーワードを特定し、特定の競合が引用される理由を理解し、以前は完全に見落としていたチャンスを見つけられるようになりました。クライアントは、より早い順位上昇、AIの回答での可視性向上、そしてすべての施策のROIがより明確になったことを実感しています。”

 Benjamin Rouxovirank.com
 “私はマーケターではなく開発者です。私のShopifyテーマは口コミと広告だけで売れていました。Sorankのおかげで、SEOの組み立て方と上位表示される記事の書き方がようやくわかりました。監査で商品ページが遅すぎることも判明しました。2か月でオーガニックトラフィックは2倍になり、ShopifyテーマについてChatGPTで検索されたときの回答にも表示され始めています。しかも、週に約2時間の作業だけです。”

 Thème FullStackthemefullstack.com“Sorankのおかげで、私たちのSEOエージェンシーの働き方は大きく変わりました。すべてが一元化・自動化されたため、クライアント1社あたりにかける時間が大幅に減りました。以前は何時間もかかっていた作業が今では数分で終わり、ようやくビジネスの中で働くのではなく、ビジネスそのものに取り組めるようになりました。”

 Océane Bondismaison-leverage.com