La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Merci ! Vos choix ont bien été enregistrés.
Oups ! Une erreur s'est produite lors de l'envoi du formulaire.
Graphes de connaissances : comment des faits structurés ancrent les réponses des IA en 2027
Les graphes de connaissances stockent entités et relations sous forme de faits reliés que les IA peuvent interroger. Fonctionnement et enjeux pour le GEO.
Vous êtes inscrit à la newsletter !
Oups ! Une erreur s'est produite lors de l'envoi du formulaire.
Les graphes de connaissances sont des réseaux d'entités, comme des personnes, des entreprises ou des produits, reliées par des relations nommées. Les machines interrogent ces liens pour raisonner sur des faits au lieu de comparer des textes approximatifs. Les réponses gagnent ainsi en exactitude et en traçabilité, et les moteurs de recherche et les IA peuvent plus facilement les citer.
Les graphes de connaissances stockent l'information sous forme de réseau, et non de lignes et de colonnes. Chaque nœud est une entité, chaque lien est une relation entre deux entités, et les deux peuvent porter des attributs descriptifs. Le résultat est une carte de faits que les logiciels peuvent suivre, interroger et vérifier, ce qui explique pourquoi les moteurs de recherche et les assistants d'IA s'appuient sur cette idée.
Qu'est-ce qu'un graphe de connaissances ?
Un graphe de connaissances est un jeu de données connectées sur des choses du monde réel et sur les liens qui les unissent. Ces choses, appelées entités, peuvent être des personnes, des entreprises, des produits, des lieux ou des concepts. L'exemple le plus connu est le Google Knowledge Graph, mais le modèle est général : il sert aussi aux données d'entreprise, aux bases de recherche et aux systèmes de recherche interne.
Google a présenté son graphe en mai 2012 comme un modèle qui comprend les choses et leurs relations, et pas seulement des chaînes de caractères. Dans son article de lancement, Google indiquait que le graphe contenait plus de 500 millions d'objets et plus de 3,5 milliards de faits à leur sujet, ainsi que les relations entre eux.
Comment fonctionnent les nœuds, les arêtes et les triplets ?
L'unité de base est le triplet, une affirmation composée d'un sujet, d'un prédicat et d'un objet. Le W3C RDF 1.1 Primer explique que les énoncés RDF se composent de trois éléments, appelés triplets, et que les sujets et les objets deviennent les nœuds du graphe, tandis que les prédicats en forment les arcs.
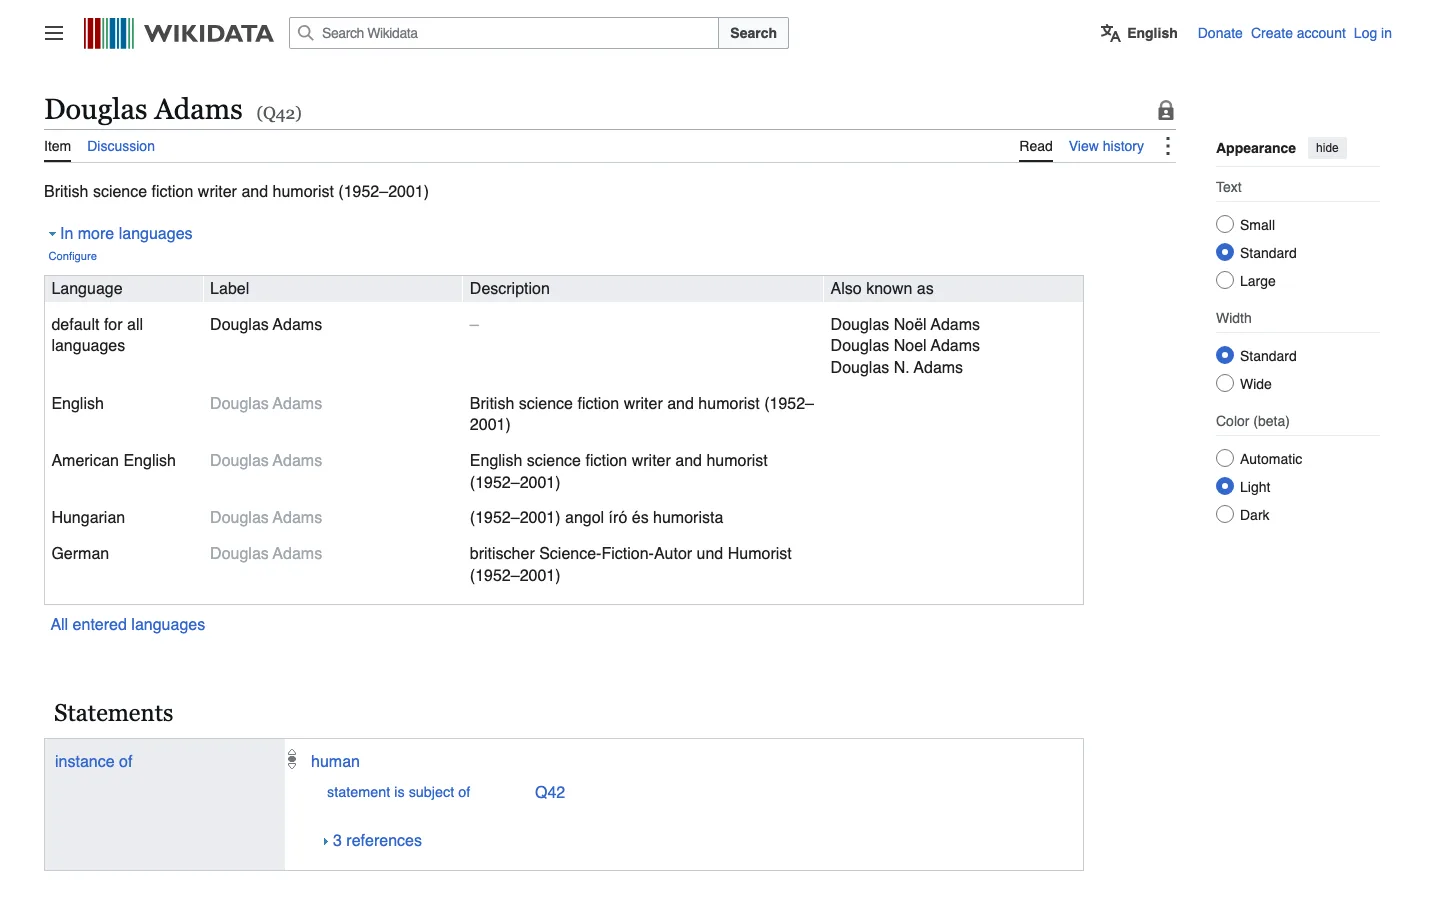
Un triplet se lit comme une courte phrase. La capture ci-dessous montre la fiche publique de Wikidata consacrée à l'écrivain Douglas Adams, où l'affirmation « instance de : humain » relie une entité à une catégorie plus large. Le même élément peut être relié à de nombreuses autres entités, et chaque lien ajoute une arête au graphe.
Une fiche publique de Wikidata montre un triplet : le sujet Douglas Adams, le prédicat instance de et l'objet humain (capture d'écran de wikidata.org).
Une ontologie est le plan du graphe. Elle définit les types d'entités qui existent, les relations autorisées et les règles qui s'appliquent, par exemple qu'une commande doit contenir au moins un produit. Cela garde le graphe cohérent, pour qu'un logiciel puisse raisonner dessus au lieu de deviner.
Comment les graphes de connaissances sont-ils stockés et interrogés ?
Les graphes de connaissances vivent en général dans des bases de graphes ou des triplestores, comme Neo4j, Amazon Neptune ou GraphDB. Ces systèmes sont conçus pour passer d'un nœud à ses voisins, puis aux voisins de ceux-ci, ce qui se prête mal à une base relationnelle classique quand la chaîne de relations est longue.
Ce parcours de proche en proche est la principale force d'un graphe. Une question du type « quels fournisseurs d'un produit servent aussi un concurrent ? » demande plusieurs jointures dans un modèle en tables, alors qu'un graphe suit simplement les arêtes entre les nœuds concernés.
En quoi un graphe de connaissances diffère-t-il d'une base de données classique ?
Une base classique range les données dans des tables et traite les relations comme des jointures calculées au moment de la requête. Un graphe de connaissances stocke les relations comme des données à part entière, si bien qu'elles peuvent être parcourues, ajoutées et expliquées directement. Les moteurs de recherche et les systèmes d'IA s'en servent pour répondre aux questions qui dépendent de la façon dont plusieurs faits se relient.
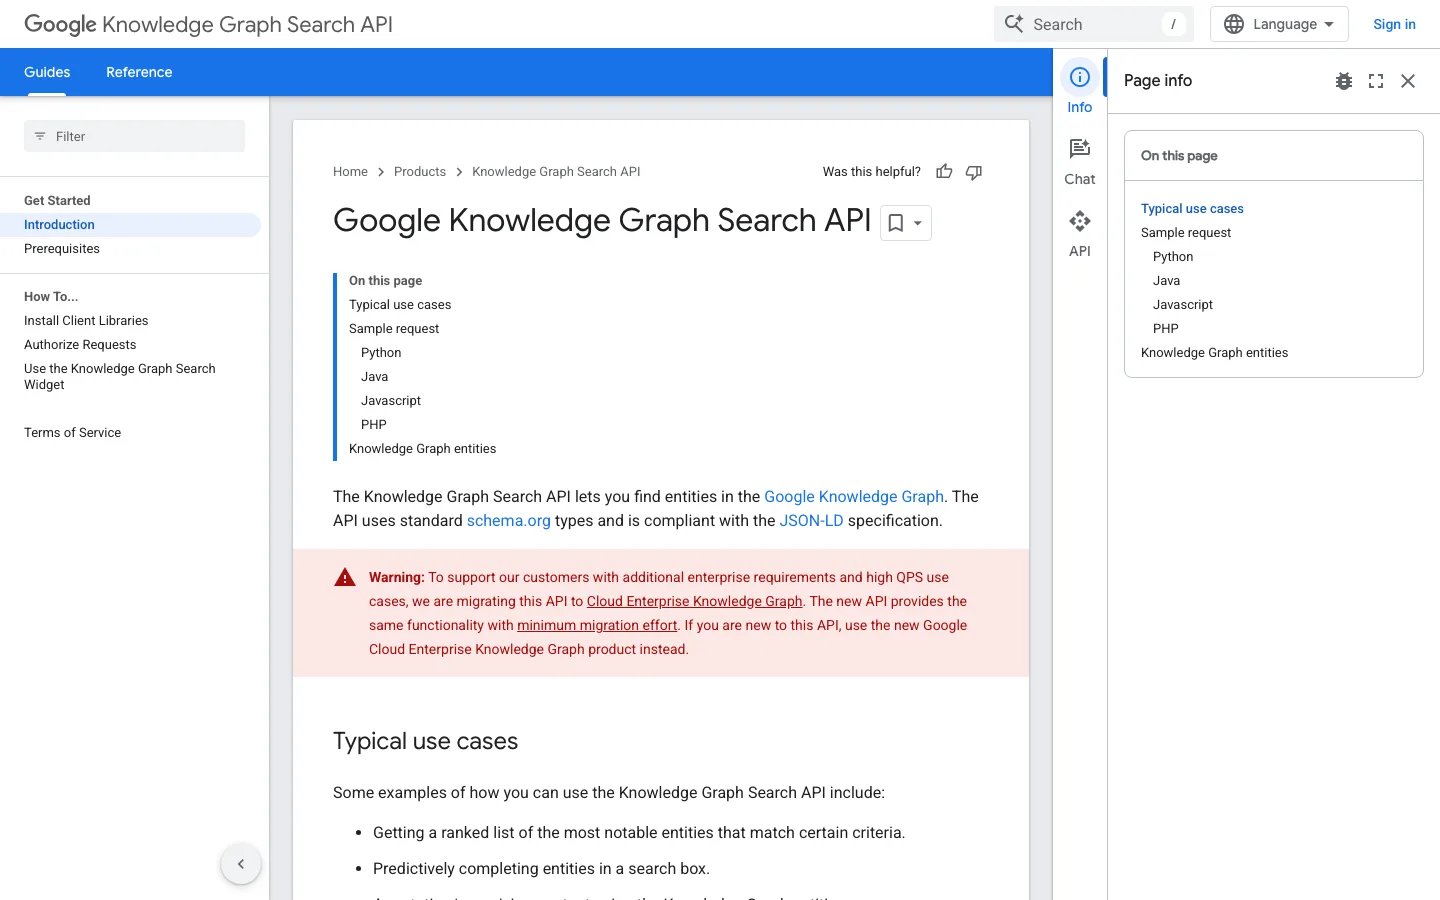
Les développeurs peuvent aussi interroger le graphe de Google. L'API Knowledge Graph Search permet de trouver des entités du Google Knowledge Graph ; elle utilise les types standard de schema.org et renvoie du JSON-LD. La documentation signale aussi que Google migre cette API vers Cloud Enterprise Knowledge Graph : vérifiez donc les options actuelles avant de vous y appuyer. La capture ci-dessous montre le haut de cette page de documentation.
Documentation de Google pour l'API Knowledge Graph Search (capture d'écran de developers.google.com).
Comment le GraphRAG combine-t-il un graphe et un modèle de langage ?
La génération augmentée par la récupération trouve en général des passages à la formulation proche et laisse le modèle les assembler. Le GraphRAG ajoute un graphe de connaissances à ce processus. Le système récupère un ensemble connecté d'entités et de relations, puis transmet cette structure au modèle comme contexte.
Les bénéfices sont concrets. Un graphe qui enregistre qu'un produit comporte la pièce A et la pièce B permet au modèle de lister exactement ces pièces. Beaucoup de chaînes associent aussi les graphes à la recherche vectorielle : les représentations vectorielles repèrent les textes similaires, et le graphe vérifie comment les faits se relient.
Comment les graphes de connaissances réduisent-ils les hallucinations de l'IA ?
Les graphes de connaissances réduisent les hallucinations de l'IA en limitant une réponse aux relations qui existent déjà dans les données. Quand le graphe ne contient aucun lien entre deux faits, le modèle a moins de marge pour en inventer un. L'effet est le plus net sur les questions précises, où un mauvais lien coûte cher.
La structure rend aussi les réponses traçables. Chaque affirmation peut être rattachée aux nœuds et aux arêtes qui la soutiennent, de sorte qu'une équipe peut vérifier pourquoi un système a dit ce qu'il a dit. Une recherche fondée uniquement sur le texte rend ce chemin beaucoup plus difficile à vérifier. Un graphe n'élimine pas les erreurs à lui seul : un triplet faux produit une réponse fausse, avec la même assurance qu'une réponse juste.
Erreurs courantes avec les graphes de connaissances
Se passer de l'ontologie : sans types d'entités ni règles convenus, la même idée finit stockée sous plusieurs formes et le graphe perd sa cohérence.
Utiliser des noms comme identifiants : « Jaguar » peut désigner un constructeur automobile ou un animal, donc chaque entité a besoin de son propre identifiant unique avant l'ajout de ses relations.
Des faits contradictoires d'une page à l'autre : si une page donne une année de fondation qu'une autre page contredit, les machines ne savent pas quel fait retenir.
Un balisage qui ne correspond pas à la page : des données structurées qui décrivent des faits absents de la page visible rendent cette page moins digne de confiance.
Croire qu'un graphe remplace le contenu : un graphe organise les faits, mais vos pages doivent toujours répondre clairement aux questions que les gens tapent réellement.
Pourquoi les graphes de connaissances comptent-ils pour le SEO et le GEO ?
Les graphes de connaissances récompensent les contenus que les machines peuvent découper en entités et en relations. Quand vos pages nomment clairement leurs entités, utilisent le balisage schema et gardent des faits cohérents, les moteurs de recherche et les IA peuvent rattacher votre marque au graphe sur lequel elles s'appuient. C'est l'idée centrale du SEO des entités.
Les graphes de connaissances transforment des faits dispersés en une structure connectée que les machines peuvent interroger et sur laquelle elles peuvent raisonner, c'est pourquoi ils se trouvent derrière de nombreuses réponses exactes des IA. En codant explicitement les entités et les relations, ils réduisent les hallucinations, facilitent le raisonnement en plusieurs étapes et rendent les résultats plus faciles à retracer. Gardez vos propres faits cohérents et clairement nommés, pour que votre marque s'intègre aux graphes que les moteurs de recherche et les assistants d'IA utilisent déjà.
Quelle différence entre un graphe de connaissances et une base de données classique ?
Une base classique range les données dans des tables et calcule les relations au moment de la requête. Un graphe de connaissances stocke les relations comme des données, ce qui permet de les parcourir, de les ajouter et de les expliquer directement.
Qu'est-ce que le GraphRAG et en quoi se distingue-t-il du RAG classique ?
Le RAG classique retrouve des passages de texte à la formulation proche. Le GraphRAG ajoute un graphe de connaissances : le système récupère un ensemble connecté d'entités et de relations au lieu d'extraits isolés, et la réponse s'appuie sur des faits structurés.
Un graphe de connaissances aide-t-il votre contenu à être cité par les IA ?
Indirectement, oui. Les pages avec des entités claires, des faits cohérents et des données structurées valides sont plus faciles à rattacher aux graphes qu'utilisent les moteurs de recherche et les IA. Une information claire et fiable a plus de chances d'être reprise et citée.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
Dominiqueflight-sensations-idf.comLoisirs et aviation
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne