העדפות
הפרטיות חשובה לנו, ולכן יש לך אפשרות להשבית סוגים מסוימים של אחסון שייתכן שאינם נחוצים לתפקוד הבסיסי של האתר. חסימת קטגוריות עלולה להשפיע על חווית השימוש שלך באתר. מידע נוסף
הפרטיות חשובה לנו, ולכן יש לך אפשרות להשבית סוגים מסוימים של אחסון שייתכן שאינם נחוצים לתפקוד הבסיסי של האתר. חסימת קטגוריות עלולה להשפיע על חווית השימוש שלך באתר. מידע נוסף

גרפי ידע שומרים ישויות ויחסים כעובדות מקושרות שבינה מלאכותית יכולה לשאול. איך הם פועלים, איך GraphRAG משתמש בהם ומה המשמעות שלהם ל-GEO.







מייסד Sorank, 7+ שנים ב-SEO.
סיכום
גרפי ידע הם רשתות של ישויות, כמו אנשים, חברות או מוצרים, המקושרות ביניהן באמצעות יחסים בעלי שם. מכונות שואלות את הקשרים האלה כדי להסיק מסקנות על עובדות, במקום להשוות טקסטים מעורפלים. כך התשובות מדויקות יותר וקלות יותר למעקב, ומנועי חיפוש ומערכות בינה מלאכותית יכולים לצטט אותן בקלות רבה יותר.
רוצים להעמיק? שאלו את
גרפי ידע שומרים מידע כרשת ולא בשורות ועמודות. כל צומת הוא ישות, וכל קשת היא יחס בין שתי ישויות, ולשניהם יכולים להיות מאפיינים תיאוריים. התוצאה היא מפה של עובדות שתוכנה יכולה לעבור עליה, לשאול אותה ולבדוק אותה, וזו הסיבה שמנועי חיפוש ועוזרי בינה מלאכותית נשענים על הרעיון הזה.
גרף ידע הוא מערך נתונים מקושר על דברים מהעולם האמיתי ועל הדרכים שבהן הם קשורים זה לזה. הדברים האלה, שנקראים ישויות, יכולים להיות אנשים, חברות, מוצרים, מקומות או מושגים. הדוגמה המוכרת ביותר היא Google Knowledge Graph, אבל המודל כללי ומשמש גם לנתוני חברות, למאגרי מחקר ולמערכות חיפוש פנימיות.
גוגל הציגה את הגרף שלה במאי 2012 כמודל שמבין דברים ויחסים ביניהם, ולא רק מחרוזות טקסט. בהכרזה שלה כתבה גוגל שהגרף מכיל יותר מ-500 מיליון אובייקטים ויותר מ-3.5 מיליארד עובדות עליהם ועל היחסים ביניהם.
היחידה הבסיסית היא השלשה, טענה שמורכבת מנושא, פרדיקט ואובייקט. המדריך W3C RDF 1.1 Primer מסביר שטענות RDF מורכבות משלושה רכיבים, שנקראים שלשות, וששושאים ואובייקטים הופכים לצמתים בגרף, בעוד שהפרדיקטים הם הקשתות ביניהם.
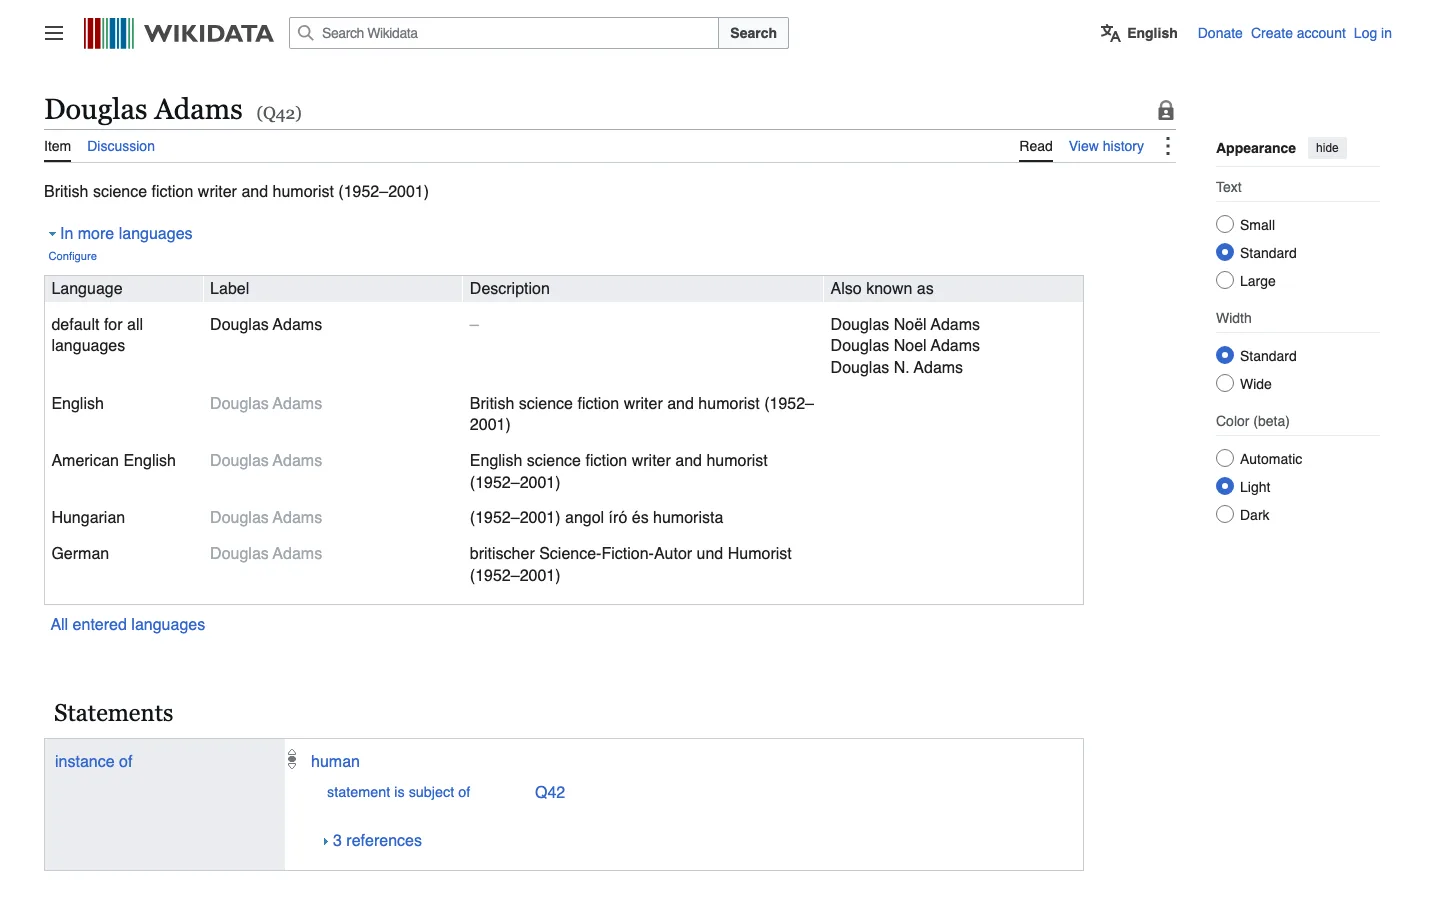
שלשה נקראת כמו משפט קצר. צילום המסך שלמטה מציג את דף הפריט הציבורי של Wikidata על הסופר דאגלס אדמס, שבו הטענה "מופע של: אדם" מקשרת ישות לקטגוריה רחבה יותר. אותה ישות יכולה להיות מקושרת לישויות רבות אחרות, וכל קישור מוסיף קשת נוספת לגרף.
אונטולוגיה היא התוכנית של הגרף. היא מגדירה אילו סוגי ישויות קיימים, אילו יחסים מותרים ואילו כללים חלים, למשל שכל הזמנה חייבת להכיל לפחות מוצר אחד. כך הגרף נשאר עקבי, והתוכנה יכולה להסיק ממנו מסקנות במקום לנחש.
גרפי ידע יושבים בדרך כלל במסדי נתונים מסוג גרף או ב-triplestores, כמו Neo4j, Amazon Neptune או GraphDB. המערכות האלה בנויות לעבור מצומת לשכניו, ומשם לשכנים של השכנים, ודבר כזה קשה לביטוי במסד נתונים יחסי כשרשרת היחסים ארוכה.
המעבר הזה על פני כמה קפיצות הוא החוזק המרכזי של גרף. שאלה כמו "אילו ספקים של מוצר משרתים גם מתחרה?" דורשת כמה חיבורים במודל של טבלאות, בעוד שגרף פשוט עוקב אחרי הקשתות בין הצמתים הרלוונטיים.
מסד נתונים רגיל שומר נתונים בטבלאות ומתייחס ליחסים כאל חיבורים שמחושבים בזמן השאילתה. גרף ידע שומר את היחסים כנתונים בפני עצמם, כך שאפשר לעבור על הקשרים, להוסיף אותם ולהסביר אותם ישירות. מנועי חיפוש ומערכות בינה מלאכותית משתמשים בזה כדי לענות על שאלות שתלויות באופן שבו כמה עובדות מתחברות.
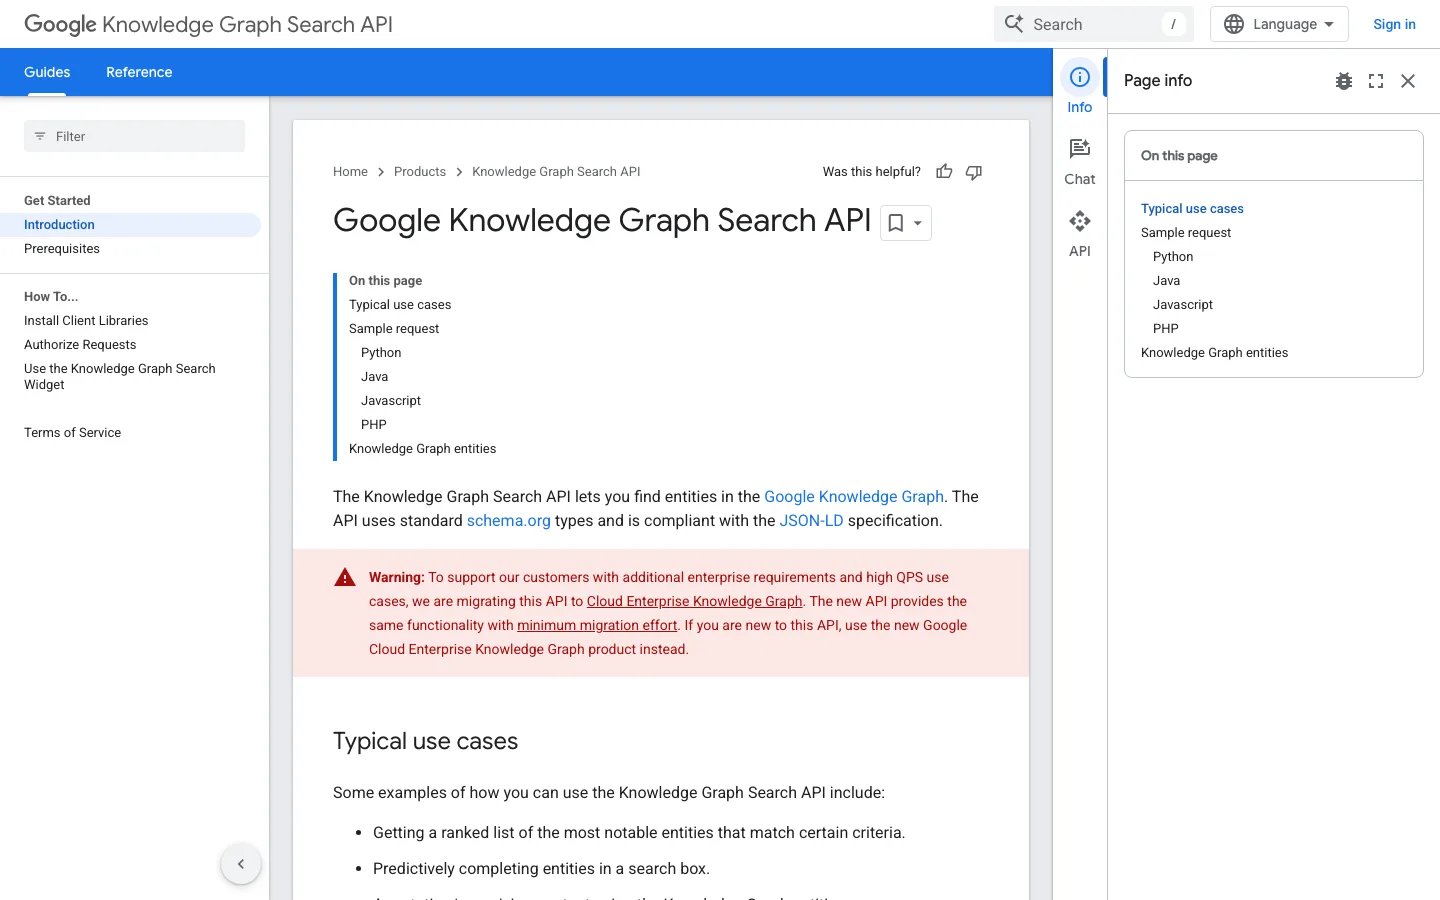
מפתחים יכולים גם לשאול את הגרף של גוגל. ממשק ה-API של Knowledge Graph Search מאפשר למצוא ישויות ב-Google Knowledge Graph, משתמש בסוגים הסטנדרטיים של schema.org ומחזיר JSON-LD. התיעוד גם מזהיר שגוגל מעבירה את הממשק הזה ל-Cloud Enterprise Knowledge Graph, ולכן כדאי לבדוק את האפשרויות העדכניות לפני שבונים עליו. צילום המסך שלמטה מציג את החלק העליון של דף התיעוד הזה.
יצירה מוגברת באמצעות אחזור מוצאת בדרך כלל קטעי טקסט עם ניסוח דומה ותנו למודל להרכיב אותם. GraphRAG מוסיף לתהליך הזה גרף ידע. המערכת שולפת קבוצה מקושרת של ישויות ויחסים רלוונטיים, ומעבירה את המבנה הזה למודל כהקשר.
היתרונות מעשיים. גרף שרושם שמוצר מכיל את החלק A ואת החלק B מאפשר למודל לפרט בדיוק את החלקים האלה. צינורות רבים גם משלבים גרפים עם חיפוש וקטורי: הווקטורים מוצאים טקסטים דומים, והגרף בודק איך העובדות מתחברות.
גרפי ידע מפחיתים הזיות של בינה מלאכותית בכך שהם מגבילים תשובה ליחסים שכבר קיימים בנתונים. כשאין בגרף קישור בין שתי עובדות, למודל יש פחות מקום להמציא אחד. ההשפעה חזקה במיוחד בשאלות מדויקות, שבהן קישור שגוי עולה ביוקר.
המבנה גם הופך את התשובות לניתנות למעקב. כל טענה אפשר לקשר לצמתים ולקשתות שתומכים בה, כך שצוות יכול לבדוק למה מערכת אמרה את מה שאמרה. בחיפוש שמבוסס על טקסט בלבד, הדרך הזו קשה הרבה יותר לאימות. עם זאת, גרף לא מבטל טעויות בעצמו: שלשה שגויה מייצרת תשובה שגויה באותה ודאות כמו תשובה נכונה.
גרפי ידע מתגמלים תוכן שמכונות יכולות לפרק לישויות ויחסים. כשהעמודים שלכם מציינים בבירור את הישויות שלהם, משתמשים בסימון schema ושומרים על עובדות עקביות, מנועי חיפוש ומערכות בינה מלאכותית יכולים לשייך את המותג שלכם לגרף שעליו הם נשענים. זו הרעיון המרכזי של Entity SEO.
בפועל, תארו את הארגון, המוצרים והכותבים שלכם עם אותן עובדות בכל מקום שבו הם מופיעים, ואחר כך בדקו את התוצאה עם בודק הנתונים המובנים החינמי של Sorank. כדי להבין איך סימון משפיע על תשובות הבינה המלאכותית, קראו את מה באמת עוזר לנתונים מובנים בחיפוש עם בינה מלאכותית.
גרפי ידע הופכים עובדות מפוזרות למבנה מקושר שמכונות יכולות לשאול ולהסיק ממנו, וזו הסיבה שהם עומדים מאחורי תשובות מדויקות רבות של בינה מלאכותית. על ידי קידוד מפורש של ישויות ויחסים, הם מפחיתים הזיות, מאפשרים הסקה בכמה שלבים והופכים את התוצאות לקלות יותר למעקב. שמרו על העובדות שלכם עקביות ובעלות שמות ברורים, כדי שהמותג שלכם יתאים לגרפים שמנועי חיפוש ועוזרי בינה מלאכותית כבר משתמשים בהם.
מקורות
מסד נתונים רגיל שומר נתונים בטבלאות ומחשב את היחסים בזמן השאילתה. גרף ידע שומר את היחסים כנתונים, כך שאפשר לעבור על הקשרים, להוסיף אותם ולהסביר אותם ישירות.
RAG רגיל מוצא קטעי טקסט עם ניסוח דומה. GraphRAG מוסיף גרף ידע, כך שהמערכת שולפת קבוצה מקושרת של ישויות ויחסים במקום קטעים מבודדים, והתשובה נשענת על עובדות מובנות.
בעקיפין, כן. עמודים עם ישויות ברורות, עובדות עקביות ונתונים מובנים תקפים קלים יותר לשייך לגרפים שמנועי חיפוש ומערכות בינה מלאכותית משתמשים בהם. מידע ברור ואמין סביר יותר להופיע ולהצוטט.
 “אנחנו סוכנות פרסום (Ads) ורצינו סוף סוף להחזיר את ה-SEO שלנו למסלול. Sorank נתנה לנו תמונה ברורה של האתר שלנו, עזרה לנו לתעדף אופטימיזציות ולבנות נכון את התוכן. הכלי קל לשימוש, מעוצב היטב לעבודת צוות, ומאוד מעשי לריכוז המעקב בלי לקפוץ בין מספר פלטפורמות. בסיס איתן מאוד לפתיחת דף חדש עם ה-SEO שלנו.”
 Gaspard Madouiסוכנות פרסום (Ads)“במשך שנתיים, 100% מהלקוחות שלי הגיעו מ-LinkedIn. פרסום יומי, תגובות, מעקבים בהודעות פרטיות... תלות מוחלטת באלגוריתם. ידעתי שאני צריך לעבוד על SEO אבל תמיד דחיתי את זה: ארוך מדי, טכני מדי, לא התחום שלי. עם Sorank, סוף סוף עשיתי את הצעד. בתוך 4 חודשים, אני מייצר 15 לידים אורגניים בחודש בלי לפרסם כלום. זה עדיין לא 50/50 מול LinkedIn, אבל אני ישן טוב יותר בידיעה שיש לי עכשיו מקור לידים שני שגדל באופן אוטומטי.”

 Valentin Thomyoffbound.fr
 “פשוט נתתי לתוכנה של Sorank לעשות את שלה, ועכשיו ציון DR של האתר שלי הוא 25 והדף שלי מדורג גבוה יותר.”
 Lucas Flandrefoundertrace.fr“פתרון מצוין לניהול SEO בלי כאב ראש. הביקורות מהירות, הממשק ברור, ואתה רואה במהירות אילו פעולות ליישם. זה הפך לכלי חיוני למעקב ולשיפור ה-SEO של האתרים שלי. ממליץ בחום.”
 Xavיזם