Integritet är viktigt för oss, så du kan välja att inaktivera vissa typer av lagring som kanske inte är nödvändig för webbplatsens grundläggande funktioner. Om du blockerar kategorier kan det påverka din upplevelse av webbplatsen. Mer information (Cookiepolicy)
Kunskapsgrafer: hur strukturerade fakta förankrar AI-svar 2027
Kunskapsgrafer lagrar entiteter och relationer som sammankopplade fakta som AI kan söka i. Hur de fungerar, hur GraphRAG använder dem och vad de betyder för GEO.
Kunskapsgrafer är nätverk av entiteter, till exempel personer, företag eller produkter, som är kopplade med namngivna relationer. Maskiner söker i dessa kopplingar för att resonera kring fakta i stället för att matcha lösa texter. Svaren blir därmed mer träffsäkra, lättare att spåra och lättare för sökmotorer och AI-system att citera.
Kunskapsgrafer lagrar information som ett nätverk i stället för rader och kolumner. Varje nod är en entitet, varje kant är en relation mellan två entiteter, och båda kan bära beskrivande attribut. Resultatet är en karta över fakta som programvara kan följa, söka i och kontrollera, och därför bygger sökmotorer och AI-assistenter på idén.
Vad är en kunskapsgraf?
En kunskapsgraf är en sammankopplad datamängd om saker i verkligheten och hur de hänger ihop. Sakerna, som kallas entiteter, kan vara personer, företag, produkter, platser eller begrepp. Det mest kända exemplet är Google Knowledge Graph, men modellen är generell och används även för företagsdata, forskningsdatabaser och interna söksystem.
Google presenterade sin graf i maj 2012 som en modell som förstår saker och deras relationer, inte bara textsträngar. I lanseringsinlägget skrev Google att grafen innehöll mer än 500 miljoner objekt och mer än 3,5 miljarder fakta om dem och om relationerna mellan dem.
Hur fungerar noder, kanter och tripplar?
Den grundläggande enheten är trippeln: ett påstående bestående av ett subjekt, ett predikat och ett objekt. W3C:s introduktion till RDF 1.1 förklarar att RDF-påståenden består av tre delar, kallade tripplar, och att subjekt och objekt blir grafens noder medan predikat blir bågarna mellan dem.
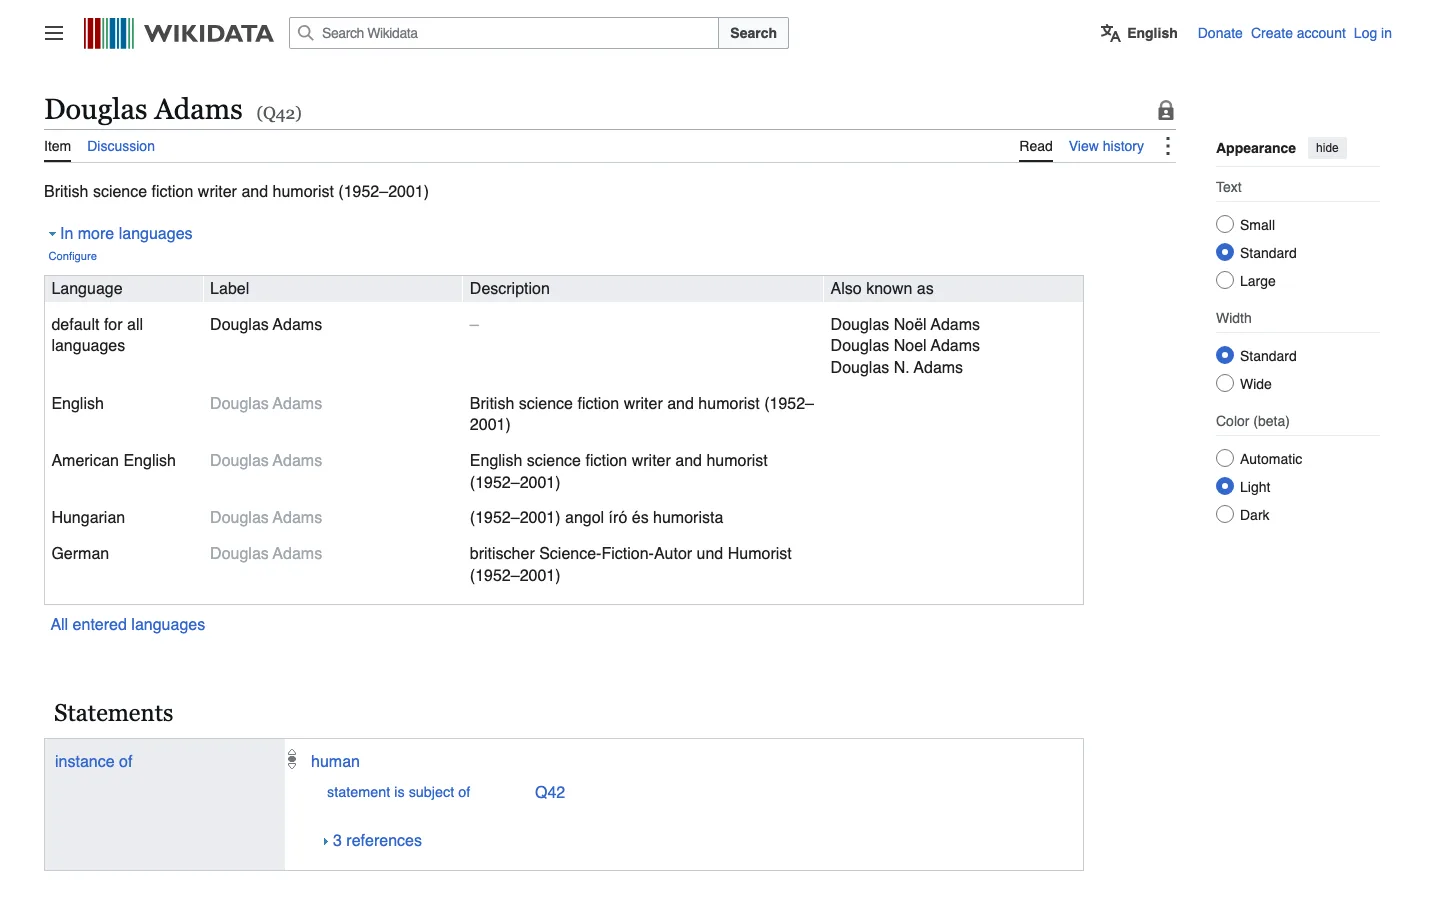
En trippel läses som en kort mening. Bilden nedan visar den offentliga Wikidata-posten för författaren Douglas Adams, där påståendet "instans av: människa" kopplar en entitet till en bredare kategori. Samma post kan kopplas till många andra entiteter, och varje koppling lägger till en ny kant i grafen.
En offentlig Wikidata-post visar en trippel: subjektet Douglas Adams, predikatet instans av och objektet människa (skärmbild från wikidata.org).
En ontologi är grafens ritning. Den definierar vilka typer av entiteter som finns, vilka relationer som är tillåtna och vilka regler som gäller, till exempel att varje order måste innehålla minst en produkt. Det håller grafen konsekvent, så att programvara kan resonera över den i stället för att gissa.
Hur lagras och söks kunskapsgrafer?
Kunskapsgrafer ligger oftast i grafdatabaser eller tripelbutiker, till exempel Neo4j, Amazon Neptune eller GraphDB. Dessa system är byggda för att gå från en nod till dess grannar, sedan till deras grannar, något som är krångligt att uttrycka i en traditionell relationsdatabas när kedjan av relationer är lång.
Denna genomgång i flera steg är grafens största styrka. En fråga som vilka leverantörer av en produkt också levererar till en konkurrent kräver flera sammanfogningar i en tabellmodell, medan en graf helt enkelt följer kanterna mellan de inblandade noderna.
Hur skiljer sig kunskapsgrafer från en vanlig databas?
En vanlig databas lagrar data i tabeller och behandlar relationer som sammanfogningar som beräknas när en fråga körs. En kunskapsgraf lagrar relationerna som data i sig, så att kopplingar kan följas, läggas till och förklaras direkt. Sökmotorer och AI-system använder detta för att svara på frågor som beror på hur flera fakta hänger ihop.
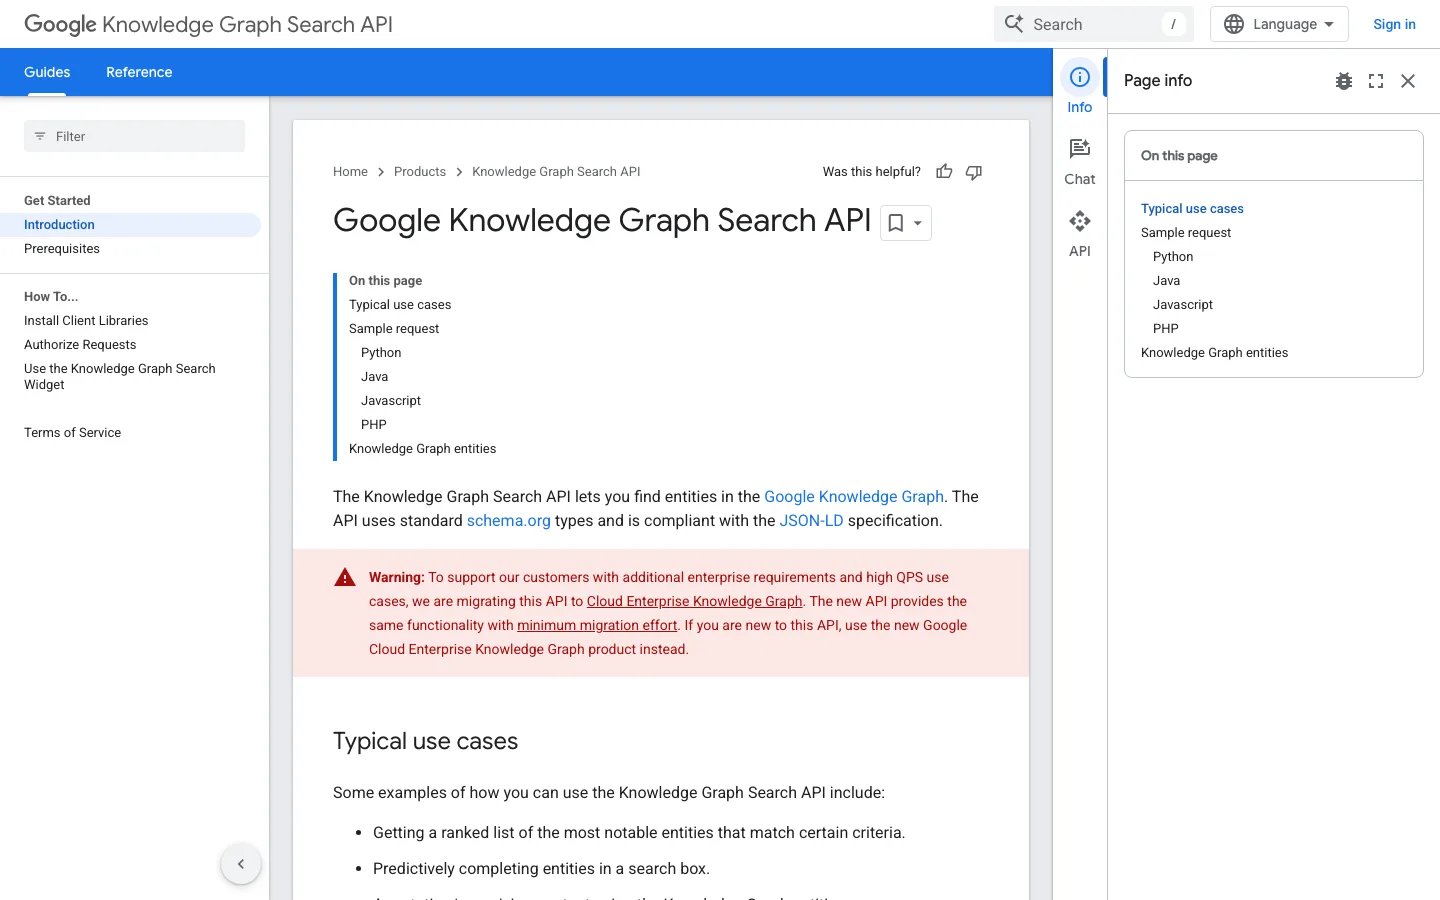
Utvecklare kan också söka i Googles graf. Knowledge Graph Search API låter er hitta entiteter i Google Knowledge Graph, använder standardiserade schema.org-typer och returnerar JSON-LD. Dokumentationen varnar också för att Google flyttar detta API till Cloud Enterprise Knowledge Graph, så kontrollera de aktuella alternativen innan ni bygger något på det. Bilden nedan visar överst på den dokumentationssidan.
Googles dokumentation för Knowledge Graph Search API (skärmbild från developers.google.com).
Hur kombinerar GraphRAG en graf med en språkmodell?
Hämtningsförstärkt generering hittar normalt textstycken med liknande formuleringar och låter modellen sätta ihop dem. GraphRAG lägger till en kunskapsgraf i den processen. Systemet hämtar en sammankopplad mängd relaterade entiteter och relationer och skickar sedan denna struktur till modellen som kontext.
Fördelarna är praktiska. En graf som registrerar att en produkt har Del A och Del B gör att modellen kan lista exakt dessa delar. Många flöden kombinerar också grafer med vektorsökning: inbäddningar hittar liknande text och grafen kontrollerar hur fakta hänger ihop.
Hur minskar kunskapsgrafer AI-hallucinationer?
Kunskapsgrafer minskar AI-hallucinationer genom att begränsa svaret till relationer som redan finns i datan. När grafen saknar en länk mellan två fakta har modellen mindre utrymme att hitta på en. Effekten är starkast vid precisa frågor, där en felaktig koppling är dyr.
Strukturen gör också svaren spårbara. Varje påstående kan kopplas till de noder och kanter som stödjer det, så att ett team kan granska varför systemet sade som det gjorde. Sökning enbart i text gör den vägen mycket svårare att verifiera. En graf tar dock inte bort fel av sig själv: en felaktig trippel ger ett felaktigt svar med samma säkerhet som ett rätt.
Vanliga misstag med kunskapsgrafer
Att hoppa över ontologin: utan överenskomna entitetstyper och regler lagras samma idé i flera former och grafen tappar sin konsekvens.
Att använda namn som identifierare: "Jaguar" kan vara en bilmärke eller ett djur, så varje entitet behöver ett eget unikt ID innan dess relationer läggs till.
Motstridiga fakta på olika sidor: när en sida anger ett grundningsår som en annan sida motsäger kan maskiner inte avgöra vilket fakta de ska lita på.
Märkning som inte stämmer med sidan: strukturerad data som beskriver fakta som den synliga sidan inte visar gör sidan svårare att lita på.
Att tro att en graf ersätter innehåll: en graf ordnar fakta, men sidorna behöver fortfarande tydliga svar på de frågor människor faktiskt söker efter.
Varför spelar kunskapsgrafer roll för SEO och GEO?
Kunskapsgrafer belönar innehåll som maskiner kan dela upp i entiteter och relationer. När era sidor tydligt namnger sina entiteter, använder schemamärkning och håller fakta konsekventa, kan sökmotorer och AI-system matcha ert varumärke mot grafen de litar på. Det är kärnidén bakom entitets-SEO.
Kunskapsgrafer förvandlar spridda fakta till en sammankopplad struktur som maskiner kan söka i och resonera över, och det är därför de ligger bakom många korrekta AI-svar. Genom att koda entiteter och relationer uttryckligen minskar de hallucinationer, stödjer resonemang i flera steg och gör resultaten lättare att spåra. Håll era egna fakta konsekventa och tydligt namngivna, så att ert varumärke passar de grafer som sökmotorer och AI-assistenter redan använder.
Vad är skillnaden mellan en kunskapsgraf och en vanlig databas?
En vanlig databas lagrar data i tabeller och beräknar relationer när en fråga körs. En kunskapsgraf lagrar relationer som data, så att kopplingar kan följas, läggas till och förklaras direkt.
Vad är GraphRAG och hur skiljer det sig från vanlig RAG?
Vanlig hämtningsförstärkt generering hittar textstycken med liknande formuleringar. GraphRAG lägger till en kunskapsgraf, så att systemet hämtar en sammankopplad mängd entiteter och relationer i stället för isolerade utdrag, och svaret bygger på strukturerade fakta.
Hjälper kunskapsgrafer mitt innehåll att bli citerat av AI?
Indirekt, ja. Sidor med tydliga entiteter, konsekventa fakta och giltig strukturerad data är lättare för sökmotorer och AI-system att koppla till de grafer de använder. Tydlig och pålitlig information har större chans att visas och citeras.
“Jag testade Sorank på en riktig kundsajt och det är helt otroligt. Det gör allt som en byrå skulle ta 1500 dollar i månaden för. Den används nu i produktion för den kunden.”Guillaume Guersanguersanguillaume.com
“Vi är en annonsbyrå och ville få igång vår SEO på rätt spår en gång för alla. Sorank gav oss en tydlig bild av vår webbplats, hjälpte oss att prioritera optimeringarna och att strukturera vårt innehåll på rätt sätt. Verktyget är lätt att använda, väl genomtänkt för ett team och mycket praktiskt för att samla uppföljningen på ett ställe utan att jonglera med flera plattformar. En mycket stabil grund för att börja om från början med vår SEO.”Gaspard MadouiAnnonsbyrå
“Jag specialiserade mig på GEO tack vare Sorank. GEO-rankningen gör det möjligt för mig att visa mina kunder deras position jämfört med konkurrenterna i ChatGPT. Det är en verklig konkurrensfördel.”MélanieFrilans SEO-konsult
“Bra service, den fungerar bra för vår webbplats och hjälper oss att förstå hur vi kan förbättra den för att rankas bättre på Google och på andra ställen. Grattis, fortsätt så, jag rekommenderar det.”Hugo T.Handlare inom e-handel