Datenschutz ist uns wichtig. Deshalb können Sie bestimmte Speicherarten deaktivieren, die für die grundlegende Funktion der Website nicht erforderlich sind. Das Blockieren einzelner Kategorien kann Ihr Erlebnis auf der Website beeinträchtigen. Weitere Informationen (Cookie-Richtlinie)
Vielen Dank! Ihre Auswahl wurde gespeichert.
Hoppla! Beim Absenden des Formulars ist ein Fehler aufgetreten.
Wissensgraphen sind Netzwerke aus Entitäten wie Personen, Unternehmen oder Produkten, die durch benannte Beziehungen verbunden sind. Maschinen fragen diese Verbindungen ab, um über Fakten zu schlussfolgern, statt unscharfe Texte zu vergleichen. Dadurch werden Antworten genauer und leichter nachvollziehbar, und Suchmaschinen und KI-Systeme können sie einfacher zitieren.
Wissensgraphen speichern Informationen als Netzwerk statt in Zeilen und Spalten. Jeder Knoten ist eine Entität, jede Kante eine Beziehung zwischen zwei Entitäten, und beide können beschreibende Attribute tragen. Das Ergebnis ist eine Landkarte von Fakten, der Software folgen, die sie abfragen und prüfen kann. Deshalb stützen sich Suchmaschinen und KI-Assistenten auf diese Idee.
Was ist ein Wissensgraph?
Ein Wissensgraph ist ein vernetzter Datenbestand über reale Dinge und die Art, wie sie zusammenhängen. Die Dinge, Entitäten genannt, können Personen, Unternehmen, Produkte, Orte oder Konzepte sein. Das bekannteste Beispiel ist der Google Knowledge Graph, doch das Modell ist allgemein gültig und wird auch für Unternehmensdaten, Forschungsdatenbanken und interne Suchsysteme genutzt.
Google stellte seinen Graphen im Mai 2012 als Modell vor, das Dinge und ihre Beziehungen versteht und nicht nur Zeichenketten. In seinem Ankündigungsbeitrag schrieb Google, der Graph enthalte mehr als 500 Millionen Objekte und mehr als 3,5 Milliarden Fakten über sie und die Beziehungen zwischen ihnen.
Wie funktionieren Knoten, Kanten und Tripel?
Die Grundeinheit ist das Tripel, eine Aussage aus Subjekt, Prädikat und Objekt. Der W3C RDF 1.1 Primer erklärt, dass RDF-Aussagen aus drei Elementen bestehen, den sogenannten Tripeln, und dass Subjekte und Objekte zu Knoten des Graphen werden, während Prädikate die Kanten zwischen ihnen bilden.
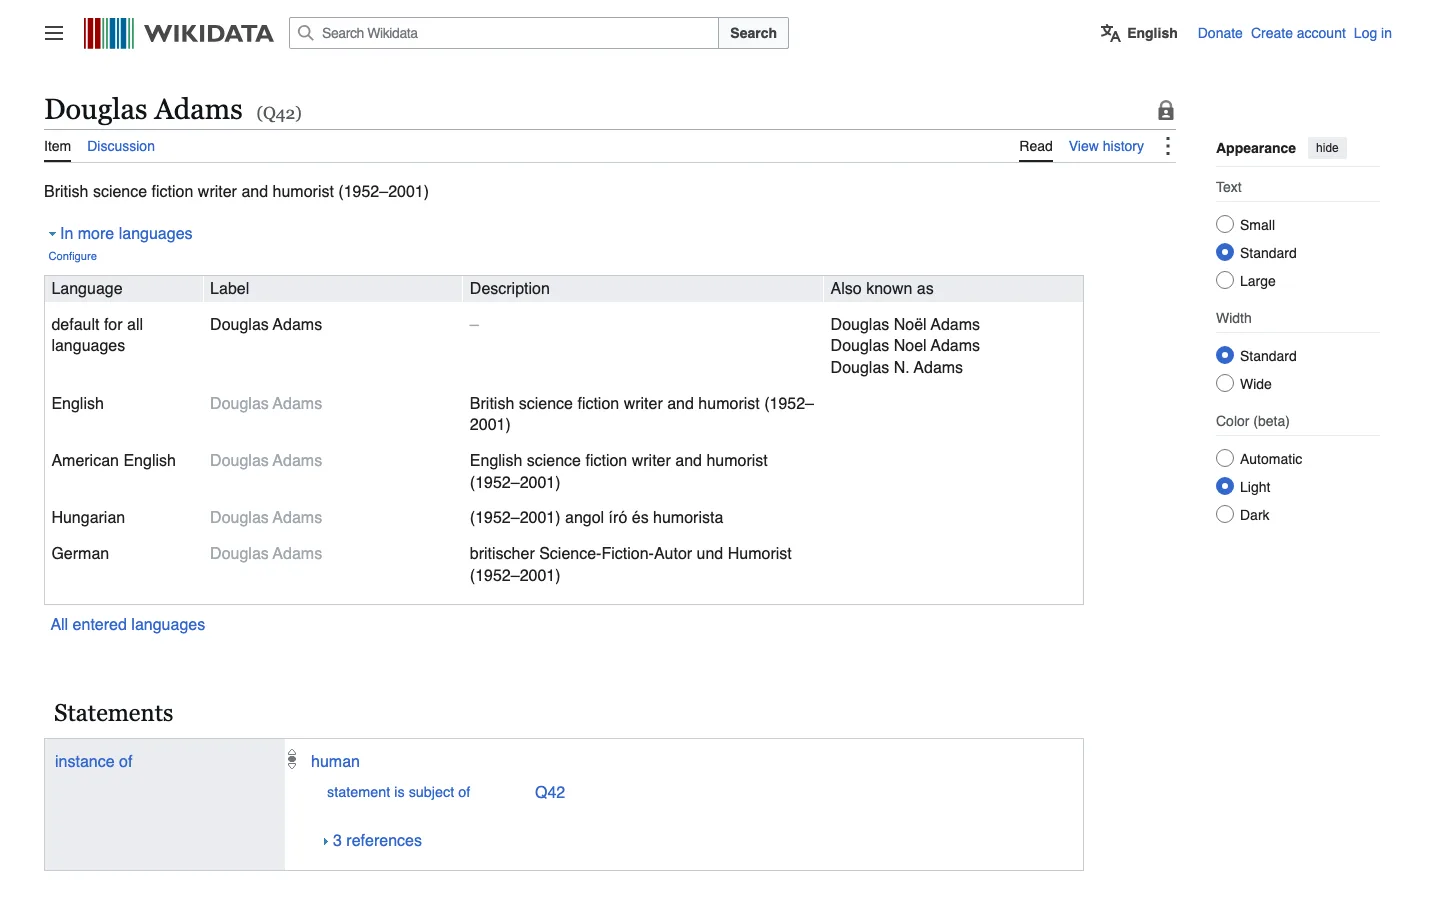
Ein Tripel liest sich wie ein kurzer Satz. Der Screenshot unten zeigt den öffentlichen Wikidata-Eintrag zum Schriftsteller Douglas Adams, in dem die Aussage „Instanz von: Mensch“ eine Entität mit einer allgemeineren Kategorie verbindet. Dieselbe Entität kann mit vielen weiteren Entitäten verbunden sein, und jede Verbindung fügt dem Graphen eine weitere Kante hinzu.
Ein öffentlicher Wikidata-Eintrag zeigt ein Tripel: das Subjekt Douglas Adams, das Prädikat Instanz von und das Objekt Mensch (Screenshot von wikidata.org).
Eine Ontologie ist der Bauplan des Graphen. Sie legt fest, welche Entitätstypen es gibt, welche Beziehungen erlaubt sind und welche Regeln gelten, etwa dass jede Bestellung mindestens ein Produkt enthalten muss. So bleibt der Graph konsistent, und Software kann über ihn schlussfolgern, statt zu raten.
Wie werden Wissensgraphen gespeichert und abgefragt?
Wissensgraphen liegen meist in Graphdatenbanken oder Triplestores, etwa Neo4j, Amazon Neptune oder GraphDB. Diese Systeme sind darauf ausgelegt, von einem Knoten zu seinen Nachbarn und von dort weiter zu gehen, was in einer klassischen relationalen Datenbank bei langen Beziehungsketten umständlich auszudrücken ist.
Dieses Durchlaufen über mehrere Schritte ist die größte Stärke eines Graphen. Eine Frage wie „Welche Lieferanten eines Produkts beliefern auch einen Wettbewerber?“ braucht im Tabellenmodell mehrere Joins, während ein Graph einfach den Kanten zwischen den betroffenen Knoten folgt.
Worin unterscheidet sich ein Wissensgraph von einer normalen Datenbank?
Eine normale Datenbank speichert Daten in Tabellen und behandelt Beziehungen als Joins, die erst beim Ausführen einer Abfrage berechnet werden. Ein Wissensgraph speichert die Beziehungen als eigenständige Daten, sodass Verbindungen direkt durchlaufen, ergänzt und erklärt werden können. Suchmaschinen und KI-Systeme nutzen dies, um Fragen zu beantworten, die davon abhängen, wie mehrere Fakten zusammenhängen.
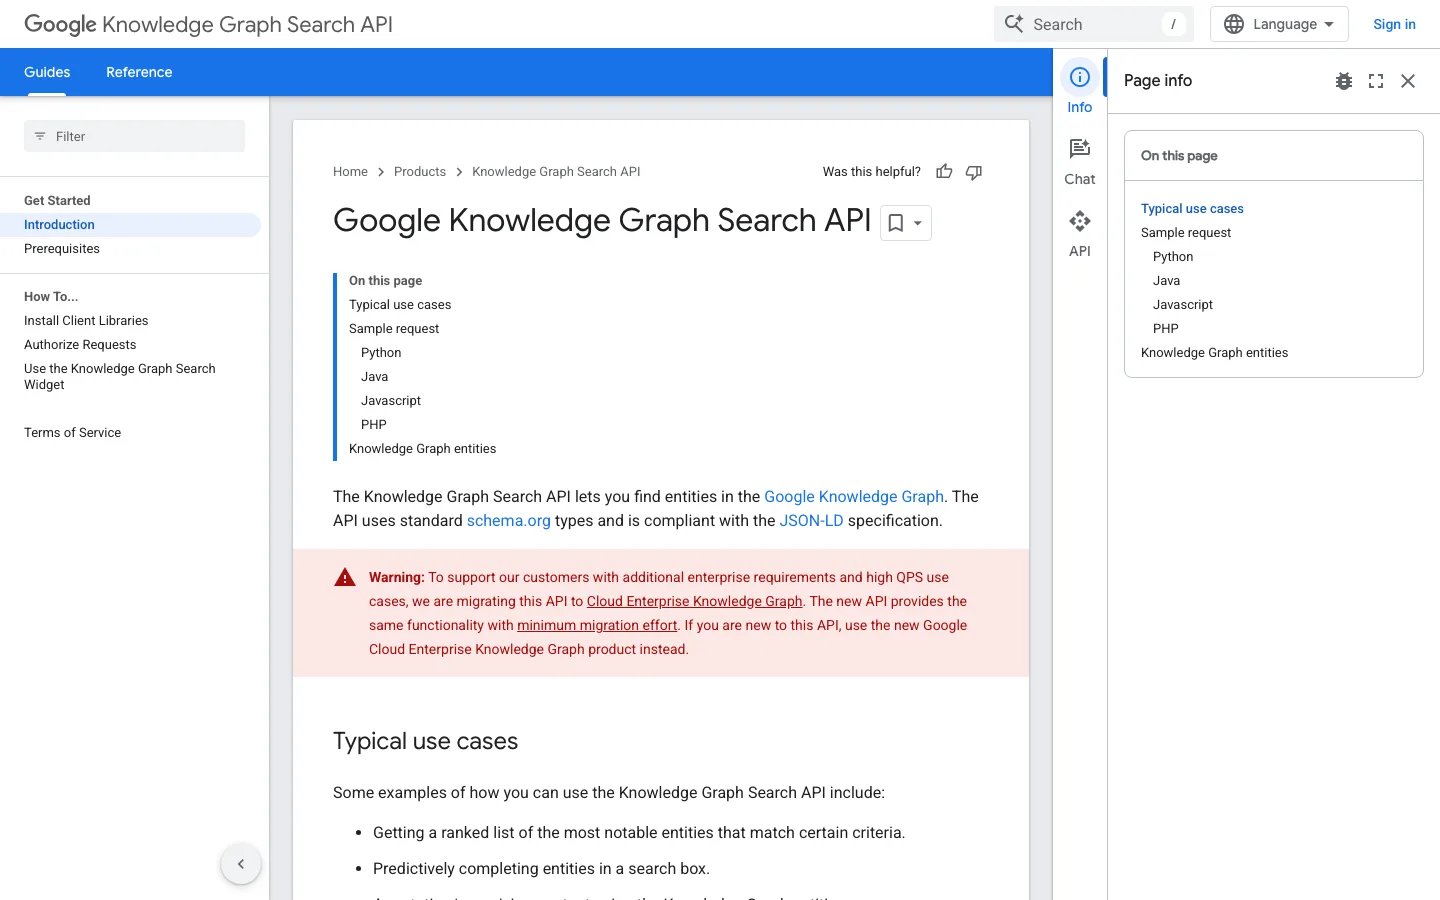
Entwickler können den Graphen von Google auch abfragen. Die Knowledge Graph Search API findet Entitäten im Google Knowledge Graph, verwendet die Standardtypen von schema.org und liefert JSON-LD zurück. Die Dokumentation weist außerdem darauf hin, dass Google diese API auf Cloud Enterprise Knowledge Graph umstellt. Prüfen Sie deshalb die aktuellen Optionen, bevor Sie darauf aufbauen. Der Screenshot unten zeigt den oberen Teil dieser Dokumentationsseite.
Dokumentation von Google zur Knowledge Graph Search API (Screenshot von developers.google.com).
Wie verbindet GraphRAG einen Graphen mit einem Sprachmodell?
Retrieval Augmented Generation findet normalerweise Textpassagen mit ähnlicher Formulierung und lässt das Modell sie zusammensetzen. GraphRAG ergänzt diesen Ablauf um einen Wissensgraphen. Das System ruft eine verbundene Menge verwandter Entitäten und Beziehungen ab und übergibt diese Struktur als Kontext an das Modell.
Die Vorteile sind praktisch. Ein Graph, der festhält, dass ein Produkt die Teile A und B hat, erlaubt dem Modell, genau diese Teile aufzuzählen. Viele Pipelines kombinieren Graphen außerdem mit der Vektorsuche: Embeddings finden ähnliche Texte, und der Graph prüft, wie die Fakten zusammenhängen.
Wie reduzieren Wissensgraphen KI-Halluzinationen?
Wissensgraphen verringern KI-Halluzinationen, indem sie eine Antwort auf Beziehungen beschränken, die in den Daten bereits existieren. Fehlt im Graphen eine Verbindung zwischen zwei Fakten, hat das Modell weniger Spielraum, eine zu erfinden. Der Effekt ist bei präzisen Fragen am stärksten, wo eine falsche Verbindung teuer wird.
Die Struktur macht Antworten außerdem nachvollziehbar. Jede Aussage lässt sich auf die Knoten und Kanten zurückführen, die sie stützen, sodass ein Team prüfen kann, warum ein System etwas gesagt hat. Bei einer reinen Textsuche ist dieser Weg deutlich schwerer zu überprüfen. Ein Graph beseitigt Fehler allerdings nicht von selbst: Ein falsches Tripel erzeugt eine falsche Antwort mit derselben Sicherheit wie eine richtige.
Typische Fehler bei Wissensgraphen
Die Ontologie auslassen: Ohne vereinbarte Entitätstypen und Regeln wird dieselbe Sache in mehreren Formen gespeichert, und der Graph verliert seine Konsistenz.
Namen als Kennungen verwenden: „Jaguar“ kann ein Autohersteller oder ein Tier sein. Jede Entität braucht deshalb eine eindeutige ID, bevor ihre Beziehungen erfasst werden.
Widersprüchliche Fakten auf verschiedenen Seiten: Nennt eine Seite ein Gründungsjahr, das eine andere Seite widerspricht, können Maschinen nicht erkennen, welchem Fakt sie vertrauen sollen.
Markup, das nicht zur Seite passt: Strukturierte Daten, die Fakten beschreiben, die auf der sichtbaren Seite fehlen, machen die Seite weniger vertrauenswürdig.
Erwarten, dass ein Graph Inhalte ersetzt: Ein Graph ordnet Fakten, doch Ihre Seiten müssen weiterhin klare Antworten auf die Fragen geben, die Menschen tatsächlich suchen.
Warum sind Wissensgraphen für SEO und GEO wichtig?
Wissensgraphen belohnen Inhalte, die Maschinen in Entitäten und Beziehungen zerlegen können. Wenn Ihre Seiten ihre Entitäten klar benennen, Schema-Markup einsetzen und Fakten konsistent halten, können Suchmaschinen und KI-Systeme Ihre Marke dem Graphen zuordnen, auf den sie sich stützen. Das ist der Kerngedanke des Entity SEO.
Wissensgraphen verwandeln verstreute Fakten in eine vernetzte Struktur, die Maschinen abfragen und über die sie schlussfolgern können. Deshalb stecken sie hinter vielen präzisen KI-Antworten. Indem sie Entitäten und Beziehungen ausdrücklich kodieren, verringern sie Halluzinationen, ermöglichen mehrstufiges Schlussfolgern und machen Ergebnisse leichter nachvollziehbar. Halten Sie Ihre eigenen Fakten konsistent und klar benannt, damit Ihre Marke in die Graphen passt, die Suchmaschinen und KI-Assistenten bereits nutzen.
Worin unterscheidet sich ein Wissensgraph von einer normalen Datenbank?
Eine normale Datenbank speichert Daten in Tabellen und berechnet Beziehungen erst bei der Abfrage. Ein Wissensgraph speichert Beziehungen als Daten, sodass Verbindungen direkt durchlaufen, ergänzt und erklärt werden können.
Was ist GraphRAG und wie unterscheidet es sich von normalem RAG?
Normales Retrieval Augmented Generation findet Textpassagen mit ähnlicher Formulierung. GraphRAG ergänzt einen Wissensgraphen, sodass das System eine verbundene Menge aus Entitäten und Beziehungen statt isolierter Ausschnitte abruft und die Antwort auf strukturierte Fakten stützt.
Helfen Wissensgraphen dabei, dass meine Inhalte von KI zitiert werden?
Indirekt ja. Seiten mit klaren Entitäten, konsistenten Fakten und gültigen strukturierten Daten lassen sich leichter den Graphen zuordnen, die Suchmaschinen und KI-Systeme nutzen. Klare, verlässliche Informationen werden eher angezeigt und zitiert.
“Ich habe Sorank auf einer echten Kundenwebsite getestet, und es ist der Wahnsinn. Es macht alles, wofür eine Agentur 1.500 € im Monat berechnet. Jetzt geht es bei diesem Kunden in den Produktivbetrieb.”Guillaume Guersanguersanguillaume.com
“Wir sind eine Ads-Agentur und wollten unser SEO endgültig wieder auf Kurs bringen. Sorank hat uns eine klare Übersicht über unsere Website verschafft, uns geholfen, Optimierungen zu priorisieren und unsere Inhalte richtig zu strukturieren. Das Tool ist einfach zu bedienen, gut für ein Team konzipiert und sehr praktisch, um das Tracking zu zentralisieren, ohne zwischen mehreren Plattformen jonglieren zu müssen. Eine sehr solide Grundlage, um mit unserem SEO neu zu starten.”Gaspard MadouiWerbeagentur
“Ich habe mich dank Sorank auf GEO spezialisiert. Das GEO Leaderboard ermöglicht es mir, meinen Kunden ihre Position im Vergleich zu ihren Wettbewerbern auf ChatGPT zu zeigen. Das ist ein echter kommerzieller Differenzierungsfaktor.”MélanieFreelancer im Bereich SEO
“Hervorragender Service, funktioniert gut für unsere Website und hilft uns zu verstehen, wie wir sie verbessern können, um auf Google und anderswo besser zu ranken. Herzlichen Glückwunsch, machen Sie weiter, ich empfehle es.”Hugo T.E-Commerce-Händler