Innstillinger
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Kunnskapsgrafer lagrer enheter og relasjoner som sammenkoblede fakta som KI kan søke i. Hvordan de fungerer, hvordan GraphRAG bruker dem og hva de betyr for GEO.







Grunnlegger av Sorank, 7+ år i SEO.
Oppsummering
Kunnskapsgrafer er nettverk av enheter, som personer, selskaper eller produkter, koblet sammen med navngitte relasjoner. Maskiner søker i disse forbindelsene for å resonnere om fakta i stedet for å matche løse tekster. Det gjør svarene mer presise, lettere å spore og lettere for søkemotorer og KI-systemer å sitere.
Vil du vite mer? Spør
Kunnskapsgrafer lagrer informasjon som et nettverk i stedet for rader og kolonner. Hver node er en enhet, hver kant er en relasjon mellom to enheter, og begge kan ha beskrivende egenskaper. Resultatet er et kart over fakta som programvare kan følge, søke i og kontrollere, og derfor bygger søkemotorer og KI-assistenter på ideen.
En kunnskapsgraf er et sammenkoblet datasett om ting i den virkelige verden og hvordan de henger sammen. Tingene, kalt enheter, kan være personer, selskaper, produkter, steder eller begreper. Det mest kjente eksemplet er Google Knowledge Graph, men modellen er generell og brukes også til bedriftsdata, forskningsdatabaser og interne søkesystemer.
Google presenterte grafen sin i mai 2012 som en modell som forstår ting og relasjonene mellom dem, ikke bare tekststrenger. I lanseringsinnlegget skrev Google at grafen inneholdt mer enn 500 millioner objekter og mer enn 3,5 milliarder fakta om dem og om relasjonene mellom dem.
Den grunnleggende enheten er tripelen: en påstand bestående av et subjekt, et predikat og et objekt. W3C sin introduksjon til RDF 1.1 forklarer at RDF-påstander består av tre elementer, kalt tripler, der subjekter og objekter blir nodene i grafen, mens predikatene blir buene mellom dem.
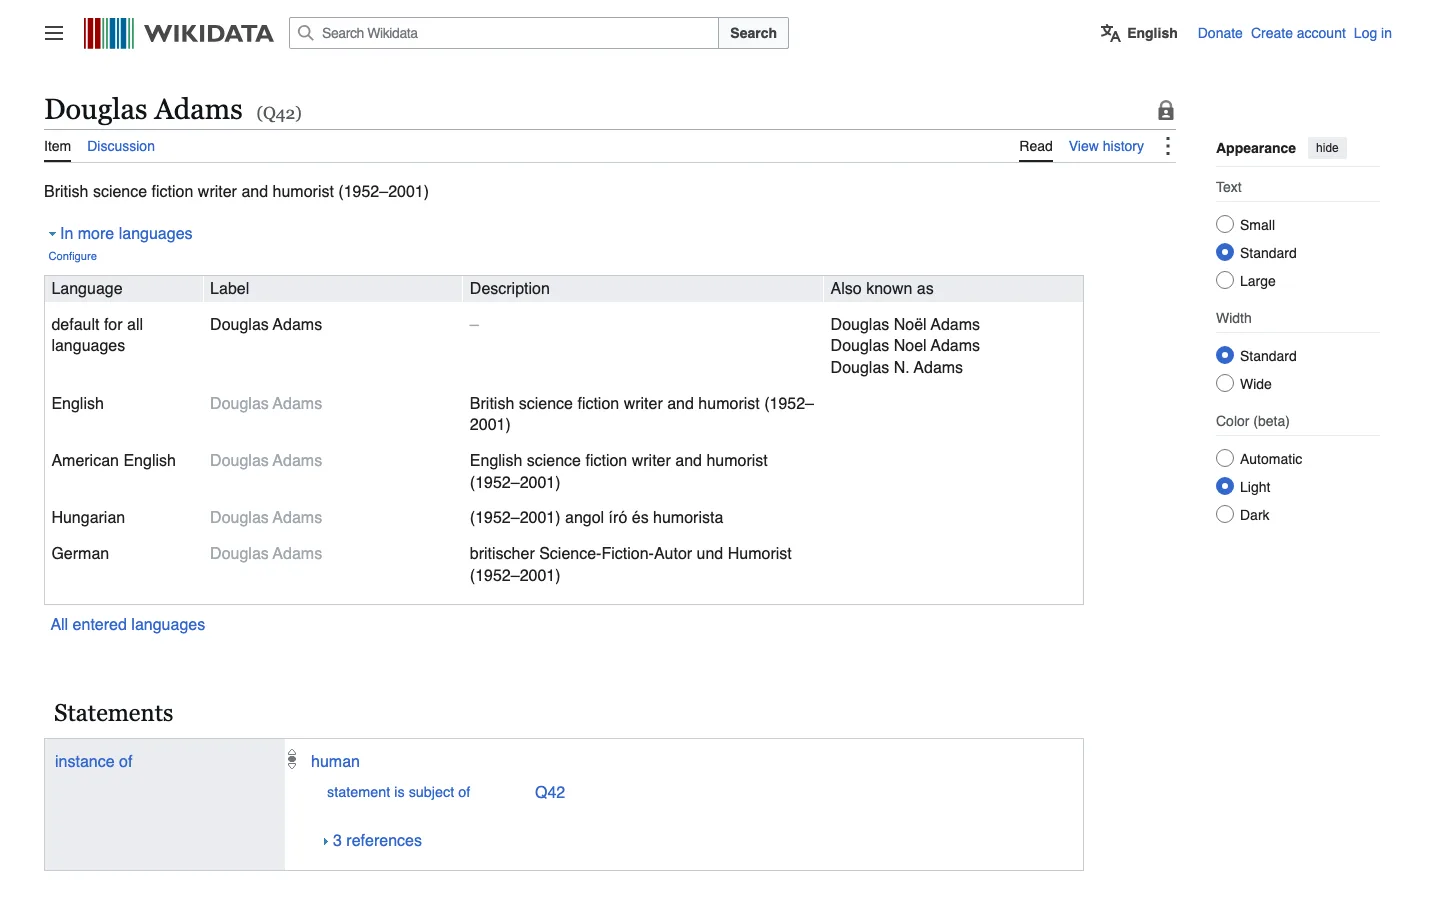
En triple leses som en kort setning. Skjermbildet nedenfor viser den offentlige Wikidata-siden til forfatteren Douglas Adams, der påstanden "instans av: menneske" kobler en enhet til en bredere kategori. Den samme siden kan kobles til mange andre enheter, og hver kobling legger til en ny kant i grafen.
En ontologi er tegningen til grafen. Den definerer hvilke typer enheter som finnes, hvilke relasjoner som er tillatt og hvilke regler som gjelder, for eksempel at hver bestilling må inneholde minst ett produkt. Det holder grafen konsistent, slik at programvare kan resonnere over den i stedet for å gjette.
Kunnskapsgrafer ligger vanligvis i grafdatabaser eller triplestores, for eksempel Neo4j, Amazon Neptune eller GraphDB. Disse systemene er bygget for å gå fra en node til naboene sine, og deretter til deres naboer, noe som er tungvint å uttrykke i en tradisjonell relasjonsdatabase når kjeden av relasjoner er lang.
Denne gjennomgangen i flere steg er grafens viktigste styrke. Et spørsmål som hvilke leverandører av et produkt også leverer til en konkurrent, krever flere sammenføyninger i en tabellmodell, mens en graf ganske enkelt følger kantene mellom nodene som er involvert.
En vanlig database lagrer data i tabeller og behandler relasjoner som sammenføyninger som beregnes når et søk kjøres. En kunnskapsgraf lagrer relasjonene som data i seg selv, slik at forbindelser kan følges, legges til og forklares direkte. Søkemotorer og KI-systemer bruker dette til å svare på spørsmål som avhenger av hvordan flere fakta henger sammen.
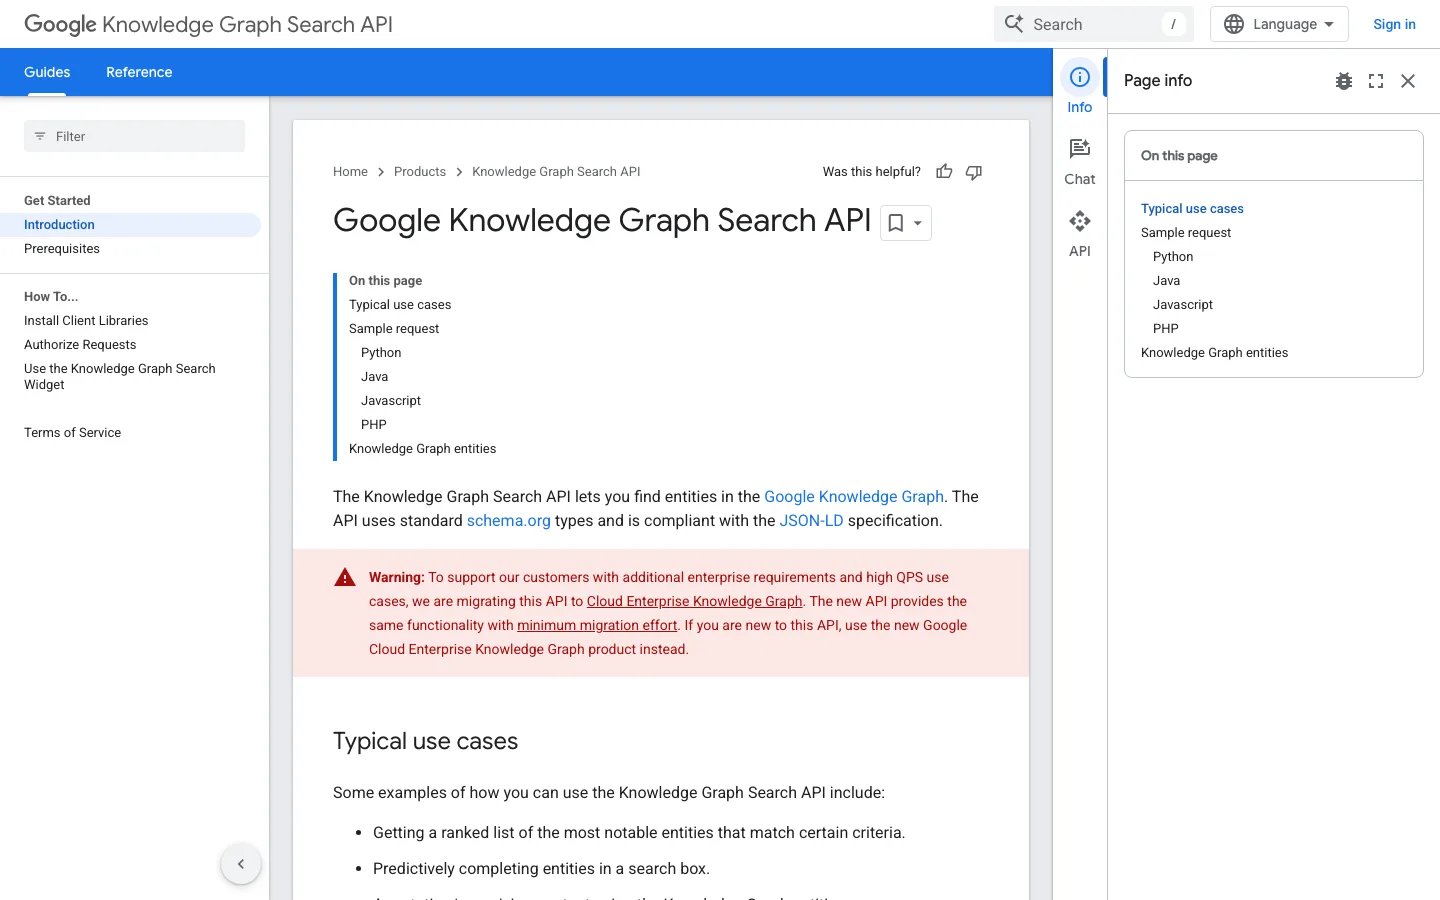
Utviklere kan også søke i Googles graf. Knowledge Graph Search API lar dere finne enheter i Google Knowledge Graph, bruker standardiserte schema.org-typer og returnerer JSON-LD. Dokumentasjonen advarer også om at Google flytter dette API-et til Cloud Enterprise Knowledge Graph, så sjekk de gjeldende alternativene før dere bygger videre på det. Skjermbildet nedenfor viser toppen av den dokumentasjonssiden.
Hentingsforsterket generering finner vanligvis tekstavsnitt med lignende ordlyd og lar modellen sette dem sammen. GraphRAG legger til en kunnskapsgraf i denne prosessen. Systemet henter et sammenhengende sett med relaterte enheter og relasjoner og sender deretter denne strukturen til modellen som kontekst.
Fordelene er praktiske. En graf som registrerer at et produkt har Del A og Del B, lar modellen liste nettopp disse delene. Mange løsninger kombinerer også grafer med vektorsøk: embeddings finner lignende tekst, og grafen kontrollerer hvordan fakta henger sammen.
Kunnskapsgrafer reduserer KI-hallusinasjoner ved å begrense svaret til relasjoner som allerede finnes i dataene. Når grafen ikke har noen forbindelse mellom to fakta, har modellen mindre rom til å finne opp en. Effekten er størst ved presise spørsmål, der en feil kobling er kostbar.
Strukturen gjør også svarene sporbare. Hver påstand kan knyttes til nodene og kantene som støtter den, slik at et team kan undersøke hvorfor systemet svarte som det gjorde. Søk kun i tekst gjør den veien mye vanskeligere å verifisere. En graf fjerner likevel ikke feil av seg selv: en feil triple gir et feil svar med samme sikkerhet som et riktig.
Kunnskapsgrafer belønner innhold som maskiner kan dele opp i enheter og relasjoner. Når sidene deres tydelig navngir enhetene sine, bruker schema-markering og holder fakta konsistente, kan søkemotorer og KI-systemer matche merkevaren deres med grafen de stoler på. Det er kjerneideen bak entitets-SEO.
I praksis bør dere beskrive organisasjonen, produktene og forfatterne deres med de samme fakta overalt der de vises, og deretter kontrollere resultatet med Sorank sin gratis validator for strukturerte data. For mer om hvordan markering påvirker KI-svar, les hva som faktisk hjelper strukturerte data i KI-søk.
Kunnskapsgrafer gjør spredte fakta om til en sammenkoblet struktur som maskiner kan søke i og resonnere over, og derfor ligger de bak mange presise KI-svar. Ved å kode enheter og relasjoner eksplisitt reduserer de hallusinasjoner, støtter resonnering over flere steg og gjør resultatene lettere å spore. Hold egne fakta konsistente og tydelig navngitt, slik at merkevaren deres passer til grafene som søkemotorer og KI-assistenter allerede bruker.
Kilder
En vanlig database lagrer data i tabeller og beregner relasjoner når et søk kjøres. En kunnskapsgraf lagrer relasjoner som data, slik at forbindelser kan følges, legges til og forklares direkte.
Vanlig hentingsforsterket generering finner tekstavsnitt med lignende ordlyd. GraphRAG legger til en kunnskapsgraf, slik at systemet henter et sammenhengende sett med enheter og relasjoner i stedet for isolerte utdrag, og svaret bygger på strukturerte fakta.
Indirekte, ja. Sider med tydelige enheter, konsistente fakta og gyldig strukturert data er lettere for søkemotorer og KI-systemer å koble til grafene de bruker. Klar og pålitelig informasjon har større sjanse til å bli vist og sitert.
 “Jeg testet Sorank på et ekte kundenettsted, og det er helt utrolig. Det gjør alt et byrå ville tatt deg $1500 i måneden for. Nå går det i produksjon på den kunden.”

 Guillaume Guersanguersanguillaume.com“Vi er et annonsebyrå, og vi ville få SEO-en vår på rett spor en gang for alle. Sorank ga oss en tydelig oversikt over nettstedet vårt, hjalp oss å prioritere optimaliseringene og å strukturere innholdet vårt på riktig måte. Verktøyet er enkelt å bruke, godt utformet for et team, og veldig praktisk for å samle oppfølgingen på ett sted uten å jonglere med flere plattformer. Et veldig solid grunnlag for å starte på nytt med SEO.”
 Gaspard MadouiAnnonsebyrå
 “Jeg lot bare Sorank-programvaren gjøre jobben sin, og nå er DR-en min 25, og siden min rangerer høyere.”
 Lucas Flandrefoundertrace.fr“Jeg spesialiserte meg på GEO takket være Sorank. GEO-rangeringen lar meg vise kundene mine hvor de står mot konkurrentene på ChatGPT. Det er en reell kommersiell fordel.”
 MélanieSEO-frilanser“Kjempebra service, den fungerer godt for nettstedet vårt og hjelper oss å forstå hvordan vi kan forbedre det for å rangere bedre på Google og andre steder. Gratulerer, fortsett slik, jeg anbefaler det.”
 Hugo T.Netthandler