La privacidad es importante para nosotros, por lo que tiene la opción de desactivar ciertos tipos de almacenamiento que pueden no ser necesarios para el funcionamiento básico del sitio web. Bloquear categorías puede afectar a su experiencia en el sitio web. Más información (Política de cookies)
Grafos de conocimiento: cómo los hechos estructurados fundamentan las respuestas de la IA en 2027
Los grafos de conocimiento guardan entidades y relaciones como hechos conectados que la IA puede consultar. Cómo funcionan, GraphRAG y qué significan para el GEO.
¡Está suscrito a la newsletter!
¡Algo salió mal con el formulario! Vuelva a intentarlo.
Los grafos de conocimiento son redes de entidades, como personas, empresas o productos, unidas por relaciones con nombre. Las máquinas consultan esas conexiones para razonar sobre hechos en lugar de comparar textos imprecisos. Así, las respuestas son más exactas y fáciles de rastrear, y los buscadores y los sistemas de IA pueden citarlas con más facilidad.
Los grafos de conocimiento guardan la información como una red en lugar de filas y columnas. Cada nodo es una entidad, cada arista es una relación entre dos entidades, y ambos pueden llevar atributos descriptivos. El resultado es un mapa de hechos que el software puede recorrer, consultar y verificar, por eso los buscadores y los asistentes de IA se apoyan en esta idea.
¿Qué es un grafo de conocimiento?
Un grafo de conocimiento es un conjunto de datos conectados sobre cosas del mundo real y las formas en que se relacionan. Esas cosas, llamadas entidades, pueden ser personas, empresas, productos, lugares o conceptos. El ejemplo más conocido es el Google Knowledge Graph, pero el modelo es general y también funciona con datos empresariales, bases de datos de investigación y sistemas de búsqueda interna.
Google presentó su grafo en mayo de 2012 como un modelo que entiende las cosas y sus relaciones, y no solo cadenas de texto. En su anuncio, Google indicaba que el grafo contenía más de 500 millones de objetos y más de 3500 millones de datos sobre ellos y sobre las relaciones entre ellos.
¿Cómo funcionan los nodos, las aristas y los tripletes?
La unidad básica es el triplete, una afirmación formada por un sujeto, un predicado y un objeto. El W3C RDF 1.1 Primer explica que las afirmaciones RDF constan de tres elementos, llamados tripletes, y que los sujetos y los objetos se convierten en nodos del grafo, mientras que los predicados son sus arcos.
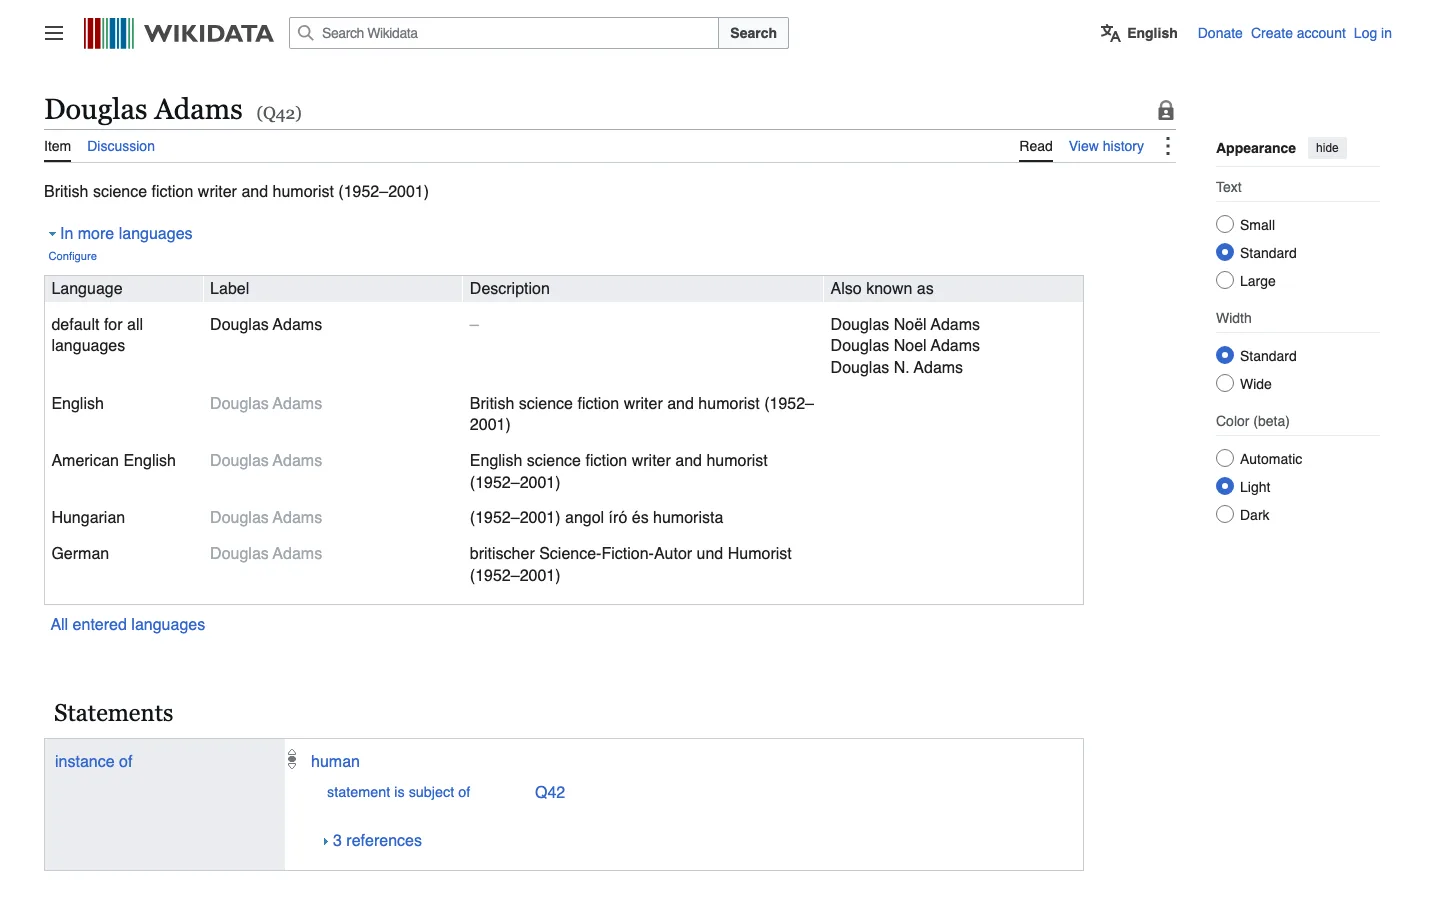
Un triplete se lee como una frase corta. La captura de abajo muestra la ficha pública de Wikidata del escritor Douglas Adams, donde la afirmación «instancia de: humano» relaciona una entidad con una categoría más amplia. La misma entidad puede estar enlazada con muchas otras, y cada enlace añade una arista al grafo.
Una ficha pública de Wikidata muestra un triplete: el sujeto Douglas Adams, el predicado instancia de y el objeto humano (captura de pantalla de wikidata.org).
Una ontología es el plano del grafo. Define qué tipos de entidades existen, qué relaciones están permitidas y qué reglas se aplican, por ejemplo que cada pedido debe contener al menos un producto. Así el grafo se mantiene coherente y el software puede razonar sobre él en lugar de adivinar.
¿Cómo se almacenan y consultan los grafos de conocimiento?
Los grafos de conocimiento suelen estar en bases de datos de grafos o en triplestores, como Neo4j, Amazon Neptune o GraphDB. Estos sistemas están diseñados para pasar de un nodo a sus vecinos y de ahí a los vecinos de estos, algo que resulta incómodo de expresar en una base relacional cuando la cadena de relaciones es larga.
Este recorrido de varios saltos es la principal fortaleza de un grafo. Una pregunta como «¿qué proveedores de un producto también sirven a un competidor?» necesita varias uniones en un modelo de tablas, mientras que un grafo simplemente sigue las aristas entre los nodos implicados.
¿En qué se diferencia un grafo de conocimiento de una base de datos normal?
Una base de datos normal guarda los datos en tablas y trata las relaciones como uniones que se calculan al ejecutar una consulta. Un grafo de conocimiento guarda las relaciones como datos propios, de modo que las conexiones pueden recorrerse, añadirse y explicarse directamente. Los buscadores y los sistemas de IA lo usan para responder preguntas que dependen de cómo se conectan varios hechos.
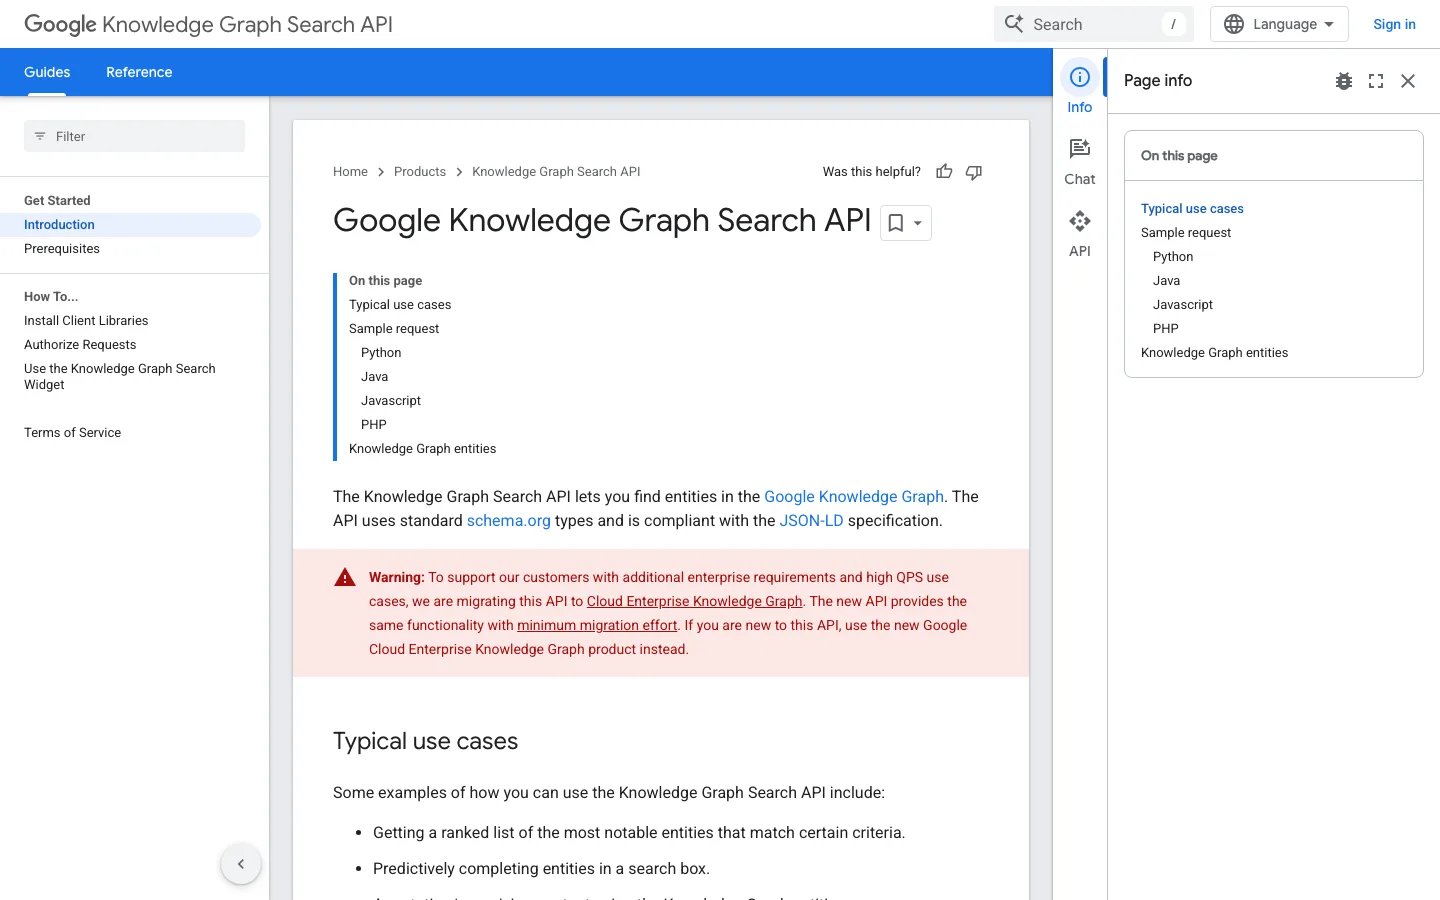
Los desarrolladores también pueden consultar el grafo de Google. La API de Knowledge Graph Search permite encontrar entidades del Google Knowledge Graph, usa los tipos estándar de schema.org y devuelve JSON-LD. La documentación advierte además de que Google está migrando esta API a Cloud Enterprise Knowledge Graph, así que compruebe las opciones actuales antes de construir sobre ella. La captura de abajo muestra la parte superior de esa página de documentación.
Documentación de Google sobre la API Knowledge Graph Search (captura de pantalla de developers.google.com).
¿Cómo combina GraphRAG un grafo con un modelo de lenguaje?
La generación aumentada por recuperación suele encontrar pasajes con una redacción parecida y deja que el modelo los combine. GraphRAG añade un grafo de conocimiento a ese proceso. El sistema recupera un conjunto conectado de entidades y relaciones relacionadas, y pasa esa estructura al modelo como contexto.
Los beneficios son prácticos. Un grafo que registra que un producto tiene la pieza A y la pieza B permite al modelo enumerar exactamente esas piezas. Muchos sistemas combinan además los grafos con la búsqueda vectorial: los vectores encuentran textos similares y el grafo comprueba cómo se conectan los hechos.
¿Cómo reducen los grafos de conocimiento las alucinaciones de la IA?
Los grafos de conocimiento reducen las alucinaciones de la IA limitando una respuesta a las relaciones que ya existen en los datos. Cuando el grafo no tiene ningún vínculo entre dos hechos, el modelo tiene menos margen para inventar uno. El efecto es mayor en preguntas precisas, donde una conexión errónea sale cara.
La estructura también hace que las respuestas sean rastreables. Cada afirmación puede vincularse a los nodos y aristas que la respaldan, de modo que un equipo puede auditar por qué un sistema dijo lo que dijo. Con una búsqueda basada solo en texto, ese camino es mucho más difícil de verificar. Aun así, un grafo no elimina los errores por sí mismo: un triplete incorrecto produce una respuesta incorrecta con la misma seguridad que una correcta.
Errores comunes con los grafos de conocimiento
Saltarse la ontología: sin tipos de entidad y reglas acordados, la misma idea se guarda de varias formas y el grafo pierde coherencia.
Usar nombres como identificadores: «Jaguar» puede ser un fabricante de coches o un animal, por eso cada entidad necesita un ID único antes de añadir sus relaciones.
Hechos contradictorios entre páginas: si una página da un año de fundación que otra página contradice, las máquinas no pueden saber qué dato creer.
Un marcado que no coincide con la página: los datos estructurados que describen hechos que la página visible no muestra hacen que la página sea menos fiable.
Esperar que un grafo sustituya al contenido: un grafo organiza los hechos, pero sus páginas siguen necesitando respuestas claras a las preguntas que la gente busca de verdad.
¿Por qué importan los grafos de conocimiento para el SEO y el GEO?
Los grafos de conocimiento premian el contenido que las máquinas pueden convertir en entidades y relaciones. Cuando sus páginas nombran claramente sus entidades, usan marcado schema y mantienen hechos coherentes, los buscadores y los sistemas de IA pueden relacionar su marca con el grafo en el que confían. Esta es la idea central del SEO de entidades.
Los grafos de conocimiento convierten hechos dispersos en una estructura conectada que las máquinas pueden consultar y sobre la que pueden razonar, por eso están detrás de muchas respuestas precisas de la IA. Al codificar de forma explícita entidades y relaciones, reducen las alucinaciones, permiten razonar en varios pasos y hacen que los resultados sean más fáciles de rastrear. Mantenga sus propios datos coherentes y con nombres claros, para que su marca encaje en los grafos que ya usan los buscadores y los asistentes de IA.
¿Qué diferencia hay entre un grafo de conocimiento y una base de datos normal?
Una base de datos normal guarda los datos en tablas y calcula las relaciones al ejecutar una consulta. Un grafo de conocimiento guarda las relaciones como datos, de modo que las conexiones pueden recorrerse, añadirse y explicarse directamente.
¿Qué es GraphRAG y en qué se diferencia del RAG normal?
El RAG normal encuentra fragmentos de texto con una redacción parecida. GraphRAG añade un grafo de conocimiento, así que el sistema recupera un conjunto conectado de entidades y relaciones en lugar de fragmentos aislados, y la respuesta se apoya en hechos estructurados.
¿Los grafos de conocimiento ayudan a que la IA cite mi contenido?
De forma indirecta, sí. Las páginas con entidades claras, datos coherentes y datos estructurados válidos se relacionan más fácilmente con los grafos que usan los buscadores y los sistemas de IA. La información clara y fiable tiene más probabilidades de mostrarse y citarse.
“He probado Sorank en el sitio real de un cliente y es una locura. Hace todo aquello por lo que una agencia cobra 1.500 € al mes. Ahora se pone en producción en ese cliente.”Guillaume Guersanguersanguillaume.com
“Somos una agencia de publicidad y queríamos poner en marcha nuestro SEO de una vez por todas. Sorank nos dio una visión clara de nuestro sitio, nos ayudó a priorizar las optimizaciones y a estructurar correctamente nuestro contenido. La herramienta es fácil de usar, bien diseñada para un equipo y muy práctica para centralizar el seguimiento sin tener que hacer malabares entre varias plataformas. Una base muy sólida para empezar de nuevo con nuestro SEO.”Gaspard MadouiAgencia de Publicidad
“Me especialicé en GEO gracias a Sorank. El GEO Leaderboard me permite mostrar a mis clientes su posicionamiento frente a sus competidores en ChatGPT. Es un verdadero diferenciador comercial.”MélanieFreelancer SEO
“Excelente servicio, funciona bien para nuestro sitio web y nos ayuda a entender cómo mejorarlo para posicionarnos mejor en Google y en otros lugares. Felicitaciones, continúen así, se lo recomiendo.”Hugo T.Comerciante e-commerce