Předvolby
Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací
Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

Znalostní grafy ukládají entity a vztahy jako propojená fakta, která lze dotazovat. Jak fungují, jak je GraphRAG používá a co znamenají pro GEO.







Zakladatel Sorank, 7+ let v SEO.
Shrnutí
Znalostní grafy jsou sítě entit, jako jsou osoby, firmy nebo produkty, propojené pojmenovanými vztahy. Stroje tyto vazby dotazují, aby uvažovaly nad fakty, místo aby porovnávaly volné texty. Odpovědi tak jsou přesnější, lépe dohledatelné a vyhledávače i systémy umělé inteligence je mohou snáze citovat.
Chcete jít dál? Zeptejte se
Znalostní grafy ukládají informace jako síť, nikoli jako řádky a sloupce. Každý uzel je entita, každá hrana je vztah mezi dvěma entitami a obojí může nést popisné atributy. Výsledkem je mapa faktů, kterou mohou software procházet, dotazovat a ověřovat, a proto se na tuto myšlenku spoléhají vyhledávače a asistenti umělé inteligence.
Znalostní graf je propojená datová sada o věcech reálného světa a o tom, jak spolu souvisejí. Tyto věci, nazývané entity, mohou být osoby, firmy, produkty, místa nebo pojmy. Nejznámějším příkladem je Google Knowledge Graph, ale model je obecný a využívá se také pro firemní data, výzkumné databáze a systémy vyhledávání uvnitř organizací.
Google svůj graf představil v květnu 2012 jako model, který rozumí věcem a jejich vztahům, a ne jen řetězcům textu. Ve svém oznámení Google uvedl, že graf obsahuje více než 500 milionů objektů a více než 3,5 miliardy faktů o nich a o vztazích mezi nimi.
Základní jednotkou je trojice: tvrzení složené z předmětu, predikátu a objektu. Úvod W3C k RDF 1.1 vysvětluje, že tvrzení RDF se skládají ze tří prvků nazývaných trojice, přičemž předměty a objekty se stávají uzly grafu a predikáty oblouky mezi nimi.
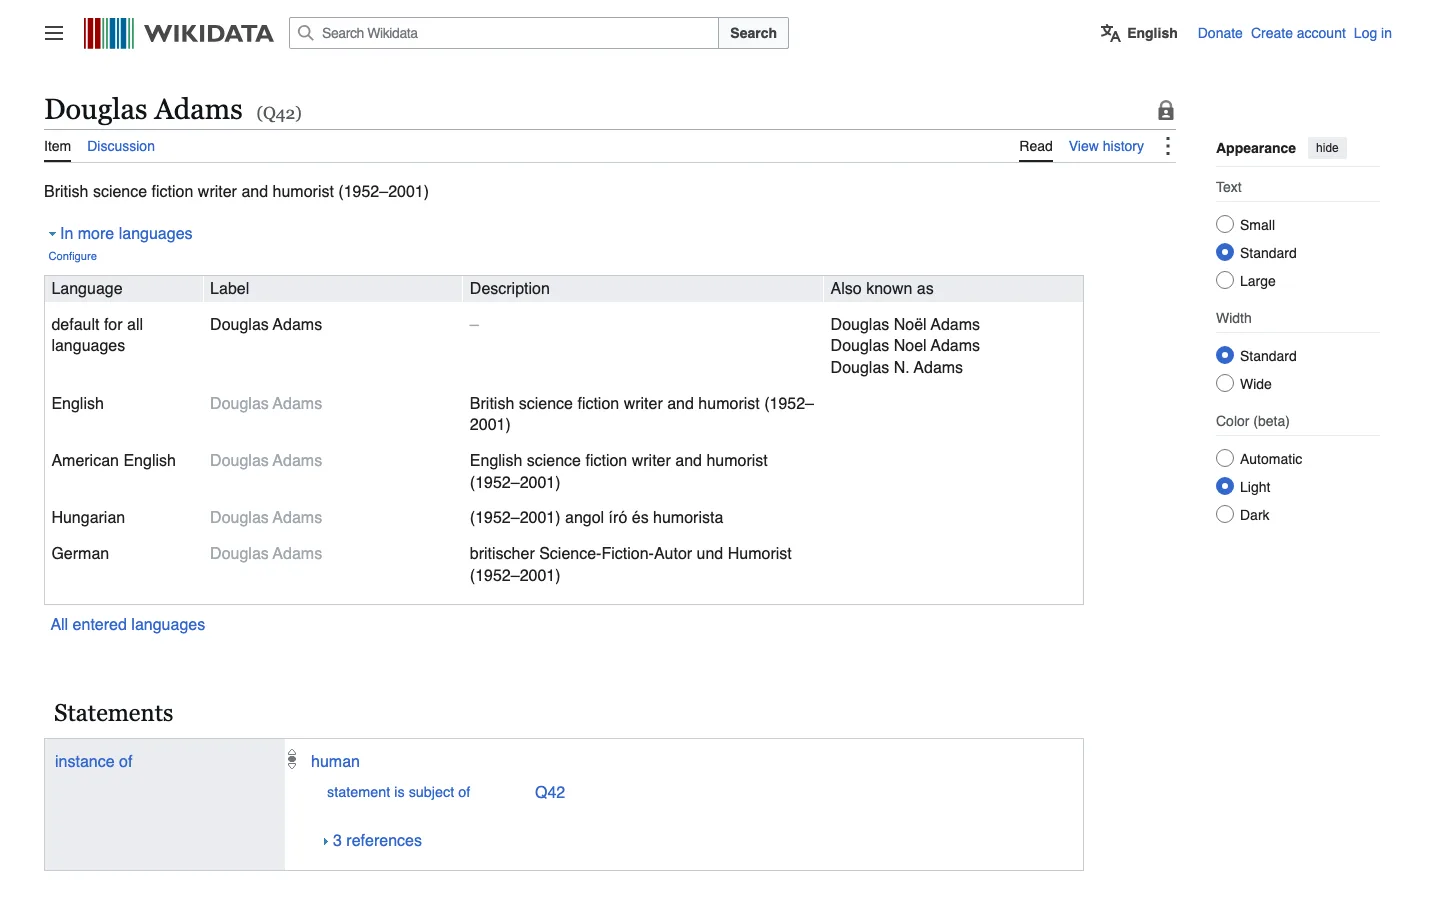
Trojice se čte jako krátká věta. Na snímku níže je veřejná položka Wikidata spisovatele Douglase Adamse, kde tvrzení „instance: člověk“ spojuje entitu se širší kategorií. Stejná položka může být propojena s mnoha dalšími entitami a každé propojení přidává do grafu další hranu.
Ontologie je plán grafu. Určuje, jaké typy entit existují, jaké vztahy jsou povolené a jaká pravidla platí, například že každá objednávka musí obsahovat alespoň jeden produkt. Díky tomu zůstává graf konzistentní a software může uvažovat nad jeho obsahem, místo aby hádal.
Znalostní grafy obvykle žijí v grafových databázích nebo triplestore, například Neo4j, Amazon Neptune nebo GraphDB. Tyto systémy jsou navrženy tak, aby přecházely z jednoho uzlu na sousední a od nich dál, což je obtížné vyjádřit v tradiční relační databázi, když je řetěz vztahů dlouhý.
Toto procházení více kroky je hlavní silou grafu. Otázka, který dodavatelé produktu obsluhují také konkurenta, vyžaduje v tabulkovém modelu několik spojení, zatímco graf jednoduše sleduje hrany mezi zúčastněnými uzly.
Běžná databáze ukládá data do tabulek a vztahy bere jako spojení, která se počítají až při běhu dotazu. Znalostní graf ukládá vztahy jako data sama o sobě, takže spojení lze přímo procházet, přidávat a vysvětlovat. Vyhledávače a systémy umělé inteligence toho využívají k odpovídání na otázky, které závisejí na tom, jak spolu souvisí několik faktů.
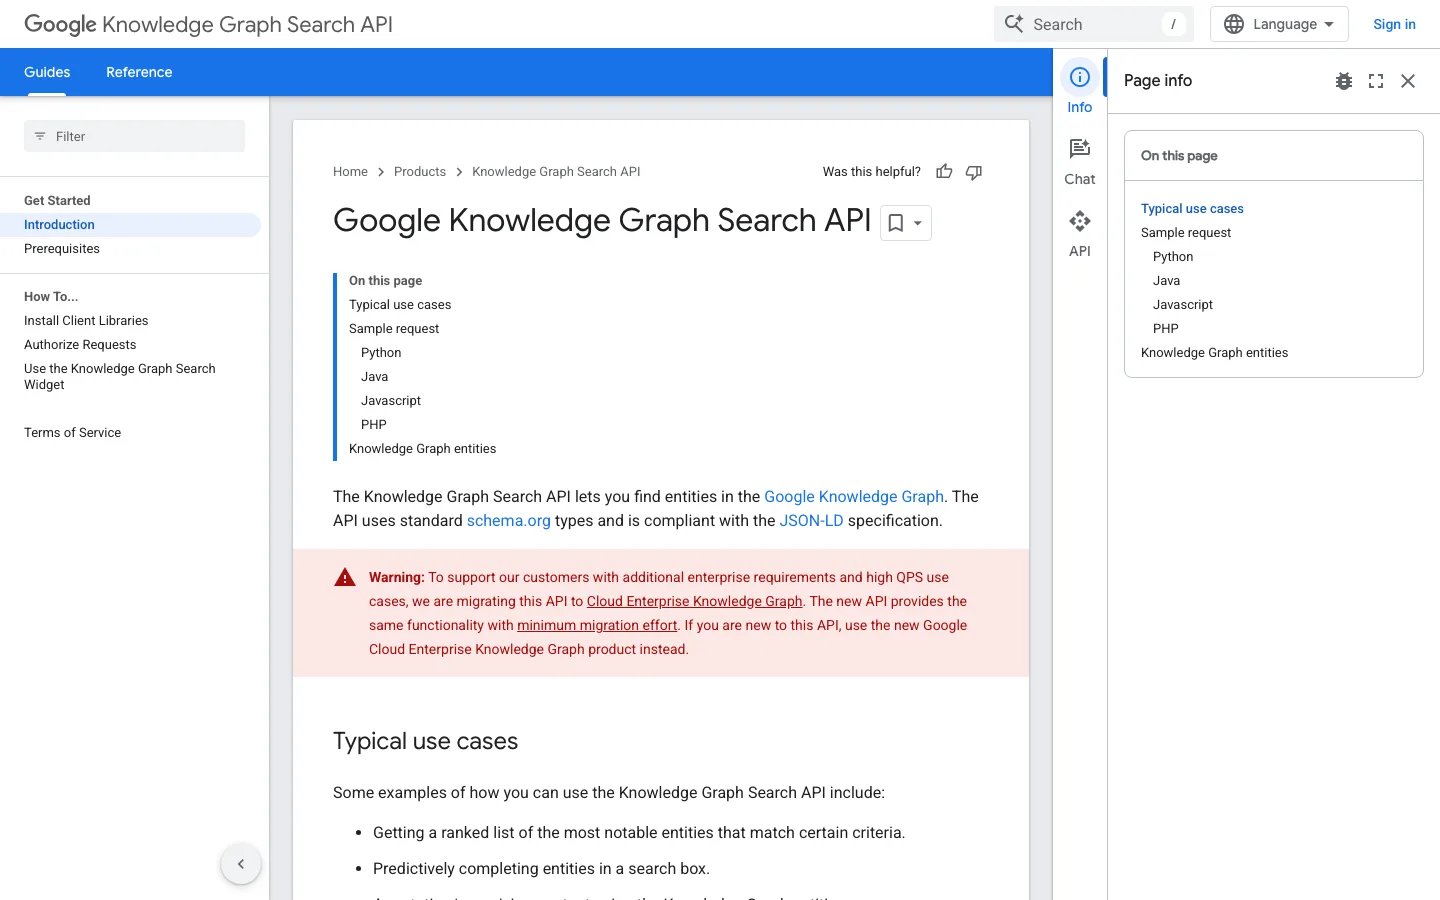
Vývojáři mohou dotazovat i Google graf. Knowledge Graph Search API umožňuje hledat entity v Google Knowledge Graph, používá standardní typy schema.org a vrací JSON-LD. Dokumentace zároveň upozorňuje, že Google tuto rozhraní přesouvá do Cloud Enterprise Knowledge Graph, proto si před stavbou řešení ověřte aktuální možnosti. Snímek níže ukazuje horní část této stránky dokumentace.
Generování rozšířené o vyhledávání běžně najde úryvky textu s podobnou formulací a model z nich sestaví odpověď. GraphRAG do tohoto procesu přidává znalostní graf. Systém načte propojenou množinu souvisejících entit a vztahů a tuto strukturu předá modelu jako kontext.
Přínosy jsou praktické. Graf, který zaznamenává, že produkt má Díl A a Díl B, umožní modelu vypsat přesně tyto díly. Mnoho postupů také kombinuje grafy s vektorovým vyhledáváním: embeddingy najdou podobný text a graf ověří, jak spolu fakta souvisejí.
Znalostní grafy snižují halucinace umělé inteligence tím, že omezují odpověď na vztahy, které již v datech existují. Pokud graf mezi dvěma fakty nemá žádný vztah, model má menší prostor, aby jej vymyslel. Účinek je největší u přesných otázek, kde je špatné spojení drahé.
Struktura také činí odpovědi dohledatelnými. Každé tvrzení lze navázat na uzly a hrany, které je podporují, takže tým může zkontrolovat, proč systém odpověděl právě tak. Vyhledávání jen v textu tuto cestu ověřit mnohem hůř. Graf sám o sobě chyby neodstraní: chybná trojice vytvoří chybnou odpověď se stejnou jistotou jako správná.
Znalostní grafy odměňují obsah, který stroje dokážou rozložit na entity a vztahy. Když vaše stránky jasně pojmenují své entity, používají značkování schema a fakta drží konzistentní, mohou vyhledávače a systémy umělé inteligence přiřadit vaši značku ke grafu, na který se spoléhají. Na tom stojí základní myšlenka entity SEO.
V praxi popisujte organizaci, produkty a autory stejnými fakty všude, kde se objevují, a výsledek pak zkontrolujte pomocí bezplatného validátoru strukturovaných dat od Sorank. Více o tom, jak značkování ovlivňuje odpovědi umělé inteligence, najdete v článku co skutečně pomáhá strukturovaným datům ve vyhledávání s umělou inteligencí.
Znalostní grafy promění roztříštěná fakta v propojenou strukturu, kterou mohou stroje dotazovat a nad kterou mohou uvažovat, a proto stojí za mnoha přesnými odpověďmi umělé inteligence. Tím, že entity a vztahy zapisují explicitně, snižují halucinace, podporují vícekrokové závěry a činí výsledky dohledatelnými. Udržujte vlastní fakta konzistentní a jasně pojmenovaná, aby vaše značka odpovídala grafům, které již používají vyhledávače a asistenti umělé inteligence.
Zdroje
Běžná databáze ukládá data v tabulkách a vztahy počítá až při dotazu. Znalostní graf ukládá vztahy jako data, takže spojení lze přímo procházet, přidávat a vysvětlovat.
Běžné generování rozšířené o vyhledávání najde úryvky textu s podobnou formulací. GraphRAG přidává znalostní graf, takže systém načte propojenou množinu entit a vztahů místo izolovaných úryvků a odpověď se opírá o strukturovaná fakta.
Nepřímo ano. Stránky s jasnými entitami, konzistentními fakty a platnými strukturovanými daty se snáze mapují na grafy, které používají vyhledávače a systémy umělé inteligence. Jasná a spolehlivá informace má větší šanci, že bude zobrazena a citována.
 “Sorank jsem otestoval na skutečném webu klienta a je to neuvěřitelné. Dělá všechno, za co by vám agentura účtovala 1500 $ měsíčně. Právě ho nasazujeme do provozu na tomto klientovi.”

 Guillaume Guersanguersanguillaume.com“Jsme reklamní agentura a chtěli jsme konečně dostat naše SEO na pravou míru. Sorank nám poskytl jasný pohled na náš web, pomohl nám určit priority optimalizací a správně strukturovat náš obsah. Nástroj se snadno používá, je dobře navržený pro tým a velmi praktický, protože centralizuje sledování bez nutnosti žonglovat s více platformami. Velmi pevný základ pro nový start našeho SEO.”
 Gaspard MadouiReklamní agentura
 “Nechal jsem software Sorank dělat svou práci a teď je moje DR 25 a moje stránka se umisťuje výš.”
 Lucas Flandrefoundertrace.fr“Díky Sorank se specializuji na GEO. Žebříček GEO mi umožňuje ukázat klientům jejich postavení oproti konkurenci v ChatGPT. Je to skutečná obchodní výhoda.”
 MélanieSEO freelancer“Skvělá služba, dobře funguje pro náš web a pomáhá nám pochopit, jak ho zlepšit, aby se lépe umisťoval ve výsledcích Google a jinde. Gratulujeme, pokračujte, doporučuji.”
 Hugo T.Majitel e-shopu