Confidențialitatea contează pentru noi, așa că ai opțiunea de a dezactiva anumite tipuri de stocare care nu sunt necesare pentru funcționarea de bază a site-ului. Blocarea categoriilor poate afecta experiența ta pe site. Mai multe informații (Politica privind cookie-urile)
Mulțumim! Trimiterea ta a fost primită!
Ups! A apărut o eroare la trimiterea formularului.
Grafuri de cunoștințe: cum faptele structurate ancorează răspunsurile AI în 2027
Grafurile de cunoștințe stochează entități și relații ca fapte conectate pe care AI le poate interoga. Cum funcționează, cum le folosește GraphRAG și ce înseamnă pentru GEO.
Grafurile de cunoștințe sunt rețele de entități, cum sunt persoanele, companiile sau produsele, legate prin relații denumite. Mașinile interoghează aceste legături pentru a raționa pe baza faptelor, în loc să potrivească texte vagi. Așa, răspunsurile devin mai exacte, mai ușor de urmărit și mai ușor de citat de motoarele de căutare și de sistemele de inteligență artificială.
Grafurile de cunoștințe stochează informația sub formă de rețea, nu de rânduri și coloane. Fiecare nod este o entitate, fiecare muchie este o relație între două entități, iar ambele pot avea atribute descriptive. Rezultatul este o hartă de fapte pe care software-ul o poate parcurge, interoga și verifica, de aceea motoarele de căutare și asistenții de inteligență artificială se bazează pe această idee.
Ce este un graf de cunoștințe?
Un graf de cunoștințe este un set de date conectate despre lucruri din lumea reală și despre modul în care acestea se leagă între ele. Aceste lucruri, numite entități, pot fi persoane, companii, produse, locuri sau concepte. Cel mai cunoscut exemplu este Google Knowledge Graph, dar modelul este general și este folosit și pentru datele companiilor, bazele de date de cercetare și sistemele de căutare internă.
Google și-a prezentat graful în mai 2012 ca pe un model care înțelege lucrurile și relațiile dintre ele, nu doar șiruri de text. În anunțul de lansare, Google a precizat că graful conține peste 500 de milioane de obiecte și peste 3,5 miliarde de fapte despre acestea și despre relațiile dintre ele.
Cum funcționează nodurile, muchiile și tripletele?
Unitatea de bază este tripletul: o afirmație formată dintr-un subiect, un predicat și un obiect. Introducerea W3C în RDF 1.1 explică faptul că afirmațiile RDF constau din trei elemente, numite triplete, iar subiectele și obiectele devin nodurile grafului, în timp ce predicatele devin arcele dintre ele.
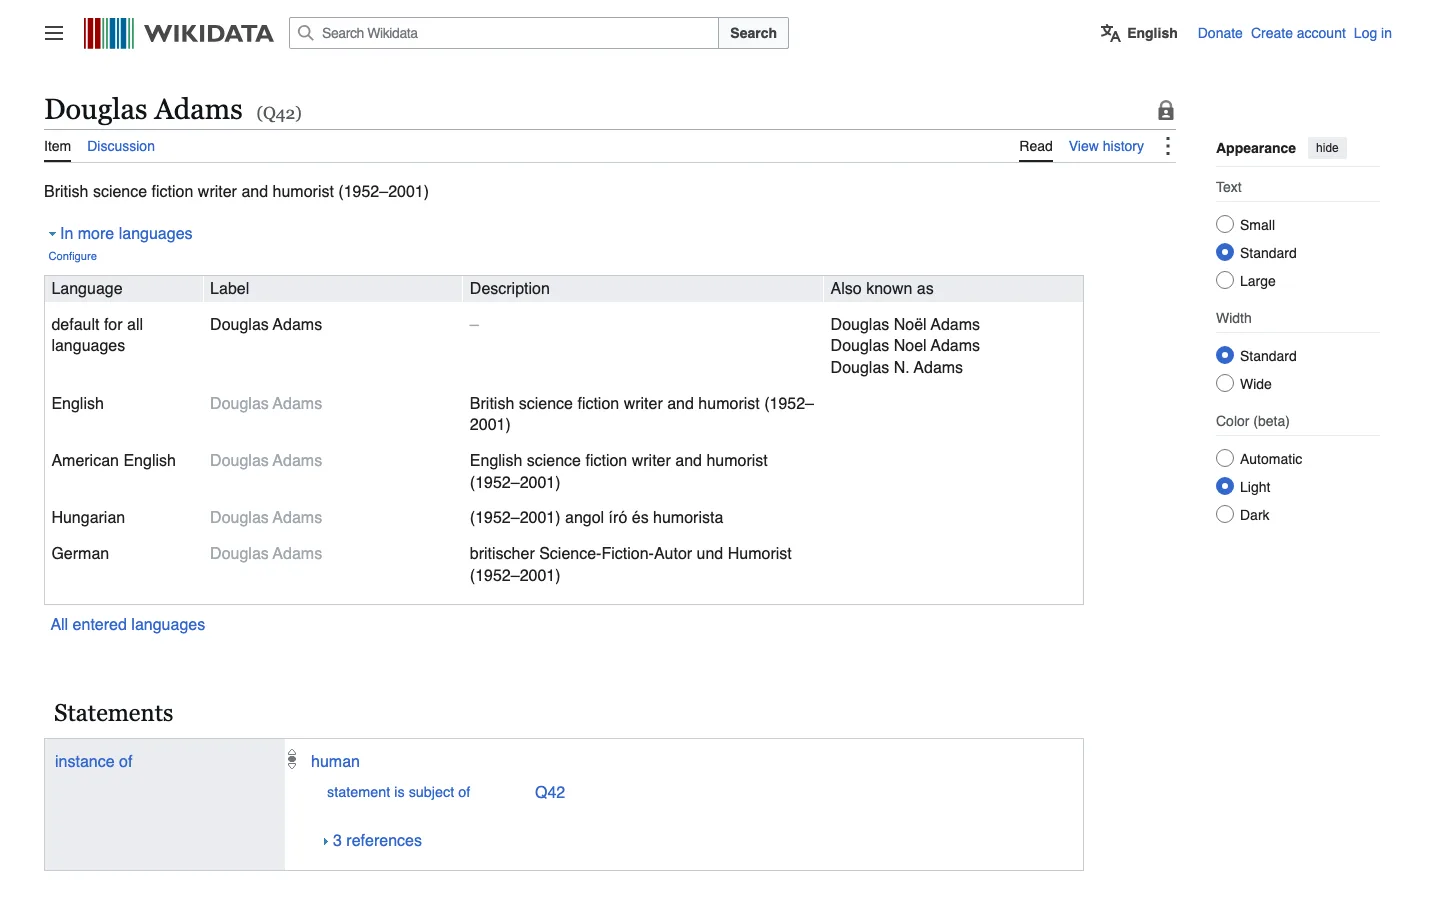
Un triplet se citește ca o propoziție scurtă. Captura de mai jos arată pagina publică Wikidata a scriitorului Douglas Adams, unde afirmația „instanță a: om” leagă o entitate de o categorie mai largă. Același element poate fi legat de multe alte entități, iar fiecare legătură adaugă o muchie nouă în graf.
O înregistrare publică Wikidata arată un triplet: subiectul Douglas Adams, predicatul instanță a și obiectul om (captură de ecran de pe wikidata.org).
Ontologia este planul grafului. Ea definește ce tipuri de entități există, ce relații sunt permise și ce reguli se aplică, de exemplu faptul că fiecare comandă trebuie să conțină cel puțin un produs. Astfel, graful rămâne coerent, iar software-ul poate raționa pe baza lui, în loc să ghicească.
Cum sunt stocate și interogate grafurile de cunoștințe?
Grafurile de cunoștințe trăiesc de obicei în baze de date de tip graf sau în depozite de triplete, precum Neo4j, Amazon Neptune sau GraphDB. Aceste sisteme sunt construite pentru a trece de la un nod la vecinii lui, apoi la vecinii acestora, lucru greu de exprimat într-o bază de date relațională tradițională atunci când lanțul de relații este lung.
Această parcurgere pe mai mulți pași este principala forță a unui graf. O întrebare de tipul care furnizori ai unui produs deservesc și un concurent cere mai multe joncțiuni într-un model tabelar, în timp ce un graf urmează pur și simplu muchiile dintre nodurile implicate.
Cu ce diferă grafurile de cunoștințe de o bază de date obișnuită?
O bază de date obișnuită stochează datele în tabele și tratează relațiile ca joncțiuni calculate la rularea unei interogări. Un graf de cunoștințe stochează relațiile ca date de sine stătătoare, astfel încât conexiunile pot fi parcurse, adăugate și explicate direct. Motoarele de căutare și sistemele de inteligență artificială folosesc acest lucru pentru a răspunde la întrebări care depind de felul în care se leagă mai multe fapte.
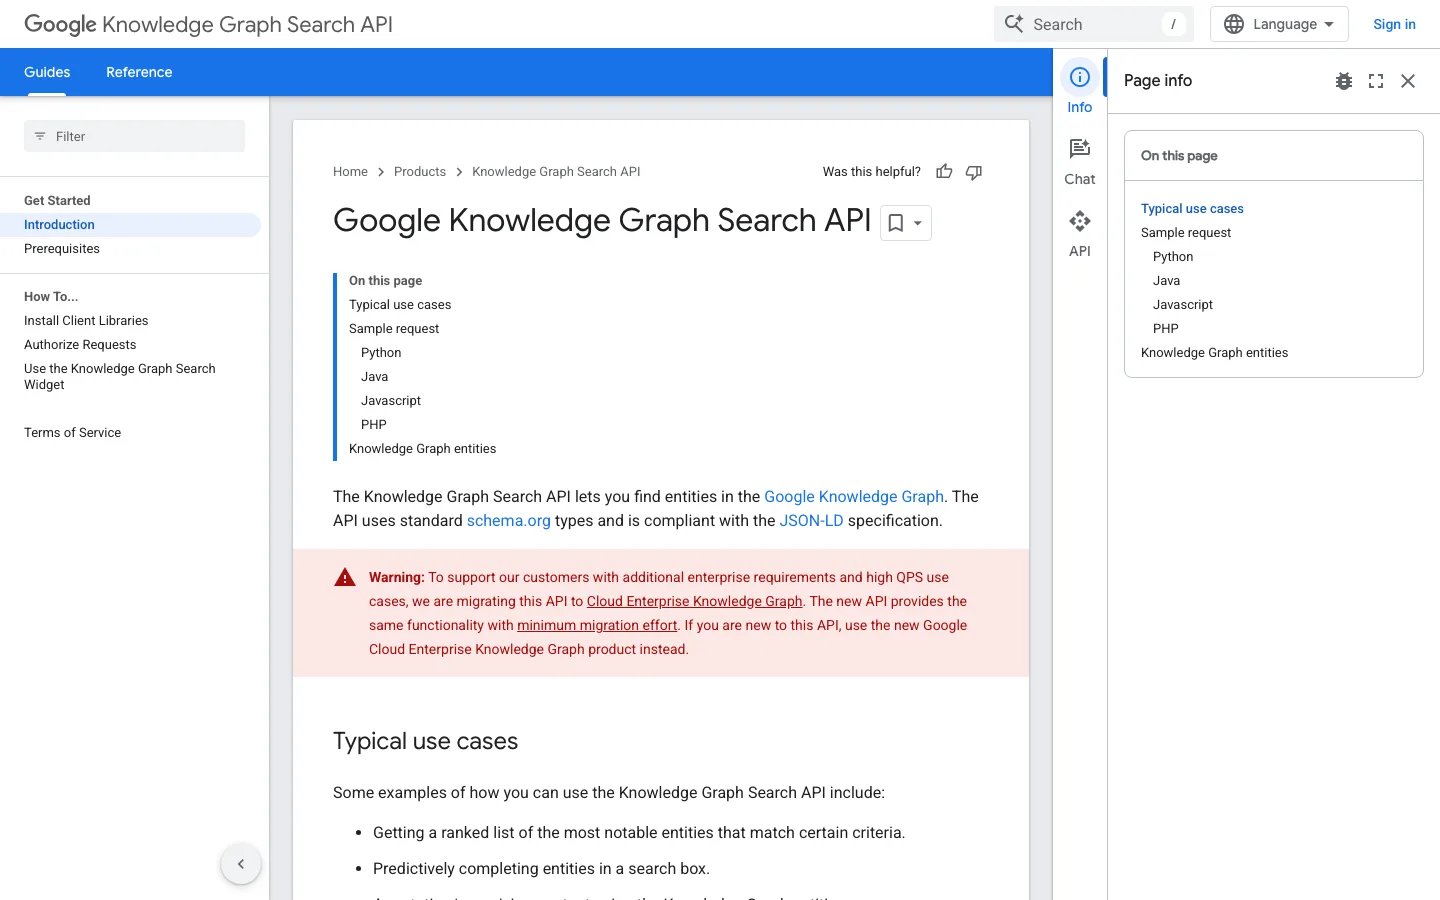
Dezvoltatorii pot interoga și graful Google. Knowledge Graph Search API vă permite să găsiți entități în Google Knowledge Graph, folosește tipurile standard schema.org și returnează JSON-LD. Documentația avertizează și că Google migrează această interfață către Cloud Enterprise Knowledge Graph, așa că verificați opțiunile actuale înainte de a construi pe ea. Captura de mai jos arată partea de sus a acestei pagini de documentație.
Documentația Google pentru API-ul Knowledge Graph Search (captură de ecran de pe developers.google.com).
Cum combină GraphRAG un graf cu un model de limbaj?
Generarea augmentată prin recuperare găsește de obicei pasaje cu formulări asemănătoare, iar modelul le asamblează. GraphRAG adaugă la acest proces un graf de cunoștințe. Sistemul recuperează un set conectat de entități și relații conexe, apoi transmite această structură modelului ca context.
Beneficiile sunt practice. Un graf care consemnează că un produs are Piesa A și Piesa B îi permite modelului să enumere exact aceste piese. Multe fluxuri asociază de asemenea grafurile cu căutarea vectorială: embedding-urile găsesc text similar, iar graful verifică modul în care se leagă faptele.
Cum reduc grafurile de cunoștințe halucinația AI?
Grafurile de cunoștințe reduc halucinația AI limitând răspunsul la relațiile care există deja în date. Când graful nu are nicio legătură între două fapte, modelul are mai puțin spațiu să inventeze una. Efectul este cel mai puternic la întrebările precise, unde o conexiune greșită costă mult.
Structura face și răspunsurile trasabile. Fiecare afirmație poate fi legată de nodurile și muchiile care o susțin, astfel încât o echipă poate verifica de ce a răspuns sistemul astfel. Regăsirea doar pe bază de text face această cale mult mai greu de verificat. Un graf nu elimină singur erorile, totuși: un triplet greșit produce un răspuns greșit cu aceeași încredere ca unul corect.
Greșeli frecvente cu grafurile de cunoștințe
Ocolirea ontologiei: fără tipuri de entități și reguli convenite, aceeași idee ajunge stocată în mai multe forme, iar graful își pierde coerența.
Folosirea numelor ca identificatori: „Jaguar” poate fi o marcă de mașini sau un animal, așa că fiecare entitate are nevoie de un ID unic înainte de a-i adăuga relațiile.
Fapte contradictorii între pagini: când o pagină indică un an al înființării pe care altă pagină îl contrazice, mașinile nu pot ști ce fapt să aibă încredere.
Marcaj care nu corespunde paginii: datele structurate care descriu fapte pe care pagina vizibilă nu le arată fac pagina mai greu de crezut.
Așteptarea ca un graf să înlocuiască conținutul: un graf organizează faptele, dar paginile au nevoie în continuare de răspunsuri clare la întrebările pe care oamenii le caută efectiv.
De ce contează grafurile de cunoștințe pentru SEO și GEO?
Grafurile de cunoștințe răsplătesc conținutul pe care mașinile îl pot descompune în entități și relații. Când paginile dvs. își numesc clar entitățile, folosesc marcajul schema și păstrează faptele coerente, motoarele de căutare și sistemele de inteligență artificială pot asocia brandul dvs. cu graful pe care se bazează. Aceasta este ideea centrală a SEO pe entități.
Grafurile de cunoștințe transformă faptele împrăștiate într-o structură conectată pe care mașinile o pot interoga și pe baza căreia pot raționa, de aceea stau în spatele multor răspunsuri AI corecte. Prin codificarea explicită a entităților și relațiilor, reduc halucinațiile, susțin raționamentul în mai mulți pași și fac rezultatele mai ușor de urmărit. Păstrați faptele proprii coerente și clar denumite, astfel încât brandul dvs. să se potrivească grafurilor pe care motoarele de căutare și asistenții AI le folosesc deja.
Care este diferența dintre un graf de cunoștințe și o bază de date obișnuită?
O bază de date obișnuită stochează datele în tabele și calculează relațiile la rularea unei interogări. Un graf de cunoștințe stochează relațiile ca date, astfel încât conexiunile pot fi parcurse, adăugate și explicate direct.
Ce este GraphRAG și cu ce diferă de RAG-ul obișnuit?
Generarea augmentată prin recuperare obișnuită găsește pasaje de text cu formulări asemănătoare. GraphRAG adaugă un graf de cunoștințe, astfel încât sistemul recuperează un set conectat de entități și relații în loc de fragmente izolate, iar răspunsul se bazează pe fapte structurate.
Ajută grafurile de cunoștințe conținutul meu să fie citat de AI?
Indirect, da. Paginile cu entități clare, fapte coerente și date structurate valide sunt mai ușor de asociat cu grafurile folosite de motoarele de căutare și de sistemele AI. Informația clară și de încredere are mai multe șanse să fie afișată și citată.
“Am testat Sorank pe un site real de client și este incredibil. Face tot ce o agenție ți-ar factura 1500$ pe lună. Acum este deja în producție la acel client.”Guillaume Guersanguersanguillaume.com
“Suntem o agenție de publicitate și am vrut să punem în sfârșit SEO-ul pe picioare. Sorank ne-a oferit o viziune clară asupra site-ului nostru, ne-a ajutat să prioritizăm optimizările și să ne structurăm conținutul corect. Instrumentul este ușor de utilizat, bine gândit pentru o echipă și foarte practic pentru a centraliza urmărirea fără să jonglăm între mai multe platforme. O bază foarte solidă pentru a începe din nou cu SEO-ul nostru.”Gaspard MadouiAgenție de publicitate
Dominiqueflight-sensations-idf.comAgrement și aviație
“Am lăsat pur și simplu software-ul Sorank să își facă treaba, iar acum DR-ul meu este 25 și pagina mea se clasează mai sus.”Lucas Flandrefoundertrace.fr
“M-am specializat în GEO datorită Sorank. Clasamentul GEO îmi permite să îmi arăt clienții poziția față de concurenți în ChatGPT. Este un avantaj comercial real.”MélanieFreelancer SEO
“Serviciu excelent, funcționează bine pentru site-ul nostru și ne ajută să înțelegem cum să îl îmbunătățim pentru a ne clasa mai bine pe Google și în alte părți. Felicitări, continuați așa, vă recomand.”Hugo T.Comerciant e-commerce