Datenschutz ist uns wichtig. Deshalb können Sie bestimmte Speicherarten deaktivieren, die für die grundlegende Funktion der Website nicht erforderlich sind. Das Blockieren einzelner Kategorien kann Ihr Erlebnis auf der Website beeinträchtigen. Weitere Informationen (Cookie-Richtlinie)
Vielen Dank! Ihre Auswahl wurde gespeichert.
Hoppla! Beim Absenden des Formulars ist ein Fehler aufgetreten.
Abstrakte Illustration von vier blauen Phasen, die in einer Schleife um einen aufsteigenden Pfeil angeordnet sind, als Bild für ein GEO-Flywheel.
Werkzeuge
Auf dieser Seite
Kurz gesagt
Ein GEO-Flywheel ist eine wöchentliche Schleife. Sie messen, in welchen KI-Antworten Ihre Marke genannt wird, verändern die Seiten und externen Quellen, die diese Antworten bestimmen, und messen dann erneut. Jeder Durchlauf liefert die Daten für den nächsten, sodass die Arbeit mit der Zeit leichter wird. KI-Antworten verschieben sich ständig, deshalb verliert ein einmaliges Audit an Wert, während eine Schleife Sie auf dem neuesten Stand hält.
3 Tage kostenlos, danach beenden Sie jederzeit. 90-Tage-Ergebnisgarantie, es gelten Bedingungen.
Was ein GEO-Flywheel ist
Generative Engine Optimization (GEO) bedeutet, dass Ihre Marke in Antworten von ChatGPT, Claude, Gemini und Perplexity genannt, zitiert oder empfohlen wird. Ein Flywheel ist eine Art, diese Arbeit so zu organisieren, dass jede Runde die nächste günstiger macht. Der Name stammt vom schweren Schwungrad alter Maschinen: Es braucht Kraft zum Anlaufen und dreht sich danach mit immer weniger Antrieb weiter.
Die Metapher kann täuschen. Ein Flywheel bedeutet nicht „mehr veröffentlichen und abwarten“. Es bedeutet vier Phasen in fester Reihenfolge, wobei das Ergebnis einer Phase die Grundlage der nächsten ist. Sie messen, wo Sie erscheinen. Sie verändern, was die Antwort bestimmt. Sie erhalten Erwähnungen auf den Quellen, die die Antworten ohnehin verwenden. Sie aktualisieren, was veraltet ist, und Ihre Messungen zeigen, was als Nächstes zu tun ist.
Die meisten GEO-Ratgeber behandeln das noch wie ein Projekt: einmal prüfen, die Liste abarbeiten, einen Bericht schreiben, weitermachen. Für eine kaputte Website funktioniert das. Für KI-Antworten passt es nicht, denn die Modelle aktualisieren ihre Quellen und ihre Formulierungen ständig. Dieselbe Frage kann im nächsten Monat eine andere Gruppe von Marken nennen, auch wenn Sie auf Ihrer Seite nichts geändert haben.
Einmaliges Projekt oder Flywheel
Einmaliges Projekt
Einmal prüfen, dann aufhören
Ergebnisse verblassen, wenn sich die Antworten ändern
Keine Aufzeichnung darüber, was funktioniert hat
Flywheel
Jede Woche messen
Jede Runde nutzt die Daten der letzten Runde
Die Gewinne summieren sich über Monate
Wenn Sie das vollständige Setup für ChatGPT, Claude und Gemini wollen, behandelt die Seite GEO-Optimierung die Werkzeuge. Dieser Artikel handelt von der Schleife selbst, dem Teil, der das Setup auch nach dem ersten Monat nützlich hält.
Warum die Sichtbarkeit in KI-Antworten nachlässt
Beginnen wir mit Google, weil dessen Position am einfachsten ist. In seiner Search-Central-Dokumentation schreibt Google, dass es für Erscheinungen in AI Overviews oder im KI-Modus „keine zusätzlichen Anforderungen“ gibt und dass man für diese Funktionen keine „neuen maschinenlesbaren Dateien, KI-Textdateien oder Markup“ braucht (Google Search Central, KI-Funktionen und Ihre Website). Ihre Seite muss indexiert sein und einen Ausschnitt anzeigen dürfen. Darüber hinaus gelten die üblichen Regeln für gute Inhalte.
ChatGPT, Claude und Perplexity veröffentlichen weniger Vorgaben als Google, deshalb lernen Sie ihr Verhalten durch Messen. Ihre Antworten hängen davon ab, was sie abrufen, was sie bereits über Ihre Marke wissen und was andere Websites über Sie sagen. Drei Dinge lassen diese Antworten veralten:
Das Modell ändert sich. Eine neue Version, ein neues Abrufsystem oder eine neue Quellenbewertung kann Ihre Marke aus einer Antwort verdrängen, ohne dass Sie etwas verändert haben.
Das Web ändert sich. Ein Wettbewerber veröffentlicht einen besseren Vergleich, eine Bewertungsseite aktualisiert ihre Liste, oder ein Forenthread wird älter und schärfer.
Ihre Seiten ändern sich. Ein Preis, eine Funktion oder eine Berufsbezeichnung ist nicht mehr aktuell, und das Modell wiederholt die alte Version.
Die folgende Tabelle ordnet jede Ursache dem Symptom zu, das Sie zuerst bemerken werden.
Ursache
Symptom, das Sie zuerst sehen
Erste Prüfung
Modell-Update
Die Sichtbarkeit sinkt in einem Modell und bleibt in den anderen stabil
Dieselben Prompts in den anderen Modellen erneut ausführen, dann einen Prüfzyklus abwarten
Wettbewerber veröffentlicht
Ein Konkurrent taucht in Antworten auf, in denen Sie genannt wurden
Die von der Antwort zitierte Seite öffnen und notieren, was dort steht und bei Ihnen fehlt
Ihre Seite ist veraltet
Die Antwort wiederholt einen alten Preis, eine alte Funktion oder ein altes Datum
Das Datum der letzten Aktualisierung und jede Zahl auf der Seite prüfen
Eine Quelle ändert sich
Eine Bewertungsseite oder ein Forenthread taucht in den Antworten nicht mehr auf
Die diese Woche zitierten Quellen mit denen des letzten Monats vergleichen
Eine Schleife löst genau dieses Problem. Jeder Zyklus erkennt den Verfall früh, und jeder Zyklus hinterlässt eine Aufzeichnung darüber, was sich verändert hat. Ein einmaliges Audit liefert eine Momentaufnahme. Eine Schleife liefert einen Trend, und auf einen Trend kann man reagieren.
Das GEO-Flywheel: Jede Runde der Schleife baut auf den Daten der vorherigen auf.
Die vier Phasen der Schleife
Die Schleife hat vier Phasen: Messen, Aufbauen, Gewinnen und Aktualisieren. Die Namen sind bewusst schlicht gewählt. Sie sollten in einem Satz sagen können, was Sie diese Woche tun.
Das GEO-Flywheel in vier Phasen
MessenEin festes Prompt-Panel in jedem Modell abfragen und notieren, wer genannt wird.
AufbauenDie Aussagen und Fakten auf Ihren Seiten so umschreiben, dass ein Modell sie zitieren kann.
GewinnenErreichen, dass Ihre Marke auf den Quellen genannt wird, die die Antworten ohnehin zitieren.
AktualisierenVeraltetes korrigieren, die Änderung protokollieren und erneut messen.
Jede Phase hat Kosten und Nutzen. Messen kostet Zeit und liefert eine Ausgangsbasis. Aufbauen kostet Schreibzeit und verändert, was Modelle zitieren können. Gewinnen kostet Outreach und verändert, welche Quellen Sie erwähnen. Aktualisieren kostet Prüfzeit und hält die anderen drei ehrlich. Lassen Sie eine Phase aus, dreht sich die Schleife trotzdem, aber blind, oder sie hört auf, besser zu werden.
Die folgenden Abschnitte gehen jede Phase der Reihe nach durch, mit den genauen Schritten und den häufigsten Fehlern.
Phase 1, Messen: jede Woche ein Prompt-Panel laufen lassen
Ein Prompt-Panel ist eine feste Liste von Fragen, die jede Woche in jedem Modell gleich gestellt werden. Fest heißt: gleicher Wortlaut. Ändern Sie die Frage, können Sie nicht mehr sagen, ob sich eine Antwort wegen des Modells oder wegen Ihrer Formulierung verändert hat.
Wählen Sie 20 bis 30 Prompts, die Kunden tatsächlich eintippen
Schreiben Sie Prompts so, wie ein Kunde sie tippt, nicht so, wie ein Marketer eine Kategorie benennt. „Beste Buchhaltungssoftware für eine Agentur mit fünf Personen“ sagt mehr als „Buchhaltungssoftware“. Mischen Sie drei Arten von Prompts:
Kategorie-Prompts: „bestes X für Y“. Sie zeigen, ob Sie überhaupt auf der Shortlist stehen.
Vergleichs-Prompts: „X gegen Y“. Sie zeigen, wie das Modell Sie gegenüber einem Mitbewerber einordnet.
Problem-Prompts: „wie behebe ich Z“. Sie zeigen, ob Sie als Hilfequelle zitiert werden und nicht nur als Produkt.
Holen Sie die Formulierungen aus Verkaufsgesprächen, Support-Tickets und den langen Fragen in Ihren Analysen. Kunden stellen auch nach dem Kauf eine Frage: „Lohnt sich das?“, „Was ersetzt das?“. Solche Prompts nennen oft einen Wettbewerber, den der Kunde sich bereits angesehen hat. Für einen strukturierten Weg, die Liste aufzubauen, lesen Sie die Funktion KI-Prompt-Recherche und den Leitfaden zu KI-Prompts.
Halten Sie die ganze Antwort fest, nicht nur Ja oder Nein
Ein Ja oder Nein verbirgt den größten Teil des Signals. Notieren Sie für jeden Prompt und jedes Modell die Felder der Tabelle. Behalten Sie die Tabelle jede Woche in derselben Reihenfolge, damit Sie Zeilen über die Zeit vergleichen können.
Feld
Was Sie notieren
Warum es wichtig ist
Prompt
Der genaue Wortlaut, den Sie verwendet haben
Derselbe Wortlaut jede Woche macht die Ergebnisse vergleichbar
Modell
ChatGPT, Claude, Gemini oder Perplexity
Jedes Modell zitiert andere Quellen
Genannt
Ja oder nein
Das ist Ihre Hauptzahl
Position
Erste, zweite, später oder nicht aufgeführt
Eine späte Erwähnung zählt weniger als eine an erster Stelle
Satz
Die Zeile, die Sie nennt, wortwörtlich kopiert
Sie zeigt, wie das Modell Sie beschreibt, und das kann falsch sein
Quellen
Die URLs, die die Antwort zitiert
Sie zeigen, wo Sie Erwähnungen gewinnen können
Wettbewerber
Die Marken, die an Ihrer Stelle genannt werden
Sie zeigen Ihr tatsächliches Wettbewerbsumfeld
Werten Sie das Panel als Anteil aus. Wenn Sie in 9 von 25 Antworten genannt werden, liegt Ihr Anteil bei 36 %. Behalten Sie den Anteil auch pro Modell im Blick, denn die vier Modelle zitieren unterschiedliche Quellen und widersprechen sich oft.
Führen Sie jeden Prompt mehr als einmal aus
Modelle antworten auf dieselbe Frage von einem Lauf zum nächsten unterschiedlich. Eine Antwort pro Prompt ist eine Stichprobe von eins. Führen Sie jeden Prompt pro Modell mindestens zweimal aus und bilden Sie den Durchschnitt. Kleine Panels reagieren empfindlich: Bei 25 Prompts entspricht eine einzige Antwort 4 Prozentpunkten Anteil. Beurteilen Sie den Trend über vier Wochen, nicht die Änderung einer einzelnen Woche.
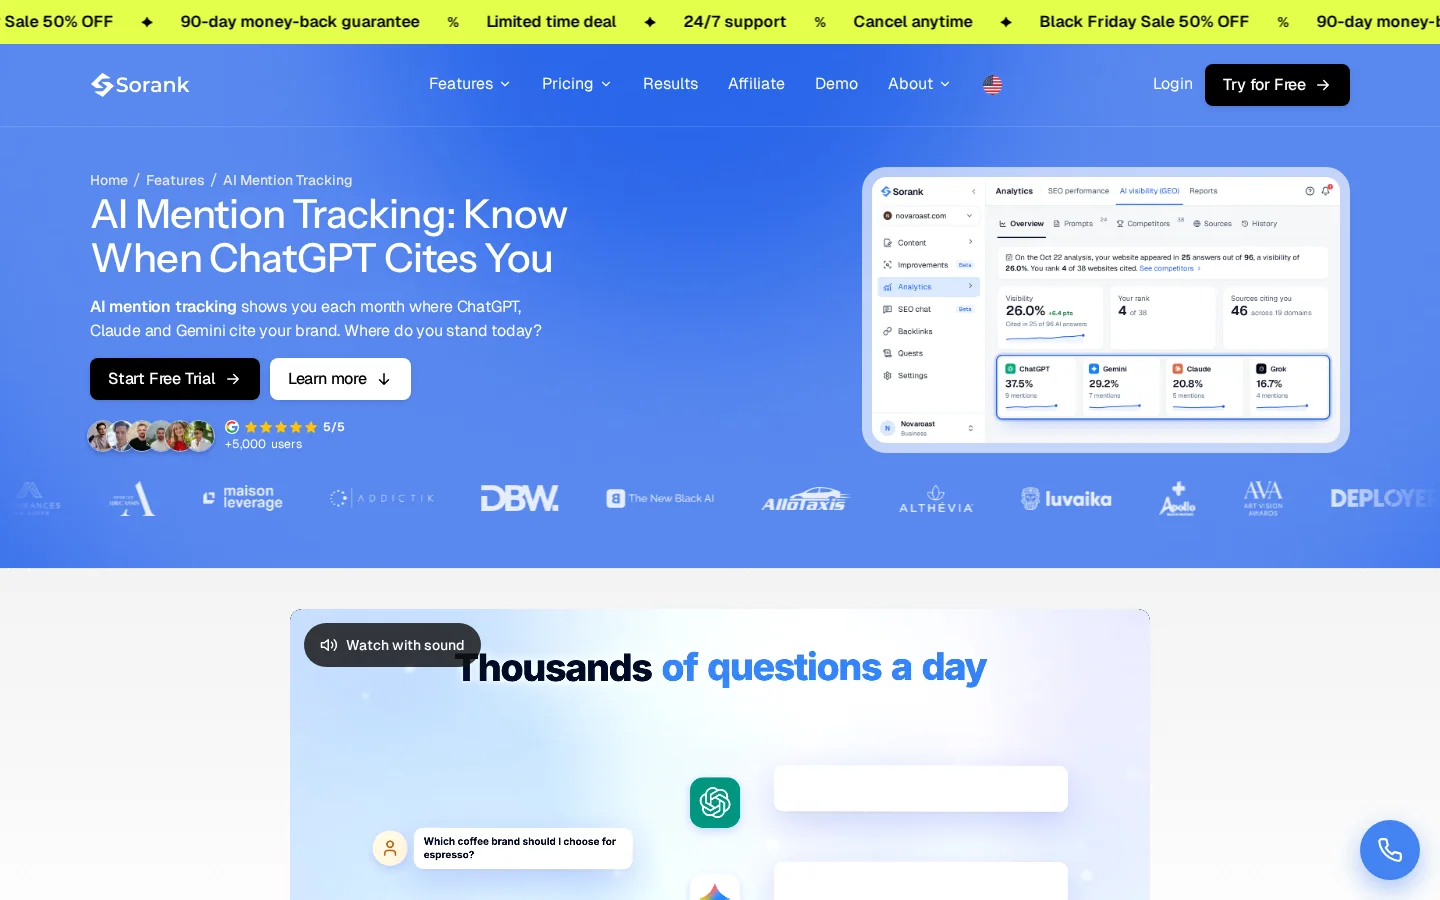
Ein Werkzeug kann das für Sie übernehmen. Die Funktion zur KI-Erwähnungsverfolgung folgt derselben Idee: Sie verfolgt jeden Prompt und zeigt, wann eine KI Sie zitiert.
KI-Erwähnungsverfolgung: Sehen Sie, wann eine KI Sie zitiert, Prompt für Prompt.
Phase 2, Aufbauen: Seiten schreiben, die ein Modell zitieren kann
Modelle zitieren die Teile einer Seite, die für sich allein stehen. Ihre Aufgabe in dieser Phase ist es, jeden Abschnitt leicht herauslösbar zu machen, ohne die Seite in eine Liste von Schlagwörtern zu verwandeln. Beginnen Sie mit den Seiten, die in Ihrer Ausgangsmessung die meisten Prompts gewonnen haben, und heben Sie den Rest für später auf.
Erst die Aussage, dann der Beleg
Beginnen Sie jeden Abschnitt mit der Antwort und liefern Sie dann den Beleg. Der Grund liegt in der Position. In „Lost in the Middle: How Language Models Use Long Contexts“ untersuchten Liu und Kollegen (2023, arXiv 2307.03172), wie Sprachmodelle lange Eingaben nutzen. Sie stellten fest, dass die Leistung oft am höchsten ist, wenn relevante Informationen am Anfang oder Ende der Eingabe stehen, und dass sie sinkt, wenn der Kerninhalt in der Mitte vergraben ist. Eine Webseite ist kein Prompt, und ein Abrufsystem ist nicht ihr Testaufbau. Die Lehre gilt für das Schreiben trotzdem: Die ersten Zeilen eines Abschnitts haben das größte Gewicht.
Vergleichen Sie zwei Fassungen derselben Aussage:
Schwach: „Tracking hilft Ihnen, Ihre Sichtbarkeit zu verstehen.“
Stark: „Verfolgen Sie 25 Prompts in vier Modellen, und Sie erhalten eine Zahl: den Anteil der Antworten, die Ihre Marke nennen.“
Die starke Fassung gibt dem Modell einen Satz, den es vollständig zitieren kann, mit Geltungsbereich, Zahl und Methode. Die schwache Fassung zwingt das Modell zu raten, was Sie meinen, und ein Modell, das rät, lässt Sie meist weg.
Ergänzen Sie Quellen, Zitate und Statistiken
Das GEO-Paper ist das Nächste, was dieses Feld einem kontrollierten Test hat. Aggarwal und Kollegen (KDD 2024, arXiv 2311.09735) entwickelten einen Benchmark für Antworten generativer Suchmaschinen und testeten Textänderungen: Quellen angeben, Zitate hinzufügen und Statistiken ergänzen. Sie maßen, wie viel jeder generierten Antwort auf dem Quelltext beruhte. Das Paper nennt für GEO in seinem Benchmark eine Steigerung der Sichtbarkeit um bis zu 40 %.
Die Zahlen im Block unten stammen aus den eigenen Tabellen des Papers. Das GEO-bench-Setup nutzte eine von Google abgeleitete Konfiguration mit einer generativen Engine auf Basis von GPT-3.5. Die Ergebnisse für Perplexity.ai stammen aus einem separaten Test. In beiden Fällen beziehen sich die Gewinne auf den Ausgangstext dieses Setups, nicht auf absoluten Traffic.
Beste Methoden gegenüber dem Ausgangstext, im GEO-Paper
41 %Gewinn bei Position-Adjusted Word Count, GEO-bench
28 %Gewinn bei Subjective Impression, GEO-bench
22 %Gewinn bei Position-Adjusted Word Count, Perplexity.ai
37 %Gewinn bei Subjective Impression, Perplexity.ai
Quelle: Aggarwal et al., „GEO: Generative Engine Optimization“, KDD 2024, Tabellen 1 und 7 (arXiv 2311.09735)
Lesen Sie die Zahlen als Richtung, nicht als Prognose. Das Paper hat seine eigenen Anfragen und Modelle gewählt, und Ihre Kategorie kann sich anders verhalten. Was die Zahlen tatsächlich stützen, ist eine praktische Gewohnheit. Nennen Sie wo möglich die Primärquelle jeder Zahl, ergänzen Sie die genaue Zahl mit Datum und ordnen Sie eine Aussage der Person oder dem Dokument zu, das dahintersteht. Ein Satz mit einer datierten Zahl und einer benannten Quelle ist schwerer zu übergehen als „allgemein anerkannt“.
Nutzen Sie strukturierte Daten und verzichten Sie auf die Datei, die nichts bringt
Strukturierte Daten sagen Crawlern, was eine Seite ist: Titel, Autor und Datum. Sie bewirken nicht, dass ein Modell Sie zitiert. Sie beseitigen aber Zweifel darüber, wer die Seite geschrieben hat und wann sie zuletzt geprüft wurde. Der Block unten ist eine minimale Beschreibung eines Artikels. Fügen Sie ihn über Ihr CMS oder Ihre Vorlage ein und testen Sie ihn mit dem Validator für strukturierte Daten.
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "GEO-Flywheel: Eine wöchentliche Schleife, die Ihre KI-Sichtbarkeit aufbaut",
  "author": {"@type": "Person", "name": "Thibault Besson-Magdelain"},
  "datePublished": "2026-11-19",
  "dateModified": "2026-11-19"
}
Warnung
Sie können lesen, dass eine Datei llms.txt der erste Schritt zur KI-Zitierung sei. Google sagt, dass seine KI-Funktionen eine solche Datei nicht brauchen. Legen Sie eine an, wenn Sie möchten, behandeln Sie sie aber als kleine Aufgabe außerhalb der Schleife. Sie ersetzt keine klaren, belegten und aktuellen Aussagen.
Phase 3, Gewinnen: auf den Quellen genannt werden, die die Antworten ohnehin nutzen
Modelle bilden sich selten ein Bild Ihrer Marke allein aus Ihrer Website. Sie lesen auch andere Seiten. Eine Aussage an einer einzigen Stelle lässt sich leicht übersehen, dieselbe Aussage auf mehreren unabhängigen Seiten wird dagegen leichter wiederholt. Darum geht es in der Phase Gewinnen: Sie erweitern die Menge der Quellen, die das Richtige über Sie sagen.
Beginnen Sie bei den Quellen, die die Antworten zitieren
Ihr Panel zeigt Ihnen bereits, wohin Sie gehen müssen. Öffnen Sie die Quellen, die in jeder Antwort zitiert werden, und listen Sie die URLs auf. Gruppieren Sie sie nach Typ: Bewertungsseiten, Vergleichsartikel, Fachmedien, Community-Threads, Verzeichnisse. Lesen Sie dann jede Seite und stellen Sie drei Fragen:
Nennt die Seite Ihre Marke, einen Wettbewerber oder niemanden?
Wann wurde sie zuletzt aktualisiert, und enthält sie eine Zahl, die heute falsch ist?
Wer betreibt die Seite, und was können Sie dem Betreiber Nützliches anbieten: eine Zahl, eine Korrektur, ein Fallbeispiel?
Am wertvollsten ist eine Seite, die Ihre Wettbewerber nennt und Sie nicht. Eine Seite mit einer veralteten Zahl kommt an zweiter Stelle. Schicken Sie der Redaktion die richtige Zahl mit ihrer Quelle, in zwei oder drei Zeilen. Eine belegte Korrektur wird leichter angenommen als eine allgemeine Anfrage, weil sie die Seite verbessert, ohne etwas im Gegenzug zu verlangen.
Halten Sie bezahlte Platzierungen aus dieser Phase heraus. Eine gesponserte Zeile, die eine Erwähnung in KI-Antworten verspricht, kann gegen Googles Regeln für Links verstoßen, und sie hinterlässt keine Spur, die Sie später verteidigen könnten. Die Risiken und sichereren Optionen behandelt Sollten Sie Backlinks kaufen? Risiken, Googles Regeln und sicherere Alternativen.
Verlinken Sie bewusst innerhalb Ihrer eigenen Website
Die eigene Website ist der erste Ort, an dem ein Modell und ein Crawler nach Tiefe suchen. Interne Links zeigen Crawlern, welche Seiten wichtig sind, und Lesern, wohin sie als Nächstes gehen können. Die Search-Central-Dokumentation von Google behandelt die Grundlagen. Dort heißt es, dass „jede Seite, die Ihnen wichtig ist, mindestens einen Link von einer anderen Seite Ihrer Website haben sollte“, und dass Google „Ihren Link nur folgen kann, wenn es sich um ein HTML-Element <a> handelt“ (Google Search Central, Best Practices für Links in der Google-Suche).
Der Ankertext ist genauso wichtig wie der Link. Googles Hinweis lautet, dass „guter Ankertext beschreibend, angemessen kurz und relevant für die Seite ist, auf der er steht“. So sieht ein Link aus, der dieser Empfehlung folgt:
<a href="/de/der-geo-seo-blog/ki-sichtbarkeitsoptimierung">wie Sie von ChatGPT, Gemini und Perplexity genannt werden</a>
Vermeiden Sie „weiterlesen“ und „hier klicken“. Der Ankertext ist der einzige Teil des Links, der Lesern und Crawlern sagt, worum es auf der Zielseite geht. Dieselbe Empfehlung besagt, dass es keine magische ideale Linkzahl pro Seite gibt, aber: „Wenn Sie denken, es sind zu viele, dann sind es wahrscheinlich zu viele.“ Setzen Sie die Links, die dem Leser helfen, und hören Sie dort auf.
Bauen Sie Knotenpunkte, keine Haufen. Eine Hub-Seite behandelt ein Thema breit und verlinkt auf unterstützende Seiten, die tiefer gehen. Diese Struktur ist ein Themencluster, der im Eintrag Themencluster definiert wird, und sie funktioniert am besten, wenn jede unterstützende Seite zurück zur Hub-Seite verlinkt. Für die Planung lesen Sie Content-Säulen. Die Funktion Themencluster-Generator plant die Struktur für Sie, ohne sich überschneidende Seiten.
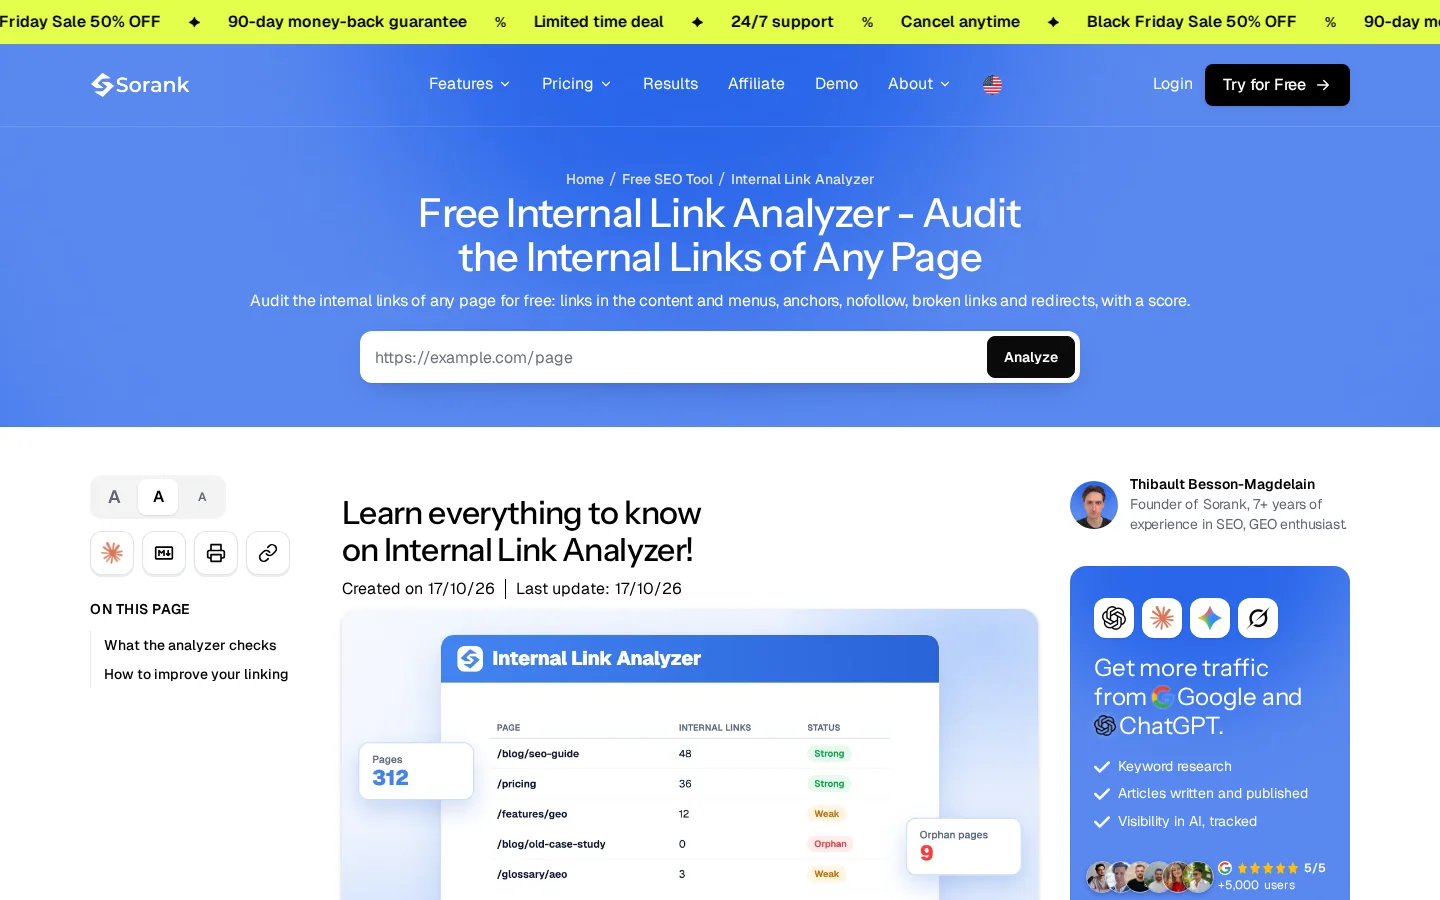
Um die bestehenden Links zu prüfen, kontrolliert der Analysator für interne Links die internen Links jeder Seite.
Der kostenlose Analysator für interne Links prüft die internen Links jeder Seite.
Tipp
Lassen Sie den Analysator zuerst auf Ihrer Hub-Seite laufen. Verlinkt sie auf weniger unterstützende Seiten als erwartet, beheben Sie das, bevor Sie etwas Neues schreiben. Der Leitfaden zur Strategie für interne Verlinkung gibt die Reihenfolge der Arbeit vor.
Phase 4, Aktualisieren: veraltetes korrigieren und dann protokollieren
Aktualisieren heißt, eine Seite oder eine Quelle zu ändern, wenn die Daten es zeigen, nicht nach einem Kalender. Eine Seite, die Sie jeden Monat ohne Grund überarbeiten, sagt Ihnen nichts, und sie kann sich von den Fakten entfernen, die Sie geprüft hatten. Die Regel ist einfach: Jede Änderung hat einen Grund im Protokoll, und jeder Grund stammt aus einer Messung oder einem datierten Fakt.
Halten Sie eine wöchentliche Prüfung mit einer festen Checkliste
Verwenden Sie jede Woche dieselbe Liste, damit die Prüfung immer gleich aussieht und Sie eine Woche mit der nächsten vergleichen können.
Wöchentliche Prüfung
Anteil der Antworten, die Sie nennen, pro Modell
Für jede verlorene Erwähnung die Quelle, die die Antwort in dieser Woche zitiert hat
Für jeden neuen Wettbewerber die Seite, die ihm die Erwähnung eingebracht hat
Seiten mit einem Datum oder einer Zahl, die älter ist als die letzte Prüfung
Eine Neufassung der ganzen Website wegen einer schlechten Woche
Halten Sie die Prüfung kurz. Lesen Sie die Änderungen, wählen Sie ein oder zwei Maßnahmen und hören Sie auf. Die Schleife lebt vom Rhythmus mehr als von der Größe jeder Runde. Wöchentlich reicht für die meisten Websites. Tägliche Ergebnisse enthalten meist vor allem Rauschen, und eine monatliche Prüfung lässt zwischen den Kontrollen zu viel Verfall auflaufen.
Diagnostizieren Sie den Rückgang, bevor Sie handeln
Ein Rückgang hat eine Ursache, und die Ursache bestimmt die Maßnahme. Nutzen Sie diese Tabelle, bevor Sie eine Seite anfassen.
Symptom
Wahrscheinliche Ursache
Maßnahme
Rückgang in allen vier Modellen gleichzeitig
Ihre Website hat sich geändert, oder Crawler erreichen eine wichtige Seite nicht mehr
Indexierung und Ihre robots-Regeln prüfen (siehe robots.txt für KI-Crawler), dann Ihre letzte Änderung durchsehen
Rückgang nur in einem Modell
Dieses Modell hat sein Modell oder seine Quellen geändert
Einen Prüfzyklus abwarten, dann mit den anderen drei vergleichen, bevor Sie etwas ändern
Ein Wettbewerber taucht in neuen Antworten auf
Er hat eine neue Quelle veröffentlicht oder gewonnen
Die von der Antwort zitierte Seite lesen und eine bessere Antwort auf dieselbe Frage planen
Negative Formulierung in einer Antwort
Ein alter Test, ein Forenthread oder ein veralteter Fakt
Die zitierte Seite finden, den Fakt an seiner Quelle korrigieren oder mit eigenen Belegen richtigstellen
Protokollieren Sie jede Änderung, damit die nächste Runde aus dieser lernt
Das Protokoll ist der Teil des Flywheels, den die meisten Teams auslassen, und genau er lässt die Schleife wachsen. Halten Sie für jede Änderung das Datum, die Seite oder Quelle, was sich geändert hat und welche Prompts davon betroffen sein sollten, fest. Nach vier bis sechs Wochen haben Sie eine Aufzeichnung, die zeigt, welche Arten von Änderungen Ihren Anteil bewegt haben. Diese Aufzeichnung entscheidet über die Arbeit der nächsten Runde.
Wenn sich Antworten aus Gründen verschieben, die Sie nicht erklären können, zeigt der Leitfaden zur Volatilität der KI-Suche, wie Sie Rauschen von einer echten Veränderung trennen, bevor Sie etwas umschreiben.
Tipp
Bevor Sie eine Seite ändern, führen Sie das kostenlose GEO-Audit für diese Seite aus. Das Ergebnis ist Ihre Ausgangsbasis für diese Seite, sodass sich die Änderung später messen lässt.
Drei Wege, die Schleife zu betreiben, und wann welcher passt
Es gibt mehr als einen Weg, die vier Phasen zu durchlaufen. Jeder kostet unterschiedlich viel Zeit und birgt ein anderes Risiko. Wählen Sie den, der zur Größe Ihres Panels und Ihres Teams passt, und wechseln Sie erst auf einen größeren Weg, wenn der aktuelle nicht mehr mithält.
Die Tabellenkalkulations-Schleife
In dieser Variante stellt ein Mensch jeden Prompt von Hand, trägt die Antwort in eine Tabelle ein und nimmt die Änderungen vor. Das Prinzip ist, dass ein Mensch jede Antwort liest. Sie passt bis etwa 10 Prompts, ein bis zwei Modelle und ein Team aus einer Person. Ihr Vorteil: Sie kostet außer Zeit nichts, und Sie bekommen ein echtes Gefühl dafür, wie jedes Modell über Ihre Kategorie schreibt. Ihre Grenzen sind Zeit und Drift: Manuelle Läufe werden vergessen, die Formulierung schleicht sich ein, und die Tabelle wird nach einigen Monaten schwer lesbar.
Die Dashboard-Schleife
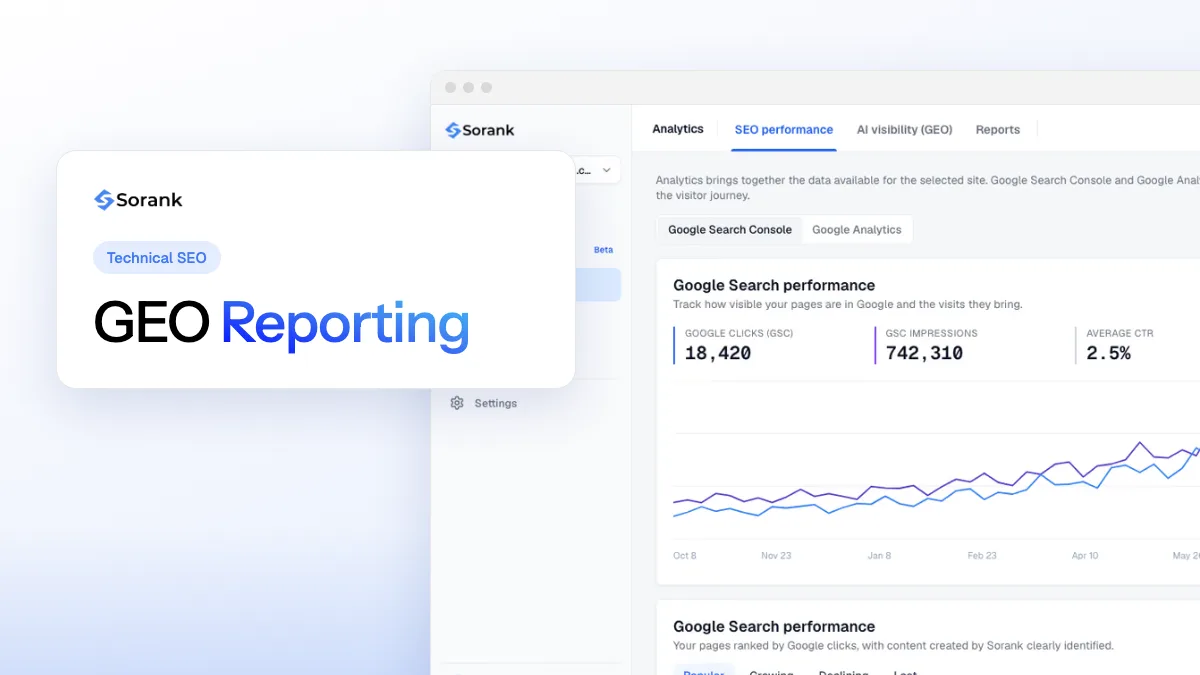
Hier führt ein Tracking-Werkzeug das Panel aus und speichert den Verlauf, und ein Mensch führt die Maßnahmen durch. Sie passt zu 20 bis 50 Prompts, mehreren Modellen und einem Team, das Inhalte schreibt. Ihr Vorteil: gleichmäßige Stichproben und eine klare Trendlinie. Ihre Grenze: Ein Dashboard zeigt die Veränderung, aber nicht die Lösung. Sie brauchen weiterhin eine Redaktion, die entscheidet, was umgeschrieben wird. Das GEO- und SEO-Dashboard führt Google- und KI-Traffic in einer Ansicht zusammen und liefert der wöchentlichen Prüfung ihre Grundlage.
Das GEO- und SEO-Dashboard zeigt Google- und KI-Traffic in einer Ansicht.
Die Autopilot-Schleife
In dieser Variante misst eine Software, erstellt oder aktualisiert Seiten und schlägt Links vor, während ein Mensch jede Änderung freigibt. Sie passt zu vielen Seiten und einem kleinen Team, das stetigen Output braucht. Ihr Vorteil: Die Schleife läuft jede Woche, ohne dass jemand sie hinterherjagen muss. Ihre Grenze: Eine falsche Regel wiederholt sich in großem Umfang. Sie brauchen eine Prüfung jeder Änderung und ein Protokoll dessen, was das System getan hat, sonst wissen Sie nicht, welche Änderung Ihren Anteil bewegt hat.
Sorank ist für die dritte Variante gebaut: Es verfolgt KI-Erwähnungen, schreibt und aktualisiert Artikel und gewinnt Links, alles im Autopilot. Egal welche Variante Sie wählen, behalten Sie die wöchentliche Prüfung. Auch ein Autopilot braucht jemanden, der kontrolliert, was sich geändert hat und warum.
Variante
Passt zu
Hauptrisiko
Wer die Arbeit macht
Tabellenkalkulations-Schleife
Bis etwa 10 Prompts, ein oder zwei Modelle
Vergessene Läufe und abdriftende Formulierung
Eine Person, von Hand
Dashboard-Schleife
20 bis 50 Prompts, mehrere Modelle
Ein klarer Trend ohne angehängte Lösung
Ein Team, das schreibt und redigiert
Autopilot-Schleife
Viele Seiten, kleines Team, stetiger Output
Eine falsche Regel wiederholt sich in großem Umfang
Software, wobei eine Person jede Änderung freigibt
Häufige Fehler und wie Sie sie beheben
Jeder Fehler unten hat drei Teile: wie er aussieht, wie Sie ihn in Ihren Daten erkennen und wie Sie ihn beheben. Beginnen Sie mit denen, die Sie wiedererkennen, und prüfen Sie die übrigen bei Ihrer ersten Prüfung.
Einmal messen und das als Ausgangsbasis bezeichnen
Wie es aussieht. Ein einziger Lauf des Panels, meist in einem Modell, gespeichert als Startpunkt für das ganze Jahr.
Wie Sie es erkennen. Ihre Tabelle hat ein einziges Datum in der Kopfzeile und keine zweite Spalte für denselben Prompt. Jede Änderung, die Sie vornehmen, wirkt wie ein Erfolg oder Misserfolg, ohne Rauschen als Vergleich.
Wie Sie es beheben. Führen Sie für die Ausgangsbasis jeden Prompt pro Modell zweimal aus, bilden Sie den Durchschnitt der beiden Läufe und bewahren Sie die rohen Antworten auf, um eine strittige Zeile nachzuprüfen. Erst dann zählt eine Änderung als Ergebnis.
Nur ein Modell verfolgen
Wie es aussieht. Das gesamte Panel läuft in ChatGPT, weil es das bekannteste Modell ist, und das Team nimmt an, dass das Ergebnis überall gilt.
Wie Sie es erkennen. Ihre Quellen-Spalte listet in jeder Zeile dieselben wenigen Domains. Die anderen Modelle nennen Sie anders oder gar nicht, und niemand hat nachgesehen.
Wie Sie es beheben. Nehmen Sie alle vier Modelle ins Panel auf. Jedes zitiert andere Quellen, daher trifft die Korrektur für eines die anderen möglicherweise nicht. Weisen Sie den Anteil pro Modell neben dem Gesamtanteil aus.
Einer neuen Datei nachjagen statt besseren Aussagen
Wie es aussieht. Das Team verbringt zwei Wochen mit einer maschinenlesbaren Datei und keine Zeit mit den Seiten, bei denen das Panel Erwähnungen verliert.
Wie Sie es erkennen. Die Phase Aufbauen enthält im Protokoll keine geänderten Absätze, nur Dateiänderungen. Die wöchentliche Prüfung zeigt überhaupt keine Seitenänderungen.
Wie Sie es beheben. Die Dokumentation von Google besagt, dass seine KI-Funktionen keine neuen maschinenlesbaren Dateien, KI-Textdateien oder Markup brauchen. Investieren Sie die Zeit in die Aussagen am Anfang jedes Abschnitts, in datierte Quellen und in interne Links, also in die Teile, die die Phase Aufbauen tatsächlich verändert.
Zehn Seiten in einer Woche ändern
Wie es aussieht. Eine große Neufassung der Website nach einer schlechten Ausgangsbasis, bei der jede Seite gleichzeitig geändert wird.
Wie Sie es erkennen. Der Anteil der folgenden Woche bewegt sich, und niemand kann sagen, welche Änderung die Ursache ist. Das Protokoll enthält einen Eintrag für zehn Seiten.
Wie Sie es beheben. Ändern Sie pro Runde einen Cluster, protokollieren Sie jede Seite einzeln und warten Sie einen vollen Prüfzyklus, bevor die nächste Änderung kommt. Eine langsamere Schleife, die Sie nachvollziehen können, ist besser als eine schnelle, die Sie nicht erklären können.
Erwähnungen durch bezahlte Platzierungen erzielen, die wie redaktionelle Inhalte aussehen
Wie es aussieht. Ein „Partnerartikel“ mit Ihrem Link und einer Erwähnung in einer KI-Antwort, ohne Kennzeichnung und ohne echte redaktionelle Prüfung.
Wie Sie es erkennen. Die Seite ist bezahlt, der Link ist nicht als gesponsert gekennzeichnet, und die Erwähnung existiert nur an dieser einen Stelle. Eine solche Erwähnung erscheint selten lange in Antworten mehrerer Modelle.
Wie Sie es beheben. Beenden Sie die Platzierung und ersetzen Sie sie durch eine Korrektur oder eine Zahl, die Sie der Redaktion einer bereits bestehenden Seite schicken. Die Regeln und sichereren Optionen stehen unter Sollten Sie Backlinks kaufen?
Generischer Ankertext
Wie es aussieht. Jeder interne Link sagt „weiterlesen“, sodass der Link Lesern und Crawlern nichts über die Zielseite verrät.
Wie Sie es erkennen. Sortieren Sie Ihre Ankertexte in einem Crawl-Bericht oder im Link-Analysator. Sind die häufigsten Anker generisch, ist das Problem systematisch.
Wie Sie es beheben. Schreiben Sie jeden Ankertext so um, dass er benennt, worauf die Zielseite antwortet. Die Änderung dauert pro Link wenige Minuten und gibt Crawlern eine klarere Landkarte.
Ein interner Link, zwei Varianten
Vorher
Ankertext: „weiterlesen“
Link einmal hinzugefügt und nie geprüft
Nachher
Ankertext: „wie Sie von ChatGPT, Gemini und Perplexity genannt werden“
Link in der wöchentlichen Prüfung protokolliert
Ihre ersten 30 Tage
Nutzen Sie diesen Plan, wenn Sie bei null anfangen. Jede Woche hat eine Hauptaufgabe, damit die Schleife startet, bevor Sie bereit sind, sie in großem Maßstab laufen zu lassen.
Ihre ersten 30 Tage
Woche 1Das Prompt-Panel aufbauen: 20 bis 30 Prompts, vier Modelle, eine Tabelle.
Woche 2Die Ausgangsbasis zweimal durchführen und jedes Feld für jede Antwort festhalten.
Woche 3Die drei wichtigsten Seiten neu aufbauen: Aussage zuerst, datierte Quellen, beschreibende interne Links.
Woche 4Korrekturen an die Quellen schicken, die die Antworten zitieren, dann die erste wöchentliche Prüfung durchführen.
Das Panel schreiben. Wählen Sie 20 bis 30 Prompts aus den Typen Kategorie, Vergleich und Problem. Legen Sie sie in eine Tabelle, mit einer Spalte pro Modell und den Feldern aus der Tabelle in Phase 1.
Die Ausgangsbasis erheben. Stellen Sie jeden Prompt zweimal in jedem Modell. Füllen Sie jedes Feld aus, einschließlich der Quellen und der Marken, die an Ihrer Stelle genannt werden.
Drei Seiten neu aufbauen. Wählen Sie die drei Seiten, die die meisten Prompts gewinnen sollten. Setzen Sie in jedem Abschnitt die Aussage an den Anfang, ergänzen Sie datierte Quellen und verlinken Sie verwandte Seiten mit beschreibendem Ankertext.
Gewinnen und prüfen. Kontaktieren Sie die Quellen, die die Antworten zitieren, mit je einer Korrektur oder einer Zahl. Führen Sie die wöchentliche Checkliste durch und protokollieren Sie jede Änderung mit Datum und Grund.
Häufig gestellte Fragen
Wie lange dauert es, bis ein GEO-Flywheel Ergebnisse zeigt?
Planen Sie mindestens zwei oder drei Runden ein, bevor Sie urteilen. Die erste Runde liefert Ihre Ausgangsbasis und einen ersten Satz Änderungen. KI-Antworten schwanken von Lauf zu Lauf, deshalb sagt eine einzelne Woche wenig. Ein Trend über vier Wochen ist das Erste, was sich lohnt zu lesen.
Brauche ich eine Datei llms.txt, um von KI zitiert zu werden?
Nein, nicht für die KI-Funktionen von Google. Google sagt, dass sie keine neuen maschinenlesbaren Dateien, KI-Textdateien oder Markup brauchen. Andere Modelle veröffentlichen weniger Vorgaben, deshalb beurteilen Sie jede Datei an Ihren eigenen Ergebnissen. Sie ist günstig zu ergänzen, gehört aber nicht zu den Phasen der Schleife.
Kann ein kleines Unternehmen ein GEO-Flywheel ohne kostenpflichtige Werkzeuge betreiben?
Ja, mit einer Tabelle und 20 Prompts. Die Grenze ist die Zeit, denn manuelle Läufe sind langsam und die Formulierung driftet. Starten Sie von Hand, finden Sie heraus, welche Prompts zählen, und wechseln Sie dann zu einem Tracking-Werkzeug, wenn das Panel die Tabelle sprengt.
Starten Sie diese Woche mit dem Panel. Schreiben Sie 20 Prompts, stellen Sie sie in vier Modellen und notieren Sie die erste Zahl. Diese Zahl ist Ihre Ausgangsbasis, und jede spätere Runde wird daran gemessen.
Häufig gestellte Fragen
Wie lange dauert es, bis ein GEO-Flywheel Ergebnisse zeigt?
Planen Sie mindestens zwei oder drei Runden ein, bevor Sie urteilen. Die erste Runde liefert eine Ausgangsbasis und einen ersten Satz Änderungen. KI-Antworten schwanken von Lauf zu Lauf, deshalb sagt eine einzelne Woche wenig, und ein Trend über vier Wochen ist das Erste, was sich lohnt zu lesen.
Brauche ich eine Datei llms.txt, um von KI zitiert zu werden?
Nein, nicht für die KI-Funktionen von Google. Google sagt, dass sie keine neuen maschinenlesbaren Dateien, KI-Textdateien oder Markup brauchen. Andere Modelle veröffentlichen weniger Vorgaben, also beurteilen Sie jede Datei an Ihren eigenen Ergebnissen. Sie ist günstig zu ergänzen, gehört aber nicht zu den Phasen der Schleife.
Kann ein kleines Unternehmen ein GEO-Flywheel ohne kostenpflichtige Werkzeuge betreiben?
Ja, mit einer Tabelle und 20 Prompts. Die Grenze ist die Zeit, denn manuelle Läufe sind langsam und die Formulierung driftet. Starten Sie von Hand, finden Sie heraus, welche Prompts zählen, und wechseln Sie dann zu einem Tracking-Werkzeug, wenn das Panel die Tabelle sprengt.
y!
Erhalten Sie kostenlos Ihren Content-Plan für 30 Tage
Wir analysieren Ihre Wettbewerber, Ihre Website und Ihre KI-Sichtbarkeit, um kostenlos einen maßgeschneiderten Content-Plan für Sie zu erstellen.
“Ich habe Sorank auf einer echten Kundenwebsite getestet, und es ist der Wahnsinn. Es macht alles, wofür eine Agentur 1.500 € im Monat berechnet. Jetzt geht es bei diesem Kunden in den Produktivbetrieb.”Guillaume Guersanguersanguillaume.com
“Wir sind eine Ads-Agentur und wollten unser SEO endgültig wieder auf Kurs bringen. Sorank hat uns eine klare Übersicht über unsere Website verschafft, uns geholfen, Optimierungen zu priorisieren und unsere Inhalte richtig zu strukturieren. Das Tool ist einfach zu bedienen, gut für ein Team konzipiert und sehr praktisch, um das Tracking zu zentralisieren, ohne zwischen mehreren Plattformen jonglieren zu müssen. Eine sehr solide Grundlage, um mit unserem SEO neu zu starten.”Gaspard MadouiWerbeagentur
“Ich habe mich dank Sorank auf GEO spezialisiert. Das GEO Leaderboard ermöglicht es mir, meinen Kunden ihre Position im Vergleich zu ihren Wettbewerbern auf ChatGPT zu zeigen. Das ist ein echter kommerzieller Differenzierungsfaktor.”MélanieFreelancer im Bereich SEO
“Hervorragender Service, funktioniert gut für unsere Website und hilft uns zu verstehen, wie wir sie verbessern können, um auf Google und anderswo besser zu ranken. Herzlichen Glückwunsch, machen Sie weiter, ich empfehle es.”Hugo T.E-Commerce-Händler