Datenschutz ist uns wichtig. Deshalb können Sie bestimmte Speicherarten deaktivieren, die für die grundlegende Funktion der Website nicht erforderlich sind. Das Blockieren einzelner Kategorien kann Ihr Erlebnis auf der Website beeinträchtigen. Weitere Informationen (Cookie-Richtlinie)
Duplikat - vom Nutzer nicht als kanonisch festgelegt: Bedeutung und Lösung
Was der Search-Console-Status „Duplikat - vom Nutzer nicht als kanonisch festgelegt“ bedeutet, wann er normal ist und wie Sie ihn prüfen und beheben.
Veröffentlicht am:
25/10/2026
-
Aktualisiert am:
25/10/2026
Titelbild des Sorank-Leitfadens zum Search-Console-Status Duplikat, vom Nutzer nicht als kanonisch festgelegt, mit zwei identischen Seiten und einer ausgewählten URL
„Duplikat - vom Nutzer nicht als kanonisch festgelegt“ ist ein Status im Bericht zur Seitenindexierung der Google Search Console. Google hat eine URL gefunden, die eine andere Seite dupliziert, die URL gibt keine bevorzugte Version an, also hat Google selbst eine andere URL als kanonisch gewählt und diese hier aus den Suchergebnissen herausgenommen. Das ist oft normal (URLs mit Parametern, HTTP- oder www-Varianten). Zum Problem wird es, wenn Google die falsche URL wählt oder Seiten, die ranken sollen, als Duplikate zusammenfasst: URL prüfen, dann mit einer 301-Weiterleitung, einem rel="canonical"-Tag oder eigenständigerem Inhalt beheben.
Welcher Weg, online Kunden zu finden, passt am besten zu Ihnen?
4 kurze Fragen, um Ihren Hauptkanal zu wählen.
Frage 1 von 425%
Unsere Empfehlung für Sie
Sorank ist die richtige Lösung für Sie
Ihre Kunden suchen, bevor sie kaufen: Artikel, die ihre Fragen beantworten, bringen sie über Monate. Sorank schreibt und veröffentlicht sie und verfolgt, was ChatGPT über Sie sagt.
Sorank passt zu Ihren Antworten
Testen Sie es 3 Tage lang auf Ihrer eigenen Website oder starten Sie mit einem kostenlosen Audit, um zu sehen, wo Sie stehen.
3 Tage kostenlos, danach beenden Sie jederzeit. 90-Tage-Geld-zurück-Garantie.
Der Status Duplikat - vom Nutzer nicht als kanonisch festgelegt gehört zu den Gründen, aus denen Seiten in der Search Console nicht indexiert werden. Die Hilfe zum Bericht zur Seitenindexierung fasst ihn so zusammen: Die Seite ist ein Duplikat einer anderen Seite, gibt aber keine bevorzugte kanonische Seite an. Dieser Leitfaden erklärt, was das bedeutet, wie Sie einen harmlosen Fall von einem echten Problem unterscheiden, wie Sie ihn mit dem URL-Prüftool diagnostizieren und welche Lösung in welcher Situation passt.
Was bedeutet „Duplikat - vom Nutzer nicht als kanonisch festgelegt“?
Wenn mehrere URLs denselben oder fast denselben Inhalt zeigen, fasst Google sie zusammen und indexiert nur eine: die kanonische Version. Google nennt diesen Vorgang Kanonisierung, also die Auswahl der repräsentativen URL eines Inhalts, und beschreibt ihn im Search-Central-Leitfaden zur Kanonisierung.
Der Status verrät drei Dinge über die gelistete URL:
Sie ist ein Duplikat: Google hält ihren Inhalt für identisch mit dem einer anderen Seite.
Sie haben nichts festgelegt: Die Seite hat kein rel="canonical"-Tag (und kein gleichwertiges Signal), das eine bevorzugte Version nennt.
Google hat für Sie entschieden: Google hat die andere Seite als kanonisch gewählt und zeigt diese Seite deshalb nicht in der Suche.
Die ausgeschlossene URL wird nicht abgestraft. Ihr Inhalt kann weiterhin in Google erscheinen, über die kanonische URL, die Google behalten hat. Laut Google-Hilfe ist der Status kein Fehler: Das System funktioniert wie vorgesehen, weil Google keine doppelten Seiten ausliefert.
Die Search Console kennt drei Status rund um kanonische URLs, die leicht zu verwechseln sind:
Status
Was passiert ist
Wer die kanonische URL gewählt hat
Maßnahme
Duplikat - vom Nutzer nicht als kanonisch festgelegt
Die Seite verweist wie geplant auf eine indexierte kanonische URL
Sie (und Google stimmt zu)
Keine, laut Google
Duplikat - Google hat eine andere Seite als der Nutzer als kanonische Seite bestimmt
Sie haben eine kanonische URL angegeben, Google hat eine andere gewählt
Google, gegen Ihre Wahl
Untersuchen: Ihre Signale widersprechen sich
Ist das ein Problem oder normal?
Die meisten Websites haben einige URLs in diesem Status, und eine kleine, stabile Zahl ist kein Grund zur Sorge. Googles Leitfaden bestätigt, dass etwas doppelter Inhalt auf einer Website normal ist und nicht gegen die Spamrichtlinien verstößt. Entscheidend ist, welche URLs gelistet sind und welche kanonische URL Google gewählt hat.
Normal: so lassen
Problem: handeln
URLs mit Tracking-Parametern (?utm_source=, ?ref=, Session-IDs)
Google hat eine Parameter-URL, die HTTP-Version oder eine alte URL als kanonisch gewählt
HTTP- oder Nicht-www-Version einer Seite, die korrekt über HTTPS läuft
Produkt-, Leistungs- oder Standortseiten, die ranken sollen, werden als Duplikate zusammengefasst
Sortier- und Filter-URLs einer Kategorieseite
Die Zahl der betroffenen URLs steigt nach einer Migration, einem Relaunch oder einem CMS-Wechsel sprunghaft
Druckversionen oder fast identische Archivseiten
Eine Staging- oder Demo-Website ist crawlbar und dupliziert Ihre Live-Seiten
Die Faustregel: Ist die von Google ausgewählte kanonische URL die, die Sie selbst gewählt hätten, gibt es nichts zu beheben. Wenn nicht, oder wenn eine Seite, die Sie in den Suchergebnissen brauchen, als Duplikat ausgeschlossen ist, handeln Sie.
Woher kommen doppelte URLs ohne kanonische Angabe?
Googles Leitfaden nennt die üblichen Quellen für Duplicate Content: regionale Varianten, Gerätevarianten, Protokollvarianten, Websitefunktionen wie Sortier- und Filterergebnisse einer Kategorieseite und versehentliche Varianten wie eine für Crawler offene Demo-Website. In der Praxis sind die häufigsten Fälle:
Protokoll- und Hostvarianten: http:// und https://, mit und ohne www, die alle mit Status 200 antworten statt weiterzuleiten.
Schrägstrich am Ende und Groß-/Kleinschreibung: /seite und /seite/ oder /Seite und /seite als getrennte URLs.
URL-Parameter: Tracking-Tags, Session-IDs, Sortierungen und Filter, die eine neue URL erzeugen, ohne den Hauptinhalt zu ändern.
E-Commerce-Strukturen: dasselbe Produkt über mehrere Kategoriepfade erreichbar, Farb- oder Größenvarianten mit derselben Beschreibung, gefilterte Kategorien. Unser Leitfaden zu SEO für Kategorieseiten behandelt den Umgang mit Filtern.
Paginierung und Archive: Tag-, Autoren- und Datumsarchive, die dieselben Beiträge wiederholen, oder paginierte Reihen ohne klare Signale (siehe Paginierung und SEO).
Vorlagenseiten: Stadt- oder Leistungsseiten, bei denen sich nur der Ortsname ändert und die Google als eine Seite behandeln kann.
Theme oder CMS ohne Canonical-Tags: Viele Plattformen setzen standardmäßig ein selbstreferenzierendes Canonical, eigene Vorlagen und manche Page Builder jedoch nicht.
Wie diagnostizieren Sie den Status mit dem URL-Prüftool?
1. Den Status im Bericht zur Seitenindexierung öffnen
Gehen Sie in der Google Search Console zu Indexierung, dann Seiten, scrollen Sie zur Tabelle mit den Gründen, warum Seiten nicht indexiert werden, und klicken Sie auf den Status. Exportieren Sie die Beispiel-URLs. Laut Google ist diese Liste auf 1.000 Einträge begrenzt und zeigt nicht garantiert alle betroffenen URLs.
2. URLs nach Muster gruppieren
Sortieren Sie den Export und suchen Sie, was die URLs gemeinsam haben: einen Parameter, einen Ordner, ein Protokoll, einen Schrägstrich am Ende. Zehntausend betroffene URLs stammen oft aus zwei oder drei Mustern, und jedes Muster braucht genau eine Lösung.
3. Eine URL pro Muster prüfen
Fügen Sie eine URL in die Suchleiste oben in der Search Console ein. Lesen Sie im Abschnitt Seitenindexierung des URL-Prüftools zwei Felder:
Vom Nutzer angegebene kanonische URL: das Canonical, das Ihre Seite angibt. Bei diesem Status ist das Feld meist leer.
Von Google ausgewählte kanonische URL: die URL, die Google an ihrer Stelle indexiert hat.
4. Beide Seiten im Browser vergleichen
Öffnen Sie die geprüfte URL und die von Google ausgewählte kanonische URL nebeneinander. Stellen Sie zwei Fragen: Ist der Inhalt derselbe, und ist Googles Wahl die URL, auf der Besucher landen sollen? Prüfen Sie anschließend die von Google gewählte URL selbst, um sicherzugehen, dass sie indexiert ist.
Achtung
Der Live-Test beantwortet die Frage nach der kanonischen URL nicht. Laut Google lässt sich die kanonische Version nur in den indexierten Daten ablesen; der Live-Test kann nicht vorhersagen, ob die getestete Version als kanonisch gilt. Lesen Sie das indexierte Ergebnis, nicht den Live-Test.
Um zu prüfen, was Ihre Seiten angeben, bevor Google sie erneut crawlt, nutzen Sie unseren kostenlosen Canonical-Tag-Checker: Er zeigt in wenigen Sekunden das Canonical im HTML jeder URL.
Wie beheben Sie „Duplikat - vom Nutzer nicht als kanonisch festgelegt“?
Die Lösung hängt davon ab, was mit der doppelten URL passieren soll. Googles Leitfaden zum Zusammenfassen doppelter URLs ordnet die Signale nach Stärke: Weiterleitungen und rel="canonical" sind starke Signale, die Aufnahme in die Sitemap ist ein schwaches.
Situation
Lösung
Signalstärke
Die doppelte URL hat keinen Grund zu existieren (HTTP, ohne www, alte URL)
301-Weiterleitung auf die bevorzugte URL
Stark
Die doppelte URL muss erreichbar bleiben (Parameter, Filter, Varianten)
rel="canonical" auf die bevorzugte URL
Stark
Die Seite soll eigenständig ranken
Deutlich anderer Inhalt plus selbstreferenzierendes Canonical
Hängt vom Inhalt ab
Die Wahl unterstützen
Interne Links und XML-Sitemap zeigen nur auf die kanonische URL
Schwach, aber konsistent
URLs weiterleiten, die nicht existieren sollten
Für Protokoll-, Host- und Schrägstrichvarianten ist eine websiteweite 301-Weiterleitung die sauberste Lösung: Besucher und Crawler landen immer auf einer URL. Unser Leitfaden zu SEO-Weiterleitungen erklärt, wie Sie sie ohne Ketten einrichten.
Ein Canonical auf behaltene Duplikate setzen
Fügen Sie im head des Duplikats ein link-Element ein: <link rel="canonical" href="https://www.example.com/bevorzugte-seite/">. Verwenden Sie absolute URLs. Google empfiehlt außerdem ein selbstreferenzierendes Canonical auf der bevorzugten Seite, damit jede indexierbare Seite ihre eigene URL angibt.
Seiten unterscheidbar machen, die ranken sollen
Fasst Google Seiten zusammen, die Sie getrennt indexiert haben wollen, hilft das Tag allein nicht. Laut Google-Hilfe sollten Sie, wenn die Seite kein Duplikat der gewählten kanonischen Seite ist, dafür sorgen, dass sich der Inhalt beider Seiten deutlich unterscheidet. Geben Sie jeder Seite eigenen Text, eigene Daten, Fotos, Preise oder lokale Details.
Die übrigen Signale angleichen
Lassen Sie interne Links auf die kanonische URL zeigen, listen Sie in Ihrer XML-Sitemap nur kanonische URLs und prüfen Sie sie mit einem Sitemap-Checker. Widersprüchliche Signale (eine Sitemap nennt die eine URL, Links zeigen auf eine andere) führen dazu, dass Google anders wählt als Sie.
Gut zu wissen
Google rät von drei verbreiteten Abkürzungen bei der Kanonisierung ab: Duplikate per robots.txt sperren, noindex nutzen, um innerhalb einer Website eine kanonische URL festzulegen, und das Tool zum Entfernen von URLs verwenden. Jede davon versteckt Inhalt, statt ihn zusammenzuführen.
Wie lange dauert es, bis der Status verschwindet?
Nichts ändert sich, bevor der Googlebot die betroffenen URLs erneut crawlt. Nach der Korrektur können Sie auf der Statusseite auf „Fehlerbehebung überprüfen“ klicken; laut Google dauert die Überprüfung in der Regel bis zu etwa zwei Wochen, in manchen Fällen deutlich länger. Die Überprüfung ist optional: Der Bericht aktualisiert sich, sobald Seiten neu gecrawlt werden. Für wenige wichtige URLs beantragen Sie die Indexierung im URL-Prüftool. Bei großen Websites prüft die URL Inspection API kanonische URLs in großer Zahl, mit einem Kontingent von 2.000 Abfragen pro Tag und Website laut den Nutzungslimits der Search Console API. Unser Leitfaden zur Google-Indexierung behandelt den Rest des Indexierungsprozesses.
Warum ist Kanonisierung für SEO und GEO wichtig?
Duplikate verteilen Signale. Backlinks, interne Links und Nutzersignale verteilen sich auf mehrere URLs, statt eine Seite zu stärken, und in den Ergebnissen erscheint womöglich die URL, die Sie am wenigsten mögen (eine Parameter-URL, eine gefilterte Seite). Bei großen Websites kostet das Crawlen von Duplikaten zudem Zeit, die der Googlebot für neue Seiten nutzen könnte.
KI-Assistenten liefern einen zweiten Grund. ChatGPT, Perplexity und Gemini beantworten viele Fragen, indem sie Seiten aus Suchindizes abrufen und dann die gefundene URL zitieren. Existiert Ihr Inhalt unter einer einzigen sauberen kanonischen URL, wird genau diese Adresse abgerufen, zitiert und angeklickt. Existiert er unter fünf, verwässern die Signale, und der zitierte Link kann auf eine Variante zeigen, die Sie lieber nicht zeigen würden.
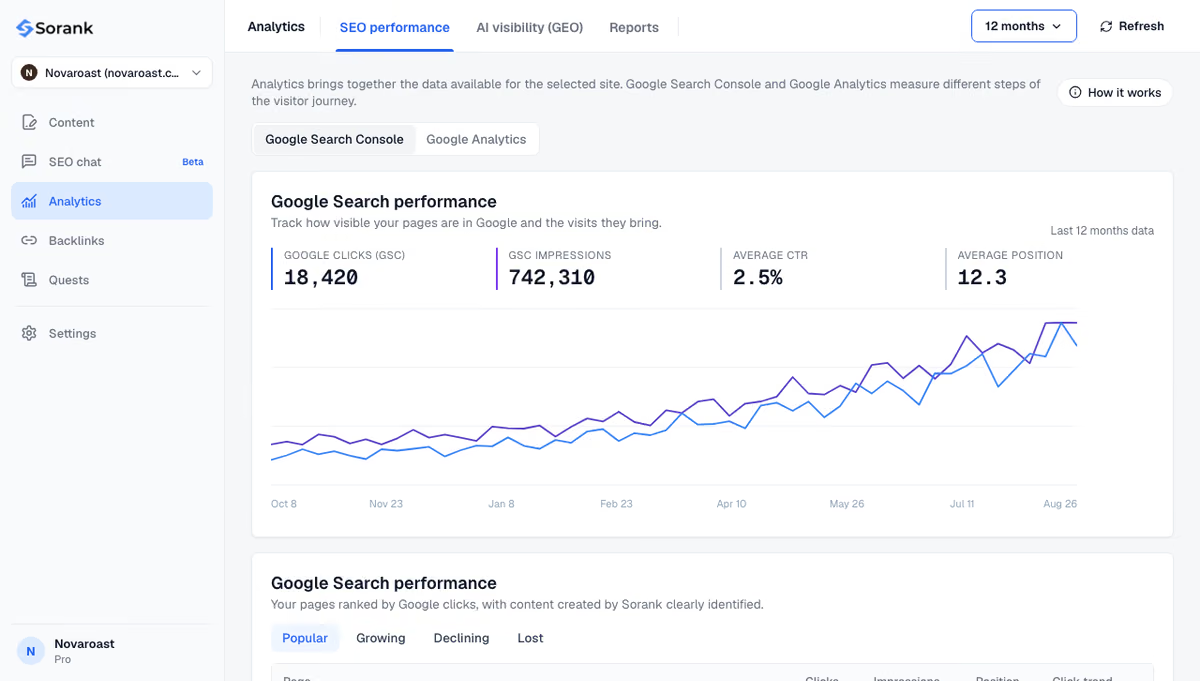
Sorank ist unser Produkt: eine SEO- und GEO-Software im Autopilot. Das GEO- und SEO-Dashboard zeigt Klicks, Impressionen und Positionen aus der Search Console, damit Sie sehen, ob Canonical-Korrekturen den Traffic auf die richtigen Seiten zurückbringen, und das KI-Erwähnungs-Tracking prüft jede Woche, ob ChatGPT, Claude und Gemini Ihre Marke nennen.
Kurz zusammengefasst: Prüfen Sie die von Google ausgewählte kanonische URL, leiten Sie weiter, was nicht existieren sollte, und setzen Sie ein Canonical auf das, was Sie behalten. Seiten, die ranken sollen, machen Sie wirklich unterschiedlich. Um die Zahl der indexierten und zitierten Seiten zu steigern, sehen Sie sich die Sorank-Tarife an, ab 49 € pro Monat mit 3 Tagen kostenlos testen.
Häufig gestellte Fragen
Schadet der Status Duplikat, vom Nutzer nicht als kanonisch festgelegt, meinen Rankings?
Nicht von sich aus. Google indexiert die gewählte kanonische URL und zeigt diese in den Suchergebnissen, der Inhalt kann also weiter ranken. Schädlich wird es nur, wenn Google die falsche URL als kanonisch wählt oder Seiten, die getrennt ranken sollen, als Duplikate einer anderen Seite behandelt.
Muss ich jede URL in diesem Status korrigieren?
Nein. Parameter-URLs, HTTP- oder Nicht-www-Varianten und Sortierseiten sind in diesem Status zu erwarten und brauchen keine Maßnahme, wenn Google die richtige kanonische URL gewählt hat. Konzentrieren Sie sich auf URLs mit falscher kanonischer Auswahl, auf Seiten, die Sie in den Suchergebnissen brauchen, und auf sprunghafte Anstiege nach Änderungen an der Website.
Kann ich auf doppelten Seiten noindex statt eines Canonical-Tags verwenden?
Google rät davon ab, noindex zur Auswahl einer kanonischen URL innerhalb einer Website zu nutzen, weil noindex die Seite komplett aus der Suche entfernt, statt ihre Signale auf der bevorzugten URL zu bündeln. Nutzen Sie eine 301-Weiterleitung, wenn das Duplikat nicht existieren sollte, und ein rel-canonical-Tag, wenn es für Besucher erreichbar bleiben muss.
“Ich habe Sorank auf einer echten Kundenwebsite getestet, und es ist der Wahnsinn. Es macht alles, wofür eine Agentur 1.500 € im Monat berechnet. Jetzt geht es bei diesem Kunden in den Produktivbetrieb.”Guillaume Guersanguersanguillaume.com
“Wir sind eine Ads-Agentur und wollten unser SEO endgültig wieder auf Kurs bringen. Sorank hat uns eine klare Übersicht über unsere Website verschafft, uns geholfen, Optimierungen zu priorisieren und unsere Inhalte richtig zu strukturieren. Das Tool ist einfach zu bedienen, gut für ein Team konzipiert und sehr praktisch, um das Tracking zu zentralisieren, ohne zwischen mehreren Plattformen jonglieren zu müssen. Eine sehr solide Grundlage, um mit unserem SEO neu zu starten.”Gaspard MadouiWerbeagentur
“Ich habe mich dank Sorank auf GEO spezialisiert. Das GEO Leaderboard ermöglicht es mir, meinen Kunden ihre Position im Vergleich zu ihren Wettbewerbern auf ChatGPT zu zeigen. Das ist ein echter kommerzieller Differenzierungsfaktor.”MélanieFreelancer im Bereich SEO
“Hervorragender Service, funktioniert gut für unsere Website und hilft uns zu verstehen, wie wir sie verbessern können, um auf Google und anderswo besser zu ranken. Herzlichen Glückwunsch, machen Sie weiter, ich empfehle es.”Hugo T.E-Commerce-Händler