A magánszféra fontos számunkra, ezért lehetőséged van kikapcsolni bizonyos típusú tárolókat, amelyekre a weboldal alapvető működéséhez nincs szükség. A kategóriák letiltása befolyásolhatja a weboldal használatának élményét. További információ (Sütikezelési szabályzat)
Hogyan működnek a keresőmotorok? Feltérképezés, indexelés, rangsorolás és MI-válaszok
Hogyan működnek a keresőmotorok 5 lépésben: feltérképezés, renderelés, indexelés, rangsorolás és megjelenítés, mit másként csinál a Bing, és hogyan használják fel az MI-válaszok az indexet.
Lapos illusztráció három kék oszlopról, különböző magasságban, a legmagasabb sötétkék, tetején sárga csillaggal.
Eszközök
Ezen az oldalon
Röviden
a keresőmotorok három fő szakaszban dolgoznak. A robotok linkek és oldaltérképek mentén felfedezik és letöltik az oldalakat (feltérképezés), a motor pedig minden oldalt elemez, és egy óriási adatbázisban, az indexben tárolja (indexelés). Amikor valaki lekérdezést ír be, a rangsorolási rendszerek kiválasztják és sorba rendezik a legrelevánsabb, legjobb minőségű oldalakat az indexből (rangsorolás és megjelenítés). Az MI-válaszok, például a Google AI Overviews és a ChatGPT keresése, egy újabb réteget tesznek hozzá: egy webes indexből keresnek oldalakat, majd olyan összefoglalót írnak, amely ezek egy részére hivatkozik.
3 nap ingyen, utána bármikor leállhatsz. 90 napos eredménygarancia visszatérítéssel.
A keresőmotorok működésének megértése minden SEO-döntés alapja: amit nem járnak be, azt nem lehet indexelni, és ami nincs indexelve, az sem rangsorolható, és MI-asszisztens sem idézheti. A Google a Google-keresés működésének részletes útmutatójában magyarázza el a folyamatot. Ez a cikk ugyanazokat a szakaszokat követi, hozzáteszi, mit csinál másként a Bing, és megmutatja, mi változik, amikor a ChatGPT, a Gemini vagy a Perplexity kék linkek listája helyett válaszol.
Mi a keresőmotor?
A keresőmotor olyan szoftver, amely a lekérdezésnek megfelelő weboldalakat keresi meg. Két részből áll: egy indexből, amely a már felfedezett és elemzett oldalak adatbázisa, és a rangsorolási rendszerekből, amelyek eldöntik, melyik indexelt oldal válaszol a legjobban a lekérdezésre, és milyen sorrendben. A keresőmotor nem az élő webben keres, amikor lekérdezést írsz be: a saját tárolt másolatában keres. Ezért lehet egy ma reggel közzétett oldal napokig láthatatlan.
A három klasszikus szakasz könnyebben kezelhető, ha öt lépésre bontjuk, és mindegyiknek megvannak a saját eszközei.
Lépés
Mit csinál a motor
Mire van ráhatásod
1. Feltérképezés
A robotok URL-eket fedeznek fel és töltenek le oldalakat
robots.txt, belső linkek, XML-oldaltérkép, szerver sebessége
2. Renderelés
Böngészőhöz hasonlóan futtatja a JavaScriptet, hogy lássa a végleges oldalt
A HTML-ben lévő tartalom, nincs kulcsfontosságú szöveg szkriptek vagy bejelentkezések mögé rejtve
3. Indexelés
Elemzi a tartalmat, kiválaszt egy kanonikus URL-t, tárolja a jeleket
Egyedi tartalom, kanonikus címkék, noindex, title tag és címsorok
4. Rangsorolás
Sorba rendezi az indexelt oldalakat minden lekérdezésre
Relevancia a szándékhoz, minőség, linkek, oldalélmény
5. Megjelenítés
Felépíti az eredményoldalt: linkek, részletek, AI Overview
Title tag, meta-leírás, strukturált adat, részletvezérlők
1. lépés: feltérképezés, az oldalak felfedezése
A feltérképezés a felfedezés szakasza. Az automatizált programok, a robotok (a Google-nél a Googlebot, a Bingnél a Bingbot) ismert URL-ekből indulnak ki, és linkeket követve találnak újakat. Olvassák a tulajdonosok által beküldött XML-oldaltérképeket is. A Google szerint a Googlebot algoritmussal dönti el, mely oldalakat járja be, milyen gyakran és hány oldalt tölt le egy webhelyről, és igyekszik nem olyan gyorsan bejárni a webhelyet, hogy az túlterhelje a szervert.
Három dolog akadályozza a feltérképezést: egy tiltó szabály a robots.txt fájlban, a bejelentkezés mögötti oldalak, valamint a szerverhibák vagy időtúllépések. Az eszközök: tiszta belső linkstruktúra árva oldal nélkül, naprakész XML-oldaltérkép, és gyors, stabil szerver. A nagy oldalak a feltérképezési keretet (crawl budget) is kezelik: azt a URL-számot, amelyet egy robot egy adott időszakban hajlandó letölteni az oldalon.
2. lépés: renderelés, az oldal böngészőként való látása
Sok oldal JavaScripttel építi a tartalmát. A Google a Chrome friss verziójával rendereli az oldalakat, így futtatja a szkripteket, és azt látja, amit a látogató. A renderelés erőforrást igényel, késhet, és az a tartalom, amely csak kattintás után jelenik meg, vagy egy meghibásodó szkripttől függ, soha nem látszik. Sok más robot, köztük több MI-robot, egyáltalán nem futtat JavaScriptet: a kulcsfontosságú tartalomnak a kezdeti HTML-ben kell lennie.
3. lépés: indexelés, megértés és tárolás
Az indexelés az elemzés szakasza. A motor elolvassa a szöveget, a címet, a címsorokat, a képeket, a videókat és a strukturált adatokat, majd a hasonló tartalmú oldalakat csoportosítja, és kiválaszt egy reprezentatív URL-t, a kanonikust, amely megjelenhet az eredményekben. Tárolja az oldalról szóló jeleket: nyelv, célország, frissesség, használhatóság. A Google a saját indexét egy könyv végén lévő mutatóhoz hasonlítja: minden általa látott szóhoz bejegyzés tartozik, minden indexelt oldalon.
Az indexelést soha nem lehet garantálni. A Google szerint nem minden feldolgozott oldal kerül be az indexbe: a vékony vagy duplikált tartalom, a noindex utasítás vagy egy nehezen elemezhető dizájn kizárhatja az oldalt. A Google-indexelésről szóló útmutatónk a javításokat tárgyalja, egy ingyenes indexelhetőség-ellenőrző pedig másodpercek alatt megmondja, indexelhető-e egy URL.
4. lépés: rangsorolás, a legjobb válaszok kiválasztása
Amikor lekérdezés érkezik, a motor először értelmezi: helyesírás, szinonimák, nyelv, földrajzi hely és a szavak mögötti szándék (tanulni, összehasonlítani, vásárolni, egy adott oldalra jutni). Ezután jelölt oldalakat keres ki az indexből, és sorba rendezi őket, sok rangsorolási rendszer együttes munkájával. A Google a fő tényezőket a lekérdezés jelentésére, a tartalom relevanciájára, a minőségére, az oldal használhatóságára és a keresés kontextusára bontja, például helyre és beállításokra. Más oldalak linkjei továbbra is a tekintély jelei. A teljes képet a Google rangsorolási tényezőiről szóló elemzésünk mutatja be.
Két pontot gyakran félreértenek. Először: a Google szerint nem fogad el fizetséget azért, hogy gyakrabban járjon be egy oldalt vagy magasabbra rangsoroljon: a hirdetéseket külön árulják, és ennek megfelelően jelölik. Másodszor: a hely és a nyelv sokkal jobban változtatja az eredményeket, mint a személyes böngészési előzmények.
5. lépés: megjelenítés, az eredményoldal összeállítása
Az utolsó lépés összeállítja az eredményoldalt. A tíz kék linkből hirdetések, helyi találatok, képek, videók, „Az emberek ezt is kérdezik” dobozok, kiemelt részletek és sok informatív lekérdezésnél egy AI Overview keveréke lett. A megjelenő cím és leírás a title tag-ből, a meta-leírásból és az oldal tartalmából származik, a strukturált adatok pedig alkalmassá tehetnek egy oldalt gazdag találatokra. Minden formátum külön lehetőség, hogy észrevegyenek.
Miben tér el a Bing a Google-től?
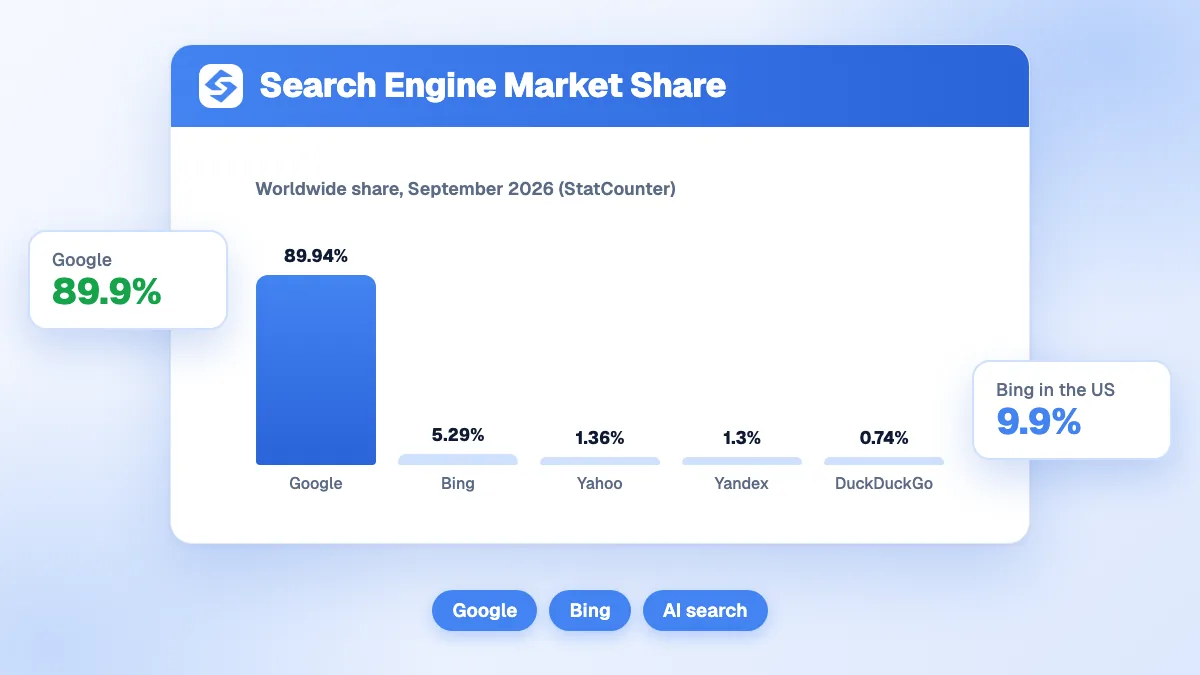
A Bing ugyanazt a feltérképezés, indexelés és rangsorolás modellt követi, néhány gyakorlati különbséggel. A fő különbség az IndexNow, egy protokoll, amely lehetővé teszi, hogy az oldal értesítse a motorokat, amint egy URL hozzáadódik, frissül vagy törlődik, ahelyett hogy a következő feltérképezésre várna. Az IndexNow.org szerint a protokollt a Microsoft Bing, a Naver, a Seznam.cz, a Yandex és a Yep támogatja; a Google nem vezette be. A Bing-eredmények a Microsoft Copilotot is táplálják. A Bing piaci részesedése a legtöbb országban kicsi, de a Bing Webmaster Tools beállítása néhány percet vesz igénybe, és egy második forgalmi és adatforrást nyit meg.
Hogyan találják meg a tartalmat a ChatGPT-hez hasonló MI-asszisztensek és az AI Overviews?
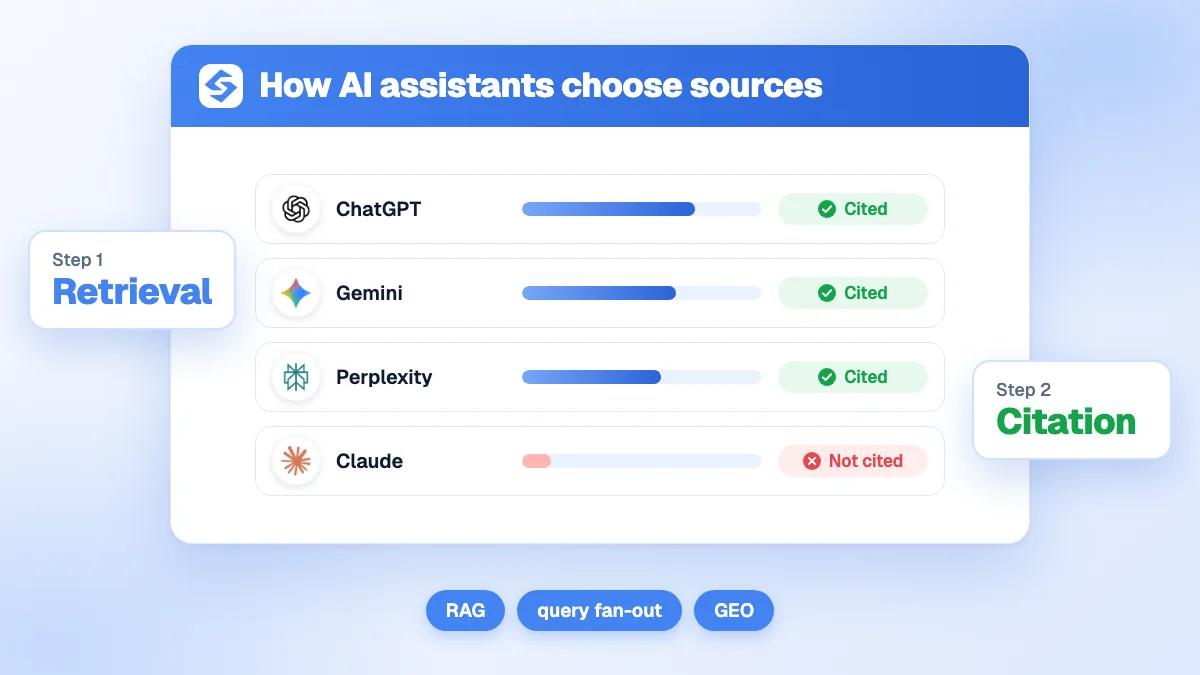
Az MI-válaszok a keresőmotorokra épülnek, nem helyettesítik őket. A legtöbb a visszakeresés-kiegészített generálásra (RAG) támaszkodik: a rendszer egy vagy több keresést futtat, a legrelevánsabb részleteket kikeresi egy webes indexből, majd egy nyelvi modell olyan választ ír, amely ezen források egy részére hivatkozik.
A Google AI Overviews és az AI Mode a Google saját indexét használja. A Google MI-funkciók és a weboldalad című oldala szerint elég, ha az oldal indexelve van, és alkalmas részletet megjeleníteni; nincs szükség különleges jelölésre vagy MI-szövegfájlra. Ezek a funkciók „query fan-out” (lekérdezés-szétágazás) módszert használnak: több, egymással összefüggő résztémára vonatkozó keresést futtatnak, hogy alátámasztó oldalakat gyűjtsenek.
A ChatGPT keresése az OpenAI OAI-SearchBot robotjával keres oldalakat. Az OpenAI robotdokumentációja szerint azokat az oldalakat, amelyek blokkolják az OAI-SearchBotot, kizárják a ChatGPT-keresés válaszaiból, a GPTBot pedig külön robot, amelyet modelltanításra használnak.
A Gemini, a Perplexity és a Claude szintén a webes visszakeresést kombinálja a generálással: a Gemini a Google-keresésre támaszkodik, a Perplexity és a Claude pedig saját robotjait (PerplexityBot, Claude-SearchBot) küldi az oldalakra, amelyeket idézhetnek.
Ebből következik: a klasszikus szakaszok továbbra is eldöntik az MI-láthatóságot. Az az oldal, amelyet nem lehet bejárni, hiányzik az indexből, vagy mélyen a rangsorban van, kicsi eséllyel kerül visszakeresésre, így idézésre sem. Ami változik, az a végső választás: az MI egész oldalak helyett részleteket választ ki, és a világos definíciókat, a forrásolt számokat és a közvetlen válaszokat részesíti előnyben. A ChatGPT által idézett forrásokról szóló tanulmányunk megmutatja, melyik típusú oldalak nyerik meg ezeket az idézéseket.
Mit szabályozhatsz az egyes szakaszokban?
Rendezd sorba a szakaszokat, és olyan ellenőrzőlistát kapsz, amely a Google-re, a Bingre és az MI-asszisztensekre egyaránt működik:
Engedd be a megfelelő robotokat. Ellenőrizd a robots.txt-t véletlen tiltó szabályokra, és tudatosan döntsd el, mely MI-robotokat engedélyezed.
Tedd minden fontos oldalt elérhetővé három kattintáson belül a belső linkeken keresztül, és vedd fel az oldaltérképbe.
Szolgáltass tartalmat a HTML-ben, ne csak JavaScripten keresztül, gyors és stabil szerverválaszokkal.
Adj minden témának egy kanonikus URL-t, és kerüld a majdnem azonos oldalakat, amelyek szétosztják a jeleket.
Igazodj a keresési szándékhoz. Abból indulj ki, amit az emberek beírnak, amit a kulcsszókutatás feltár, és válaszolj rájuk az oldal első sorai között.
Szerezz tekintélyt releváns oldalak linkjeivel és említéseivel.
Írj idézhető részleteket: egy definíciót, egy számot a forrásával, lépések rövid listáját.
Mérd mindkét csatornát: a Search Console-t a Google-höz, az MI-említések követését pedig ahhoz, hogy lásd, idézi-e a ChatGPT, a Gemini vagy a Claude a márkádat.
Hogyan változtak a keresőmotorok az idők során?
Az 1990-es évek korai motorjai főleg kulcsszóillesztéssel rangsoroltak, ami könnyen manipulálható volt. A Google PageRankje, amely a linkeket szavazatként kezelte, sokkal nehezebbé tette a rangsorok kijátszását, az elkövetkező évtizedek pedig nyelvi megértést adtak hozzá gépi tanulási modellekkel, például a BERT-tel, a mobilelső indexeléssel, a spamszűréssel és a minőségi rendszerekkel. A Google története egyenletes mintát mutat: minden nagy változtatás az embereknek készült oldalakat jutalmazta, és a rövidítéseket büntette. A generatív válaszok a legutóbbi lépés, és ugyanazt jutalmazzák: világos, megbízható, jól strukturált tartalmat.
A feltérképezéstől a forgalomig: honnan kezdj
A keresőmotorok azokat az oldalakat jutalmazzák, amelyeket be tudnak járni, meg tudnak érteni és meg tudnak bízni bennük, az MI-asszisztensek pedig azokat az oldalakat idézik, amelyeket a keresőmotorok már rangsorolnak. Előbb a hozzáférést javítsd, utána az indexelést, aztán a relevanciát és a tekintélyt. Hogy ez hetről hetre működjön, a Sorank megtalálja a kulcsszavaidat, forrásokkal és belső linkekkel ellátott, optimalizált cikkeket tesz közzé, és autopilot módban követi, hogy a ChatGPT, a Gemini és a Claude idézi-e a márkádat.
Gyakran ismételt kérdések
Mennyi idő alatt indexeli a Google az új oldalt?
Nincs rögzített késés: néhány óra egy gyakran bejárt oldalon, több nap vagy hét egy új vagy ritkán frissülő oldalon. Ha az oldalra már indexelt oldalakról linkelsz, és a Google Search Console URL-ellenőrző eszközével indexelést kérsz, a felfedezés gyorsul. Kérés után sem garantált az indexelés.
A keresőmotorok valós időben az egész internetben keresnek?
Nem. Saját indexükben keresnek, a feltérképező robotok által már letöltött és elemzett oldalak tárolt másolatában. Az az oldal, amelyet blokkoltak, bejelentkezés mögé rejtettek, vagy még nem járták be, addig nem létezik a motor számára, amíg fel nem fedezik és nem indexelik.
A ChatGPT a Google-eredményeket használja a kérdések megválaszolásához?
A ChatGPT nem másolja a Google eredményeit. Amikor a webet keresi, az oldalakat az OpenAI saját keresési infrastruktúrájával kéri le, köztük az OAI-SearchBot robottal, és idézi a felhasznált forrásokat. Az az oldal, amely a robots.txt-ben blokkolja az OAI-SearchBotot, kimarad ezekből a válaszokból, ezért fontos, hogy a Google és az OpenAI is be tudja járni.
y!
Ingyenes SEO- és GEO-audit
Kérd ingyen a 30 napos tartalomtervedet
Elemezzük a versenytársaidat, a weboldalad és az AI-láthatóságodat, hogy ingyen készítsünk neked testre szabott tartalomtervet.
“Teszteltem a Sorankot egy valódi ügyfél oldalán, és őrület. Mindent megtesz, amiért egy ügynökség $1500-t kérne havonta. Most ennél az ügyfélnél már éles üzemben van.”Guillaume Guersanguersanguillaume.com
“Egy hirdetési ügynökség vagyunk, és végre rendbe akartuk tenni a SEO-nkat. A Sorank tiszta képet adott az oldalunkról, segített sorrendbe állítani az optimalizálásokat, és segített rendesen felépíteni a tartalmainkat. Az eszköz könnyen kezelhető, csapatra jól szabott, és nagyon praktikus, hogy több platform közötti ugrálás nélkül egy helyen követhetjük a munkát. Nagyon szilárd alap ahhoz, hogy újrakezdjük a SEO-nkat.”Gaspard MadouiHirdetési ügynökség
“A Soranknak köszönhetően GEO-szakértő lettem. A GEO-ranglista segítségével megmutathatom az ügyfeleimnek, hol állnak a versenytársakhoz képest a ChatGPT-ben. Ez valódi kereskedelmi előny.”MélanieSEO szabadúszó
“Remek szolgáltatás, jól működik a weboldalunkon, és segít megérteni, hogyan lehet javítani, hogy jobban szerepeljünk a Google-on és másutt. Gratulálok, így tovább, ajánlom.”Hugo T.E-kereskedelmi kereskedő