Confidențialitatea contează pentru noi, așa că ai opțiunea de a dezactiva anumite tipuri de stocare care nu sunt necesare pentru funcționarea de bază a site-ului. Blocarea categoriilor poate afecta experiența ta pe site. Mai multe informații (Politica privind cookie-urile)
Cum funcționează motoarele de căutare? Crawlare, indexare, clasare și răspunsurile IA
Cum funcționează motoarele de căutare în 5 pași: crawlare, randare, indexare, clasare și afișare, ce face altfel Bing și cum folosesc răspunsurile IA indexul.
Ilustrație plată a trei bare albastre de înălțimi diferite, cea mai înaltă în albastru închis, cu o stea galbenă deasupra.
Instrumente
Pe această pagină
Pe scurt
motoarele de căutare lucrează în trei etape principale. Crawlerele descoperă și descarcă pagini urmând linkurile și sitemap-urile (crawlare), motorul analizează fiecare pagină și o stochează într-o bază de date uriașă numită index (indexare), iar când cineva scrie o interogare, sistemele de clasare aleg și ordonează din index cele mai relevante pagini, cu cea mai bună calitate (clasare și afișare). Răspunsurile IA, precum Google AI Overviews sau căutarea ChatGPT, adaugă încă un strat: recuperează pagini dintr-un index web, apoi scriu un rezumat care citează unele dintre ele.
3 zile gratuit, apoi renunți oricând vrei. Garanție de rambursare în 90 de zile dacă nu vezi rezultate.
Înțelegerea modului în care funcționează motoarele de căutare stă la baza fiecărei decizii SEO: o pagină care nu este crawlată nu poate fi indexată, iar o pagină care nu este indexată nu poate nici să se clasească, nici să fie citată de un asistent IA. Google explică procesul în ghidul detaliat despre funcționarea Căutării Google. Acest articol urmează aceleași etape, adaugă ce face altfel Bing și arată ce se schimbă când ChatGPT, Gemini sau Perplexity răspund în locul unei liste de linkuri albastre.
Ce este un motor de căutare?
Un motor de căutare este un software care găsește pagini web care se potrivesc unei interogări. Are două părți: un index, adică o bază de date cu paginile deja descoperite și analizate, și sistemele de clasare, care decid ce pagini indexate răspund cel mai bine interogării și în ce ordine. Un motor de căutare nu caută niciodată pe web-ul live când scrii o interogare: caută în propria copie stocată. De aceea o pagină publicată în dimineața aceasta poate rămâne invizibilă zile întregi.
Rulează JavaScript ca un browser, ca să vadă pagina finală
Conținut prezent în HTML, fără text important ascuns în spatele scripturilor sau al autentificărilor
3. Indexare
Analizează conținutul, alege un URL canonic, stochează semnalele
Conținut unic, etichete canonice, noindex, titluri și subtitluri
4. Clasare
Ordonează paginile indexate pentru fiecare interogare
Relevanța față de intenție, calitatea, linkurile, experiența paginii
5. Afișare
Construiește pagina de rezultate: linkuri, fragmente, AI Overview
Eticheta de titlu, meta-descrierea, datele structurate, controalele fragmentelor
Pasul 1: crawlarea, descoperirea paginilor
Crawlarea este etapa descoperirii. Programe automate numite crawlere (Googlebot pentru Google, Bingbot pentru Bing) pornesc de la adresele pe care le cunosc deja și urmează linkurile ca să găsească altele noi. Citesc și sitemap-urile XML pe care proprietarii le trimit. Google spune că Googlebot folosește un algoritm pentru a decide ce site-uri să crawleze, cât de des și câte pagini să descarce din fiecare, și că încearcă să nu crawleze un site atât de repede încât să supraîncarce serverul.
Trei lucruri blochează crawlarea: o regulă de interzicere din fișierul robots.txt, paginile din spatele unei autentificări și erorile sau expirările serverului. Pârghiile sunt o structură curată de linkuri interne, fără pagini orfane, un sitemap XML actualizat și un server rapid și stabil. Site-urile mari își gestionează și bugetul de crawlare: numărul de adrese URL pe care un crawler este dispus să le descarce de pe site, într-o perioadă dată.
Pasul 2: randarea, văzând pagina ca un browser
Multe pagini își construiesc conținutul cu JavaScript. Google randează paginile cu o versiune recentă de Chrome, deci poate rula scripturile și vedea ce vede un vizitator. Randarea consumă resurse și poate fi întârziată, iar conținutul care apare doar după un clic sau care depinde de un script care eșuează poate să nu fie văzut niciodată. Mulți alți crawlere, inclusiv mai mulți crawlere IA, nu rulează deloc JavaScript: conținutul esențial trebuie să fie în HTML-ul inițial.
Pasul 3: indexarea, înțelegerea și stocarea
Indexarea este etapa analizei. Motorul citește textul, titlul, subtitlurile, imaginile, videoclipurile și datele structurate, apoi grupează paginile cu conținut asemănător și alege o adresă URL reprezentativă, canonica, adică versiunea care poate apărea în rezultate. Stochează semnale despre pagină: limba, țara vizată, prospețimea, utilizabilitatea. Google compară indexul său cu indexul de la finalul unei cărți, cu o intrare pentru fiecare cuvânt văzut pe fiecare pagină indexată.
Indexarea nu este niciodată garantată. Google precizează că nu fiecare pagină procesată va fi indexată: conținutul subțire sau duplicat, o directivă noindex sau un design care îngreunează analiza pot ține o pagină afară. Ghidul nostru despre indexarea paginilor în Google acoperă soluțiile, iar un verificator de indexabilitate gratuit îți spune în câteva secunde dacă o adresă URL poate fi indexată.
Pasul 4: clasarea, alegerea celor mai bune răspunsuri
Când sosește o interogare, motorul o interpretează întâi: ortografia, sinonimele, limba, locația și intenția din spatele cuvintelor (a învăța, a compara, a cumpăra, a ajunge pe un anumit site). Apoi extrage din index pagini candidate și le ordonează, cu mai multe sisteme de clasare care lucrează împreună. Google grupează factorii principali în sensul interogării, relevanța conținutului, calitatea lui, utilizabilitatea paginii și contextul căutării, cum ar fi locația și setările. Linkurile de la alte site-uri rămân un semnal de autoritate. Imaginea completă se află în analiza noastră a factorilor de clasare Google.
Două puncte sunt adesea înțelese greșit. Primul: Google spune că nu acceptă plată ca să crawleze un site mai des sau să îl claseze mai sus. Reclamele se vând separat și sunt marcate ca atare. Al doilea: locația și limba schimbă rezultatele mult mai mult decât istoricul personal de navigare.
Pasul 5: afișarea, construirea paginii de rezultate
Ultimul pas asamblează pagina de rezultate. Cele zece linkuri albastre s-au transformat într-un amestec de reclame, rezultate locale, imagini, videoclipuri, casete „Oamenii întreabă și”, fragmente recomandate și, pentru multe interogări informaționale, un AI Overview. Titlul și descrierea afișate vin din eticheta de titlu, meta-descriere și conținutul paginii, iar datele structurate pot face o pagină eligibilă pentru rezultate bogate. Fiecare format este o șansă separată de a fi văzut.
Cum diferă Bing de Google?
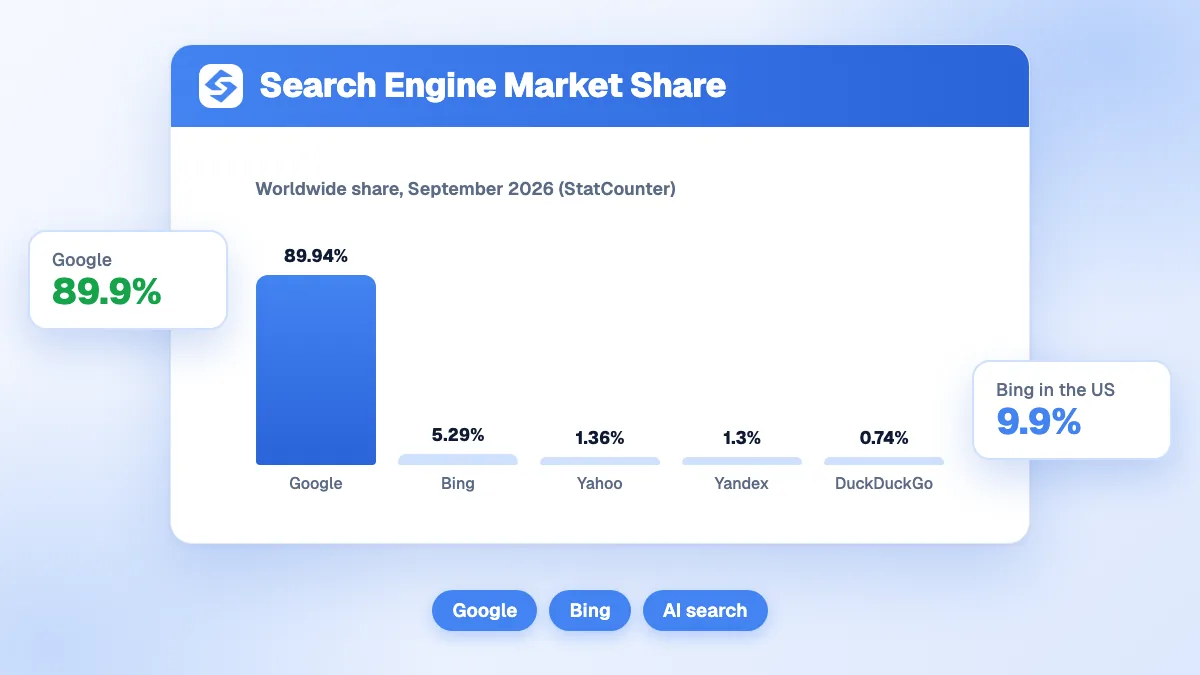
Bing urmează același model de crawlare, indexare și clasare, cu câteva diferențe practice. Cea mai importantă este IndexNow, un protocol prin care un site anunță motoarele imediat ce o adresă URL este adăugată, actualizată sau ștearsă, în loc să aștepte următoarea crawlare. Potrivit IndexNow.org, protocolul este acceptat de Microsoft Bing, Naver, Seznam.cz, Yandex și Yep. Google nu l-a adoptat. Rezultatele Bing alimentează și Microsoft Copilot. Cota de piață a Bing este mică în majoritatea țărilor, dar configurarea Bing Webmaster Tools durează câteva minute și deschide o a doua sursă de trafic și de date.
Cum găsesc asistenții IA, precum ChatGPT și AI Overviews, conținutul?
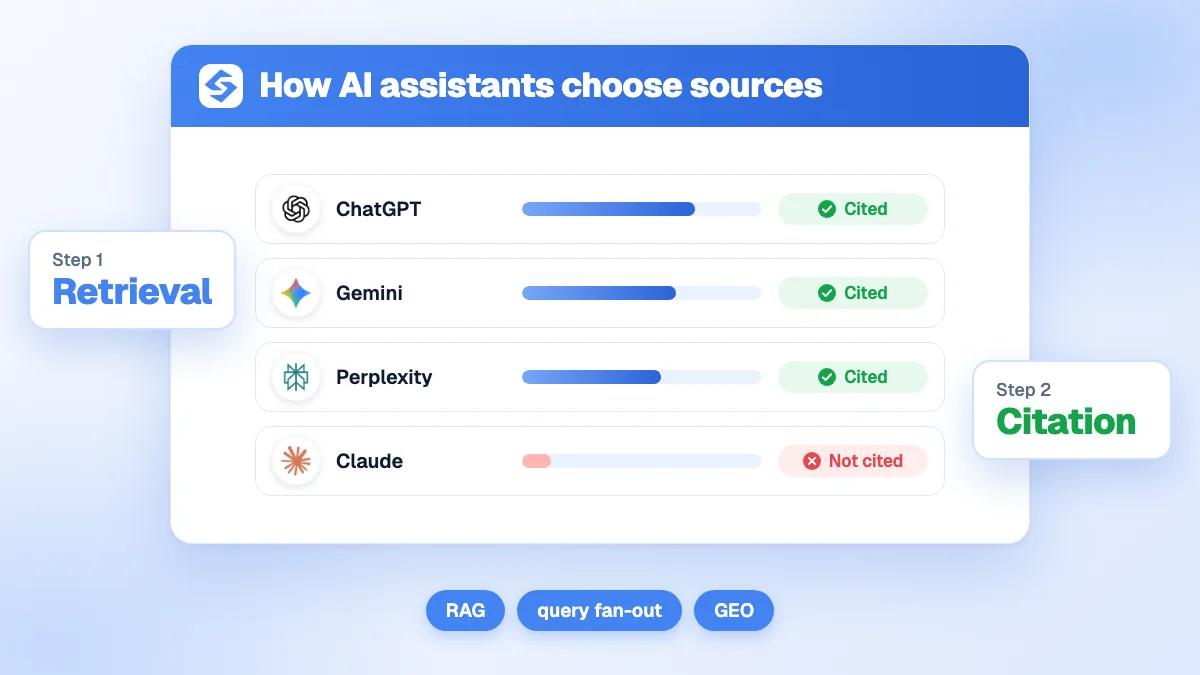
Răspunsurile IA se sprijină pe motoarele de căutare, fără să le înlocuiască. Majoritatea folosesc generarea augmentată prin recuperare (RAG): sistemul face una sau mai multe căutări, recuperează cele mai relevante fragmente dintr-un index web, apoi un model de limbaj scrie un răspuns care citează unele dintre sursele respective.
Google AI Overviews și AI Mode folosesc propriul index al Google. Pagina Google despre funcțiile IA și site-ul tău precizează că o pagină trebuie doar să fie indexată și eligibilă pentru a afișa un fragment, fără marcaj special sau fișier text dedicat IA. Aceste funcții folosesc „query fan-out”: trimit mai multe căutări înrudite, pe subteme, ca să adune pagini de sprijin.
Căutarea ChatGPT recuperează pagini cu crawlerul OpenAI, OAI-SearchBot. Potrivit documentației OpenAI despre crawlere, site-urile care blochează OAI-SearchBot sunt excluse din răspunsurile căutării ChatGPT, în timp ce GPTBot este un crawler separat, folosit pentru antrenarea modelelor.
Gemini, Perplexity și Claude combină și ei recuperarea de pe web cu generarea: Gemini se sprijină pe Căutarea Google, iar Perplexity și Claude trimit propriile crawlere (PerplexityBot, Claude-SearchBot) ca să indexeze paginile pe care le pot cita.
Consecința: etapele clasice decid în continuare vizibilitatea IA. O pagină blocată la crawlare, lipsă din index sau îngropată adânc în clasare are puține șanse să fie recuperată și, deci, citată. Ce se schimbă este alegerea finală: IA selectează fragmente, nu pagini întregi, și favorizează definițiile clare, cifrele cu sursă și răspunsurile directe. Studiul nostru despre sursele citate de ChatGPT arată ce tipuri de pagini câștigă aceste citări.
Ce poți controla la fiecare etapă?
Pune etapele în ordine și obții o listă de verificare valabilă pentru Google, Bing și asistenții IA deopotrivă:
Lasă botii potriviți să intre. Verifică robots.txt pentru reguli de interzicere accidentale și decide deliberat ce crawlere IA permiți.
Fă fiecare pagină importantă accesibilă în cel mult trei clicuri, prin linkuri interne, și include-o în sitemap.
Servește conținutul în HTML, nu doar prin JavaScript, cu răspunsuri de server rapide și stabile.
Dă fiecărui subiect o singură adresă URL canonică și evită paginile aproape identice, care împart semnalele.
Potrivește intenția de căutare. Pornește de la întrebările pe care le scriu oamenii, pe care le descoperă cercetarea de cuvinte cheie, și răspunde la ele în primele rânduri ale paginii.
Câștigă autoritate prin linkuri și mențiuni de la site-uri relevante.
Scrie pasaje care pot fi citate: o definiție, o cifră cu sursa ei, o listă scurtă de pași.
Măsoară ambele canale: Search Console pentru Google și Monitorizarea mențiunilor IA ca să vezi dacă ChatGPT, Gemini sau Claude îți citează marca.
Cum s-au schimbat motoarele de căutare în timp?
Primele motoare de căutare din anii 1990 clasau paginile mai ales prin potrivirea cuvintelor cheie, ceea ce era ușor de manipulat. PageRank-ul Google, care trata linkurile ca voturi, a făcut clasarea mult mai greu de păcălit, iar deceniile următoare au adăugat înțelegerea limbajului prin modele de învățare automată, precum BERT, indexarea mobile-first, detectarea spamului și sisteme de calitate. Istoria Google arată un tipar constant: fiecare schimbare majoră a răsplătit paginile scrise pentru oameni și a penalizat scurtăturile. Răspunsurile generative sunt cel mai recent pas, iar ele răsplătesc același lucru: conținut clar, de încredere și bine structurat.
De la crawlare la trafic: de unde să începi
Motoarele de căutare răsplătesc paginile pe care le pot crawla, înțelege și în care pot avea încredere, iar asistenții IA citează paginile pe care motoarele de căutare le clasează deja. Repară mai întâi accesul, apoi indexarea, apoi relevanța și autoritatea. Ca să țină asta săptămână de săptămână, Sorank găsește cuvintele tale cheie, publică articole optimizate cu surse și linkuri interne și urmărește dacă ChatGPT, Gemini și Claude îți citează marca, totul pe autopilot.
Întrebări frecvente
Cât timp îi ia Google să indexeze o pagină nouă?
Nu există un termen fix: câteva ore pe un site pe care Google îl crawlează des, câteva zile sau săptămâni pe un site nou sau rar actualizat. Liniile către pagină din paginile deja indexate și cererea de indexare cu instrumentul Inspecția URL-ului din Google Search Console accelerează descoperirea. Indexarea tot nu este garantată, chiar și după o cerere.
Caută motoarele de căutare în tot internetul în timp real?
Nu. Ele caută în propriul index, o copie stocată a paginilor pe care crawlerele lor le-au descărcat și analizat deja. O pagină blocată, din spatele unei autentificări sau încă necrawlată nu există pentru motor până când nu este descoperită și indexată.
Folosește ChatGPT rezultatele Google ca să răspundă la întrebări?
ChatGPT nu copiază rezultatele Google. Când caută pe web, recuperează pagini prin infrastructura de căutare proprie OpenAI, inclusiv crawlerul OAI-SearchBot, și citează sursele folosite. Un site care blochează OAI-SearchBot în robots.txt este exclus din aceste răspunsuri, deci contează să poți fi crawlat atât de Google, cât și de OpenAI.
y!
Audit SEO și GEO gratuit
Primește gratuit planul tău de conținut pe 30 de zile
Analizăm concurenții, site-ul tău și vizibilitatea ta în AI pentru a crea gratuit un plan de conținut personalizat.
“Am testat Sorank pe un site real de client și este incredibil. Face tot ce o agenție ți-ar factura 1500$ pe lună. Acum este deja în producție la acel client.”Guillaume Guersanguersanguillaume.com
“Suntem o agenție de publicitate și am vrut să punem în sfârșit SEO-ul pe picioare. Sorank ne-a oferit o viziune clară asupra site-ului nostru, ne-a ajutat să prioritizăm optimizările și să ne structurăm conținutul corect. Instrumentul este ușor de utilizat, bine gândit pentru o echipă și foarte practic pentru a centraliza urmărirea fără să jonglăm între mai multe platforme. O bază foarte solidă pentru a începe din nou cu SEO-ul nostru.”Gaspard MadouiAgenție de publicitate
“Am lăsat pur și simplu software-ul Sorank să își facă treaba, iar acum DR-ul meu este 25 și pagina mea se clasează mai sus.”Lucas Flandrefoundertrace.fr
“M-am specializat în GEO datorită Sorank. Clasamentul GEO îmi permite să îmi arăt clienții poziția față de concurenți în ChatGPT. Este un avantaj comercial real.”MélanieFreelancer SEO
Creștere organicăGenerare de lead-uri pentru instalatori
“Serviciu excelent, funcționează bine pentru site-ul nostru și ne ajută să înțelegem cum să îl îmbunătățim pentru a ne clasa mai bine pe Google și în alte părți. Felicitări, continuați așa, vă recomand.”Hugo T.Comerciant e-commerce