Præferencer
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Sådan fungerer søgemaskiner i 5 trin: crawling, rendering, indeksering, rangering og visning, hvad Bing gør anderledes, og hvordan AI-svar genbruger indekset.

Værktøjer

Kort fortalt
søgemaskiner arbejder i tre hovedfaser. Crawlere opdager og henter sider ved at følge links og sitemaps (crawling), motoren analyserer hver side og gemmer den i en kæmpe database kaldet indekset (indeksering), og når nogen skriver en søgning, vælger rangeringssystemerne de mest relevante og bedste sider fra indekset og sorterer dem (rangering og visning). AI-svar som Google AI Overviews og ChatGPT-søgning tilføjer endnu et lag: de henter sider fra et webindeks og skriver derefter et resumé, der citerer nogle af dem.
Vil du vide mere? Spørg
Hurtig quiz
Passer SEO til dig, og hvordan skal du starte?
Sorank matcher dine svar


Test det i 3 dage på dit eget site, og se, hvor du står på Google, ChatGPT og de andre AI'er.
Start prøveperiode på 3 dage3 dage gratis, derefter stopper du, når du vil. 90 dages garanti: resultater eller pengene tilbage.
At forstå hvordan søgemaskiner fungerer er grundlaget for enhver SEO-beslutning: en side, der ikke bliver gennemsøgt, kan ikke indekseres, og en side, der ikke er indekseret, kan hverken rangere eller blive citeret af en AI-assistent. Google forklarer processen i sin dybdegående guide til, hvordan Google-søgning fungerer. Denne artikel følger de samme faser, tilføjer hvad Bing gør anderledes, og viser, hvad der ændrer sig, når ChatGPT, Gemini eller Perplexity svarer i stedet for en liste med blå links.
En søgemaskine er software, der finder websider, som matcher en søgning. Den har to dele: et indeks, en database over sider, der allerede er opdaget og analyseret, og rangeringssystemer, der afgør, hvilke indekserede sider der bedst besvarer søgningen, og i hvilken rækkefølge. En søgemaskine søger aldrig på det levende web, når du skriver en søgning: den søger i sin egen gemte kopi af det. Derfor kan en side, der blev offentliggjort i morges, forblive usynlig i flere dage.
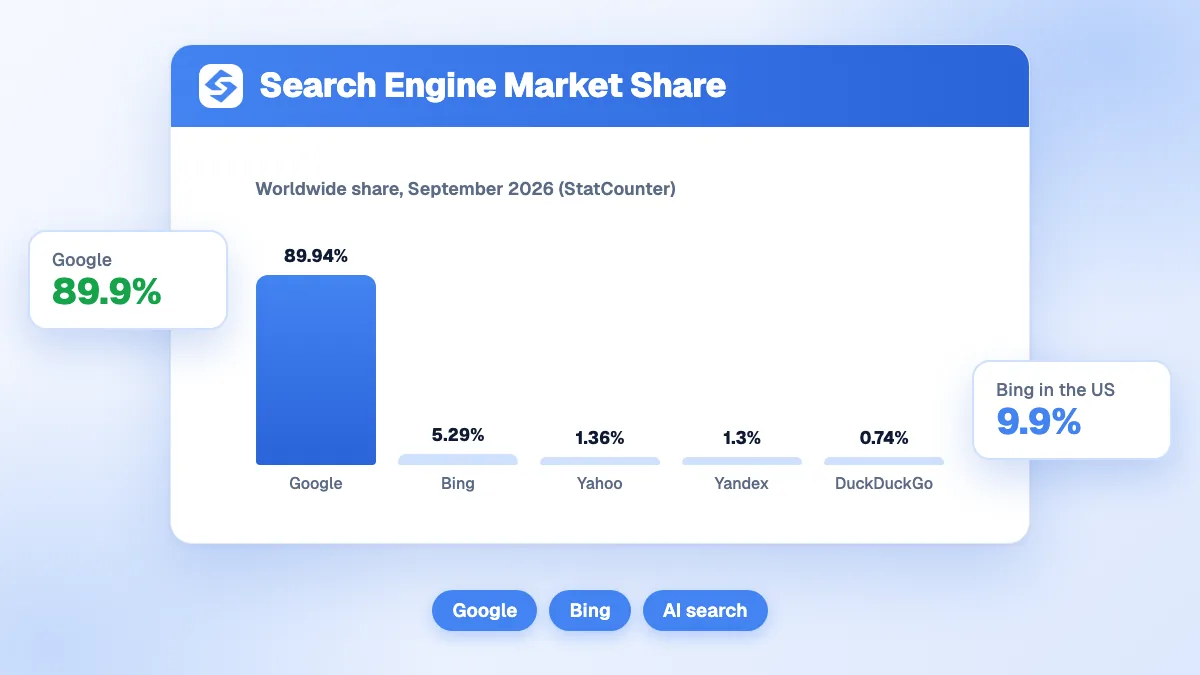
Omfanget forklarer de fleste designvalg. Ifølge Google dækker søgeindekset hundredvis af milliarder websider og fylder langt over 100.000.000 gigabyte (Google, Hvordan søgning fungerer). Ingen motor kan gennemsøge alt hver dag, så hver enkelt prioriterer, hvad der skal hentes, hvad der skal gemmes, og hvad der skal vises. Google dominerer i de fleste lande, men Bing, Yandex, Baidu, Naver og privatlivsfokuserede søgemaskiner følger den samme logik, som vores liste over alternative søgemaskiner til Google viser.
De tre klassiske faser er lettere at handle på, når du deler dem op i fem trin, hver med sine egne håndtag.
| Trin | Hvad motoren gør | Hvad du kan styre |
|---|---|---|
| 1. Crawling | Robotter opdager URL'er og henter sider | robots.txt, interne links, XML-sitemap, serverhastighed |
| 2. Rendering | Kører JavaScript som en browser for at se den endelige side | Indhold til stede i HTML'en, ingen vigtig tekst skjult bag scripts eller logins |
| 3. Indeksering | Analyserer indhold, vælger en kanonisk URL, gemmer signaler | Unikt indhold, canonical-tags, noindex, titler og overskrifter |
| 4. Rangering | Sorterer de indekserede sider for hver søgning | Relevans for hensigten, kvalitet, links, sideoplevelse |
| 5. Visning | Bygger resultatsiden: links, uddrag, AI Overview | Titeltag, metabeskrivelse, strukturerede data, kontrol af uddrag |
Crawling er opdagelsesfasen. Automatiske programmer kaldet crawlere (Googlebot for Google, Bingbot for Bing) starter fra URL'er, de allerede kender, og følger links for at finde nye. De læser også de XML-sitemaps, webstedsejerne sender ind. Google oplyser, at Googlebot bruger en algoritme til at bestemme, hvilke websites der skal gennemsøges, hvor ofte, og hvor mange sider der hentes fra hvert, og at den forsøger ikke at gennemsøge et website så hurtigt, at serveren overbelastes.
Tre ting blokerer crawling: en disallow-regel i robots.txt-filen, sider bag et login, og serverfejl eller timeouts. Håndtagene er en ren intern linkstruktur uden forældreløse sider, en opdateret XML-sitemap og en hurtig, stabil server. Store websites styrer også deres crawlbudget: antallet af URL'er, en crawler er villig til at hente på websitet i en given periode.
Mange sider bygger deres indhold med JavaScript. Google renderer sider med en nyere version af Chrome, så den kan køre scripts og se, hvad en besøgende ser. Rendering koster ressourcer og kan blive forsinket, og indhold, der først vises efter et klik, eller som afhænger af et script, der fejler, kan aldrig blive set. Mange andre crawlere, herunder flere AI-crawlere, kører slet ikke JavaScript: det vigtige indhold hører hjemme i den første HTML.
Indeksering er analysefasen. Motoren læser teksten, titlen, overskrifterne, billederne, videoerne og de strukturerede data og grupperer derefter sider med lignende indhold og vælger én repræsentativ URL, den kanoniske, som er den version, der må vises i resultaterne. Den gemmer signaler om siden: sprog, målland, aktualitet, brugervenlighed. Google sammenligner sit indeks med stikordsregistret bagerst i en bog, med en post for hvert ord, der er set på hver indekseret side.
Indeksering er aldrig garanteret. Google oplyser, at ikke alle sider, den behandler, bliver indekseret: tynt eller duplikeret indhold, et noindex-direktiv eller et design, der gør analysen svær, kan holde en side ude. Vores guide til at få sider indekseret på Google dækker løsningerne, og en gratis indekserbarhedstjekker fortæller dig på få sekunder, om en URL kan indekseres.
Når en søgning kommer ind, fortolker motoren den først: stavning, synonymer, sprog, placering og hensigten bag ordene (lær, sammenlign, køb, nå et bestemt website). Derefter henter den kandidatsider fra indekset og sorterer dem, med mange rangeringssystemer, der arbejder sammen. Google samler de vigtigste faktorer i søgningens betydning, indholdets relevans, dets kvalitet, sidens brugervenlighed og søgningens kontekst, for eksempel placering og indstillinger. Links fra andre websites er stadig et signal om autoritet. Det fulde billede findes i vores gennemgang af Googles rangeringsfaktorer.
To punkter misforstås ofte. For det første oplyser Google, at det ikke tager imod betaling for at gennemsøge et website oftere eller for at rangere det højere: annoncer sælges separat og er mærket som sådan. For det andet ændrer placering og sprog resultaterne langt mere end den personlige browserhistorik gør.
Det sidste trin samler resultatsiden. Ti blå links er blevet til en blanding af annoncer, lokale resultater, billeder, videoer, bokse med "Folk spørger også", featured snippets og for mange informative søgninger en AI Overview. Titlen og beskrivelsen, der vises, kommer fra dit titeltag, din metabeskrivelse og sideindholdet, og strukturerede data kan gøre en side berettiget til rich results. Hvert format er en selvstændig chance for at blive set.
Bing følger den samme model med crawling, indeksering og rangering, med få praktiske forskelle. Den vigtigste er IndexNow, en protokol, der lader et website underrette motorerne, så snart en URL tilføjes, opdateres eller slettes, i stedet for at vente på næste crawl. Ifølge IndexNow.org understøttes protokollen af Microsoft Bing, Naver, Seznam.cz, Yandex og Yep; Google har ikke taget den i brug. Bing-resultater fødes også ind i Microsoft Copilot. Bings markedsandel er lille i de fleste lande, men det tager få minutter at opsætte Bing Webmaster Tools, og det åbner en ekstra kilde til trafik og data.
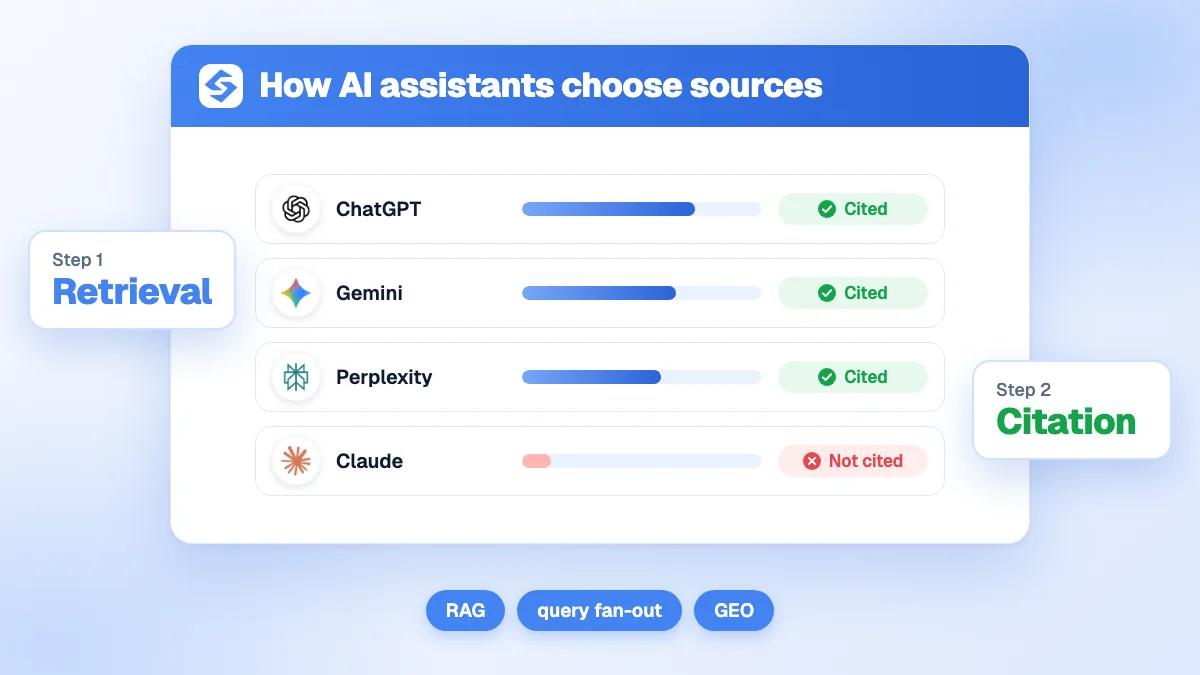
AI-svar ligger oven på søgemaskiner i stedet for at erstatte dem. De fleste bygger på retrieval-augmented generation (RAG): systemet kører en eller flere søgninger, henter de mest relevante passager fra et webindeks, og derefter skriver en sprogmodel et svar, der citerer nogle af kilderne.
Konsekvensen: de klassiske faser afgør stadig AI-synligheden. En side, der er blokeret for crawling, mangler i indekset eller ligger langt nede i rangeringen, har kun en lille chance for at blive hentet og dermed citeret. Det, der ændrer sig, er det endelige valg: AI'en vælger passager, ikke hele sider, og foretrækker klare definitioner, kildebelagte tal og direkte svar. Vores undersøgelse af de kilder, ChatGPT citerer, viser, hvilke typer sider der vinder de citeringer.
Sæt fasene i rækkefølge, og du får en tjekliste, der virker for Google, Bing og AI-assistenter på samme måde:
De tidlige søgemaskiner i 1990'erne rangerede sider primært ud fra søgeordsmatch, hvilket var nemt at manipulere. Googles PageRank, der behandlede links som stemmer, gjorde rangering langt sværere at snyde, og de følgende årtier tilføjede sprogforståelse gennem maskinlæringsmodeller som BERT, indeksering med mobilen som udgangspunkt, spamregistrering og kvalitetssystemer. Googles historie viser et jævnt mønster: hver større ændring belønnede sider skrevet til mennesker og straffede genveje. Generative svar er det seneste skridt, og de belønner det samme: klart, pålideligt og veldisponeret indhold.
Søgemaskiner belønner sider, de kan gennemsøge, forstå og stole på, og AI-assistenter citerer de sider, søgemaskinerne allerede rangerer. Ret adgangen først, derefter indekseringen og til sidst relevans og autoritet. For at holde det kørende uge efter uge finder Sorank dine søgeord, offentliggør optimerede artikler med kilder og interne links og følger, om ChatGPT, Gemini og Claude citerer dit brand, på autopilot.

Der er ingen fast forsinkelse: nogle få timer på et website, som Google gennemsøger ofte, flere dage eller uger på et nyt eller sjældent opdateret website. At linke til siden fra sider, der allerede er indekseret, og anmode om indeksering med URL-kontrolværktøjet i Google Search Console fremskynder opdagelsen. Indeksering er stadig ikke garanteret, selv efter en anmodning.
Nej. De søger i deres eget indeks, en gemt kopi af de sider, deres crawlere allerede har hentet og analyseret. En side, der er blokeret, bag et login eller endnu ikke gennemsøgt, findes ikke for motoren, før den er opdaget og indekseret.
ChatGPT kopierer ikke Googles resultater. Når den søger på nettet, henter den sider gennem OpenAI's egen søgeinfrastruktur, herunder crawleren OAI-SearchBot, og citerer de kilder, den har brugt. Et website, der blokerer OAI-SearchBot i robots.txt, bliver udelukket fra disse svar, så det har betydning, at være gennemsøgelig for både Google og OpenAI.
Vi analyserer dine konkurrenter, dit website og din synlighed i AI for at lave en skræddersyet indholdsplan gratis.
 AI-generator til indholdsbrief
 FAQ-schemagenerator
 AI-generator til blogidéer
 Validator for struktureret data (schema-validator)
 Tjek af alt-tekst
 Analyse af interne links
 Backlink-udfordringen
 AI-generator til metabeskrivelser
 AI-generator til blogtitler
 Tjek af indekserbarhed
 AI-generator til blogdispositioner
 UTM-linkgenerator
 Værktøj til søgeordsclustering
 Tjek af canonical-tag
 XML-sitemap-generator
 Tjek af ødelagte links
 AI-generator til SEO-titler
 Overskriftsanalysator
 SERP-forhåndsvisning
 Redirect-tjekker
 Hreflang-generator
 Overskriftsanalysator
 HTTP-headertjekker
 Favicon-udtrækker
 SERP CTR-beregner
 Beregner for besparelse ved SEO vs. betalt søgning
 Beregner af SEO-synlighedsandel
 Beregner af SEO-afkast
 Beregner af SEO-trafik- og omsætningsprognose
 Beregner af SEO-budget
 Beregner af SEO-break-even
 Beregner af SaaS-SEO-afkast
 Beregner af ROAS
 Beregner af læsetid
 Simulator for placeringsgevinst
 Beregner for værdi af organisk trafik
 Estimator for organisk trafik og tjek af webstedstrafik
 Beregner for LTV/CAC-forhold
 Beregner for lokal SEO-afkast
 Beregner for linkbuilding-omkostninger
 Beregner for søgeordsværdi
 Beregner for søgeordsmulighed
 Beregner for nøgleordstæthed
 Beregner for GEO-ROI
 Beregner for investering i GEO-indhold
 Ecommerce SEO-ROI-beregner
 Beregner for kundens levetidsværdi
 CAC-beregner
 Beregner for CTR
 Beregner for omkostning pr. artikel
 Beregner for konverteringsrate
 Beregner for ROI på content marketing
 Estimator for henvisningstrafik fra ChatGPT
 Beregner for bounce rate
 Beregner for backlinks ROI
 Beregner for AI-synlighedsscore
 AI-trafikværdi-beregner
 AI-share of voice-beregner
 Beregner for omkostningen ved AI-usynlighed
 AI-citationsrate-beregner
 llms.txt-validator
 AI Overview-tjekker og rangeringstjekker for AI Overviews
 Robots.txt-tjekker
 AI-SEO-audit
 LLM-læsbarhedstjek
 SearchGPT-klartjek
 LLM-audit af strukturerede data
 AI-crawlbarhedsaudit for websites
 Hvorfor anbefaler ChatGPT ikke mit website?
 Gemini-rangeringsværktøj
 Perplexity-placeringstjek
 LLM-citeringstjek
 AEO-audit
 GEO-audit
 Test af synlighed i AI-søgning
 Tjek af ChatGPT-synlighed
 llms.txt-generator
 URL-udtrækker
 Webside til Markdown
 Sitemap-tjek
 SERP-volatilitetsmåler
 Sidestørrelsestjek
 Ordtæller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Metatag-generator
 Billedkompressor
 Favicon-generator
 On-page SEO-audit: SEO-tjek og SEO-analyse
 Backlinkanalyseværktøj
 Værktøj til søgeordsanalyse
 Domain Authority-tjek
DE PRØVEDE SORANK, FØR DU GJORDE DET
 “Jeg testede Sorank på en rigtig kundes site, og det er vanvittigt. Det gør alt, et bureau ville opkræve dig 1500 dollar om måneden for. Det går nu i produktion på den kunde.”

 Guillaume Guersanguersanguillaume.com“Vi er et annoncebureau, og vi ville have vores SEO på rette spor en gang for alle. Sorank gav os et klart overblik over vores site, hjalp os med at prioritere optimeringer og strukturere vores indhold ordentligt. Værktøjet er nemt at bruge, velegnet til et team og meget praktisk til at samle opfølgningen et sted uden at jonglere med flere platforme. Et meget solidt fundament til at starte forfra med vores SEO.”
 Gaspard MadouiAnnoncebureau
 “Jeg lod bare Sorank-softwaren gøre sit arbejde, og nu er min DR 25, og min side rangerer højere.”
 Lucas Flandrefoundertrace.fr“Jeg specialiserede mig i GEO takket være Sorank. GEO-ranglisten gør det muligt at vise mine kunder deres placering i forhold til konkurrenterne på ChatGPT. Det er en reel kommerciel fordel.”
 MélanieSEO-freelancer“Fantastisk service, den virker godt til vores hjemmeside og hjælper os med at forstå, hvordan vi kan forbedre den for at rangere bedre på Google og andre steder. Tillykke, bliv ved, jeg anbefaler det.”
 Hugo T.Netbutiksejer