Předvolby
Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

Jak vyhledávače fungují v 5 krocích: procházení, vykreslování, indexace, řazení a zobrazení výsledků, co dělá Bing jinak a jak odpovědi AI využívají index.

Nástroje

Ve zkratce
vyhledávače fungují ve třech hlavních fázích. Roboti objevují a stahují stránky tak, že sledují odkazy a sitemapy (procházení), vyhledávač každou stránku analyzuje a uloží do obrovské databáze zvané index (indexace), a když někdo zadá dotaz, systémy řazení z indexu vyberou nejrelevantnější a nejkvalitnější stránky a seřadí je (řazení a zobrazení). Odpovědi AI, jako jsou Google AI Overviews a vyhledávání ChatGPT, přidávají ještě jednu vrstvu: načtou stránky z webového indexu a napíšou shrnutí, které některé z nich citují.
Chcete jít dál? Zeptejte se
Rychlý kvíz
Hodí se vám SEO a jak začít?
Sorank odpovídá vašim odpovědím


Vyzkoušejte to 3 dny na svém webu a zjistěte, kde stojíte na Googlu, v ChatGPT a v ostatních AI.
Spustit 3denní bezplatnou zkušební verzi3 dny zdarma, poté můžete kdykoli přestat. Garance výsledků nebo vrácení peněz do 90 dnů.
Pochopení toho, jak vyhledávače fungují, je základem každého rozhodnutí v SEO: stránka, která není procházena, nemůže být indexována, a stránka, která není indexována, se nemůže umístit ani být citována AI asistentem. Google proces popisuje v podrobném průvodci fungováním Vyhledávání Google. Tento článek sleduje stejné fáze, přidává, co dělá Bing jinak, a ukazuje, co se změní, když odpovídá ChatGPT, Gemini nebo Perplexity místo seznamu modrých odkazů.
Vyhledávač je software, který nachází webové stránky odpovídající dotazu. Má dvě části: index, databázi stránek, které už byly objeveny a analyzovány, a systémy řazení, které rozhodují, které indexované stránky na dotaz odpovídají nejlépe a v jakém pořadí. Vyhledávač při zadání dotazu neprohledává živý web: prohledává svou vlastní uloženou kopii. Proto může stránka publikovaná dnes ráno několik dní zůstat neviditelná.
Většinu konstrukčních rozhodnutí vysvětluje měřítko. Podle Googlu index Vyhledávání obsahuje stovky miliard webových stránek a jeho velikost přesahuje 100 000 000 gigabajtů (Google, Jak funguje Vyhledávání). Žádný vyhledávač nemůže každý den znovu procházet všechno, takže každý rozhoduje, co stáhnout, co si ponechat a co zobrazit. Google dominuje ve většině zemí, ale Bing, Yandex, Baidu, Naver a vyhledávače zaměřené na soukromí se řídí stejnou logikou, jak ukazuje náš přehled alternativních vyhledávačů k Googlu.
Tři klasické fáze se lépe využijí, když je rozdělíte na pět kroků, každý s vlastními páčkami.
| Krok | Co vyhledávač dělá | Co můžete ovlivnit |
|---|---|---|
| 1. Procházení | Roboti objevují URL a stahují stránky | robots.txt, interní odkazy, XML sitemapa, rychlost serveru |
| 2. Vykreslování | Spouští JavaScript jako prohlížeč, aby viděl konečnou stránku | Obsah přítomný v HTML, žádný klíčový text skrytý za skripty nebo přihlášením |
| 3. Indexace | Analyzuje obsah, vybere kanonickou URL a uloží signály | Unikátní obsah, kanonické značky, noindex, title a nadpisy |
| 4. Řazení | Seřadí indexované stránky pro každý dotaz | Relevance k záměru, kvalita, odkazy, zážitek ze stránky |
| 5. Zobrazení | Sestaví výsledkovou stránku: odkazy, úryvky, AI Overview | Title tag, meta description, strukturovaná data, ovládání úryvků |
Procházení je fáze objevování. Automatické programy zvané roboti (Googlebot pro Google, Bingbot pro Bing) začínají od URL, které už znají, a sledují odkazy, aby našly nové. Čtou také XML sitemapy, které vlastníci webů odešlou. Google uvádí, že Googlebot pomocí algoritmu rozhoduje, které weby procházet, jak často a kolik stránek z každého stáhnout, a snaží se web neprocházet tak rychle, aby přetížil server.
Procházení blokují tři věci: pravidlo zakázání v souboru robots.txt, stránky za přihlášením a chyby serveru nebo časové limity. Páčkami jsou čistá struktura interního propojení bez osiřelých stránek, aktuální XML sitemapa a rychlý, stabilní server. Velké weby také spravují svůj crawl budget, tedy počet URL, které je robot v daném období ochoten na webu stáhnout.
Mnoho stránek buduje obsah pomocí JavaScriptu. Google stránky vykresluje aktuální verzí Chromu, takže dokáže spouštět skripty a vidí, co vidí návštěvník. Vykreslování stojí zdroje a může se zpozdit, a obsah, který se objeví až po kliknutí nebo závisí na skriptu, který selže, nemusí být nikdy uvidět. Mnoho dalších robotů, včetně několika AI robotů, JavaScript vůbec nespouští: klíčový obsah patří do počátečního HTML.
Indexace je fáze analýzy. Vyhledávač čte text, title, nadpisy, obrázky, videa a strukturovaná data, pak seskupí stránky s podobným obsahem a vybere jednu reprezentativní URL, kanonickou, tedy verzi, která se smí objevit ve výsledcích. Ukládá signály o dané stránce: jazyk, cílovou zemi, aktuálnost, použitelnost. Google přirovnává svůj index k rejstříku na konci knihy, s položkou pro každé slovo nalezené na každé indexované stránce.
Indexace není nikdy zaručena. Google uvádí, že ne každá zpracovaná stránka bude indexována: tenký nebo duplicitní obsah, direktiva noindex nebo návrh ztěžující analýzu mohou stránku vyřadit. Náš průvodce indexací stránek v Googlu popisuje nápravy a bezplatný kontrolor indexovatelnosti vám během několika sekund řekne, zda lze URL indexovat.
Když dorazí dotaz, vyhledávač ho nejdřív interpretuje: pravopis, synonyma, jazyk, místo a záměr za slovy (zjistit, porovnat, koupit, dostat se na konkrétní web). Pak z indexu vybere kandidátské stránky a seřadí je pomocí mnoha systémů řazení, které spolupracují. Google hlavní faktory dělí na význam dotazu, relevanci obsahu, jeho kvalitu, použitelnost stránky a kontext hledání, například místo a nastavení. Odkazy z jiných webů zůstávají signálem autority. Celý obraz najdete v našem rozboru faktorů řazení Googlu.
Dva body se často chápou špatně. Za prvé, Google uvádí, že nepřijímá platbu za častější procházení webu nebo za jeho vyšší pořadí: reklamy se prodávají odděleně a jsou jako takové označené. Za druhé, místo a jazyk mění výsledky mnohem víc než osobní historie prohlížení.
Poslední krok sestaví výsledkovou stránku. Deset modrých odkazů se proměnilo ve směs reklam, místních výsledků, obrázků, videí, boxů „Lidé se také ptají“, featured snippetů a u mnoha informačních dotazů také AI Overview. Zobrazený titulek a popis pocházejí z title tagu, meta description a obsahu stránky a strukturovaná data mohou stránku zpřístupnit pro rich results. Každý formát je samostatná šance být viděn.
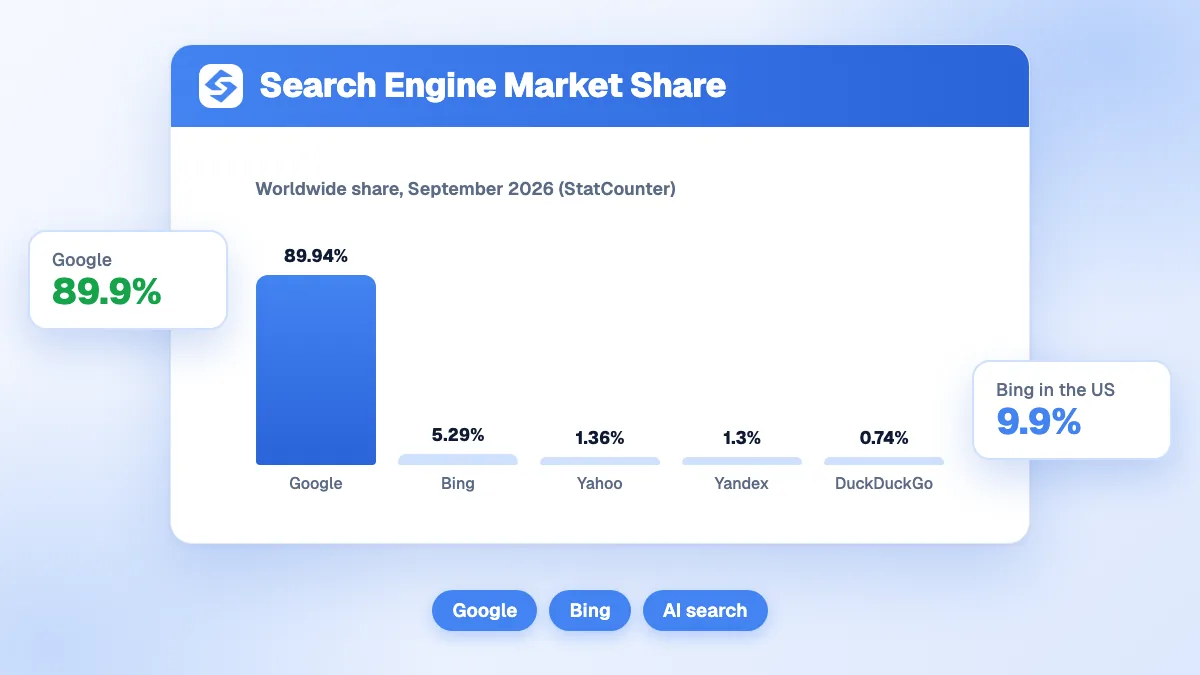
Bing sleduje stejný model procházení, indexace a řazení s několika praktickými rozdíly. Tím hlavním je IndexNow, protokol, který web vyhledávače upozorní hned, když je URL přidána, aktualizována nebo smazána, místo čekání na další procházení. Podle IndexNow.org protokol podporují Microsoft Bing, Naver, Seznam.cz, Yandex a Yep; Google ho nepřijal. Výsledky Bingu také napájejí Microsoft Copilot. Podíl Bingu je ve většině zemí malý, ale nastavení Bing Webmaster Tools zabere pár minut a otevírá druhý zdroj návštěvnosti a dat.
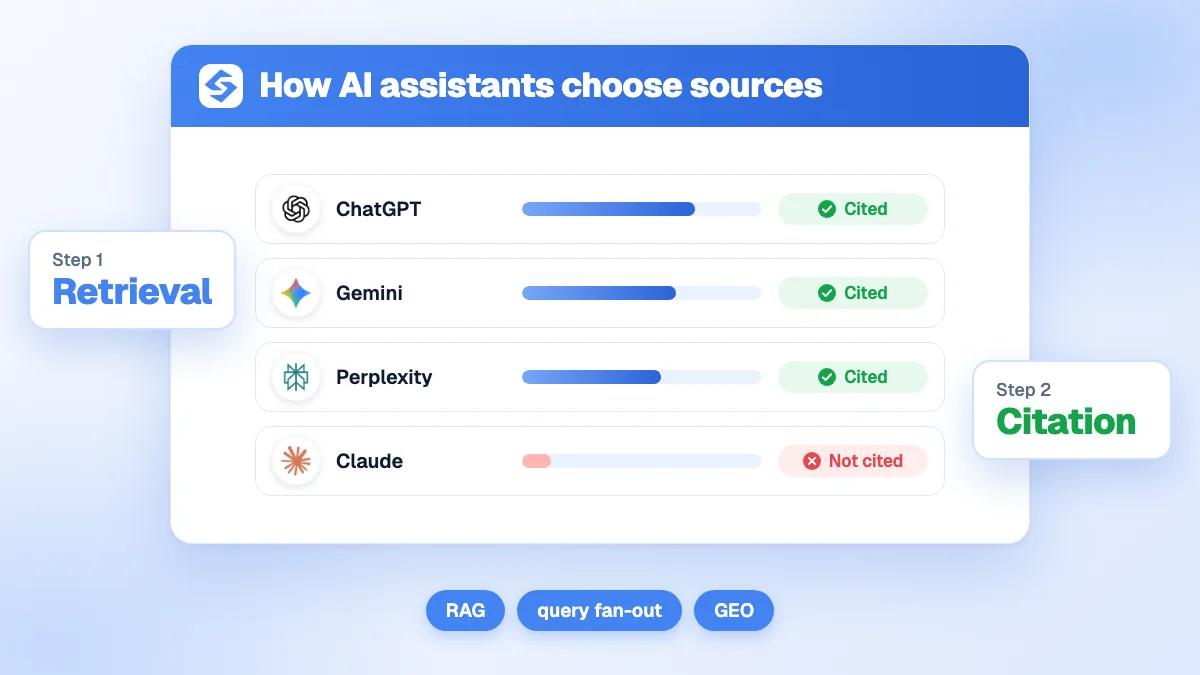
Odpovědi AI stojí nad vyhledávači, místo aby je nahrazovaly. Většina se opírá o generování s rozšířeným vyhledáváním (RAG): systém provede jedno nebo více hledání, z webového indexu načte nejrelevantnější pasáže a jazykový model pak napíše odpověď, která některé z těchto zdrojů cituje.
Z toho plyne: klasické fáze stále rozhodují o viditelnosti v AI. Stránka zablokovaná pro procházení, chybějící v indexu nebo hluboko v řazení má malou šanci být načtena, a tedy citována. Mění se konečný výběr: AI vybírá pasáže, ne celé stránky, a upřednostňuje jasné definice, zdrojovaná čísla a přímé odpovědi. Naše studie zdrojů, které ChatGPT cituje, ukazuje, které typy stránek tyto citace získávají.
Seřaďte fáze a dostanete kontrolní seznam, který funguje pro Google, Bing i AI asistenty:
Rané vyhledávače v devadesátých letech řadily stránky hlavně podle shody klíčových slov, což se dalo snadno zmanipulovat. PageRank od Googlu, který odkazy bral jako hlasy, způsobil, že řazení se dalo obcházet mnohem hůř, a v následujících desetiletích přibylo porozumění jazyku díky modelům strojového učení, jako je BERT, indexaci podle mobilní verze (mobile-first indexing), detekci spamu a systémům kvality. Historie Googlu ukazuje stálý vzorec: každá velká změna odměnila stránky psané pro lidi a potrestala zkratky. Generativní odpovědi jsou nejnovějším krokem a odměňují totéž: jasný, spolehlivý a dobře strukturovaný obsah.
Vyhledávače odměňují stránky, které umí procházet, pochopit a kterým lze věřit, a AI asistenti citují stránky, které vyhledávače už řadí. Nejdřív opravte přístup, pak indexaci, pak relevanci a autoritu. Aby to fungovalo týden co týden, Sorank najde vaše klíčová slova, publikuje optimalizované články se zdroji a interními odkazy a sleduje, zda ChatGPT, Gemini a Claude citují vaši značku, a to na autopilotu.

Neexistuje pevná lhůta: několik hodin u webu, který Google prochází často, několik dní nebo týdnů u nového nebo zřídka aktualizovaného webu. Urychlí to odkaz na stránku z již indexovaných stránek a žádost o indexaci přes nástroj Kontrola URL v Google Search Console. Indexace ani po žádosti není zaručena.
Ne. Prohledávají svůj vlastní index, uloženou kopii stránek, které jejich roboti už stáhli a analyzovali. Stránka, která je blokovaná, za přihlášením nebo ještě neprocházená, pro vyhledávač neexistuje, dokud není objevena a indexována.
ChatGPT výsledky Googlu nekopíruje. Když prohledává web, načítá stránky přes vlastní vyhledávací infrastrukturu OpenAI, včetně robota OAI-SearchBot, a cituje zdroje, které použil. Web, který v robots.txt blokuje OAI-SearchBot, je z těchto odpovědí vyloučen, takže je důležité být procházitelný pro Google i OpenAI.
Analyzujeme vaši konkurenci, váš web a vaši viditelnost v AI, abychom pro vás zdarma připravili obsahový plán na míru.
 Generátor zadání článku s AI
 Generátor schématu FAQ
 Generátor nápadů na blogové články s AI
 Validátor strukturovaných dat (validátor schématu)
 Kontrola alternativních textů
 Analyzátor interních odkazů
 Výzva zpětných odkazů
 Generátor meta popisů s AI
 Generátor titulků blogu s AI
 Kontrola indexovatelnosti pro Google
 Generátor osnovy článku s AI
 Tvůrce UTM odkazů
 Nástroj pro clustering klíčových slov
 Kontrola kanonické značky
 Generátor XML sitemap
 Kontrola nefunkčních odkazů
 Generátor SEO titulků s AI
 Analyzátor nadpisů
 Nástroj pro náhled SERP
 Kontrola přesměrování
 Generátor značek hreflang
 Analyzátor struktury nadpisů
 Kontrola HTTP hlaviček
 Extraktor favicon
 Kalkulačka CTR v SERP
 Kalkulačka úspor SEO oproti placenému vyhledávání
 Kalkulačka podílu hlasu v SEO
 Kalkulačka ROI SEO
 Kalkulačka předpovědi návštěvnosti a tržeb SEO
 Kalkulačka rozpočtu SEO
 Kalkulačka bodu zvratu SEO
 Kalkulačka ROI SEO pro SaaS
 Kalkulačka ROAS
 Kalkulačka doby čtení
 Simulátor zisku pozic
 Kalkulátor hodnoty organické návštěvnosti
 Odhad organické návštěvnosti a kontrola návštěvnosti webu
 Kalkulátor poměru LTV a CAC
 Kalkulátor ROI lokálního SEO
 Kalkulátor nákladů na budování zpětných odkazů
 Kalkulátor hodnoty klíčových slov
 Kalkulačka skóre příležitosti klíčových slov
 Kalkulačka hustoty klíčových slov
 Kalkulačka ROI GEO
 Kalkulačka investice do obsahu GEO
 Kalkulačka návratnosti SEO pro e-shop
 Kalkulačka celoživotní hodnoty zákazníka
 Kalkulačka nákladů na získání zákazníka
 Kalkulátor CTR
 Kalkulátor ceny za článek
 Kalkulátor míry konverze
 Kalkulátor ROI obsahového marketingu
 Odhad návštěvnosti z ChatGPT
 Kalkulátor míry odchodů
 Kalkulátor ROI zpětných odkazů
 Kalkulátor skóre viditelnosti v AI
 Kalkulačka hodnoty návštěvnosti z AI
 Kalkulačka podílu hlasů v AI
 Kalkulačka ceny neviditelnosti v AI
 Kalkulačka míry citování v AI
 Validátor llms.txt
 Kontrola AI Overviews a kontrola pozic v AI Overviews
 Kontrola robots.txt
 Audit AI SEO
 Kontrola čitelnosti pro LLM
 Kontrola připravenosti pro SearchGPT
 Audit strukturovaných dat pro LLM
 Audit procházení webu pro AI
 Proč ChatGPT nedoporučuje můj web
 Nástroj pro kontrolu pozic v Gemini
 Kontrola pořadí v Perplexity
 Kontrola citací v LLM
 Audit optimalizace pro odpovědní enginy
 Audit GEO
 Test viditelnosti ve vyhledávání AI
 Kontrola viditelnosti v ChatGPT
 Generátor llms.txt
 Extraktor URL
 Převod stránky do Markdownu
 Kontrola sitemapy
 Senzor volatility SERP
 Kontrola velikosti stránky
 Počítadlo slov
 Generátor slugů
 Generátor schema
 Generátor robots
 Náhled OG
 Generátor meta značek
 Kompresor obrázků
 Generátor favicon
 Audit on-page SEO: kontrola a analýza SEO
 Nástroj pro analýzu zpětných odkazů
 Nástroj pro výzkum klíčových slov
 Kontrola autority domény
VYZKOUŠELI SORANK PŘED VÁMI
 “Sorank jsem otestoval na skutečném webu klienta a je to neuvěřitelné. Dělá všechno, za co by vám agentura účtovala 1500 $ měsíčně. Právě ho nasazujeme do provozu na tomto klientovi.”

 Guillaume Guersanguersanguillaume.com“Jsme reklamní agentura a chtěli jsme konečně dostat naše SEO na pravou míru. Sorank nám poskytl jasný pohled na náš web, pomohl nám určit priority optimalizací a správně strukturovat náš obsah. Nástroj se snadno používá, je dobře navržený pro tým a velmi praktický, protože centralizuje sledování bez nutnosti žonglovat s více platformami. Velmi pevný základ pro nový start našeho SEO.”
 Gaspard MadouiReklamní agentura
 “Nechal jsem software Sorank dělat svou práci a teď je moje DR 25 a moje stránka se umisťuje výš.”
 Lucas Flandrefoundertrace.fr“Díky Sorank se specializuji na GEO. Žebříček GEO mi umožňuje ukázat klientům jejich postavení oproti konkurenci v ChatGPT. Je to skutečná obchodní výhoda.”
 MélanieSEO freelancer“Skvělá služba, dobře funguje pro náš web a pomáhá nám pochopit, jak ho zlepšit, aby se lépe umisťoval ve výsledcích Google a jinde. Gratulujeme, pokračujte, doporučuji.”
 Hugo T.Majitel e-shopu