संक्षेप में: सर्च इंजन तीन मुख्य चरणों में काम करते हैं। क्रॉलर्स लिंक और साइटमैप का पीछा करके पेज खोजते और डाउनलोड करते हैं (क्रॉलिंग), इंजन हर पेज का विश्लेषण करके उसे एक विशाल डेटाबेस में रखता है जिसे इंडेक्स कहते हैं (इंडेक्सिंग), और जब कोई सवाल टाइप करता है, तो रैंकिंग सिस्टम उस इंडेक्स से सबसे प्रासंगिक, सबसे अच्छी क्वालिटी वाले पेज चुनकर क्रम में लगाते हैं (रैंकिंग और नतीजे दिखाना)। Google AI Overviews और ChatGPT search जैसे AI जवाब एक परत और जोड़ते हैं: वे वेब इंडेक्स से पेज खोजते हैं, फिर एक सार लिखते हैं जिसमें उनमें से कुछ का हवाला होता है।
सर्च इंजन कैसे काम करते हैं, यह समझना हर SEO फ़ैसले की नींव है: जो पेज क्रॉल नहीं होता वह इंडेक्स नहीं हो सकता, और जो इंडेक्स नहीं होता वह न रैंक कर सकता है, न AI असिस्टेंट द्वारा उद्धृत हो सकता है। Google यह प्रक्रिया अपनी Google Search कैसे काम करता है वाली विस्तृत गाइड में समझाता है। यह लेख उन्हीं चरणों को फ़ॉलो करता है, जोड़ता है कि Bing अलग तरह से क्या करता है, और दिखाता है कि ChatGPT, Gemini या Perplexity नीले लिंक की सूची के बजाय जवाब देते हैं तो क्या बदलता है।
सर्च इंजन क्या है?
एक सर्च इंजन ऐसा सॉफ़्टवेयर है जो किसी सवाल से मेल खाने वाले वेब पेज ढूँढता है। इसके दो हिस्से हैं: एक इंडेक्स, यानी पहले से खोजे और विश्लेषित किए गए पेजों का डेटाबेस, और रैंकिंग सिस्टम, जो तय करते हैं कि इंडेक्स के कौन-से पेज सवाल का सबसे अच्छा जवाब देते हैं और किस क्रम में। जब आप सवाल टाइप करते हैं, तो सर्च इंजन असल वेब में नहीं खोजता: वह अपनी संग्रहित प्रति में खोजता है। इसीलिए आज सुबह प्रकाशित पेज कई दिनों तक दिखाई न दे सकता है।
पैमाना ज़्यादातर डिज़ाइन फ़ैसले समझाता है। Google के अनुसार उसका Search इंडेक्स सैकड़ों अरब वेबपेज कवर करता है और 100,000,000 गीगाबाइट से काफ़ी बड़ा है (Google, How Search Works)। कोई भी इंजन हर दिन सब कुछ दोबारा क्रॉल नहीं कर सकता, इसलिए हर इंजन तय करता है कि क्या लाना है, क्या रखना है और क्या दिखाना है। ज़्यादातर देशों में Google आगे है, लेकिन Bing, Yandex, Baidu, Naver और प्राइवेसी पर केंद्रित इंजन भी यही तर्क अपनाते हैं, जैसा हमारी Google के विकल्प वाले सर्च इंजनों की सूची दिखाती है।
सर्च इंजन चरण-दर-चरण कैसे काम करते हैं?
तीन क्लासिक चरण ज़्यादा काम के तब बनते हैं जब उन्हें पाँच कदमों में बाँटा जाए, और हर कदम के अपने नियंत्रण होते हैं।
| चरण | इंजन क्या करता है | आप क्या नियंत्रित करते हैं |
|---|
| 1. क्रॉलिंग | बॉट URL खोजते हैं और पेज डाउनलोड करते हैं | robots.txt, इंटरनल लिंक, XML साइटमैप, सर्वर की रफ़्तार |
| 2. रेंडरिंग | ब्राउज़र की तरह JavaScript चलाकर अंतिम पेज देखता है | कंटेंट HTML में मौजूद हो, ज़रूरी टेक्स्ट स्क्रिप्ट या लॉगिन के पीछे छिपा न हो |
| 3. इंडेक्सिंग | कंटेंट का विश्लेषण करता है, एक कैनॉनिकल URL चुनता है, सिग्नल सहेजता है | अनोखा कंटेंट, canonical टैग, noindex, टाइटल और हेडिंग |
| 4. रैंकिंग | हर सवाल के लिए इंडेक्स पेजों को क्रम देता है | इरादे से प्रासंगिकता, क्वालिटी, लिंक, पेज अनुभव |
| 5. नतीजे दिखाना | नतीजों का पेज बनाता है: लिंक, स्निपेट्स, AI Overview | Title टैग, meta description, स्ट्रक्चर्ड डेटा, स्निपेट नियंत्रण |
चरण 1: क्रॉलिंग, पेज खोजना
क्रॉलिंग खोज का चरण है। Googlebot (Google के लिए) और Bingbot (Bing के लिए) जैसे स्वचालित प्रोग्राम, जिन्हें क्रॉलर्स कहते हैं, उन URLs से शुरू करते हैं जो वे पहले से जानते हैं, और नए URL ढूँढने के लिए लिंक का पीछा करते हैं। वे साइट मालिकों द्वारा जमा किए गए XML साइटमैप भी पढ़ते हैं। Google बताता है कि Googlebot एक एल्गोरिदम से तय करता है कि कौन-सी साइट कितनी बार क्रॉल करनी है और हर साइट से कितने पेज लाने हैं, और वह किसी साइट को इतनी तेज़ी से क्रॉल करने से बचने की कोशिश करता है कि सर्वर पर बोझ पड़े।
तीन चीज़ें क्रॉलिंग रोकती हैं: robots.txt फ़ाइल में disallow नियम, लॉगिन के पीछे के पेज, और सर्वर एरर या टाइमआउट। इनके नियंत्रण हैं: बिना ऑर्फ़न पेज वाली साफ़ इंटरनल लिंकिंग संरचना, एक अपडेटेड XML साइटमैप, और तेज़, स्थिर सर्वर। बड़ी साइटें अपना क्रॉल बजट भी संभालती हैं: किसी दी गई अवधि में क्रॉलर साइट पर जितने URL लाने को तैयार है, उनकी संख्या।
चरण 2: रेंडरिंग, ब्राउज़र की तरह पेज देखना
कई पेज अपना कंटेंट JavaScript से बनाते हैं। Google पेज को Chrome के एक नए वर्शन से रेंडर करता है, इसलिए वह स्क्रिप्ट चला सकता है और वह देख सकता है जो विज़िटर देखता है। रेंडरिंग में संसाधन लगते हैं और उसमें देरी हो सकती है, और ऐसा कंटेंट जो सिर्फ़ क्लिक के बाद दिखता है, या किसी ऐसी स्क्रिप्ट पर निर्भर है जो विफल हो जाए, कभी देखा ही न जाए। कई दूसरे क्रॉलर, जिनमें कुछ AI क्रॉलर भी शामिल हैं, JavaScript बिल्कुल नहीं चलाते: ज़रूरी कंटेंट शुरुआती HTML में होना चाहिए।
चरण 3: इंडेक्सिंग, समझना और सहेजना
इंडेक्सिंग विश्लेषण का चरण है। इंजन टेक्स्ट, टाइटल, हेडिंग, इमेज, वीडियो और स्ट्रक्चर्ड डेटा पढ़ता है, फिर मिलते-जुलते कंटेंट वाले पेजों को एक साथ रखता है और एक प्रतिनिधि URL चुनता है, जिसे कैनॉनिकल कहते हैं, यानी वह संस्करण जो नतीजों में दिखने योग्य है। वह उस पेज के बारे में सिग्नल सहेजता है: भाषा, लक्षित देश, ताज़गी, उपयोगिता। Google अपने इंडेक्स की तुलना किताब के पीछे के इंडेक्स से करता है, जिसमें हर इंडेक्स पेज पर देखे गए हर शब्द की एंट्री होती है।
इंडेक्सिंग की गारंटी कभी नहीं होती। Google बताता है कि वह जो हर पेज प्रोसेस करता है, वह इंडेक्स नहीं होगा: पतला या डुप्लीकेट कंटेंट, noindex निर्देश या ऐसा डिज़ाइन जिसका विश्लेषण मुश्किल हो, पेज को बाहर रख सकता है। Google पर पेज इंडेक्स कराने वाली हमारी गाइड समाधान बताती है, और एक मुफ़्त इंडेक्सेबिलिटी चेकर सेकंडों में बताता है कि कोई URL इंडेक्स हो सकता है या नहीं।
चरण 4: रैंकिंग, सबसे अच्छे जवाब चुनना
जब सवाल आता है, तो इंजन पहले उसे समझता है: वर्तनी, पर्यायवाची शब्द, भाषा, स्थान, और शब्दों के पीछे का इरादा (सीखना, तुलना करना, खरीदना, किसी खास साइट तक पहुँचना)। फिर वह इंडेक्स से उम्मीदवार पेज लाता है और कई रैंकिंग सिस्टम मिलकर उन्हें क्रम देते हैं। Google मुख्य कारकों को इन श्रेणियों में बाँटता है: सवाल का अर्थ, कंटेंट की प्रासंगिकता, उसकी क्वालिटी, पेज की उपयोगिता, और सर्च का संदर्भ, जैसे स्थान और सेटिंग्स। दूसरी साइटों के लिंक अब भी अधिकार का सिग्नल हैं। पूरी तस्वीर हमारे Google रैंकिंग कारकों के विश्लेषण में है।
दो बातें अक्सर गलत समझी जाती हैं। पहली, Google कहता है कि वह किसी साइट को ज़्यादा बार क्रॉल करने या ऊँची रैंक देने के लिए पैसे नहीं लेता: विज्ञापन अलग बिकते हैं और उसी तरह लेबल होते हैं। दूसरी, स्थान और भाषा नतीजों को निजी ब्राउज़िंग इतिहास से कहीं ज़्यादा बदलते हैं।
चरण 5: नतीजे दिखाना, नतीजों का पेज बनाना
आख़िरी चरण नतीजों का पेज जोड़ता है। दस नीले लिंक अब विज्ञापनों, स्थानीय नतीजों, इमेज, वीडियो, “People also ask” बॉक्स, फ़ीचर्ड स्निपेट्स और कई सूचनात्मक सवालों के लिए AI Overview के मिश्रण में बदल गए हैं। दिखाया गया टाइटल और विवरण आपके title टैग, meta description और पेज के कंटेंट से आता है, और स्ट्रक्चर्ड डेटा किसी पेज को रिच रिज़ल्ट्स के योग्य बना सकता है। हर फ़ॉर्मेट देखे जाने का एक अलग मौका है।
Bing, Google से कैसे अलग है?
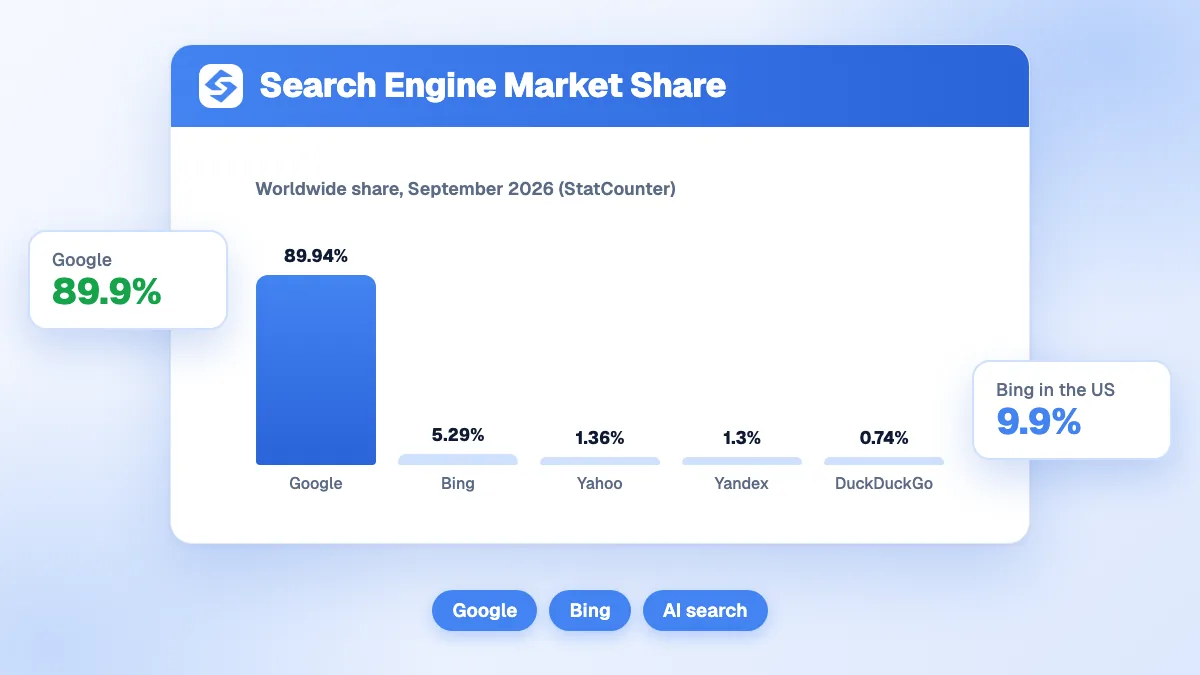
Bing वही क्रॉल, इंडेक्स और रैंक मॉडल अपनाता है, कुछ व्यावहारिक अंतरों के साथ। सबसे बड़ा है IndexNow, एक प्रोटोकॉल जो साइट को तुरंत बताने देता है कि कोई URL जोड़ा, अपडेट या हटाया गया है, अगले क्रॉल का इंतज़ार किए बिना। IndexNow.org के अनुसार यह प्रोटोकॉल Microsoft Bing, Naver, Seznam.cz, Yandex और Yep सपोर्ट करते हैं; Google ने इसे नहीं अपनाया है। Bing के नतीजे Microsoft Copilot को भी देते हैं। ज़्यादातर देशों में Bing का बाज़ार हिस्सा छोटा है, लेकिन Bing Webmaster Tools सेट करने में कुछ मिनट लगते हैं और ट्रैफ़िक व डेटा का दूसरा स्रोत खुलता है।
ChatGPT और AI Overviews जैसे AI असिस्टेंट्स कंटेंट कैसे ढूँढते हैं?
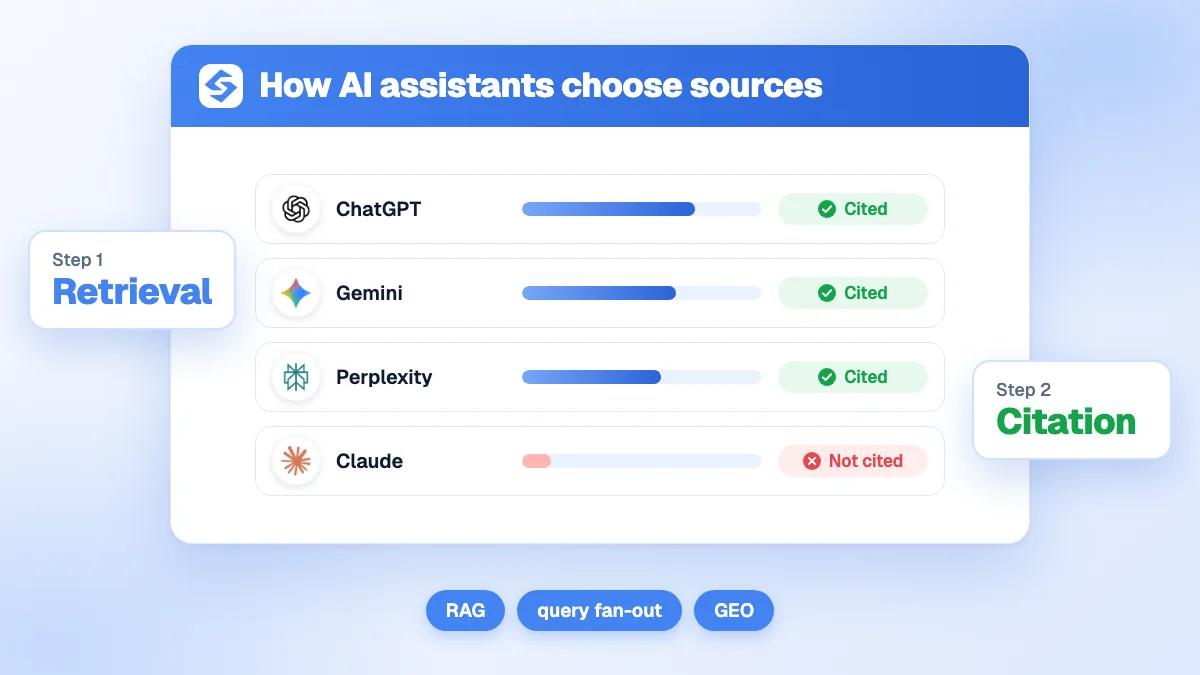
AI जवाब सर्च इंजनों की जगह लेने के बजाय उनके ऊपर बैठते हैं। ज़्यादातर रिट्रीवल-ऑगमेंटेड जेनरेशन (RAG) पर निर्भर हैं: सिस्टम एक या कई सर्च चलाता है, वेब इंडेक्स से सबसे प्रासंगिक अंश लाता है, फिर एक भाषा मॉडल एक जवाब लिखता है जिसमें उन स्रोतों में से कुछ का हवाला होता है।
- Google AI Overviews और AI Mode Google के अपने इंडेक्स का इस्तेमाल करते हैं। Google के AI फ़ीचर्स और आपकी वेबसाइट वाले पेज के अनुसार पेज को सिर्फ़ इंडेक्स और स्निपेट दिखाने योग्य होना चाहिए, किसी खास मार्कअप या AI टेक्स्ट फ़ाइल की ज़रूरत नहीं। ये फ़ीचर “query fan-out” का इस्तेमाल करते हैं: सहायक पेज इकट्ठा करने के लिए उप-विषयों पर कई संबंधित सर्च चलाते हैं।
- ChatGPT search OpenAI के क्रॉलर OAI-SearchBot से पेज लेता है। OpenAI के क्रॉलर दस्तावेज़ के अनुसार जो साइटें OAI-SearchBot को ब्लॉक करती हैं, वे ChatGPT search के जवाबों से बाहर रहती हैं, जबकि GPTBot एक अलग क्रॉलर है जो मॉडल ट्रेनिंग के लिए इस्तेमाल होता है।
- Gemini, Perplexity और Claude भी वेब रिट्रीवल को जेनरेशन के साथ जोड़ते हैं: Gemini Google Search से मदद लेता है, जबकि Perplexity और Claude अपने क्रॉलर (PerplexityBot, Claude-SearchBot) भेजते हैं ताकि वे उन पेजों को इंडेक्स करें जिनका वे हवाला दे सकें।
इसका नतीजा: क्लासिक चरण अब भी AI विज़िबिलिटी तय करते हैं। जो पेज क्रॉल से ब्लॉक है, इंडेक्स से गायब है या रैंकिंग में बहुत नीचे दबा है, उसके रिट्रीव होने और इसलिए उद्धृत होने की संभावना कम है। जो बदलता है वह आख़िरी चुनाव है: AI पूरे पेज के बजाय अंश चुनता है, और साफ़ परिभाषाओं, स्रोत वाले आँकड़ों और सीधे जवाबों को पसंद करता है। ChatGPT जिन स्रोतों का हवाला देता है, उस पर हमारा अध्ययन दिखाता है कि किस तरह के पेज ये उद्धरण जीतते हैं।
हर चरण पर आप क्या नियंत्रित कर सकते हैं?
चरणों को क्रम में रखें तो एक चेकलिस्ट बनती है जो Google, Bing और AI असिस्टेंट्स, तीनों के लिए काम करती है:
- सही बॉट्स को आने दें। robots.txt में गलती से लगे disallow नियम जाँचें, और सोच-समझकर तय करें कि कौन-से AI क्रॉलर्स को अनुमति है।
- हर ज़रूरी पेज तक पहुँच बनाएँ, इंटरनल लिंक से तीन क्लिक के भीतर, और उसे साइटमैप में डालें।
- कंटेंट HTML में दें, सिर्फ़ JavaScript के ज़रिए नहीं, तेज़ और स्थिर सर्वर जवाबों के साथ।
- हर विषय को एक कैनॉनिकल URL दें और लगभग-डुप्लीकेट पेजों से बचें जो सिग्नल बाँटते हैं।
- सर्च इरादे से मेल खाएँ। उन सवालों से शुरू करें जो लोग टाइप करते हैं, जिन्हें keyword research सामने लाता है, और उनका जवाब पेज की पहली पंक्तियों में दें।
- अधिकार कमाएँ प्रासंगिक साइटों से लिंक और उल्लेखों के ज़रिए।
- ऐसे अंश लिखें जिन्हें उद्धृत किया जा सके: एक परिभाषा, स्रोत के साथ एक संख्या, चरणों की एक छोटी सूची।
- दोनों चैनल मापें: Google के लिए Search Console, और यह देखने के लिए कि ChatGPT, Gemini या Claude आपके ब्रांड का हवाला देते हैं या नहीं, AI मेंशन ट्रैकिंग।
सर्च इंजन समय के साथ कैसे बदले हैं?
1990 के दशक के शुरुआती इंजन पेजों को ज़्यादातर कीवर्ड मिलान से रैंक करते थे, जिसमें हेरफेर आसान था। Google का PageRank, जो लिंक को वोट मानता था, रैंकिंग में हेरफेर को कहीं मुश्किल बना गया, और उसके बाद के दशकों में BERT जैसे मशीन लर्निंग मॉडलों से भाषा की समझ, mobile-first इंडेक्सिंग, स्पैम डिटेक्शन और क्वालिटी सिस्टम जुड़े। Google का इतिहास एक स्थिर पैटर्न दिखाता है: हर बड़े बदलाव ने इंसानों के लिए लिखे गए पेजों को इनाम दिया और शॉर्टकट को सज़ा। जनरेटिव जवाब ताज़ा कदम हैं, और वे भी वही चीज़ इनाम देते हैं: साफ़, भरोसेमंद, अच्छी तरह संरचित कंटेंट।
क्रॉलिंग से ट्रैफ़िक तक: कहाँ से शुरू करें
सर्च इंजन उन पेजों को इनाम देते हैं जिन्हें वे क्रॉल, समझ और भरोसा कर सकें, और AI असिस्टेंट्स वे पेज उद्धृत करते हैं जिन्हें सर्च इंजन पहले ही रैंक करते हैं। पहले पहुँच ठीक करें, फिर इंडेक्सिंग, फिर प्रासंगिकता और अधिकार। यह हफ़्ते-दर-हफ़्ते चलता रहे, इसके लिए Sorank आपके कीवर्ड ढूँढता है, स्रोतों और इंटरनल लिंक के साथ अनुकूलित आर्टिकल प्रकाशित करता है, और ट्रैक करता है कि ChatGPT, Gemini और Claude आपके ब्रांड का हवाला दे रहे हैं या नहीं, autopilot पर।