Integritet är viktigt för oss, så du kan välja att inaktivera vissa typer av lagring som kanske inte är nödvändig för webbplatsens grundläggande funktioner. Om du blockerar kategorier kan det påverka din upplevelse av webbplatsen. Mer information (Cookiepolicy)
Platt illustration av tre blå staplar av olika höjd, där den högsta är mörkblå med en gul stjärna överst.
Verktyg
På den här sidan
Kort sagt
sökmotorer arbetar i tre huvudsteg. Sökrobotar upptäcker och hämtar sidor genom att följa länkar och sitemaps (crawling), motorn analyserar varje sida och lagrar den i en enorm databas som kallas index (indexering), och när någon skriver en sökning väljer rankingsystemen ut och sorterar de mest relevanta sidorna av hög kvalitet ur indexet (ranking och visning). AI-svar som Google AI-översikter och ChatGPT-sök lägger till ett lager till: de hämtar sidor från ett webbindex och skriver sedan en sammanfattning som citerar några av dem.
3 dagar gratis, sedan kan du avsluta när du vill. 90 dagars garanti med pengarna tillbaka om du inte ser resultat.
Att förstå hur sökmotorer fungerar är grunden för varje SEO-beslut: en sida som inte crawlas kan inte indexeras, och en sida som inte indexeras kan varken rankas eller citeras av en AI-assistent. Google förklarar processen i sin djupgående guide till hur Google Sök fungerar. Den här artikeln följer samma steg, lägger till vad Bing gör annorlunda och visar vad som förändras när ChatGPT, Gemini eller Perplexity svarar i stället för en lista med blå länkar.
Vad är en sökmotor?
En sökmotor är programvara som hittar webbsidor som matchar en sökning. Den har två delar: ett index, en databas med sidor som redan upptäckts och analyserats, och rankingsystem, som avgör vilka indexerade sidor som svarar bäst på sökningen och i vilken ordning. En sökmotor söker aldrig på hela webben i realtid när du skriver en sökning: den söker i sin egen lagrade kopia. Därför kan en sida som publicerades i morse vara osynlig i flera dagar.
Crawling är upptäcktsteget. Automatiska program som kallas sökrobotar (Googlebot för Google, Bingbot för Bing) startar från URL:er de redan känner till och följer länkar för att hitta nya. De läser också de XML-sitemaps som sajtägare skickar in. Google anger att Googlebot använder en algoritm för att avgöra vilka sajter som ska crawlas, hur ofta, och hur många sidor som ska hämtas från varje, och att den försöker att inte crawla en sajt så snabbt att servern överbelastas.
Tre saker blockerar crawling: en disallow-regel i robots.txt-filen, sidor bakom inloggning, och serverfel eller timeouter. Hävstängerna är en ren struktur för interna länkar utan föräldralösa sidor, en uppdaterad XML-sitemap och en snabb, stabil server. Stora sajter hanterar också sin crawlbudget: antalet URL:er som en sökrobot är villig att hämta på sajten under en viss period.
Steg 2: rendering, att se sidan som en webbläsare
Många sidor bygger sitt innehåll med JavaScript. Google renderar sidor med en ny version av Chrome, så den kan köra skript och se vad besökaren ser. Rendering kostar resurser och kan försenas, och innehåll som bara dyker upp efter ett klick, eller som beror på ett skript som misslyckas, kanske aldrig ses. Många andra sökrobotar, inklusive flera AI-robotar, kör inte JavaScript alls: viktigt innehåll hör hemma i den första HTML:en.
Steg 3: indexering, att förstå och lagra
Indexering är analyssteget. Motorn läser texten, titeln, rubrikerna, bilderna, videorna och den strukturerade datan, grupperar sedan sidor med liknande innehåll och väljer en representativ URL, den kanoniska versionen, som är den som får visas i resultaten. Den lagrar signaler om sidan: språk, målland, aktualitet, användbarhet. Google jämför sitt index med registret längst bak i en bok, med en post för varje ord på varje indexerad sida.
Indexering är aldrig garanterad. Google anger att inte varje sida som bearbetas kommer att indexeras: tunt eller dubbelt innehåll, ett noindex-direktiv eller en design som gör analysen svår kan hålla en sida utanför. Vår guide om hur du får sidor indexerade i Google går igenom åtgärderna, och en gratis kontroll av indexerbarhet talar om på några sekunder om en URL kan indexeras.
Steg 4: ranking, att välja de bästa svaren
När en sökning kommer in tolkar motorn den först: stavning, synonymer, språk, plats och avsikten bakom orden (lära sig, jämföra, köpa, nå en specifik sajt). Den hämtar sedan kandidatsidor från indexet och sorterar dem med många rankingsystem som samverkar. Google grupperar de viktigaste faktorerna i sökningens betydelse, innehållets relevans, dess kvalitet, sidans användbarhet och sökningens sammanhang, till exempel plats och inställningar. Länkar från andra sajter är fortfarande en signal om auktoritet. Hela bilden finns i vår analys av Googles rankingfaktorer.
Två saker missförstås ofta. För det första anger Google att det inte tar betalt för att crawla en sajt oftare eller för att rangordna den högre: annonser säljs separat och märks ut som sådana. För det andra påverkar plats och språk resultaten långt mer än personlig surfhistorik.
Steg 5: visning, att bygga resultatsidan
Det sista steget sätter ihop resultatsidan. De tio blå länkarna har blivit en blandning av annonser, lokala resultat, bilder, videor, rutor med “Andra användare frågar också”, utvalda utdrag och, för många informativa sökningar, en AI-översikt. Titeln och beskrivningen som visas kommer från din title-tagg, metabeskrivning och sidans innehåll, och strukturerad data kan göra en sida berättigad till rika resultat. Varje format är ett separat tillfälle att synas.
Hur skiljer sig Bing från Google?
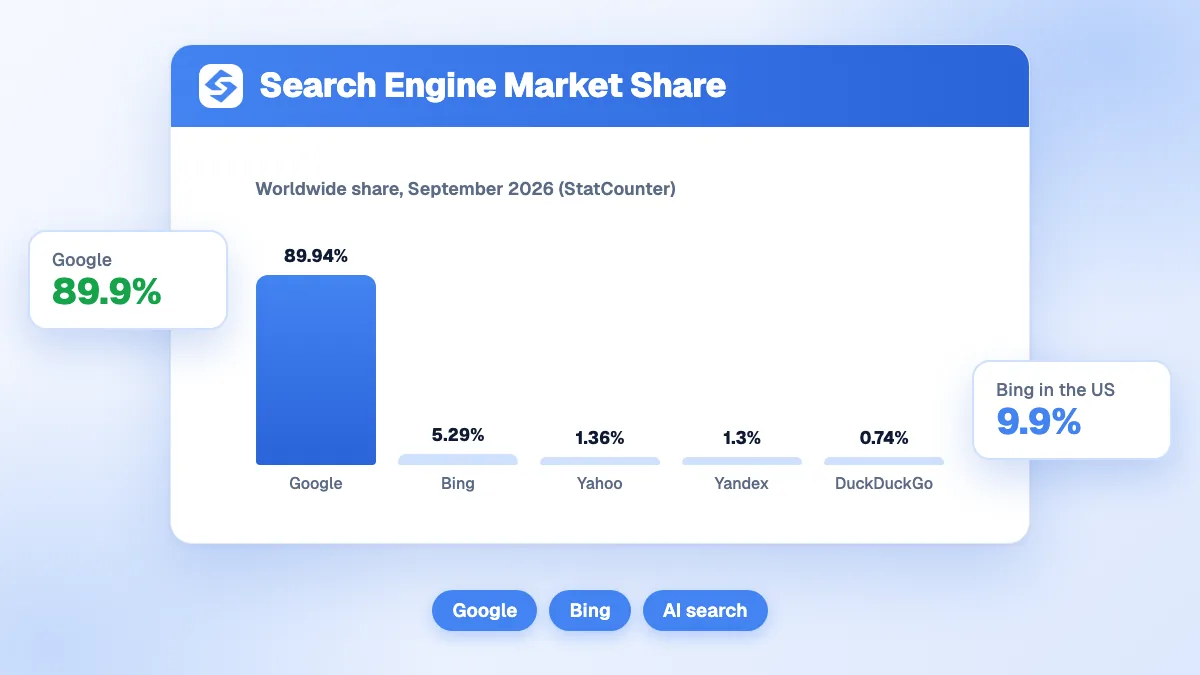
Bing följer samma modell för crawling, indexering och ranking, med några praktiska skillnader. Den viktigaste är IndexNow, ett protokoll som låter en sajt meddela sökmotorerna så snart en URL läggs till, uppdateras eller tas bort, i stället för att vänta på nästa crawl. Enligt IndexNow.org stöds protokollet av Microsoft Bing, Naver, Seznam.cz, Yandex och Yep; Google har inte anslutit sig. Bings resultat matar också Microsoft Copilot. Bings marknadsandel är liten i de flesta länder, men det tar några minuter att sätta upp Bing Webmaster Tools och det öppnar en andra källa till trafik och data.
Hur hittar AI-assistenter som ChatGPT och AI-översikter innehåll?
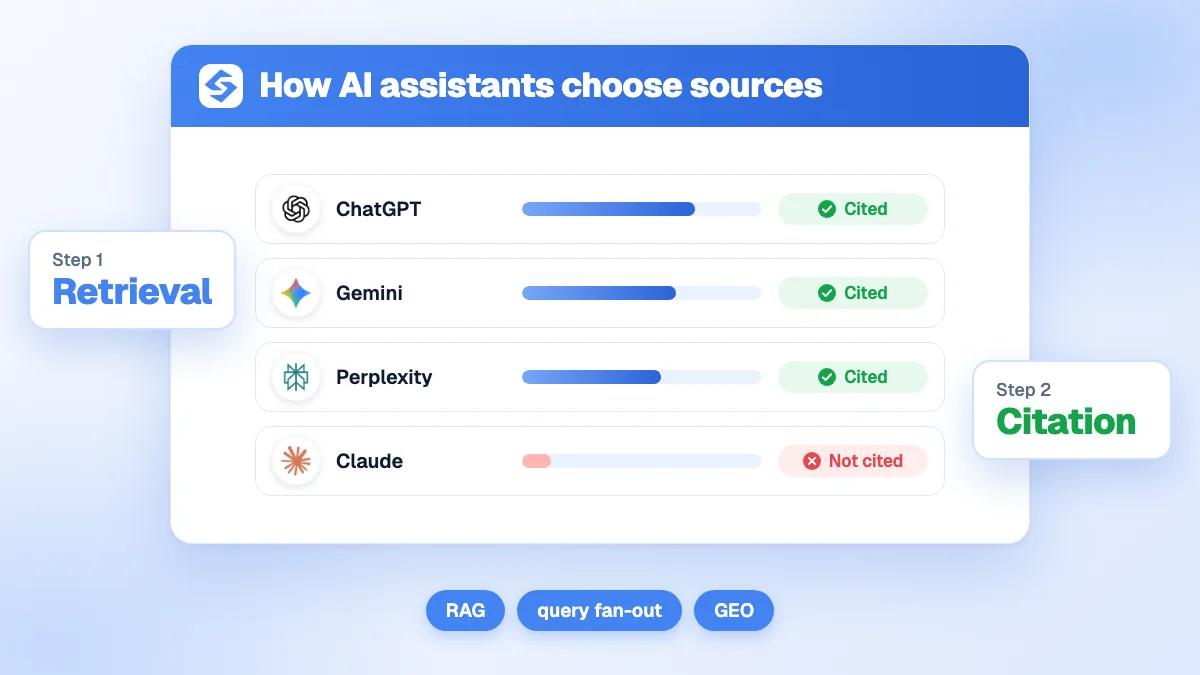
AI-svar ligger ovanpå sökmotorerna i stället för att ersätta dem. De flesta bygger på retrieval-augmented generation (RAG): systemet kör en eller flera sökningar, hämtar de mest relevanta styckena från ett webbindex, och en språkmodell skriver sedan ett svar som citerar några av källorna.
Google AI-översikter och AI-läge använder Googles eget index. Googles sida om AI-funktioner och din webbplats anger att en sida bara behöver vara indexerad och berättigad att visa ett utdrag, utan någon särskild märkning eller AI-textfil. Dessa funktioner använder “query fan-out”: de gör flera närbesläktade sökningar i delämnen för att samla stödjande sidor.
ChatGPT-sök hämtar sidor med OpenAI:s sökrobot OAI-SearchBot. Enligt OpenAI:s dokumentation om sina robotar utesluts sajter som blockerar OAI-SearchBot från ChatGPT-sökens svar, medan GPTBot är en separat robot som används för modellträning.
Gemini, Perplexity och Claude kombinerar också webbsökning med generering: Gemini hämtar från Google Sök, medan Perplexity och Claude skickar egna robotar (PerplexityBot, Claude-SearchBot) för att indexera de sidor de kan citera.
Konsekvensen: de klassiska stegen avgör fortfarande AI-synligheten. En sida som blockeras för crawling, saknas i indexet eller ligger långt ner i rankingen har liten chans att hämtas och därmed att citeras. Det som förändras är det slutliga valet: AI:n väljer stycken, inte hela sidor, och föredrar tydliga definitioner, källbelagda siffror och direkta svar. Vår studie av de källor ChatGPT citerar visar vilka typer av sidor som vinner de citeringarna.
Vad kan du styra i varje steg?
Lägg stegen i ordning så får du en checklista som fungerar för Google, Bing och AI-assistenter:
Släpp in rätt robotar. Kontrollera robots.txt efter oavsiktliga disallow-regler, och bestäm medvetet vilka AI-robotar du tillåter.
Gör varje viktig sida nåbar inom tre klick via interna länkar, och lista den i sitemapen.
Levererar innehåll i HTML:en, inte bara via JavaScript, med snabba och stabila serversvar.
Ge varje ämne en kanonisk URL och undvik nästan identiska sidor som splittrar signalerna.
Matcha sökavsikten. Utgå från de frågor folk skriver, som sökordsanalysen visar, och besvara dem i sidans första rader.
Förtjäna auktoritet genom länkar och omnämnanden från relevanta sajter.
Skriv stycken som kan citeras: en definition, en siffra med källa, en kort lista med steg.
Mät båda kanalerna: Search Console för Google, och spårning av AI-omnämnanden för att se om ChatGPT, Gemini eller Claude citerar ditt varumärke.
Hur har sökmotorerna förändrats över tid?
De tidiga sökmotorerna på 1990-talet rangordnade sidor mest genom nyckelordsmatchning, vilket var lätt att manipulera. Googles PageRank, som behandlade länkar som röster, gjorde rankingen mycket svårare att lura, och de följande decennierna lade till språkförståelse genom maskininlärningsmodeller som BERT, mobile-first-indexering, skräppostdetektering och kvalitetssystem. Googles historia visar ett stadigt mönster: varje större förändring belönade sidor skrivna för människor och straffade genvägar. Generativa svar är det senaste steget, och de belönar samma sak: tydligt, pålitligt och välstrukturerat innehåll.
Från crawling till trafik: var du ska börja
Sökmotorer belönar sidor som de kan crawla, förstå och lita på, och AI-assistenter citerar de sidor som sökmotorerna redan rankar. Åtgärda åtkomsten först, sedan indexeringen, och sedan relevans och auktoritet. För att hålla detta igång vecka efter vecka hittar Sorank dina sökord, publicerar optimerade artiklar med källor och interna länkar, och följer om ChatGPT, Gemini och Claude citerar ditt varumärke, på autopilot.
Vanliga frågor
Hur lång tid tar det för Google att indexera en ny sida?
Det finns ingen fast fördröjning: några timmar på en sajt som Google crawlar ofta, flera dagar eller veckor på en ny eller sällan uppdaterad sajt. Länkar till sidan från redan indexerade sidor och en begäran om indexering med URL-kontrollverktyget i Google Search Console påskyndar upptäckten. Indexering är ändå inte garanterad, även efter en begäran.
Söker sökmotorer hela internet i realtid?
Nej. De söker i sitt eget index, en lagrad kopia av de sidor deras robotar redan har hämtat och analyserat. En sida som blockeras, ligger bakom en inloggning eller ännu inte har crawlats finns inte för motorn förrän den har upptäckts och indexerats.
Använder ChatGPT Googles resultat för att svara på frågor?
ChatGPT kopierar inte Googles resultat. När den söker på webben hämtar den sidor via OpenAI:s egen sökinfrastruktur, inklusive sökroboten OAI-SearchBot, och citerar de källor den använt. En sajt som blockerar OAI-SearchBot i robots.txt utesluts från de svaren, så det spelar roll att vara crawlbar för både Google och OpenAI.
y!
Gratis SEO- och GEO-granskning
Få din innehållsplan för 30 dagar gratis
Vi analyserar dina konkurrenter, din webbplats och din synlighet i AI för att skapa en skräddarsydd innehållsplan, gratis.
“Jag testade Sorank på en riktig kundsajt och det är helt otroligt. Det gör allt som en byrå skulle ta 1500 dollar i månaden för. Den används nu i produktion för den kunden.”Guillaume Guersanguersanguillaume.com
“Vi är en annonsbyrå och ville få igång vår SEO på rätt spår en gång för alla. Sorank gav oss en tydlig bild av vår webbplats, hjälpte oss att prioritera optimeringarna och att strukturera vårt innehåll på rätt sätt. Verktyget är lätt att använda, väl genomtänkt för ett team och mycket praktiskt för att samla uppföljningen på ett ställe utan att jonglera med flera plattformar. En mycket stabil grund för att börja om från början med vår SEO.”Gaspard MadouiAnnonsbyrå
“Jag specialiserade mig på GEO tack vare Sorank. GEO-rankningen gör det möjligt för mig att visa mina kunder deras position jämfört med konkurrenterna i ChatGPT. Det är en verklig konkurrensfördel.”MélanieFrilans SEO-konsult
“Bra service, den fungerar bra för vår webbplats och hjälper oss att förstå hur vi kan förbättra den för att rankas bättre på Google och på andra ställen. Grattis, fortsätt så, jag rekommenderar det.”Hugo T.Handlare inom e-handel