Innstillinger
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Slik fungerer søkemotorer i 5 trinn: crawling, rendering, indeksering, rangering og visning, hva Bing gjør annerledes, og hvordan AI-svar gjenbruker indeksen.

Verktøy

Kort sagt
søkemotorer fungerer i tre hovedtrinn. Crawlere oppdager og laster ned sider ved å følge lenker og sitemaps (crawling), motoren analyserer hver side og lagrer den i en enorm database som kalles indeksen (indeksering), og når noen skriver et søk, velger rangeringssystemene de mest relevante og best kvalitetssikrede sidene fra indeksen og ordner dem (rangering og visning). AI-svar som Google AI-oversikter og ChatGPT-søk legger til ett lag til: de henter sider fra en nettindeks og skriver deretter et sammendrag som siterer noen av dem.
Vil du vite mer? Spør
Rask quiz
Passer SEO for deg, og hvordan bør du starte?
Sorank passer til svarene dine


Prøv det i 3 dager på ditt eget nettsted, og se hvor du står på Google, ChatGPT og de andre AI-assistentene.
Start en gratis prøveperiode på 3 dager3 dager gratis, deretter kan du stoppe når du vil. Resultatgaranti i 90 dager, ellers pengene tilbake.
Å forstå hvordan søkemotorer fungerer er grunnlaget for alle SEO-beslutninger: en side som ikke crawles, kan ikke indekseres, og en side som ikke er indeksert, kan verken rangere eller siteres av en AI-assistent. Google forklarer prosessen i sin grundige guide til hvordan Google Søk fungerer. Denne artikkelen følger de samme trinnene, legger til hva Bing gjør annerledes, og viser hva som endrer seg når ChatGPT, Gemini eller Perplexity svarer i stedet for en liste med blå lenker.
En søkemotor er programvare som finner nettsider som matcher en forespørsel. Den har to deler: en indeks, en database med sider som allerede er oppdaget og analysert, og rangeringssystemer, som avgjør hvilke indekserte sider som best besvarer forespørselen, og i hvilken rekkefølge. En søkemotor søker aldri på nettet slik det er akkurat nå når du skriver et søk: den søker i sin egen lagrede kopi. Derfor kan en side publisert i dag være usynlig i flere dager.
Skala forklarer de fleste designvalg. Ifølge Google dekker søkeindeksen hundrevis av milliarder nettsider og er langt over 100,000,000 gigabyte stor (Google, How Search Works). Ingen motor kan crawle alt på nytt hver dag, så hver enkelt prioriterer hva den henter, hva den beholder og hva den viser. Google dominerer i de fleste land, men Bing, Yandex, Baidu, Naver og personvernfokuserte motorer følger samme logikk, slik vår liste over alternative søkemotorer til Google viser.
De tre klassiske stadiene er lettere å handle etter når du deler dem i fem trinn, hver med sine egne spaker.
| Trinn | Hva søkemotoren gjør | Hva du kan styre |
|---|---|---|
| 1. Crawling | Roboter oppdager URL-er og laster ned sider | robots.txt, interne lenker, XML-sitemap, serverhastighet |
| 2. Rendering | Kjører JavaScript som en nettleser for å se den endelige siden | Innhold som finnes i HTML-en, ingen viktig tekst skjult bak skript eller innlogging |
| 3. Indeksering | Analyserer innholdet, velger en kanonisk URL og lagrer signaler | Unikt innhold, canonical-tagger, noindex, titler og overskrifter |
| 4. Rangering | Ordner de indekserte sidene for hver forespørsel | Relevans for intensjonen, kvalitet, lenker, sideopplevelse |
| 5. Visning | Bygger resultatsiden: lenker, utdrag, AI-oversikt | Tittel-tagg, metabeskrivelse, strukturerte data, kontroll over utdrag |
Crawling er oppdagelsesstadiet. Automatiske programmer som kalles crawlere (Googlebot for Google, Bingbot for Bing) starter fra URL-er de allerede kjenner, og følger lenker for å finne nye. De leser også XML-sitemapene som nettstedseiere sender inn. Google sier at Googlebot bruker en algoritme for å avgjøre hvilke nettsteder som skal crawles, hvor ofte og hvor mange sider som hentes fra hvert, og at den prøver å ikke crawle et nettsted så raskt at serveren overbelastes.
Tre ting blokkerer crawling: en disallow-regel i robots.txt-filen, sider bak innlogging, og serverfeil eller tidsavbrudd. Spakene er en ryddig struktur for interne lenker uten foreldreløse sider, et oppdatert XML-sitemap og en rask, stabil server. Store nettsteder styrer også crawlbudsjettet: antall URL-er en crawler er villig til å hente på nettstedet i en gitt periode.
Mange sider bygger innholdet sitt med JavaScript. Google rendrer sider med en nylig versjon av Chrome, så den kan kjøre skript og se det en besøkende ser. Rendering koster ressurser og kan forsinkes, og innhold som bare vises etter et klikk, eller som er avhengig av et skript som feiler, kan aldri bli sett. Mange andre crawlere, deriblant flere AI-crawlere, kjører ikke JavaScript i det hele tatt: sentralt innhold hører hjemme i den første HTML-en.
Indeksering er analysestadiet. Motoren leser teksten, tittelen, overskriftene, bildene, videoene og de strukturerte dataene, grupperer sider med lignende innhold og velger én representativ URL, den kanoniske, som er versjonen som kan vises i resultatene. Den lagrer signaler om siden: språk, målland, aktualitet og brukervennlighet. Google sammenligner indeksen sin med registeret bakerst i en bok, med en oppføring for hvert ord sett på hver indekserte side.
Indeksering er aldri garantert. Google sier at ikke alle sider den behandler blir indeksert: tynt eller duplisert innhold, et noindex-direktiv eller en utforming som gjør analysen vanskelig, kan holde en side ute. Vår guide til å få sider indeksert i Google dekker løsningene, og en gratis sjekker for indekserbarhet forteller deg på få sekunder om en URL kan indekseres.
Når en forespørsel kommer inn, tolker motoren den først: stavemåte, synonymer, språk, sted og intensjonen bak ordene (lære, sammenligne, kjøpe, nå et bestemt nettsted). Deretter henter den kandidatsider fra indeksen og ordner dem med mange rangeringssystemer som jobber sammen. Google grupperer de viktigste faktorene i betydningen av forespørselen, relevansen til innholdet, kvaliteten, brukervennligheten på siden og konteksten for søket, for eksempel sted og innstillinger. Lenker fra andre nettsteder er fortsatt et signal om autoritet. Hele bildet finner du i vår analyse av Googles rangeringsfaktorer.
To punkter blir ofte misforstått. For det første sier Google at det ikke tar betalt for å crawle et nettsted oftere eller for å rangere det høyere: annonser selges separat og merkes som annonser. For det andre endrer sted og språk resultatene langt mer enn personlig nettleserhistorikk gjør.
Det siste trinnet setter sammen resultatsiden. De ti blå lenkene har blitt en blanding av annonser, lokale resultater, bilder, videoer, bokser med «Folk spør også», utvalgte utdrag og, for mange informasjonsspørsmål, en AI-oversikt. Tittelen og beskrivelsen som vises, kommer fra tittel-taggen, metabeskrivelsen og innholdet på siden, og strukturerte data kan gjøre en side kvalifisert til rike resultater. Hvert format er en egen sjanse til å bli sett.
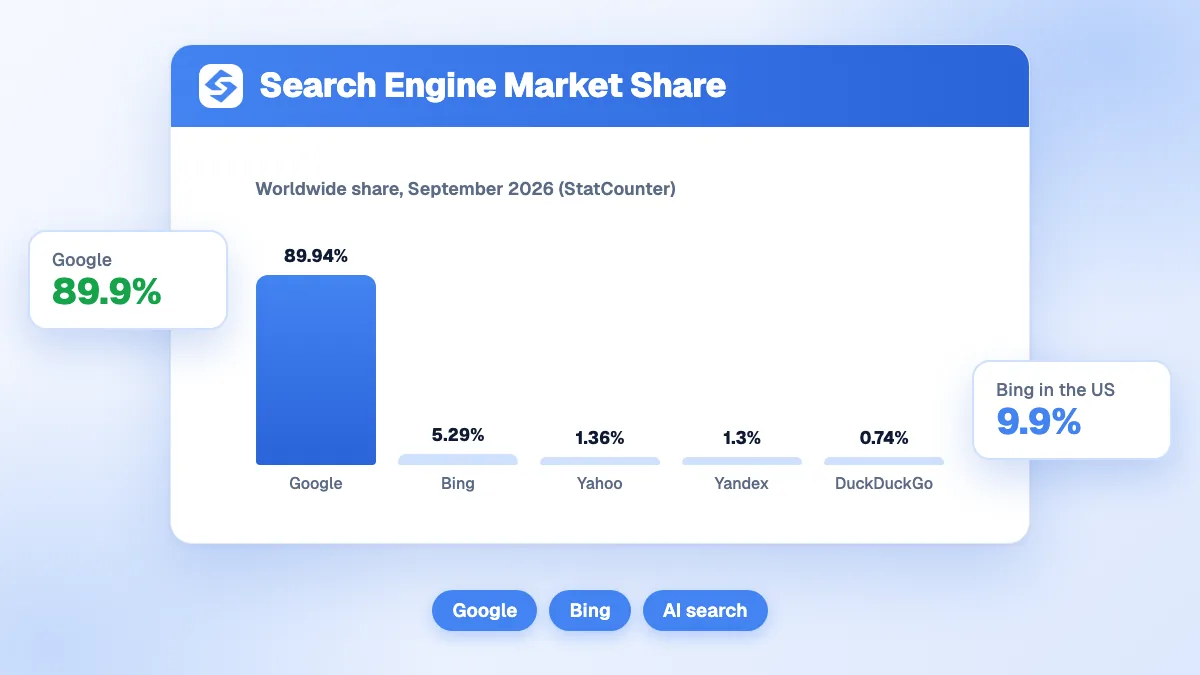
Bing følger samme modell for crawling, indeksering og rangering, med noen praktiske forskjeller. Den viktigste er IndexNow, en protokoll som lar et nettsted varsle søkemotorer så snart en URL legges til, oppdateres eller slettes, i stedet for å vente på neste crawl. Ifølge IndexNow.org støttes protokollen av Microsoft Bing, Naver, Seznam.cz, Yandex og Yep; Google har ikke tatt den i bruk. Bing-resultater mater også Microsoft Copilot. Bings markedsandel er liten i de fleste land, men det tar bare noen minutter å sette opp Bing Webmaster Tools, og det åpner en andre kilde til trafikk og data.
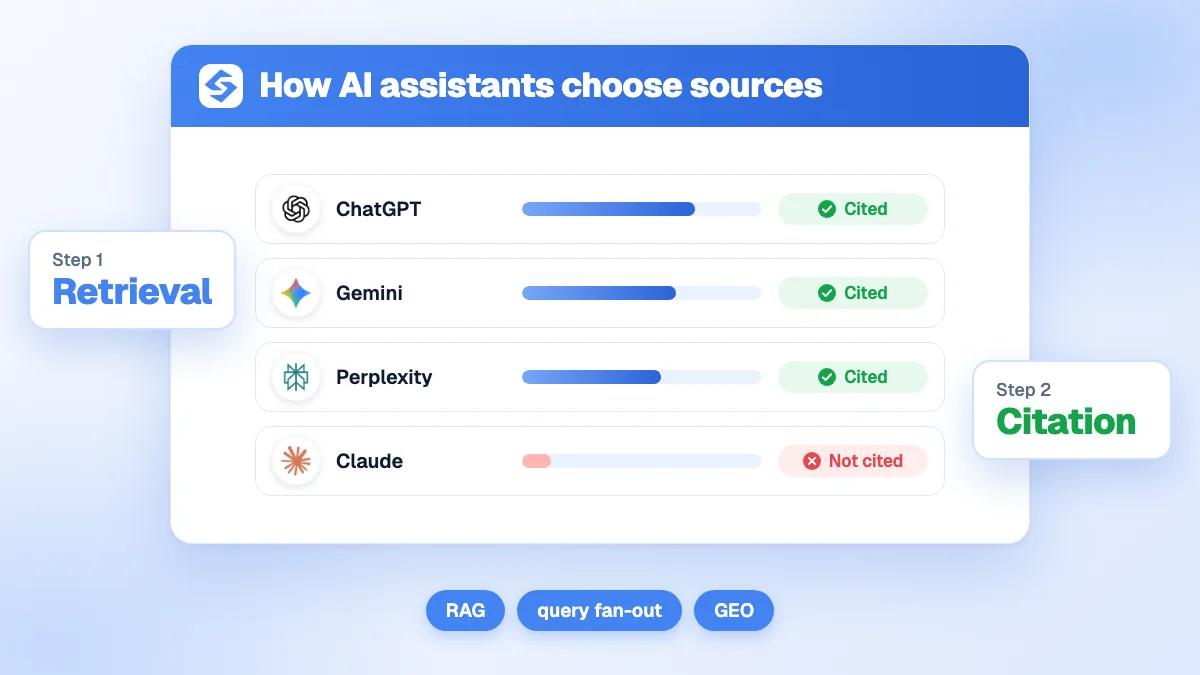
AI-svar ligger oppå søkemotorer i stedet for å erstatte dem. De fleste bygger på retrieval-augmented generation (RAG): systemet kjører ett eller flere søk, henter de mest relevante avsnittene fra en nettindeks, og så skriver en språkmodell et svar som siterer noen av kildene.
Konsekvensen: de klassiske trinnene avgjør fortsatt AI-synligheten. En side som er blokkert for crawling, mangler i indeksen eller er begravd dypt i rangeringene, har liten sjanse til å bli hentet, og dermed sitert. Det som endrer seg er det siste valget: AI-en velger avsnitt, ikke hele sider, og foretrekker tydelige definisjoner, kildebelagte tall og direkte svar. Vår undersøkelse av kildene ChatGPT siterer viser hvilke typer sider som vinner disse sitatene.
Sett trinnene i rekkefølge, og du får en sjekkliste som fungerer for Google, Bing og AI-assistenter:
Tidlige søkemotorer på 1990-tallet rangerte sider i hovedsak etter nøkkelordmatching, noe som var lett å manipulere. Googles PageRank, som behandlet lenker som stemmer, gjorde rangering mye vanskeligere å lure, og de påfølgende tiårene la til språkforståelse gjennom maskinlæringsmodeller som BERT, mobile-first-indeksering, spamdeteksjon og kvalitetssystemer. Historien til Google viser et jevnt mønster: hver større endring belønnet sider skrevet for mennesker og straffet snarveier. Generative svar er det nyeste steget, og de belønner det samme: klart, pålitelig og godt strukturert innhold.
Søkemotorer belønner sider de kan crawle, forstå og stole på, og AI-assistenter siterer sidene søkemotorene allerede rangerer. Fiks tilgangen først, deretter indekseringen, og så relevans og autoritet. For at dette skal fungere uke etter uke, finner Sorank søkeordene dine, publiserer optimaliserte artikler med kilder og interne lenker, og følger om ChatGPT, Gemini og Claude siterer merkevaren din, på autopilot.

Det finnes ingen fast forsinkelse: noen timer på et nettsted Google crawler ofte, flere dager eller uker på et nytt eller sjelden oppdatert nettsted. Lenker fra sider som allerede er indeksert, og en forespørsel om indeksering med URL-inspeksjonsverktøyet i Google Search Console, gjør oppdagelsen raskere. Indeksering er fortsatt ikke garantert, selv etter en forespørsel.
Nei. De søker i sin egen indeks, en lagret kopi av sidene crawlerne deres allerede har lastet ned og analysert. En side som er blokkert, bak innlogging eller ikke crawlet ennå, finnes ikke for motoren før den er oppdaget og indeksert.
ChatGPT kopierer ikke Googles resultater. Når det søker på nettet, henter det sider gjennom OpenAIs egen søkeinfrastruktur, deriblant crawleren OAI-SearchBot, og siterer kildene det brukte. Et nettsted som blokkerer OAI-SearchBot i robots.txt, utelates fra disse svarene, så det er viktig å kunne crawles av både Google og OpenAI.
Vi analyserer konkurrentene dine, nettstedet ditt og synligheten din i AI for å lage en skreddersydd innholdsplan, gratis.
 KI-generator for innholdsbrief
 Generator for FAQ-schema
 Generator for blogg-ideer med AI
 Validator for strukturerte data (schema-validator)
 Sjekk av alt-tekst
 Analyse av interne lenker
 Lenkeutfordringen
 KI-generator for metabeskrivelser
 KI-generator for bloggtitler
 Indekserbarhetssjekker for Google
 KI-generator for bloggdisposisjon
 Generator for UTM-lenker
 Verktøy for gruppering av søkeord
 Sjekk av kanonisk tagg
 XML-sitemap-generator
 Sjekk av ødelagte lenker
 KI-generator for SEO-tittel
 Overskriftsanalyse
 SERP-forhåndsvisning
 Kontroll av omdirigeringer
 Generator for hreflang-tagger
 Analyse av overskriftsstruktur
 Kontroll av HTTP-headere
 Favikon-henter
 SERP CTR-kalkulator
 Sparekalkulator: SEO mot betalt søk
 Kalkulator for SEO-synlighetsandel
 ROI-kalkulator for SEO
 SEO-prognosekalkulator for trafikk og inntekter
 SEO-budsjettkalkulator
 SEO-nullpunktkalkulator
 ROI-kalkulator for SaaS-SEO
 ROAS-kalkulator
 Lesetidskalkulator
 Simulator for rangeringsgevinst
 Kalkulator for verdien av organisk trafikk
 Estimator for organisk trafikk og sjekk av nettstedstrafikk
 Kalkulator for LTV til CAC-forhold
 Kalkulator for avkastning på lokal SEO
 Kalkulator for kostnad ved lenkebygging
 Kalkulator for søkeordverdi
 Kalkulator for poengsum for søkeordmuligheter
 Kalkulator for tetthet av søkeord
 Kalkulator for GEO-avkastning
 Kalkulator for investering i GEO-innhold
 Kalkulator for SEO-avkastning i netthandel
 Kalkulator for kundens levetidsverdi
 Kalkulator for kundeanskaffelseskostnad
 CTR-kalkulator
 Kalkulator for kostnad per artikkel
 Kalkulator for konverteringsrate
 Kalkulator for ROI i innholdsmarkedsføring
 Estimator for ChatGPT-trafikk
 Kalkulator for avvisningsrate
 Kalkulator for backlink-ROI
 Kalkulator for AI-synlighetspoeng
 Kalkulator for verdien av AI-trafikk
 Kalkulator for AI-synlighetsandel
 Kalkulator for kostnaden av AI-usynlighet
 Kalkulator for AI-siteringsrate
 llms.txt-validator
 AI Overview-sjekker og rangeringssjekker for AI Overviews
 Robots.txt-sjekker
 KI-SEO-revisjon
 Sjekk av lesbarhet for LLM
 Sjekk av klargjøring for SearchGPT
 Revisjon av strukturerte data for LLM
 KI-revisjon av crawlbarhet
 Hvorfor ChatGPT ikke anbefaler nettstedet mitt
 Gemini-rangeringsverktøy
 Sjekk av rangering i Perplexity
 Sjekk av LLM-sitater
 AEO-revisjon
 GEO-revisjon
 Test av synlighet i AI-søk
 Sjekk av synlighet i ChatGPT
 llms.txt-generator
 URL-uttrekker
 Nettside til Markdown
 Sjekk av sitemap
 Sensor for SERP-volatilitet
 Sidestørrelsessjekk
 Ordteller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Generator for metatagger
 Bildekomprimerer
 Favicon-generator
 Revisjon av on-page SEO: SEO-sjekk og SEO-analyse
 Verktøy for analyse av tilbakelenker
 Verktøy for søkeordforslag
 Sjekk av domeneautoritet
DE PRØVDE SORANK FØR DEG
 “Jeg testet Sorank på et ekte kundenettsted, og det er helt utrolig. Det gjør alt et byrå ville tatt deg $1500 i måneden for. Nå går det i produksjon på den kunden.”

 Guillaume Guersanguersanguillaume.com“Vi er et annonsebyrå, og vi ville få SEO-en vår på rett spor en gang for alle. Sorank ga oss en tydelig oversikt over nettstedet vårt, hjalp oss å prioritere optimaliseringene og å strukturere innholdet vårt på riktig måte. Verktøyet er enkelt å bruke, godt utformet for et team, og veldig praktisk for å samle oppfølgingen på ett sted uten å jonglere med flere plattformer. Et veldig solid grunnlag for å starte på nytt med SEO.”
 Gaspard MadouiAnnonsebyrå
 “Jeg lot bare Sorank-programvaren gjøre jobben sin, og nå er DR-en min 25, og siden min rangerer høyere.”
 Lucas Flandrefoundertrace.fr“Jeg spesialiserte meg på GEO takket være Sorank. GEO-rangeringen lar meg vise kundene mine hvor de står mot konkurrentene på ChatGPT. Det er en reell kommersiell fordel.”
 MélanieSEO-frilanser“Kjempebra service, den fungerer godt for nettstedet vårt og hjelper oss å forstå hvordan vi kan forbedre det for å rangere bedre på Google og andre steder. Gratulerer, fortsett slik, jeg anbefaler det.”
 Hugo T.Netthandler