Datenschutz ist uns wichtig. Deshalb können Sie bestimmte Speicherarten deaktivieren, die für die grundlegende Funktion der Website nicht erforderlich sind. Das Blockieren einzelner Kategorien kann Ihr Erlebnis auf der Website beeinträchtigen. Weitere Informationen (Cookie-Richtlinie)
Vielen Dank! Ihre Auswahl wurde gespeichert.
Hoppla! Beim Absenden des Formulars ist ein Fehler aufgetreten.
AthenaHQ im Test: Preise, Credits und wie Sie es vor dem Kauf prüfen
AthenaHQ im Test mit den echten Tarifen, der Credit-Rechnung und einem Testlauf in fünf Schritten, um das Tool vor dem Kauf zu prüfen. Geprüft auf der offiziellen Preisseite.
Notizbuch mit handgezeichneten Diagrammen und einem Stift auf einem Schreibtisch, so sehen die Notizen aus, mit denen man einen KI-Sichtbarkeitstool-Test vorbereitet.
Werkzeuge
Auf dieser Seite
Kurz gesagt
AthenaHQ ist eine kostenpflichtige Plattform zur KI-Sichtbarkeit. Sie prüft, ob ChatGPT, Gemini, Perplexity und andere Assistenten Ihre Marke erwähnen, und schlägt dann vor, was Sie als Nächstes veröffentlichen sollten. Es gibt einen kostenlosen Tarif Essential mit 300 Credits. Der Self-Service-Tarif Starter kostet laut Preisseite von AthenaHQ 295 $ pro Monat, geprüft am 21. November 2026.
3 Tage kostenlos, danach beenden Sie jederzeit. 90-Tage-Ergebnisgarantie, es gelten Bedingungen.
Was AthenaHQ ist und wie die Tarife aufgeteilt sind
AthenaHQ gehört zu den Werkzeugen für Generative Engine Optimization, kurz GEO. GEO bedeutet, zu messen und zu verbessern, wie eine Marke in KI-Antworten auftaucht, und nicht nur in einer Liste blauer Links. Wenn Ihnen der Begriff neu ist, erklärt der Glossar-Eintrag zu GEO die Grundlagen, und der Rest dieses Artikels setzt sie voraus.
Die meisten Testberichte sind sich einig, was das Produkt ist. Bei den Details gehen die Meinungen auseinander: wie viele KI-Engines abgedeckt sind, wie viele Plätze man bekommt und was es kostet. Manche Listungen nennen einen monatlichen Einstiegspreis von 95 $, und wir konnten diesen Wert auf der Preisseite nicht finden. Dieser Artikel stützt sich deshalb auf die offizielle Seite und sagt jedes Mal dazu, wenn sie schweigt.
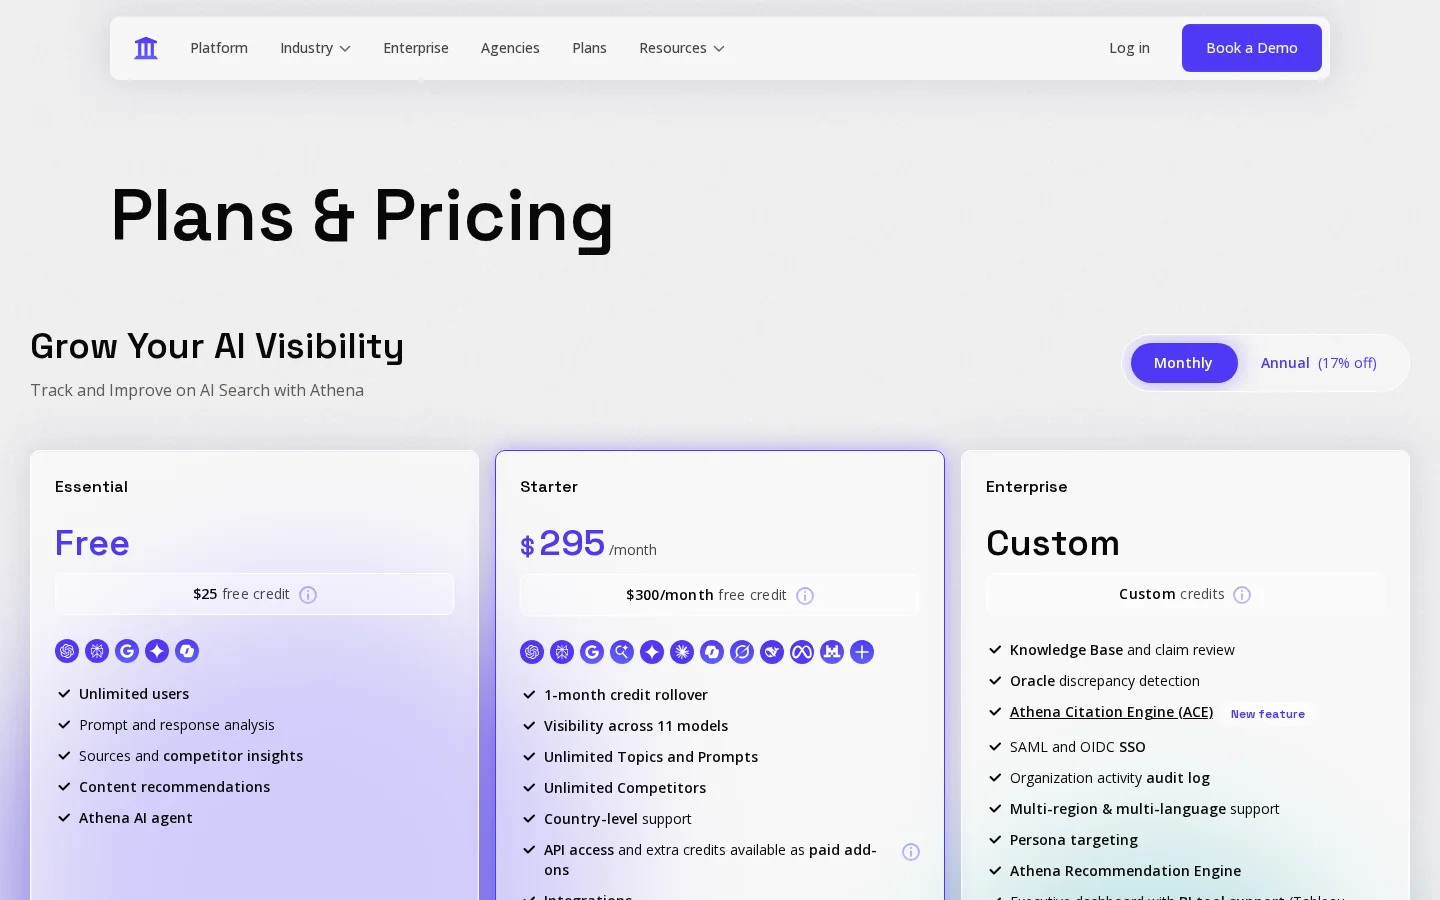
Die Preisseite listet drei Tarife. Essential ist kostenlos. Starter ist der kostenpflichtige Self-Service-Tarif für 295 $ pro Monat. Enterprise gibt es auf Anfrage und über einen Vertrag. Abschnitt 4 geht jede Zeile durch.
Quelle: Preisseite von AthenaHQ (athenahq.ai/pricing), gelesen am 21. November 2026
Für wen der Enterprise-Tarif gedacht ist
Enterprise bringt die Funktionen mit, die wichtig werden, sobald mehrere Personen, mehrere Marken oder ein Compliance-Team beteiligt sind. Die Seite nennt Persona-Targeting, die Athena Citation Engine (ACE), Single Sign-on per SAML mit Anbietern wie Okta, Audit-Logs, einen eigenen Slack-Kanal und ein SLA von 2 Stunden. Mehrere dieser Punkte betreffen Verwaltung und Support statt der Qualität der Messung. Sie sind nur wichtig, wenn Ihre Organisation sie braucht.
Wenn Sie eine Website betreuen und als Einzige die Berichte lesen, starten Sie mit dem kostenlosen Tarif. Später können Sie upgraden, ohne die Prompts zu verlieren, die Sie angelegt haben, solange Sie eine Kopie davon behalten.
So misst ein Sichtbarkeitstracker Ihre Marke
Ein Sichtbarkeitstracker schickt dieselben Prompts nach Zeitplan an mehrere KI-Assistenten, liest jede Antwort und zählt die Antworten, die Ihre Marke nennen. Das Ergebnis ist eine Sichtbarkeitsrate, also der Anteil der Antworten, in denen Sie vorkommen. Ein Prompt ist die Frage, die ein Käufer eintippt, zum Beispiel „beste Laufschuhe für Plattfüße“, und nicht Ihr Markenname. Nur den Markennamen zu verfolgen sagt sehr wenig, weil ihn kaum ein Käufer eintippt.
Ein Tracking-Durchlauf Schritt für Schritt
Prompts auswählenSchreiben Sie die Fragen auf, die Käufer stellen, bevor sie Ihren Namen kennen, in Ihrem Markt und in Ihrer Sprache.
Jeden Prompt an jede Engine schickenZehn Prompts auf fünf Engines ergeben 50 Antworten.
Jede Antwort lesenSuchen Sie nach Ihrem Markennamen, Ihrer Domain und Ihren Produktnamen und notieren Sie die genannten Quellen.
Den Durchlauf auswertenTeilen Sie die Antworten, die Sie erwähnen, durch alle gesammelten Antworten.
Die Formel für die Sichtbarkeitsrate
Der Wert ist einfache Rechnung, und genau deshalb lohnt es sich, ihn selbst nachzurechnen. Schreiben Sie die Formel auf, bevor Sie zwei Tools vergleichen.
Sichtbarkeitsrate = Antworten, die Sie nennen / alle gesammelten Antworten
Nehmen Sie einen Durchlauf mit 10 Prompts auf 5 Engines. Das ergibt 50 Antworten. Wenn 18 davon Sie nennen, liegt die Sichtbarkeitsrate bei 18 / 50, also 36 %. Zählt ein anderes Tool nur die Antworten von ChatGPT und Gemini, ergibt derselbe Durchlauf einen anderen Nenner und einen anderen Prozentwert. Prüfen Sie, welche Engines ein Dashboard einbezieht, bevor Sie Zahlen vergleichen.
Erwähnung, Zitat und Quelle sind drei verschiedene Dinge
Eine Erwähnung ist Ihr Markenname im Text der Antwort. Ein Zitat ist ein Link auf eine Ihrer Seiten. Eine Quelle ist eine Seite, die der Assistent beim Schreiben der Antwort gelesen hat und die nicht unbedingt verlinkt ist. Tracker zählen nicht alle drei gleich. Der Glossar-Eintrag zum KI-Sichtbarkeits-Score erklärt, wie ein einzelner Wert aus diesen Signalen entsteht. Lesen Sie ihn, bevor Sie einer einzelnen Zahl vertrauen.
Warum ein einzelner Durchlauf nicht reicht
KI-Antworten ändern sich von Durchlauf zu Durchlauf, und sie können vom Konto, vom Verlauf und vom Standort der fragenden Person abhängen. Ein Durchlauf ist eine Momentaufnahme. Ein Trend braucht dieselben Prompts, die über mehrere Tage oder Wochen wiederholt werden, und genau dafür nutzt man einen Tracker. Ein manueller Test liefert eine Antwort, ein Tracker liefert eine Reihe.
Illustration: eine Marke, die über mehrere KI-Assistenten verfolgt wird, mit einer Linie pro Antwort.
Vier Wege, die KI-Sichtbarkeit zu messen, und wo ein Tracker passt
Manuelle Prüfungen, Prompt-Tracking, Zitat-Audits und Referral-Analysen beantworten jeweils eine andere Frage. Sie funktionieren besser zusammen als gegeneinander. Ein Tracker ist der einzige der vier, der denselben Test nach Zeitplan wiederholt, deshalb zeigt er einen Trend. Die anderen drei sagen Ihnen, warum sich ein Trend bewegt und wohin der Traffic geht.
Manuelle Prüfungen
Prinzip: Sie stellen dem Assistenten die Frage selbst und lesen die vollständige Antwort. Wann einsetzen: am Anfang oder wenn Sie den genauen Wortlaut lesen wollen, mit dem ein Assistent über Ihre Marke spricht. Vorteile: Es ist kostenlos, und Sie lesen die ganze Antwort statt eines Scores. Grenzen: Sie bekommen eine einzelne Antwort ohne Verlauf und können Zufall nicht von einem echten Muster unterscheiden. Beispiel: Sie fragen am Montag nach „bestes CRM für eine Agentur mit 10 Personen“, und Ihre Marke taucht auf. Am Donnerstag taucht sie nicht mehr auf, und Sie wissen nicht, warum. Unser Leitfaden zum KI-Sichtbarkeits-Audit führt diese Prüfung Schritt für Schritt durch.
Prompt-Tracking
Prinzip: Bei jedem Durchlauf gehen dieselben Prompts an mehrere Engines, und jede Antwort wird gespeichert. Wann einsetzen: wenn Sie eine Zahl brauchen, die Sie über die Zeit berichten können. Vorteile: Es ist wiederholbar, zwischen Engines vergleichbar und behält den Verlauf. Grenzen: Gemessen werden Erwähnungen, nicht Umsatz, und die Kosten steigen mit der Zahl der Prompts mal der Zahl der Engines. AthenaHQ gehört in diese Kategorie, ebenso das KI-Erwähnungs-Tracking von Sorank.
Zitat- und Quellen-Audits
Prinzip: Sie listen die Seiten auf, auf die sich KI-Assistenten stützen, wenn sie Sie oder einen Mitbewerber nennen. Wann einsetzen: wenn Sie wissen wollen, was Sie an Ihrer Website ändern sollten oder wo Sie einen Link gewinnen können. Vorteile: Sie zeigen konkrete Seiten, die Sie verbessern können. Grenzen: Die Liste ändert sich mit jedem Prompt, und eine Seite kann gelesen werden, ohne zitiert zu werden. Beispiel: Wird die Vergleichsseite eines Mitbewerbers in vier Ihrer zehn Prompts zitiert, haben Sie eine konkrete Seite, auf die Sie antworten können, und Sie prüfen, ob Ihre eigene Seite dieselben Fragen abdeckt.
Referral-Analyse und Search Console
Prinzip: Sie lesen den Traffic, den KI-Produkte auf Ihre Website schicken. Wann einsetzen: wenn Sie wissen wollen, ob KI Besuche bringt und nicht nur Erwähnungen. Vorteile: Die Besuche sind echt, und die Daten kosten nichts. Grenzen: Viele Besuche aus KI-Produkten kommen ohne Referrer an und erscheinen deshalb als Direktzugriffe, die Zahl ist also zu niedrig. Abschnitt 8 erklärt, was Search Console zeigt und was nicht.
Methode
Was sie misst
Wiederholbar
Kosten
Wichtigste Grenze
Manuelle Prüfung
Einzelne Antworten, komplett gelesen
Nein
Kostenlos
Eine Momentaufnahme ohne Verlauf
Prompt-Tracking
Erwähnungen pro Engine über die Zeit
Ja
Kostenpflichtig
Zählt Erwähnungen, nicht Besuche
Zitat-Audits
Seiten, auf die sich die KI stützt
Teilweise
Kostenlos bis kostenpflichtig
Die Quellenliste ändert sich mit jedem Prompt
Referral-Analyse
Besuche aus KI-Produkten
Ja
Kostenlos
Unterzählt Besuche ohne Referrer
Sobald Sie mehrere Marken verfolgen, zeigt der Share of Voice in KI-Antworten, wie viel vom Antwortraum Sie gegenüber Ihren Wettbewerbern halten. Das ist die Zahl, die Sie einem Vorgesetzten berichten sollten, denn die Rate einer einzelnen Marke sagt allein wenig.
Tipp
Bevor Sie einen Tracker kaufen, machen Sie mit dem kostenlosen ChatGPT-Sichtbarkeitscheck eine manuelle Ausgangsmessung für Ihre eigene Marke. Heben Sie das Ergebnis auf, damit Sie den ersten Bericht des Trackers damit vergleichen können.
Die Tarife von AthenaHQ, Zeile für Zeile
Der Essential-Tarif kostet nichts und umfasst 300 Credits und fünf Engines. Starter kostet 295 $ pro Monat, mit 3600 Credits und 11 Engines. Enterprise ist individuell, und das Creditkontingent wird im Vertrag ausgehandelt. Die Tabelle stellt die drei Tarife nebeneinander und nutzt nur, was die Preisseite angibt.
Tarif
Preis
Credits
Gelistete KI-Engines
Plätze
Wichtige Extras
Essential
Kostenlos
300
5: ChatGPT, Perplexity, Google AI Overviews, Gemini, Copilot
Unbegrenzte Nutzer
Prompt-Analyse, Quellen- und Wettbewerbs-Einblicke, Content-Empfehlungen, ein Angebot über 25 $ Gratis-Credits
Starter
295 $ pro Monat
3600 pro Monat
11: die fünf oben genannten plus Google AI Mode, Claude, Grok, DeepSeek, Meta AI und Mistral
Unbegrenzte Plätze mit rollenbasierter Zugriffskontrolle
Ein Angebot über 300 $ Gratis-Credits pro Monat, API-Zugang und zusätzliche Credits als kostenpflichtige Add-ons
Enterprise
Individuell
Im Vertrag ausgehandelt
Die Starter-Liste plus „und mehr“
Unbegrenzte Plätze mit rollenbasierter Zugriffskontrolle
Citation Engine (ACE), Persona-Targeting, SSO, Audit-Logs, ein eigener Slack-Kanal, ein SLA von 2 Stunden
Auf jedem Tarif gelistete KI-Engines
Essential5 Engines
Starter11 Engines
Quelle: Preisseite von AthenaHQ, gelesen am 21. November 2026
Die drei Zahlen, die das Budget bestimmen
295 $pro Monat, Listenpreis des Starter-Tarifs
3600Credits pro Monat bei Starter
300Credits beim kostenlosen Essential-Tarif
Quelle: Preisseite von AthenaHQ, gelesen am 21. November 2026
Was die Preisseite nicht klar macht
Die Seite lässt mehrere Punkte offen, und jeder davon verändert die reale Kostenstruktur. Fragen Sie danach, bevor Sie budgetieren.
Jährliche Abrechnung. Der Schalter trägt die Bezeichnung „17 % Rabatt“, aber im Text, den wir gelesen haben, steht kein Jahrespreis. Lassen Sie sich den Jahresbetrag schriftlich geben.
Die Angebote mit Gratis-Credits. Die Seite wirbt mit 25 $ Gratis-Credits bei Essential und 300 $ Gratis-Credits pro Monat bei Starter. Der gelesene Text erklärt weder die Bedingungen noch die Laufzeit oder was bei der Verlängerung passiert.
Add-ons. API-Zugang und zusätzliche Credits werden zusätzlich zu Starter berechnet. Die Seite nennt dafür keinen Preis und verweist auf den Vertrieb.
Angaben Dritter. Bewertungen nennen unterschiedliche Platzzahlen, Engine-Zahlen und Einstiegspreise. Vergleichen Sie jede Angabe mit der Live-Seite an dem Tag, an dem Sie entscheiden.
Achtung
Tarife und Preise ändern sich. Jede Zahl in diesem Artikel ist der Wert auf der Preisseite, wie am 21. November 2026 geprüft. Prüfen Sie die Live-Seite vor jeder Budgetentscheidung.
Wie Credits funktionieren und was ein Monat Tracking kostet
Die Preisseite definiert einen Credit als eine KI-Antwort. Das Budget ist deshalb eine Frage der Multiplikation. Jeder Prompt, der an jede Engine geschickt wird, kostet pro Durchlauf einen Credit, und Sie können die Kosten jedes Tarifs vor dem Kauf berechnen.
Credits pro Durchlauf = Prompts x Engines
Credits pro Monat = Credits pro Durchlauf x Durchläufe pro Monat
Credits für einen vollständigen Durchlauf
50
110
Essential: 10 Prompts x 5 EnginesStarter: 10 Prompts x 11 Engines
Berechnet aus der Preisseite: ein Credit entspricht einer KI-Antwort
Essential als Testbudget nutzen
Zehn Prompts auf fünf Engines verbrauchen 50 Credits pro Durchlauf, also reichen 300 Credits für sechs vollständige Durchläufe. Das genügt, um zu prüfen, ob die Antworten des Tools mit dem übereinstimmen, was Sie von Hand sehen, und zwar über mehrere Tage. Für wöchentliches Tracking über ein Quartal reicht es nicht. Dreizehn wöchentliche Durchläufe zu je 50 Credits brauchen 650 Credits, also mehr als das Doppelte des kostenlosen Kontingents.
Starter für tägliches Tracking nutzen
Zehn Prompts auf 11 Engines verbrauchen 110 Credits pro Durchlauf. Täglich über 30 Tage sind das 3300 Credits, sodass 300 der 3600 für zusätzliche Tests übrig bleiben. Jeder Monat mit mehr Durchläufen braucht Zusatz-Credits, und die Seite nennt dafür keinen Preis. Fragen Sie den Preis vor der Entscheidung ab. Wenn Sie mehr Prompts brauchen, steigen die Kosten auf dieselbe Weise, also rechnen Sie die Formel mit Ihrer realen Promptzahl durch, bevor Sie einen Tarif wählen.
Hinweis
Die Formel setzt einen Credit pro Prompt-Engine-Paar voraus, was „ein Credit = eine KI-Antwort“ impliziert. Wenn eine Engine mehrere Antworten auf einen Prompt liefert oder eine Funktion zusätzliche Credits verbraucht, liegt Ihr tatsächlicher Verbrauch höher. Messen Sie ihn auf dem kostenlosen Tarif, bevor Sie den kostenpflichtigen kaufen.
Ein Testlauf in fünf Schritten vor dem Bezahlen
Führen Sie den Test auf dem kostenlosen Tarif durch und behandeln Sie ihn als Prüfung des Tools, nicht als Verkaufsdemo. Ziel ist herauszufinden, ob die Antworten mit dem übereinstimmen, was Sie selbst sehen. Ein Tool, das Erwähnungen meldet, die Sie nicht finden, ist schlechter als gar kein Tool, weil es Ihr Budget in die falsche Richtung lenkt.
Der Testlauf in fünf Schritten
Zehn Käufer-Prompts schreibenNutzen Sie die Fragen, die ein Kunde stellt, bevor er einen Anbieter wählt, in Ihrem Markt und in Ihrer Sprache.
Einmal auf Essential laufen lassenZehn Prompts auf fünf Engines kosten 50 Credits. Speichern Sie die Rohantworten, nicht nur die Zusammenfassung.
Zwanzig Antworten von Hand prüfenÖffnen Sie die Antworten und suchen Sie selbst nach Ihrer Marke. Zählen Sie jede falsche Meldung und jede verpasste Erwähnung.
Die Quellen vergleichenPrüfen Sie, ob das Tool die Seiten zeigt, auf die sich jede Antwort stützt, und ob diese Seiten Ihre eigenen sind.
Nur auf Starter wechseln, wenn die Lücken geschlossen sindWenn das Tool Erwähnungen verpasst oder erfindet, behebt ein höherer Tarif das nicht.
Ein durchgerechnetes Beispiel
Beispiel
Dieses Beispiel ist hypothetisch. Ein Laufschuhgeschäft testet zehn Prompts wie „beste Laufschuhe für Plattfüße unter 150 Dollar“ und „Laufschuhmarken, die für breite Füße gut sind“. Der erste Durchlauf zeigt eine Erwähnung in 3 von 50 Antworten, das wäre eine Sichtbarkeitsrate von 6 %. Als das Geschäft diese drei Antworten von Hand prüft, nennen zwei davon eine andere Marke mit ähnlichem Namen. Die echte Zahl ist 1 von 50, also 2 %. Ohne die manuelle Prüfung hätte das Geschäft eine dreimal zu hohe Rate gemeldet.
Was Sie aus dem Test mitnehmen
Behalten Sie drei Dinge: die Liste der Prompts, die Rohantworten jeder Engine und Ihre handgeprüfte Zählung. Mit diesen drei Elementen können Sie später jedes Tool zu denselben Fragen vergleichen. Sie schützen Sie auch, wenn ein Anbieter nach Ihrer Anmeldung seine Bewertungsmethode ändert, denn Sie können dieselben Prompts erneut laufen lassen und den Unterschied sehen.
Was in der Funktionsliste zu prüfen ist
Drittanbieter-Bewertungen beschreiben ein Action Center, das Tracking in Aufgaben verwandelt, und eine Citation Engine, die schätzt, wie wahrscheinlich eine Seite zitiert wird. Die Preisseite ordnet die Citation Engine dem Enterprise-Tarif zu. Betrachten Sie jede Funktionsbehauptung als ungeprüft, bis sie mit Ihren eigenen Prompts und Ihren eigenen Markennamen gelaufen ist.
Nur Tracking oder Tracking plus Aktion
Nur Tracking
Eine klare, wiederholbare Messgröße
Kein nächster Schritt für Ihr Team
Tracking plus Aktion
Schlägt vor, welche Seite zu korrigieren oder anzulegen ist
Der entworfene Inhalt braucht weiterhin eine menschliche Prüfung
Was Sie in einer Demo fragen sollten
Eine Demo sollte die Fragen beantworten, die Ihr Test aufgeworfen hat. Zeigt der Anbieter nur ein Dashboard, bitten Sie um die Rohantworten hinter einem Diagramm. Die folgende Checkliste ist das, was wir vor einer Unterschrift verlangen würden.
Das verlangen Sie in der Demo
Drei Ihrer eigenen Prompts live laufen lassen und die Rohantworten zeigen
Jede abgedeckte Engine auflisten, mit dem Tarif, der sie enthält
Erklären, wie eine Zitation gezählt wird und woher die Daten stammen
Einen Export des Berichts zeigen, den Sie an Ihren Vorgesetzten schicken würden
Die Credit-Kosten eines Durchlaufs und eines Monats aufschreiben
Wo die Daten aufhören: Search Console und KI-Crawler
Zwei kostenlose Quellen beantworten einen Teil der Frage. Search Console zählt die Klicks aus den KI-Funktionen von Google, und Ihre Server-Logs zeigen, welche KI-Bots Ihre Seiten besuchen. Keine der beiden sagt, ob ChatGPT Ihre Marke in einer Antwort genannt hat, deshalb ersetzt ein Tracker sie nicht. Sie brauchen alle drei, um das ganze Bild zu sehen.
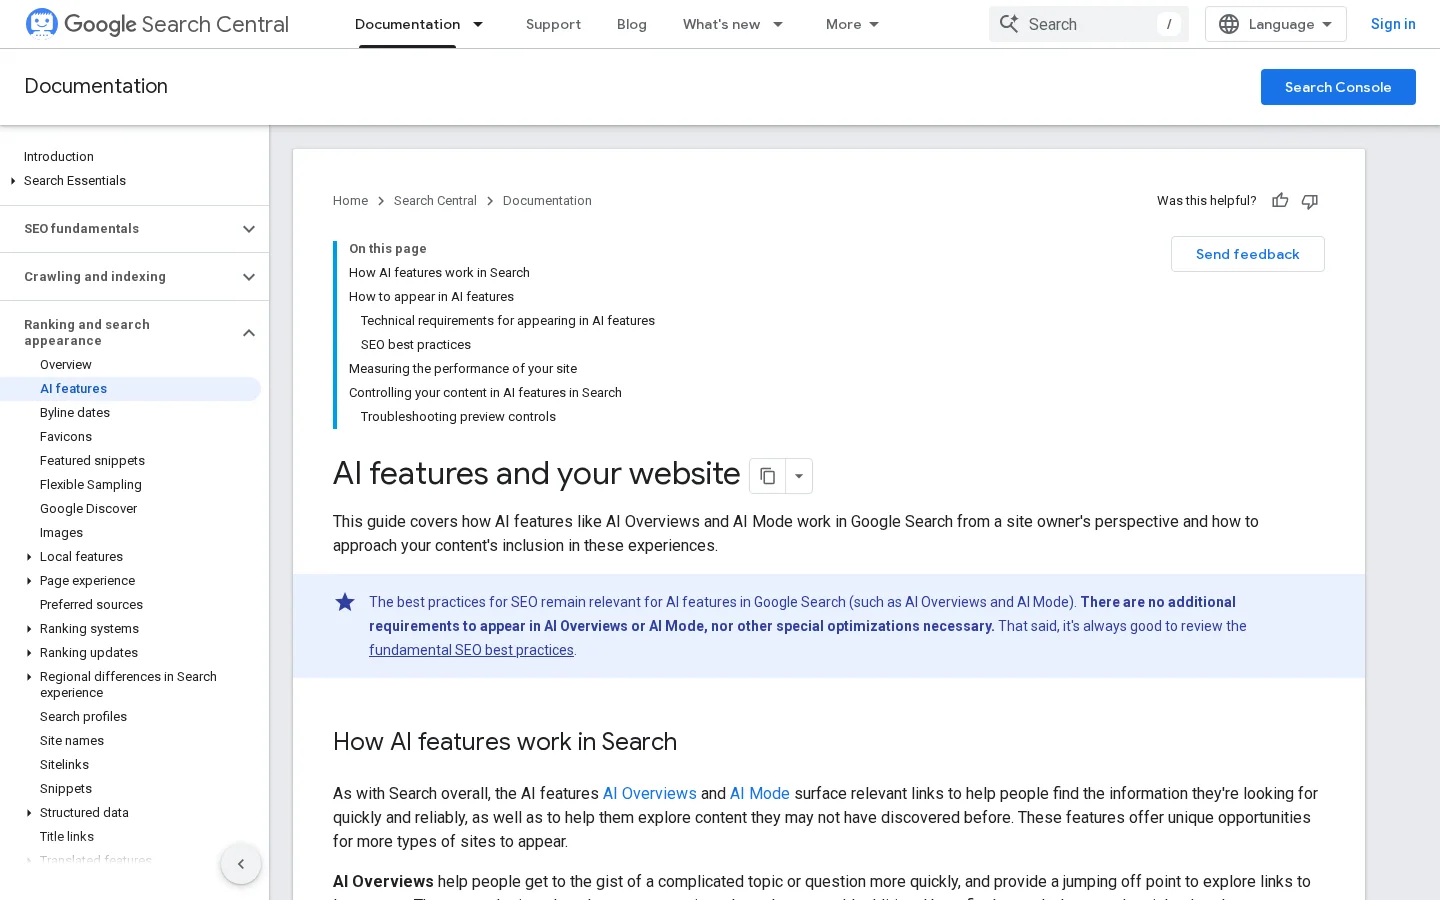
Quelle: Google Search Central, Dokumentation zu KI-Funktionen
Googles Dokumentation zu KI-Funktionen sagt, dass Websites, die in AI Overviews und im KI-Modus erscheinen, im gesamten Suchtraffic der Search Console enthalten sind. Diese Klicks werden im Leistungsbericht unter dem Suchtyp Websuche ausgewiesen. Einen eigenen Bericht brauchen Sie dafür nicht, aber Sie sollten den Suchtyp Websuche prüfen und nicht eine ungefilterte Summe.
Wissen, welcher Bot was tut
OpenAI listet mehrere Crawler mit unterschiedlichen Aufgaben. GPTBot crawlt Inhalte, die für das Training der generativen KI-Basismodelle verwendet werden dürfen. OAI-SearchBot macht Websites in den Suchfunktionen von ChatGPT sichtbar. ChatGPT-User besucht eine Seite, wenn ein Nutzer ChatGPT oder einen benutzerdefinierten GPT eine Frage dazu stellt, und robots.txt-Regeln gelten dafür möglicherweise nicht. Lesen Sie diese drei Beschreibungen als drei getrennte Entscheidungen und nicht als eine.
Der häufigste Fehler ist, den falschen Bot zu blockieren. Der folgende robots.txt-Eintrag meldet Ihre Website vom Training ab, und sonst nichts:
User-agent: GPTBot
Disallow: /
Das Blockieren von OAI-SearchBot entscheidet darüber, ob Ihre Seiten in den Suchfunktionen von ChatGPT erscheinen können. OpenAI weist außerdem darauf hin, dass abgemeldete Websites trotzdem als Navigationslinks auftauchen können. Legen Sie eine Regel pro Bot fest, je nachdem, was Sie für jeden Zweck wollen, und prüfen Sie Ihre Logs, bevor Sie etwas ändern. Der Glossar-Eintrag zu KI-Crawlern listet die User-Agents auf, nach denen Sie suchen sollten.
Häufige Fehler beim Prüfen oder Kaufen eines KI-Sichtbarkeitstools
Diese Fehler tauchen in vielen Testberichten auf, auch in sorgfältigen. Jeder hat ein klares Erkennungszeichen und eine einfache Korrektur, sodass Sie ihn abfangen, bevor er Sie einen Budgetzyklus kostet.
Engine-Zahlen über Tarife hinweg vergleichen
Was es ist: Sie vergleichen die 11 Engines von Starter mit den 5 von Essential, als wären es zwei gleiche Produkte. So erkennen Sie es: der Test nennt den getesteten Tarif nicht. So beheben Sie es: Notieren Sie die Engine-Liste des Tarifs, den Sie kaufen würden, und vergleichen Sie dann die Listen, nicht die Schlagzeilenzahlen.
Einen Gratis-Credit als kostenlosen Tarif lesen
Was es ist: Ein Werbe-Credit wird wie ein dauerhaft kostenloser Tarif behandelt. So erkennen Sie es: Die Preisseite nennt es ein Angebot, und der Text erklärt die Bedingungen nicht. Die 25 $ und 300 $ auf der Seite von AthenaHQ sind Beispiele. So beheben Sie es: Fragen Sie schriftlich, was der Credit abdeckt, wie lange er gilt und was Sie nach dem Aufbrauchen zahlen.
Sich auf einen einzigen Durchlauf verlassen
Was es ist: Sie beurteilen ein Tool anhand eines einzigen Antwortstapels. So erkennen Sie es: Eine Erwähnung erscheint an einem Tag und ist am nächsten verschwunden. So beheben Sie es: Lassen Sie jeden Prompt an zwei verschiedenen Tagen laufen, bevor Sie ein Urteil fällen, und bewahren Sie die Rohantworten auf, um Behauptungen später prüfen zu können.
Den falschen Bot blockieren
Was es ist: Sie blockieren GPTBot, um nicht zitiert zu werden, aber GPTBot betrifft das Training, und die Suche läuft über OAI-SearchBot. So erkennen Sie es: Ihre robots.txt verbietet GPTBot und sagt nichts zu OAI-SearchBot. So beheben Sie es: Legen Sie eine Regel pro Bot fest, je nachdem, ob Sie Training, Suche oder keines von beidem wollen, und nutzen Sie das Beispiel aus dem Abschnitt oben.
Drittanbieter-Zahlen für aktuell halten
Was es ist: Sie übernehmen die Platzzahl oder den Preis aus einer Bewertung als heutigen Preis. So erkennen Sie es: Die Bewertung hat kein Datum, oder ihre Zahlen weichen von der offiziellen Seite ab. So beheben Sie es: Prüfen Sie die offizielle Seite am Kauftag und notieren Sie ihr Datum in Ihren Kaufunterlagen.
Bevor Sie unterschreiben, prüfen Sie, ob Sie
die Engine-Liste für genau den Tarif notiert haben, den Sie kaufen würden
die Bedingungen eines Gratis-Credit-Angebots erfragt haben
Ihre Prompts an zwei verschiedenen Tagen laufen lassen haben
jede KI-Bot-Regel bewusst festgelegt haben
den Preis, den Sie vergleichen, datiert haben
Für wen sich AthenaHQ eignet und für wen nicht
Die richtige Wahl hängt von der Aufgabe ab. Messung, Teamzugang und Content-Produktion sind drei verschiedene Bedürfnisse, und kein einzelner Tarif deckt alle drei gleich gut ab. Die Tabelle unten zeigt schnell, welche Option zu Ihrer Situation passt.
Ihre Situation
Besser geeignet
Warum
Sie wollen vor dem Bezahlen testen
AthenaHQ Essential
Kostenlos, mit 300 Credits und fünf Engines
Sie brauchen 11 Engines und gemeinsamen Teamzugang
AthenaHQ Starter
Die gelisteten Engines, mit unbegrenzten Plätzen
Sie wollen, dass das Tool auf Befunde reagiert
Ein Tracker, der auch erstellt und veröffentlicht
Reines Tracking endet beim Score
Sie wollen einen Monatstrend pro Prompt und pro Engine
Ein Prompt-Tracker mit Monatsverlauf
Wiederholbare Durchläufe mit den Quellen hinter jeder Erwähnung
Wenn Sie Sorank wählen, deckt das monatliche Prompt-Tracking ChatGPT, Claude und Gemini ab, auf höheren Tarifen mit Grok, und führt pro verfolgtem Prompt eine Analyse pro Monat durch. Das GEO Leaderboard zeigt, welche Marken die Assistenten statt Ihrer empfehlen. Es ist die falsche Wahl, wenn Sie tägliche Durchläufe auf elf Engines brauchen. Aktuelle Tarife und Preise finden Sie auf der Preisseite von Sorank.
Starten Sie mit dem kostenlosen Tarif, prüfen Sie zwanzig Antworten von Hand und entscheiden Sie anhand Ihrer eigenen Daten statt eines Werbepreises.
Häufig gestellte Fragen
Was kostet AthenaHQ?
Die Preisseite von AthenaHQ listet einen kostenlosen Essential-Tarif, einen Starter-Tarif für 295 $ pro Monat und einen individuellen Enterprise-Tarif. Der Jahrespreis steht nicht im Text, den wir gelesen haben. Prüfen Sie die Live-Seite, bevor Sie budgetieren, denn Preise ändern sich.
Ist AthenaHQ kostenlos?
Der Essential-Tarif ist kostenlos und umfasst 300 Credits und fünf KI-Engines. Ein Credit entspricht einer KI-Antwort, ein Test mit 10 Prompts auf fünf Engines verbraucht also 50 Credits, genug für sechs vollständige Durchläufe vor dem Kauf.
Wie viele KI-Engines verfolgt AthenaHQ?
Der Starter-Tarif listet 11 Engines, darunter ChatGPT, Perplexity, Google AI Overviews, Google AI Mode, Gemini, Claude, Copilot, Grok, DeepSeek, Meta AI und Mistral. Der Enterprise-Tarif listet eine ähnliche Auswahl und ergänzt die Citation Engine und das Persona-Targeting.
y!
Erhalten Sie kostenlos Ihren Content-Plan für 30 Tage
Wir analysieren Ihre Wettbewerber, Ihre Website und Ihre KI-Sichtbarkeit, um kostenlos einen maßgeschneiderten Content-Plan für Sie zu erstellen.
“Ich habe Sorank auf einer echten Kundenwebsite getestet, und es ist der Wahnsinn. Es macht alles, wofür eine Agentur 1.500 € im Monat berechnet. Jetzt geht es bei diesem Kunden in den Produktivbetrieb.”Guillaume Guersanguersanguillaume.com
“Wir sind eine Ads-Agentur und wollten unser SEO endgültig wieder auf Kurs bringen. Sorank hat uns eine klare Übersicht über unsere Website verschafft, uns geholfen, Optimierungen zu priorisieren und unsere Inhalte richtig zu strukturieren. Das Tool ist einfach zu bedienen, gut für ein Team konzipiert und sehr praktisch, um das Tracking zu zentralisieren, ohne zwischen mehreren Plattformen jonglieren zu müssen. Eine sehr solide Grundlage, um mit unserem SEO neu zu starten.”Gaspard MadouiWerbeagentur
“Ich habe mich dank Sorank auf GEO spezialisiert. Das GEO Leaderboard ermöglicht es mir, meinen Kunden ihre Position im Vergleich zu ihren Wettbewerbern auf ChatGPT zu zeigen. Das ist ein echter kommerzieller Differenzierungsfaktor.”MélanieFreelancer im Bereich SEO
“Hervorragender Service, funktioniert gut für unsere Website und hilft uns zu verstehen, wie wir sie verbessern können, um auf Google und anderswo besser zu ranken. Herzlichen Glückwunsch, machen Sie weiter, ich empfehle es.”Hugo T.E-Commerce-Händler