La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Excluded by 'noindex' tag : est-ce normal, et comment le corriger ?
« Excluded by 'noindex' tag » : Google a trouvé une règle noindex et tenu la page hors de l'index. Quand c'est normal, où se cache la règle et comment la corriger.
Couverture de l’article « Excluded by 'noindex' tag », avec une capture du logiciel Sorank à côté du titre
Outils
Sur cette page
En bref
« Excluded by 'noindex' tag » est une raison listée dans le rapport Indexation des pages de Google Search Console. Elle signifie que Googlebot a exploré la page, trouvé une règle noindex (dans une balise meta robots ou dans un en-tête HTTP X-Robots-Tag) et l'a respectée, si bien que la page ne peut pas apparaître dans les résultats de recherche. Pour les pages de connexion, de panier, de remerciement ou de recherche interne, c'est le résultat attendu et aucune action n'est nécessaire. Pour une page que vous voulez voir classer, cherchez d'où vient la règle (réglage du CMS, extension SEO, thème, serveur ou CDN), supprimez-la à la source, puis demandez à Google de réexplorer la page.
Qui doit corriger la partie technique de votre site ?
Question 1 sur 425%
Notre conseil pour vous
Vérifiez vous-même avec les outils gratuits de Google
Search Console liste les pages que Google n'arrive pas à lire, et PageSpeed Insights teste la vitesse. Beaucoup de petits problèmes se règlent dans les paramètres de votre outil de création de site.
Notre conseil pour vous
Un développeur web
Votre problème est dans le code ou le serveur : un développeur qui connaît le SEO est la bonne personne. Donnez-lui la liste des erreurs de Search Console.
Notre conseil pour vous
Un outil d'audit technique
Votre site a beaucoup de pages : un robot d'exploration les lit toutes comme Google et donne la liste complète des erreurs à corriger, page par page.
Notre conseil pour vous
Un audit automatique, puis du contenu
Votre site fonctionne mais attire peu de visiteurs : la technique est rarement en cause. Sorank audite le site, puis rédige les pages qui amènent du trafic.
« Excluded by 'noindex' tag » est le seul statut d'indexation que vous créez vous-même, volontairement ou par erreur. La documentation du rapport Indexation des pages de Google décrit cette raison en trois phrases : « Lorsque Google a tenté d'indexer la page, il a rencontré une directive « noindex » et ne l'a donc pas indexée. Si vous ne voulez pas que cette page soit indexée, félicitations ! Si vous voulez qu'elle soit indexée, vous devez supprimer la directive « noindex ». » Ce guide vous aide à savoir de quel côté de cette phrase se trouve chaque URL, à trouver la source exacte d'une règle indésirable et à la corriger sans rien casser d'autre.
Que signifie « Excluded by 'noindex' tag » ?
Une règle noindex demande aux moteurs de recherche de ne pas afficher une page dans leurs résultats. Google la lit à deux endroits, comme l'explique son guide sur le blocage de l'indexation avec noindex :
Une balise meta robots dans le <head> du HTML : <meta name="robots" content="noindex"> pour tous les moteurs, ou name="googlebot" pour Google seul.
Un en-tête HTTP X-Robots-Tag envoyé par le serveur avec la réponse, avec la valeur noindex ou none. C'est la seule option pour les fichiers sans HTML, comme les PDF.
Dès que Googlebot trouve l'une de ces deux règles, il garde l'URL hors de l'index. Le statut apparaît dans la Search Console, sous Indexation puis Pages, dans le tableau « Why pages aren't indexed ». La page d'aide donne la même raison sous le libellé « URL marked 'noindex' » : les deux désignent une seule situation.
Trois points changent la façon de lire ce rapport :
Google vous a obéi. Contrairement à « Crawled - currently not indexed », où Google décide lui-même de ne pas indexer une page, ce statut reflète une instruction envoyée par votre site.
Il faut une exploration. Google ne peut voir une règle noindex que sur une page qu'il a le droit de charger. Une page bloquée par le fichier robots.txt n'atteint jamais ce statut.
La règle peut venir de n'importe quel maillon. Le HTML, le CMS, une extension, le thème, la configuration du serveur et le CDN peuvent chacun l'ajouter, et le code source de la page ne montre pas les en-têtes HTTP.
Est-ce normal ou une erreur ?
La plupart des sites ont des URL dans ce statut, et beaucoup d'entre elles doivent y rester. Google précise que les pages listées comme non indexées le sont « pas nécessairement à cause d'une erreur ». Triez la liste par type d'URL avant de corriger quoi que ce soit.
Type d'URL
Verdict
Action
Pages de connexion, de compte et d'administration
Normal
Aucune
Panier, paiement et confirmation de commande
Normal
Aucune
Pages de remerciement après un formulaire
Normal
Aucune
Résultats de la recherche interne
Normal
Aucune ; évitez de les lier en masse
Pages d'étiquettes, archives d'auteurs, pages de filtres pauvres
Souvent un choix délibéré
Gardez-les si elles n'apportent rien ; à revoir si elles visent de vraies recherches
URL de préproduction, de test ou d'aperçu
Normal
Gardez le noindex, idéalement avec un mot de passe
Articles de blog, pages produit, catégorie ou service
Erreur
Trouvez la source et supprimez la règle
La page d'accueil ou une section entière
Erreur urgente
À corriger aujourd'hui : le site perd son trafic organique
URL présentes dans votre sitemap XML
Conflit
Supprimez le noindex, ou retirez l'URL du sitemap
La dernière ligne compte plus qu'il n'y paraît. Un sitemap dit à Google « indexez ces pages », alors qu'un noindex dit le contraire. Limitez le sitemap aux URL indexables et canoniques (notre guide sur l'envoi d'un sitemap à Google explique comment le nettoyer).
Astuce
Exportez la liste complète depuis le rapport (le tableau à l'écran n'en montre qu'un échantillon), puis regroupez les URL par dossier ou par motif dans un tableur. Si un motif attendu, comme /panier/ ou /compte/, explique 95 % des lignes, il ne reste à vérifier que le reste.
D'où vient un noindex indésirable ?
Quand une page importante porte un noindex, la cause est presque toujours l'une des sources ci-dessous. Vérifiez-les dans cet ordre, de la plus fréquente à la plus rare.
Source
Situation typique
Où vérifier
Réglage global du CMS
Option cochée pendant le développement, puis jamais décochée
WordPress : Réglages, Lecture, « Search engine visibility » ; autres CMS : réglages SEO du site
Extension ou application SEO
Type de contenu, taxonomie ou page unique réglés sur noindex
Réglages de l'extension par type de contenu, puis la case SEO de la page
Code du thème ou des gabarits
Une balise meta robots écrite dans un fichier de gabarit
Gabarit d'en-tête, gabarits de page
Migration ou refonte
Réglages de préproduction passés en production
Comparez la configuration de l'ancien et du nouveau site
Configuration du serveur
X-Robots-Tag ajouté dans .htaccess ou dans la configuration du serveur
Règles Apache, Nginx ou panneau de l'hébergeur
CDN ou règles de périphérie
Une règle d'en-tête appliquée à tout un chemin
Règles de transformation ou d'en-têtes du CDN
JavaScript
Un script qui ajoute ou retire la balise meta après le chargement
HTML rendu dans l'inspection d'URL
Le cas de WordPress est assez fréquent pour être nommé. Selon la documentation WordPress sur l'écran Lecture, cocher « Discourage search engines from indexing this site » ajoute noindex,nofollow dans le head de chaque page (depuis la version 5.3). Une seule case oubliée après une mise en ligne suffit à retirer tout un site de Google. Les mises en ligne et les refontes sont les moments les plus risqués, c'est pourquoi une checklist de migration SEO contient toujours un contrôle des règles d'exploration. Pour les réglages propres à WordPress, consultez notre page sur le SEO et le GEO avec WordPress.
Comment diagnostiquer le statut, étape par étape ?
Ouvrez le rapport. Dans la Search Console, allez dans Indexation, puis Pages, cliquez sur « Excluded by 'noindex' tag » et exportez la liste.
Triez les URL avec le tableau ci-dessus. Mettez de côté celles qui doivent rester hors de l'index.
Inspectez une URL importante. Collez-la dans l'outil d'inspection d'URL. La ligne « Indexing allowed? » indique si Google a vu un noindex et s'il vient de la balise meta robots ou de l'en-tête X-Robots-Tag.
Testez l'URL en direct. Cliquez sur « Test live URL » : si la version en ligne n'a plus de noindex, la règle a déjà été retirée et Google n'a besoin que d'une nouvelle exploration.
Vérifiez vous-même les deux emplacements. Cherchez noindex dans le code source de la page, puis dans les en-têtes de réponse (outils de développement du navigateur, onglet Réseau). Un vérificateur d'en-têtes HTTP gratuit affiche le X-Robots-Tag sans aucun outil de développement, et le vérificateur d'indexabilité teste la balise meta, l'en-tête et le robots.txt en une seule fois.
Remontez à la source avec le tableau des sources, en commençant par le réglage du CMS et l'extension SEO.
Attention
Google peut ne pas afficher le rendu d'une page quand il trouve un noindex dans le HTML d'origine. Son guide du SEO JavaScript prévient que « using JavaScript to change or remove the robots meta tag from noindex may not work as expected ». Un script qui retire la balise après le chargement ne règle pas le problème.
Comment corriger ?
La correction dépend de la source. Modifiez le réglage là où la règle est générée, jamais seulement ce qui s'affiche, sinon elle revient à la prochaine mise à jour.
Source trouvée
Correction
Réglage global du CMS
Décochez l'option, videz le cache, vérifiez le code source de la page d'accueil
Extension SEO, page par page
Réglez la page sur « index » dans ses réglages SEO
Extension SEO, par type de contenu
Changez la valeur par défaut du type de contenu, puis vérifiez que les pages uniques ne la remplacent pas
Code du thème
Retirez la balise écrite en dur dans le gabarit, idéalement dans un thème enfant
En-tête du serveur ou du CDN
Supprimez ou restreignez la règle X-Robots-Tag pour qu'elle ne vise que les chemins à masquer
JavaScript
Servez la bonne balise meta robots dans le HTML d'origine
Page bloquée par le robots.txt
Autorisez d'abord l'exploration, sinon Google ne peut pas voir que le noindex a disparu
Après la correction, demandez l'indexation des URL les plus importantes dans l'outil d'inspection d'URL, et renvoyez le sitemap si beaucoup de pages sont touchées. Pour un groupe d'URL corrigées, cliquez sur « Validate fix » dans le rapport : Google indique que la validation « typically takes up to about two weeks, but in some cases can take much longer ». Videz d'abord le cache de la page ou du CDN, faute de quoi Google récupère l'ancienne version avec l'ancienne règle. Si des pages n'apparaissent toujours pas quelques semaines plus tard, notre guide sur l'indexation des pages par Google liste les leviers suivants. Si elles passent sur Crawled - currently not indexed, le problème n'est plus la règle mais le contenu.
Noindex, robots.txt ou canonical : lequel utiliser ?
Ces trois outils sont souvent confondus, et les combiner mal produit les rapports les plus déroutants.
Outil
Ce qu'il fait
Pour quoi faire
Erreur fréquente
noindex
Page explorée, gardée hors des résultats
Pages que les visiteurs atteignent mais que les internautes ne doivent pas trouver dans la recherche
Combiné à un blocage robots.txt, si bien que Google ne lit jamais la règle
Disallow dans robots.txt
Page non explorée
Économiser le budget d'exploration sur de grands ensembles d'URL inutiles
Utilisé pour retirer une page des résultats : l'URL peut rester indexée sans son contenu
Balise canonical
Signale la version préférée parmi des doublons
Variantes d'un même contenu (paramètres, tris)
Combinée à un noindex sur la même page, ce qui envoie des signaux contradictoires
Google le dit clairement : si le robots.txt bloque une page, « the crawler will never see the noindex rule ». Si vous voulez qu'une page sorte de l'index, laissez-la explorable avec noindex jusqu'à sa disparition, puis décidez s'il faut la bloquer. Testez votre fichier avec le vérificateur de robots.txt, et lisez la spécification de la balise meta robots pour la liste complète des règles : elle indique aussi que, en cas de conflit, « the more restrictive rule applies ».
Note
Une page qui affiche « Indexed, though blocked by robots.txt » est le cas inverse : Google a indexé l'URL à partir de liens sans la lire. Débloquez-la et ajoutez un noindex si vous voulez qu'elle sorte de l'index.
Pourquoi cela compte-t-il pour le SEO et la visibilité dans les IA ?
Une page sous noindex ne reçoit aucun clic organique de Google, quelle que soit sa qualité. Sur un grand site, une règle indésirable sur un gabarit peut retirer des centaines de pages produit ou d'articles d'un coup, et le premier signe est souvent une baisse de trafic quelques semaines plus tard. Si votre site semble avoir totalement disparu, commencez par notre checklist sur un site qui n'apparaît pas sur Google.
Les assistants IA ajoutent un second coût. ChatGPT, Perplexity et Gemini répondent souvent en récupérant des pages dans les index de recherche web et en les citant, si bien qu'une page absente de l'index a peu de chances d'être citée. Notre étude sur les plateformes les plus citées par les IA montre quelles sources elles privilégient.
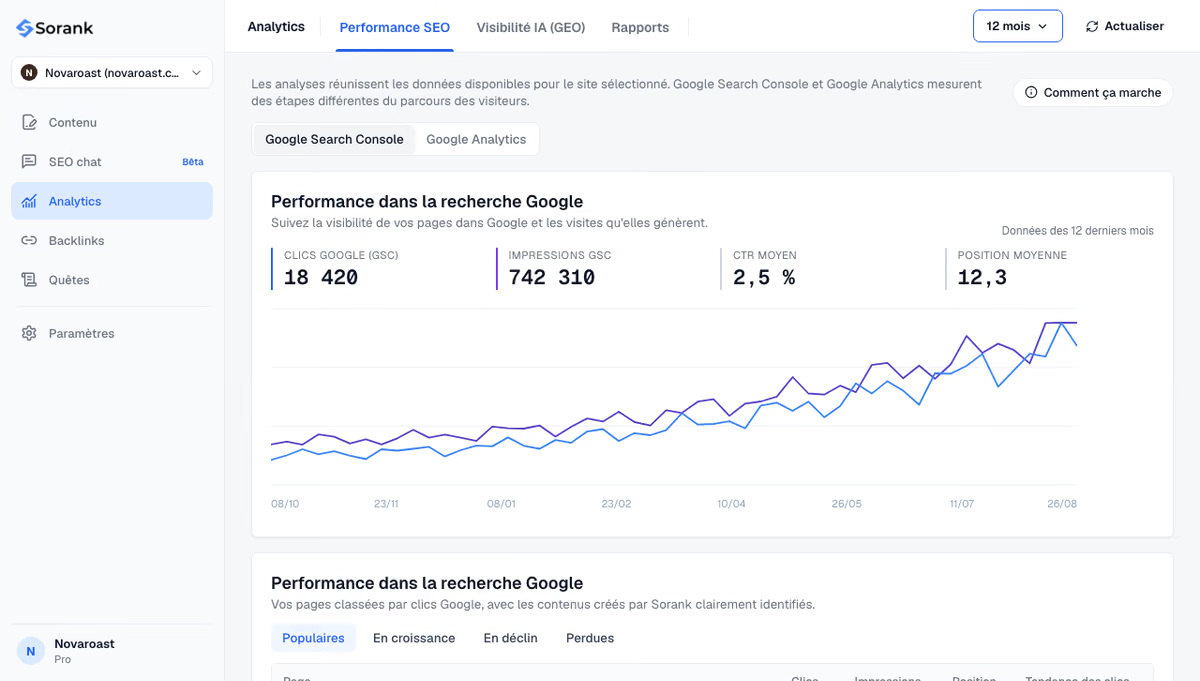
Sorank est notre produit : un logiciel de SEO et de GEO en autopilote. Son tableau de bord GEO et SEO affiche les clics, les impressions et les positions issus de la Search Console, si bien qu'une chute soudaine des impressions sur un groupe de pages se repère vite, et la extension Chrome gratuite de Sorank signale les problèmes SEO de toute page que vous ouvrez.
En bref : laissez le noindex sur les pages qui ne doivent jamais se classer, retirez-le à la source sur celles qui doivent se classer, gardez le sitemap sans URL noindex, et ne bloquez jamais une page dans le robots.txt pendant que Google attend de lire son noindex. Pour publier des pages conçues pour être indexées et citées, voyez les offres de Sorank, à partir de 49€ par mois, avec un essai gratuit de 3 jours.
Questions fréquentes
Combien de temps faut-il pour qu'une page soit indexée après la suppression du noindex ?
Google doit d'abord réexplorer la page avant que quoi que ce soit ne change, ce qui peut prendre de quelques jours à plusieurs semaines selon la fréquence de ses passages sur le site. Demander l'indexation dans l'outil d'inspection d'URL accélère les URL importantes. Selon Google, la validation d'un groupe de pages corrigées prend en général jusqu'à environ deux semaines.
Un noindex sur certaines pages nuit-il au reste de mon site ?
Non. Le noindex ne concerne que les pages qui le portent, et Google n'applique aucune pénalité globale pour cela. Utiliser noindex sur des pages peu utiles, comme le panier, la connexion ou les résultats de recherche interne, est une pratique courante. Le risque vient d'une règle appliquée par erreur à des pages qui devraient se classer.
Faut-il utiliser noindex ou supprimer une page dont je ne veux plus dans Google ?
Si les visiteurs ont encore besoin de la page, par exemple une page de remerciement ou de compte, gardez-la et utilisez noindex. Si elle n'a plus d'utilité, supprimez-la et renvoyez une erreur 404 ou 410, ou redirigez-la par une redirection 301 vers la page pertinente la plus proche si elle a des backlinks ou du trafic. Les deux méthodes retirent l'URL de l'index après la prochaine exploration.
y!
Audit SEO et GEO gratuit
Recevez gratuitement votre plan de contenu pour 30 jours
Nous analysons vos concurrents, votre site et votre visibilité dans les IA pour créer gratuitement un plan de contenu sur mesure.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
Croissance organiqueGénération de leads pour installateurs
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne