Předvolby
Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

SEO pro vývojáře: jak renderovat stránky, které roboti dokážou číst, vracet správné kódy HTTP, nasadit základní tagy v hlavičce, splnit Core Web Vitals a zůstat viditelní pro AI.

Nástroje

Stručně
pro vývojáře znamená SEO, že každá důležitá stránka je dostupná, vykreslitelná a jednoznačná pro roboty. Hlavní obsah podávejte už v počátečním HTML (renderování na serveru nebo statické generování), vracejte poctivé stavové kódy HTTP, dejte title, meta popis, canonical a direktivy robots do odpovědi serveru, odkazujte pomocí skutečných prvků <a href>, splňte prahy Core Web Vitals a přidejte strukturovaná data JSON-LD. Většina AI robotů nespouští JavaScript, takže obsah, který existuje až po hydrataci, je neviditelný pro ChatGPT, Claude a Perplexity.
Chcete jít dál? Zeptejte se
Rychlý kvíz
Hodí se vám SEO a jak začít?
Sorank odpovídá vašim odpovědím


Vyzkoušejte to 3 dny na svém webu a zjistěte, kde stojíte na Googlu, v ChatGPT a v ostatních AI.
Spustit 3denní bezplatnou zkušební verzi3 dny zdarma, poté můžete kdykoli přestat. Garance výsledků nebo vrácení peněz do 90 dnů.
SEO pro vývojáře je ta část optimalizace pro vyhledávače, která žije v kódu: šablony, směrování, renderování, hlavičky a výkon. Marketéři vybírají klíčová slova a píšou obsah, ale jeden špatný stavový kód, trasa dostupná jen na klientovi nebo zapomenutý noindex mohou tuto práci vymazat jediným nasazením. Google sám ve svých základech SEO pro JavaScript popisuje tři fáze (procházení, renderování, indexace) a každá má chyby, které mohou opravit jen vývojáři. Tento průvodce je probírá v pořadí, v jakém se rozbíjejí.
| Oblast | Odpovědnost vývojáře | Typický příznak, když se to rozbije |
|---|---|---|
| Renderování | Hlavní obsah a odkazy jsou přítomné v HTML ze serveru | Stránky indexované s prázdným nebo neúplným obsahem |
| Stavové kódy | 200, 301, 404, 410 a 5xx vracené pravdivě | Měkké 404, indexované chybové stránky, smazané stránky stále v pořadí |
| Tagy v hlavičce | Jedinečný title, popis, canonical, robots, hreflang | Duplicity, pořadí špatné URL, stránky chybí v indexu |
| Řízení procházení | robots.txt, XML sitemapa, interní odkazy, parametry | Důležité stránky se neobjeví, procházení plýtvá na filtrech |
| Výkon | Core Web Vitals u skutečných mobilních uživatelů | Špatná zkušenost se stránkou, nižší konverze |
| Strukturovaná data | Platný JSON-LD odpovídající viditelnému obsahu | Žádné rozšířené výsledky, záměna entit |
| Přístup AI | Povolení AI uživatelských agentů, obsah čitelný bez JavaScriptu | Značka chybí v odpovědích ChatGPT a Perplexity |
Googlebot spouští JavaScript, ale v druhém kroku, který se může opozdit, a sám Google píše, že „renderování na serveru nebo pre-rendering je pořád skvělý nápad“, protože je rychlejší pro uživatele i roboty a protože ne všechny boty spouštějí JavaScript. Ten poslední bod má dnes větší váhu než dřív: ve své analýze z prosince 2024 Vzestup AI crawlerů zjistil Vercel, že „žádný z hlavních AI crawlerů v současnosti nevykresluje JavaScript“, a jmenoval mimo jiné GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot a PerplexityBot. Výjimkou je Gemini, který využívá infrastrukturu Googlu.
| Režim renderování | Co roboti dostávají | Vhodnost pro SEO |
|---|---|---|
| Client-side rendering (CSR) | Téměř prázdná HTML kostra, obsah až po spuštění JavaScriptu | Slabé: u Googlu opožděné, pro většinu AI crawlerů neviditelné |
| Server-side rendering (SSR) | Úplné HTML při každém požadavku | Silné pro dynamické stránky |
| Statické generování (SSG) | Úplné HTML vytvořené při nasazení | Nejsilnější pro obsah, který se mění zřídka |
| Inkrementální regenerace (ISR) | Statické HTML obnovované podle plánu nebo na vyžádání | Silné pro velké katalogy a blogy |
Bez ohledu na framework platí dvě pravidla. Odkazy musejí být prvky <a> s atributem href: Google uvádí, že odkazy umí objevit jen v této podobě, takže tlačítka s obslužnými funkcemi kliknutí a trasy založené na fragmentech jsou slepé uličky. A každá trasa potřebuje vlastní URL bez znaku #, které vrací obsah přímo. Naše průvodce SEO pro JavaScript, SEO pro jednostránkové aplikace a SEO pro Next.js jdou do detailů pro jednotlivé frameworky.
Stavové kódy jsou pro roboty pokyny. Dokumentace Googlu ke stavovým kódům HTTP a síťovým chybám popisuje, jak se zachází s jednotlivými skupinami:
Zkontrolujte, co váš server skutečně posílá, pomocí kontroly HTTP hlaviček, a řetězce přesměrování držte na jednom kroku. Náš článek o přesměrováních pro SEO popisuje vzorce migrace.
Každá indexovatelná stránka potřebuje jedinečný title a popis, samoodkazující canonical a na vícejazyčných webech anotace hreflang. Držte je v odpovědi serveru:
<title>Běžecké boty pro ploché nohy | Příklad</title>
<meta name="description" content="Testované výběry, velikosti a ceny.">
<link rel="canonical" href="https://example.com/running-shoes-flat-feet">
<link rel="alternate" hreflang="fr" href="https://example.com/fr/chaussures-pieds-plats">
<meta name="robots" content="index, follow">
Tag kanonický odkaz (canonical) musí ukazovat na URL, které chcete mít v pořadí, s přesným protokolem, hostitelem a konvencí koncového lomítka, kterou váš web používá.
Pozor
Nikdy se nespoléhejte na JavaScript, aby odstranil noindex. Google uvádí, že když najde značku noindex, může vynechat renderování, takže stránka, která v HTML posílá noindex a na klientovi ho odstraní, může zůstat mimo index.
Vyhledávače indexují URL, takže schéma URL je rozhodnutí pro SEO. Používejte malá písmena, čitelné cesty oddělené pomlčkami, zvolte jednu konvenci koncového lomítka a druhou přesměrujte, a držte jednu URL pro každý kus obsahu. Filtry, řazení a sledovací parametry množí URL bez přidání obsahu: nastavte jejich canonical na čistou verzi a neodkazujte na kombinace parametrů, které nechcete procházet.
Interní odkazy nesou objevování i důležitost. Navigaci, drobečkovou navigaci a bloky souvisejícího obsahu renderujte na serveru, stránkované seznamy opatřete prostými odkazy na každou stránku a nepoužívejte nekonečné rolování bez stránkovaných URL za ním. Produkt nebo článek, ke kterému se dostanete jen přes vyhledávání na webu nebo JavaScriptový filtr, je pro robota osiřelá stránka.
robots.txt řídí procházení, ne indexaci: zablokovaná URL se může ve výsledcích objevit, pokud na ni odkazují jiné stránky. Chcete-li stránku z indexu vyřadit, nechte ji projít a vraťte noindex. XML sitemapu generujte z tras nebo databáze, uvádějte jen kanonické URL se stavem 200 a lastmod měňte jen tehdy, když se obsah skutečně změní. Pravidla testujte kontrolou robots.txt před každým vydáním a nikdy na produkci nenasazujte testovací robots.txt s „Disallow: /“.
Google používá Core Web Vitals jako součást signálů zkušenosti se stránkou. Podle web.dev je stránka dobrá, když splní tyto prahy na 75. percentilu skutečných načtení stránek, na mobilu i na počítači:
| Metrika | Měří | Dobrý práh | Časté opravy pro vývojáře |
|---|---|---|---|
| LCP (Largest Contentful Paint) | Načítání | 2,5 s nebo méně | Předběžně načtěte hlavní obrázek, renderujte na serveru obsah nad záhybem, použijte CDN |
| INP (Interaction to Next Paint) | Odezva | 200 ms nebo méně | Rozdělte dlouhé úlohy, odložte skripty třetích stran, snižte náklady hydratace |
| CLS (Cumulative Layout Shift) | Vizuální stabilita | 0,1 nebo méně | Nastavte šířku a výšku médií, vyhraďte místo pro reklamy a vložené prvky |
INP nahradil First Input Delay jako stabilní Core Web Vital v roce 2024. K posouzení použijte data z terénu (Search Console, Chrome UX Report) a laboratorní nástroje k ladění. Náš slovníkový záznam o Core Web Vitals uvádí nástroje.
Použijte JSON-LD ve značce script, renderovanou na serveru, která popisuje to, co je na stránce vidět:
<script type="application/ld+json">
{"@context": "https://schema.org", "@type": "Article",
 "headline": "Běžecké boty pro ploché nohy",
 "datePublished": "2026-10-01",
 "author": {"@type": "Person", "name": "Jane Doe"}}
</script>
Generujte ho ze stejných dat jako stránku, aby se nikdy nerozešla, ověřujte ho v CI a nevkládejte ho přes správce značek. Generátor schématu dá výchozí šablonu pro běžné typy.
Tip
Přidejte kontroly SEO do svého procesu: sestavení nechte selhat, pokud indexovatelná šablona nemá title nebo canonical, pokud trasa vrací 200 pro neznámý slug, nebo pokud produkční robots.txt obsahuje „Disallow: /“. Tyto regrese se chytají levně před nasazením a draze po něm.
Viditelnost v AI začíná přístupem. Rozhodněte, které AI uživatelské agenty povolíte (GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot a další), a napište výslovná pravidla do robots.txt; náš průvodce robots.txt pro AI crawlery vysvětluje rozdíl mezi trénovacími a vyhledávacími boty. Pak zajistěte, aby text, ceny, parametry a FAQ byly v počátečním HTML, používejte sémantické nadpisy a tabulky místo obrázků textu a držte stránky dost lehké, aby se rychle načetly. Soubor llms.txt může shrnout klíčové stránky pro AI nástroje, ale žádný velký asistent zatím nepotvrdil, že se jím řídí, takže ho berte jako volitelný.
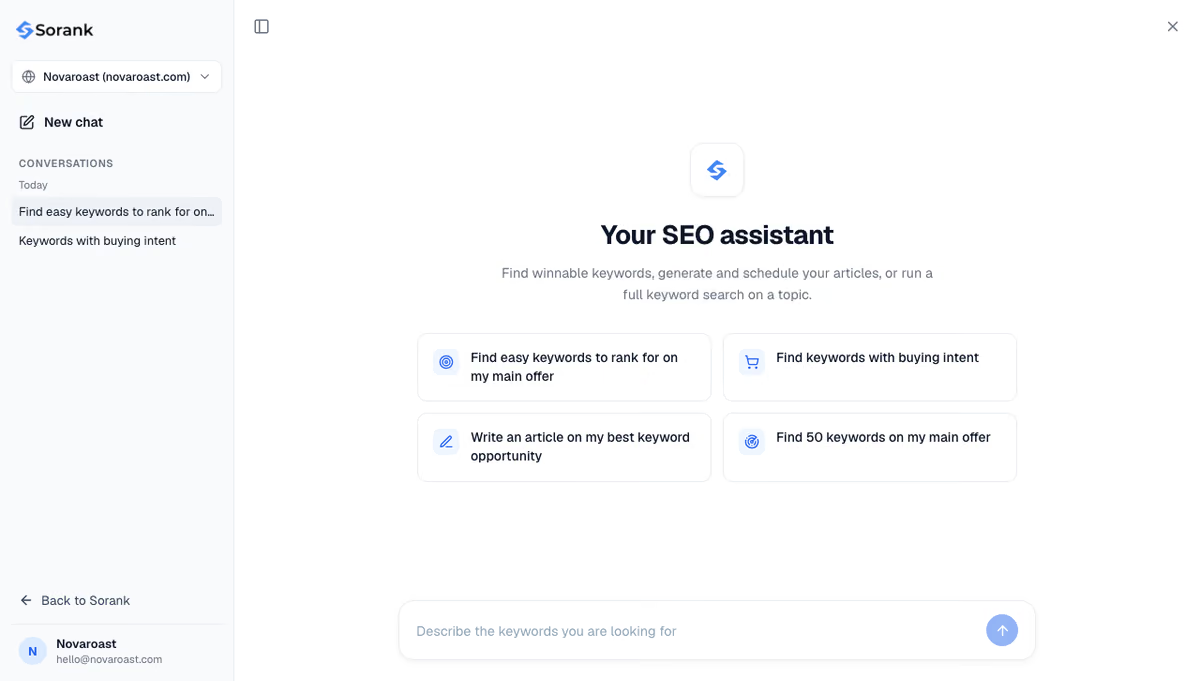
Sorank je náš produkt: software pro SEO a GEO v režimu autopilot. Vývojáři se s ním nejčastěji setkají přes integrace: publikuje články na WordPress, Shopify, Webflow nebo Wix, nebo na vlastní řešení přes webhook, jak je popsáno na stránce instalace. Jeho SEO chat odpovídá na otázky o vašem webu v konverzaci a Sledování zmínek v AI každý měsíc kontroluje, zda ChatGPT, Claude a Gemini citují vaši značku.
Stručně: posílejte ze serveru kompletní HTML, poctivé stavové kódy a správné tagy v hlavičce, a výkon pak měřte na skutečných uživatelích. To slouží Googlebotu i AI robotům, kteří nespouštějí JavaScript. Pro naplnění dobře postaveného webu obsahem, který se umisťuje, viz tarify Sorank, od $49 měsíčně s 3denní bezplatnou zkušební dobou.

Pro Google ne vždy, protože renderuje JavaScript, ale přidává zpoždění a riziko, a většina AI crawlerů JavaScript vůbec nespouští. U stránek, které se musejí umisťovat nebo být citovány, podávejte hlavní obsah a odkazy v počátečním HTML pomocí renderování na serveru, statického generování nebo pre-renderingu a renderování na klientovi nechte pro interaktivní části.
Oba kódy Googlu říkají, že stránka zmizela, a Google URL v obou případech postupně přestane používat. 410 výslovně říká, že odstranění je záměrné a trvalé, což některé týmy preferují u obsahu, který smazaly schválně. Nejdůležitější je nevracet 200 s chybovou zprávou, protože to vytváří měkké 404.
Jsou součástí signálů zkušenosti se stránkou, které Google popisuje jako jeden faktor mezi mnoha, přičemž větší váhu mají relevance a kvalita obsahu. V praxi fungují jako rozhodovač mezi podobnými stránkami a silně ovlivňují konverze, takže splnit prahy stojí za to.
Analyzujeme vaši konkurenci, váš web a vaši viditelnost v AI, abychom pro vás zdarma připravili obsahový plán na míru.
 Generátor zadání článku s AI
 Generátor schématu FAQ
 Generátor nápadů na blogové články s AI
 Validátor strukturovaných dat (validátor schématu)
 Kontrola alternativních textů
 Analyzátor interních odkazů
 Výzva zpětných odkazů
 Generátor meta popisů s AI
 Generátor titulků blogu s AI
 Kontrola indexovatelnosti pro Google
 Generátor osnovy článku s AI
 Tvůrce UTM odkazů
 Nástroj pro clustering klíčových slov
 Kontrola kanonické značky
 Generátor XML sitemap
 Kontrola nefunkčních odkazů
 Generátor SEO titulků s AI
 Analyzátor nadpisů
 Nástroj pro náhled SERP
 Kontrola přesměrování
 Generátor značek hreflang
 Analyzátor struktury nadpisů
 Kontrola HTTP hlaviček
 Extraktor favicon
 Kalkulačka CTR v SERP
 Kalkulačka úspor SEO oproti placenému vyhledávání
 Kalkulačka podílu hlasu v SEO
 Kalkulačka ROI SEO
 Kalkulačka předpovědi návštěvnosti a tržeb SEO
 Kalkulačka rozpočtu SEO
 Kalkulačka bodu zvratu SEO
 Kalkulačka ROI SEO pro SaaS
 Kalkulačka ROAS
 Kalkulačka doby čtení
 Simulátor zisku pozic
 Kalkulátor hodnoty organické návštěvnosti
 Odhad organické návštěvnosti a kontrola návštěvnosti webu
 Kalkulátor poměru LTV a CAC
 Kalkulátor ROI lokálního SEO
 Kalkulátor nákladů na budování zpětných odkazů
 Kalkulátor hodnoty klíčových slov
 Kalkulačka skóre příležitosti klíčových slov
 Kalkulačka hustoty klíčových slov
 Kalkulačka ROI GEO
 Kalkulačka investice do obsahu GEO
 Kalkulačka návratnosti SEO pro e-shop
 Kalkulačka celoživotní hodnoty zákazníka
 Kalkulačka nákladů na získání zákazníka
 Kalkulátor CTR
 Kalkulátor ceny za článek
 Kalkulátor míry konverze
 Kalkulátor ROI obsahového marketingu
 Odhad návštěvnosti z ChatGPT
 Kalkulátor míry odchodů
 Kalkulátor ROI zpětných odkazů
 Kalkulátor skóre viditelnosti v AI
 Kalkulačka hodnoty návštěvnosti z AI
 Kalkulačka podílu hlasů v AI
 Kalkulačka ceny neviditelnosti v AI
 Kalkulačka míry citování v AI
 Validátor llms.txt
 Kontrola AI Overviews a kontrola pozic v AI Overviews
 Kontrola robots.txt
 Audit AI SEO
 Kontrola čitelnosti pro LLM
 Kontrola připravenosti pro SearchGPT
 Audit strukturovaných dat pro LLM
 Audit procházení webu pro AI
 Proč ChatGPT nedoporučuje můj web
 Nástroj pro kontrolu pozic v Gemini
 Kontrola pořadí v Perplexity
 Kontrola citací v LLM
 Audit optimalizace pro odpovědní enginy
 Audit GEO
 Test viditelnosti ve vyhledávání AI
 Kontrola viditelnosti v ChatGPT
 Generátor llms.txt
 Extraktor URL
 Převod stránky do Markdownu
 Kontrola sitemapy
 Senzor volatility SERP
 Kontrola velikosti stránky
 Počítadlo slov
 Generátor slugů
 Generátor schema
 Generátor robots
 Náhled OG
 Generátor meta značek
 Kompresor obrázků
 Generátor favicon
 Audit on-page SEO: kontrola a analýza SEO
 Nástroj pro analýzu zpětných odkazů
 Nástroj pro výzkum klíčových slov
 Kontrola autority domény
VYZKOUŠELI SORANK PŘED VÁMI
 “Sorank jsem otestoval na skutečném webu klienta a je to neuvěřitelné. Dělá všechno, za co by vám agentura účtovala 1500 $ měsíčně. Právě ho nasazujeme do provozu na tomto klientovi.”

 Guillaume Guersanguersanguillaume.com“Jsme reklamní agentura a chtěli jsme konečně dostat naše SEO na pravou míru. Sorank nám poskytl jasný pohled na náš web, pomohl nám určit priority optimalizací a správně strukturovat náš obsah. Nástroj se snadno používá, je dobře navržený pro tým a velmi praktický, protože centralizuje sledování bez nutnosti žonglovat s více platformami. Velmi pevný základ pro nový start našeho SEO.”
 Gaspard MadouiReklamní agentura
 “Nechal jsem software Sorank dělat svou práci a teď je moje DR 25 a moje stránka se umisťuje výš.”
 Lucas Flandrefoundertrace.fr“Díky Sorank se specializuji na GEO. Žebříček GEO mi umožňuje ukázat klientům jejich postavení oproti konkurenci v ChatGPT. Je to skutečná obchodní výhoda.”
 MélanieSEO freelancer“Skvělá služba, dobře funguje pro náš web a pomáhá nám pochopit, jak ho zlepšit, aby se lépe umisťoval ve výsledcích Google a jinde. Gratulujeme, pokračujte, doporučuji.”
 Hugo T.Majitel e-shopu