Præferencer
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

SEO for udviklere: Sådan renderer du sider, som crawlere kan læse, returnerer de rigtige HTTP-koder, sender de vigtigste head-tags, opfylder Core Web Vitals og forbliver synlig for AI.

Værktøjer

Kort fortalt
for en udvikler betyder SEO, at hver vigtig side kan nås, renderes og er entydig for crawlere. Lever hovedindholdet i den første HTML (server-side rendering eller statisk generering), returnér ærlige HTTP-statuskoder, læg titlen, metabeskrivelsen, canonical og robots-direktiverne i serversvaret, link med rigtige <a href>-elementer, opfyld tærskelværdierne for Core Web Vitals, og tilføj JSON-LD-strukturerede data. De fleste AI-crawlere kører ikke JavaScript, så indhold, der først findes efter hydrering, er usynligt for ChatGPT, Claude og Perplexity.
Vil du vide mere? Spørg
Hurtig quiz
Passer SEO til dig, og hvordan skal du starte?
Sorank matcher dine svar


Test det i 3 dage på dit eget site, og se, hvor du står på Google, ChatGPT og de andre AI'er.
Start prøveperiode på 3 dage3 dage gratis, derefter stopper du, når du vil. 90 dages garanti: resultater eller pengene tilbage.
SEO for udviklere er den del af søgeoptimeringen, der lever i koden: skabeloner, routing, rendering, headers og ydeevne. Marketingfolk vælger søgeord og skriver indhold, men en forkert statuskode, en rute der kun findes på klientsiden, eller et tilfældigt noindex kan slette arbejdet i én udrulning. Googles egne grundlæggende principper for JavaScript-SEO beskriver tre faser (crawling, rendering, indeksering), og hver af dem har fejlkilder, som kun udviklere kan rette. Denne guide gennemgår dem i den rækkefølge, de går i stykker.
| Område | Udviklerens ansvar | Typisk symptom, når det går galt |
|---|---|---|
| Rendering | Hovedindhold og links findes i serverens HTML | Sider indekseret med tomt eller delvist indhold |
| Statuskoder | 200, 301, 404, 410 og 5xx returneres sandfærdigt | Bløde 404-fejl, fejlsider indekseret, slettede sider der stadig rangerer |
| Head-tags | Unik titel, beskrivelse, canonical, robots og hreflang | Dubletter, forkert URL rangerer, sider mangler i indekset |
| Crawlstyring | robots.txt, XML-sitemap, interne links, parametre | Vigtige sider bliver ikke opdaget, crawl spildes på filtre |
| Ydeevne | Core Web Vitals hos reelle mobilbrugere | Dårlig sideoplevelse, lavere konverteringer |
| Strukturerede data | Gyldig JSON-LD, der passer til det synlige indhold | Ingen rich results, forvirring om entiteter |
| AI-adgang | Tilladte AI-user-agents, indhold der kan læses uden JavaScript | Brandet mangler i svar fra ChatGPT og Perplexity |
Googlebot kører JavaScript, men i et andet trin, der kan blive forsinket, og Google selv skriver, at »server-side eller prerendering er stadig en god idé«, fordi det er hurtigere for brugere og crawlere, og fordi ikke alle bots kører JavaScript. Det sidste punkt betyder mere end nogensinde: i sin analyse fra december 2024 The rise of the AI crawler fandt Vercel, at »ingen af de store AI-crawlere i øjeblikket renderer JavaScript«, og nævnte blandt andre GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot og PerplexityBot. Gemini, som bruger Googles infrastruktur, er undtagelsen.
| Renderingsform | Hvad crawlere får | Egnethed til SEO |
|---|---|---|
| Rendering på klientsiden (CSR) | En næsten tom HTML-skal, indhold efter at JavaScript er kørt | Svag: forsinket for Google, usynlig for de fleste AI-crawlere |
| Server-side rendering (SSR) | Fuld HTML ved hver forespørgsel | Stærk for dynamiske sider |
| Statisk generering (SSG) | Fuld HTML bygget ved udrulning | Stærkest for indhold, der sjældent ændres |
| Inkrementel regenerering (ISR) | Statisk HTML opdateret efter en plan eller på forespørgsel | Stærk for store kataloger og blogs |
To regler gælder uanset framework. Links skal være <a>-elementer med et href-attribut: Google oplyser, at det kun kan opdage links i den form, så knapper med klikhandlere og routes baseret på fragmenter er blindgyder. Og hver rute skal have sin egen URL, uden #, der returnerer indholdet direkte. Vores guider til JavaScript-SEO, SEO for single-page-applikationer og Next.js-SEO går i detaljer med de enkelte frameworks.
Statuskoder er instruktioner til crawlere. Googles dokumentation om HTTP-statuskoder og netværksfejl beskriver, hvordan hver familie håndteres:
Kontrollér, hvad din server reelt sender, med en kontrol af HTTP-headers, og hold omdirigeringskæder til ét hop: vores artikel om SEO-omdirigeringer dækker migreringsmønstre.
Hver side, der kan indekseres, skal have en unik titel og beskrivelse, en selvreferende canonical og, på flersprogede sites, hreflang-annoteringer. Hold dem i serversvaret:
<title>Løbesko til platfødder | Eksempel</title>
<meta name="description" content="Testede valg, størrelser og priser.">
<link rel="canonical" href="https://example.com/running-shoes-flat-feet">
<link rel="alternate" hreflang="fr" href="https://example.com/fr/chaussures-pieds-plats">
<meta name="robots" content="index, follow">
Den canonical-tag skal pege på den URL, du ønsker rangeret, med præcis den protokol, det værtsnavn og den skråstregskonvention, dit site bruger.
Pas på
Stol aldrig på JavaScript til at fjerne et noindex. Google oplyser, at når det finder et noindex-tag, kan det springe rendering over, så en side, der leverer noindex i HTML og fjerner det på klientsiden, kan blive stående uden for indekset.
Søgemaskiner indekserer URL'er, så URL-strukturen er en SEO-beslutning. Brug små bogstaver, stavelser adskilt af bindestreger og læsbare stier; vælg én skråstregskonvention og omdiriger den anden; og hold én URL pr. indholdsstykke. Filtre, sortering og sporingsparametre multiplicerer URL'er uden at tilføje indhold: sæt dem til canonical på den rene version, og link ikke til parameterkombinationer, du ikke ønsker crawlet.
Interne links bærer både opdagelse og vigtighed. Render navigation, brødkrummer og blokke med relateret indhold på serveren, giv paginerede lister almindelige links til hver side, og undgå uendelig scroll uden paginerede URL'er bag. En produkt- eller artikelside, der kun kan nås via sitesøgning eller et JavaScript-filter, er for en crawler en forældreløs side.
robots.txt styrer crawling, ikke indeksering: en blokeret URL kan stadig dukke op i resultaterne, hvis andre sider linker til den. For at holde en side ude af indekset skal du lade den blive crawlet og returnere noindex. Generér XML-sitemappet ud fra dine routes eller din database, list kun canonical 200-URL'er, og opdatér lastmod kun, når indholdet virkelig ændrer sig. Test dine regler med en kontrol af robots.txt før hver udgivelse, og udrul aldrig en staging-robots.txt med »Disallow: /« til produktion.
Google bruger Core Web Vitals som en del af sine signaler om sideoplevelse. Ifølge web.dev er en side god, når den opfylder disse tærskelværdier ved den 75. percentil af reelle sideindlæsninger, på mobil og desktop:
| Måleparameter | Måler | God tærskelværdi | Typiske rettelser for udviklere |
|---|---|---|---|
| LCP (Largest Contentful Paint) | Indlæsning | 2,5 s eller mindre | Forhåndsindlæs heltebilledet, server-render indhold over folden, brug et CDN |
| INP (Interaction to Next Paint) | Lydhørhed | 200 ms eller mindre | Del lange opgaver op, udsæt tredjepartsscripts, reducér omkostningen ved hydrering |
| CLS (Cumulative Layout Shift) | Visuel stabilitet | 0,1 eller mindre | Sæt bredde og højde på medier, reservér plads til annoncer og indlejringer |
INP erstattede First Input Delay som stabil Core Web Vital i 2024. Brug felddata (Search Console, Chrome UX Report) til at vurdere, og labværktøjer til at fejlsøge. Vores ordbogsindgang om Core Web Vitals lister værktøjerne.
Brug JSON-LD i et script-tag, renderet på serveren, der beskriver det, der er synligt på siden:
<script type="application/ld+json">
{"@context": "https://schema.org", "@type": "Article",
 "headline": "Løbesko til platfødder",
 "datePublished": "2026-10-01",
 "author": {"@type": "Person", "name": "Jane Doe"}}
</script>
Generér det ud fra de samme data som siden, så de to aldrig afviger, valider det i CI, og undgå at indsætte det via en tagmanager. En schema-generator giver en startskabelon for de almindelige typer.
Tip
Tilføj SEO-kontroller til din pipeline: stop bygningen, hvis en skabelon, der kan indekseres, mangler titel eller canonical, hvis en rute returnerer 200 for et ukendt slug, eller hvis produktions-robots.txt indeholder »Disallow: /«. Disse fejl er billige at fange før udrulning og dyre bagefter.
AI-synlighed starter med adgang. Beslut, hvilke AI-user-agents du tillader (GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot og andre), og skriv eksplicitte regler i robots.txt; vores guide til robots.txt for AI-crawlere forklarer forskellen mellem trænings- og søgebots. Sørg derefter for, at teksten, priserne, specifikationerne og FAQ'en står i den første HTML, brug semantiske overskrifter og tabeller frem for billeder af tekst, og hold siderne lette nok til at hente hurtigt. En llms.txt-fil kan opsummere dine vigtigste sider til AI-værktøjer, men ingen større assistent har bekræftet, at den bruges, så betragt den som valgfri.
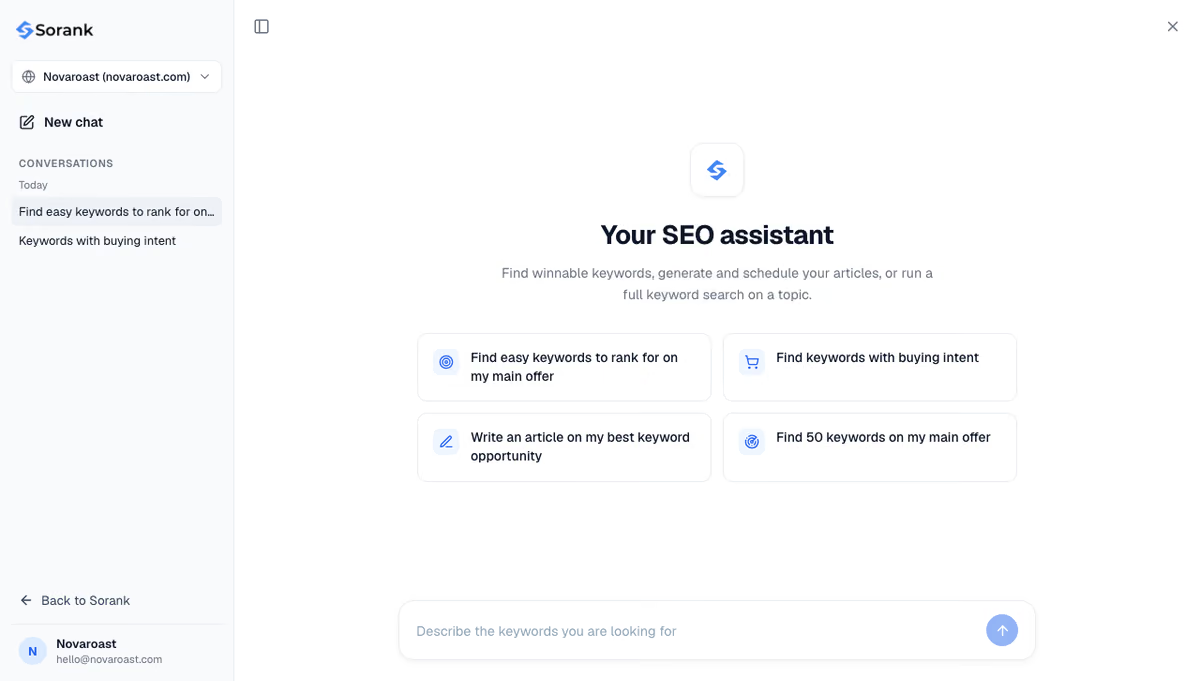
Sorank er vores produkt: et autopilot-software til SEO og GEO. Udviklere møder det oftest gennem integrationerne: det udgiver artikler til WordPress, Shopify, Webflow eller Wix, eller til en egen løsning via et webhook, som beskrevet på installationssiden. Dets SEO-chat besvarer spørgsmål om dit site i en samtale, og overvågning af AI-omtaler kontrollerer hver måned, om ChatGPT, Claude og Gemini citerer dit brand.
Kort version: lever komplet HTML, ærlige statuskoder og korrekte head-tags fra serveren, og mål derefter ydeevnen hos reelle brugere. Det betjener Googlebot og de AI-crawlere, der ikke kører JavaScript. For at fylde et veldesignet site med indhold, der rangerer, se Sorank's priser, fra 49$ pr. måned med en gratis prøveperiode på 3 dage.

Ikke altid for Google, som renderer JavaScript, men det tilføjer forsinkelse og risiko, og de fleste AI-crawlere kører slet ikke JavaScript. For sider, der skal rangere eller blive citeret, skal du levere hovedindholdet og links i den første HTML med server-side rendering, statisk generering eller prerendering, og beholde rendering på klientsiden til de interaktive dele.
Begge fortæller Google, at siden er væk, og Google holder med tiden op med at bruge URL'en i begge tilfælde. En 410 angiver, at fjernelsen er bevidst og permanent, hvilket nogle teams foretrækker for indhold, de har slettet med vilje. Det vigtigste er at undgå at returnere en 200 med en fejlbesked, fordi det skaber bløde 404-fejl.
De er en del af Googles signaler om sideoplevelse, som Google beskriver som en faktor blandt mange, hvor relevans og indholdskvalitet vejer tungere. I praksis fungerer de som en afgørelse mellem ens sider og har en stærk effekt på konverteringer, så det er umagen værd at opfylde tærskelværdierne.
Vi analyserer dine konkurrenter, dit website og din synlighed i AI for at lave en skræddersyet indholdsplan gratis.
 AI-generator til indholdsbrief
 FAQ-schemagenerator
 AI-generator til blogidéer
 Validator for struktureret data (schema-validator)
 Tjek af alt-tekst
 Analyse af interne links
 Backlink-udfordringen
 AI-generator til metabeskrivelser
 AI-generator til blogtitler
 Tjek af indekserbarhed
 AI-generator til blogdispositioner
 UTM-linkgenerator
 Værktøj til søgeordsclustering
 Tjek af canonical-tag
 XML-sitemap-generator
 Tjek af ødelagte links
 AI-generator til SEO-titler
 Overskriftsanalysator
 SERP-forhåndsvisning
 Redirect-tjekker
 Hreflang-generator
 Overskriftsanalysator
 HTTP-headertjekker
 Favicon-udtrækker
 SERP CTR-beregner
 Beregner for besparelse ved SEO vs. betalt søgning
 Beregner af SEO-synlighedsandel
 Beregner af SEO-afkast
 Beregner af SEO-trafik- og omsætningsprognose
 Beregner af SEO-budget
 Beregner af SEO-break-even
 Beregner af SaaS-SEO-afkast
 Beregner af ROAS
 Beregner af læsetid
 Simulator for placeringsgevinst
 Beregner for værdi af organisk trafik
 Estimator for organisk trafik og tjek af webstedstrafik
 Beregner for LTV/CAC-forhold
 Beregner for lokal SEO-afkast
 Beregner for linkbuilding-omkostninger
 Beregner for søgeordsværdi
 Beregner for søgeordsmulighed
 Beregner for nøgleordstæthed
 Beregner for GEO-ROI
 Beregner for investering i GEO-indhold
 Ecommerce SEO-ROI-beregner
 Beregner for kundens levetidsværdi
 CAC-beregner
 Beregner for CTR
 Beregner for omkostning pr. artikel
 Beregner for konverteringsrate
 Beregner for ROI på content marketing
 Estimator for henvisningstrafik fra ChatGPT
 Beregner for bounce rate
 Beregner for backlinks ROI
 Beregner for AI-synlighedsscore
 AI-trafikværdi-beregner
 AI-share of voice-beregner
 Beregner for omkostningen ved AI-usynlighed
 AI-citationsrate-beregner
 llms.txt-validator
 AI Overview-tjekker og rangeringstjekker for AI Overviews
 Robots.txt-tjekker
 AI-SEO-audit
 LLM-læsbarhedstjek
 SearchGPT-klartjek
 LLM-audit af strukturerede data
 AI-crawlbarhedsaudit for websites
 Hvorfor anbefaler ChatGPT ikke mit website?
 Gemini-rangeringsværktøj
 Perplexity-placeringstjek
 LLM-citeringstjek
 AEO-audit
 GEO-audit
 Test af synlighed i AI-søgning
 Tjek af ChatGPT-synlighed
 llms.txt-generator
 URL-udtrækker
 Webside til Markdown
 Sitemap-tjek
 SERP-volatilitetsmåler
 Sidestørrelsestjek
 Ordtæller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Metatag-generator
 Billedkompressor
 Favicon-generator
 On-page SEO-audit: SEO-tjek og SEO-analyse
 Backlinkanalyseværktøj
 Værktøj til søgeordsanalyse
 Domain Authority-tjek
DE PRØVEDE SORANK, FØR DU GJORDE DET
 “Jeg testede Sorank på en rigtig kundes site, og det er vanvittigt. Det gør alt, et bureau ville opkræve dig 1500 dollar om måneden for. Det går nu i produktion på den kunde.”

 Guillaume Guersanguersanguillaume.com“Vi er et annoncebureau, og vi ville have vores SEO på rette spor en gang for alle. Sorank gav os et klart overblik over vores site, hjalp os med at prioritere optimeringer og strukturere vores indhold ordentligt. Værktøjet er nemt at bruge, velegnet til et team og meget praktisk til at samle opfølgningen et sted uden at jonglere med flere platforme. Et meget solidt fundament til at starte forfra med vores SEO.”
 Gaspard MadouiAnnoncebureau
 “Jeg lod bare Sorank-softwaren gøre sit arbejde, og nu er min DR 25, og min side rangerer højere.”
 Lucas Flandrefoundertrace.fr“Jeg specialiserede mig i GEO takket være Sorank. GEO-ranglisten gør det muligt at vise mine kunder deres placering i forhold til konkurrenterne på ChatGPT. Det er en reel kommerciel fordel.”
 MélanieSEO-freelancer“Fantastisk service, den virker godt til vores hjemmeside og hjælper os med at forstå, hvordan vi kan forbedre den for at rangere bedre på Google og andre steder. Tillykke, bliv ved, jeg anbefaler det.”
 Hugo T.Netbutiksejer