Innstillinger
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

SEO for utviklere: slik gjengir du sider som crawlere kan lese, returnerer riktige HTTP-koder, legger inn de viktigste head-taggene, består Core Web Vitals og er synlig for AI.

Verktøy

Kort fortalt
For en utvikler betyr SEO at hver viktig side kan nås, gjengis og er entydig for crawlere. Legg hovedinnholdet i den første HTML-en (server-side rendering eller statisk generering), returner ærlige HTTP-statuskoder, legg tittel, metabeskrivelse, canonical og robots-direktiver i serversvaret, lenk med ekte <a href>-elementer, oppfyll terskelverdiene for Core Web Vitals og legg til strukturerte data i JSON-LD. De fleste AI-crawlere kjører ikke JavaScript, så innhold som først vises når JavaScript kjører, er usynlig for ChatGPT, Claude og Perplexity.
Vil du vite mer? Spør
Rask quiz
Passer SEO for deg, og hvordan bør du starte?
Sorank passer til svarene dine


Prøv det i 3 dager på ditt eget nettsted, og se hvor du står på Google, ChatGPT og de andre AI-assistentene.
Start en gratis prøveperiode på 3 dager3 dager gratis, deretter kan du stoppe når du vil. Resultatgaranti i 90 dager, ellers pengene tilbake.
SEO for utviklere er den delen av søkeoptimaliseringen som ligger i koden: maler, ruting, gjengivelse, headere og ytelse. Markedsførere velger søkeord og skriver innhold, men en feil statuskode, en rute som bare finnes på klientsiden eller en tilfeldig noindex kan viske ut alt dette i ett enkelt lanseringsløp. Googles egen grunnleggende om JavaScript-SEO beskriver tre faser (crawling, gjengivelse og indeksering), og hver av dem har feilmønstre som bare utviklere kan rette. Denne guiden dekker dem i den rekkefølgen de går i stykker.
| Område | Ansvar for utvikleren | Typisk symptom når det går galt |
|---|---|---|
| Gjengivelse | Hovedinnhold og lenker finnes i HTML-en fra serveren | Sider indeksert med tomt eller delvis innhold |
| Statuskoder | 200, 301, 404, 410 og 5xx returneres riktig | Myke 404-feil, feilsider indeksert, slettede sider rangerer fortsatt |
| Head-tagger | Unik tittel, beskrivelse, canonical, robots og hreflang | Duplikater, feil URL rangerer, sider mangler i indeksen |
| Crawlstyring | robots.txt, XML-sitemap, interne lenker, parametere | Viktige sider blir ikke oppdaget, crawling bortkastet på filtre |
| Ytelse | Core Web Vitals hos ekte brukere på mobil | Dårlig sideopplevelse, lavere konverteringer |
| Strukturerte data | Gyldig JSON-LD som stemmer med synlig innhold | Ingen rike resultater, forvirring om entiteter |
| AI-tilgang | Tillatte AI-brukeragenter, innhold som kan leses uten JavaScript | Merkevaren mangler i svar fra ChatGPT og Perplexity |
Googlebot kjører JavaScript, men i et eget steg som kan bli forsinket, og Google selv skriver at «server-side eller forhåndsgjengivelse fortsatt er en god idé» fordi det er raskere for brukere og crawlere, og fordi ikke alle roboter kjører JavaScript. Det siste punktet betyr mer enn noensinne: i analysen The rise of the AI crawler fra desember 2024 fant Vercel at «ingen av de store AI-crawlerne gjengir JavaScript i dag», og nevner GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot og PerplexityBot blant andre. Gemini, som bruker Googles infrastruktur, er unntaket.
| Gjengivelsesmodus | Hva crawlere får | Passer for SEO |
|---|---|---|
| Client-side rendering (CSR) | Et nesten tomt HTML-skall, med innhold når JavaScript kjører | Svakt: forsinket for Google, usynlig for de fleste AI-crawlere |
| Server-side rendering (SSR) | Full HTML ved hver forespørsel | Sterkt for dynamiske sider |
| Statisk generering (SSG) | Full HTML bygget ved utrulling | Sterkest for innhold som sjelden endres |
| Inkrementell regenerering (ISR) | Statisk HTML oppdatert etter tidsplan eller ved behov | Sterkt for store kataloger og blogger |
To regler gjelder uansett rammeverk. Lenker må være <a>-elementer med et href-attributt: Google sier at den bare kan oppdage lenker i den formen, så knapper med klikkbehandlere og ruter med fragmenter er blindveier. Og hver rute trenger sin egen URL, uten #, som returnerer innholdet direkte. Våre guider til JavaScript-SEO, SEO for single-page-applikasjoner og Next.js-SEO går nærmere inn på rammeverkspesifikke detaljer.
Statuskoder er instrukser til crawlere. Googles dokumentasjon om HTTP-statuskoder og nettverksfeil beskriver hvordan hver gruppe håndteres:
Sjekk hva serveren faktisk sender med en kontroll av HTTP-headere, og hold omdirigeringskjeder til ett hopp. Artikkelen vår om SEO-omdirigeringer dekker migreringsmønstre.
Hver side som kan indekseres trenger en unik tittel og beskrivelse, en canonical som peker til seg selv, og på flerspråklige nettsteder hreflang-annoteringer. Behold dem i serversvaret:
<title>Løpesko for flate føtter | Eksempel</title>
<meta name="description" content="Testede valg, størrelser og priser.">
<link rel="canonical" href="https://example.com/running-shoes-flat-feet">
<link rel="alternate" hreflang="fr" href="https://example.com/fr/chaussures-pieds-plats">
<meta name="robots" content="index, follow">
Den canonical-taggen må peke på URL-en du vil skal rangere, med nøyaktig protokoll, vert og skråstrek-konvensjon slik nettstedet ditt bruker dem.
Vær oppmerksom
Stol aldri på JavaScript for å fjerne en noindex. Google sier at når den finner en noindex-tagg, kan den hoppe over gjengivelsen. En side som sender noindex i HTML-en og fjerner den på klientsiden, kan derfor bli værende utenfor indeksen.
Søkemotorer indekserer URL-er, så URL-strukturen er en SEO-beslutning. Bruk små bokstaver, bindestreker og lesbare stier. Velg én konvensjon for skråstrek til slutt og omdiriger den andre, og ha én URL per innhold. Filtre, sortering og sporingsparametere multipliserer URL-er uten å legge til innhold: sett canonical til den rene versjonen, og lenk ikke til parameterkombinasjoner du ikke vil skal crawles.
Interne lenker bærer både oppdagelse og viktighet. Gjengi navigasjon, brødsmuler og blokker med relatert innhold på serveren, gi paginerte lister vanlige lenker til hver side, og unngå endeløs rulling uten paginerte URL-er bak. Et produkt eller en artikkel som bare kan nås via søk på nettstedet eller et JavaScript-filter, er for en crawler en foreldreløs side.
robots.txt styrer crawling, ikke indeksering: en blokkert URL kan fortsatt dukke opp i resultatene hvis andre sider lenker til den. For å holde en side ute av indeksen må du la den crawles og returnere noindex. Generer XML-sitemapet fra rutene eller databasen, list bare canonical URL-er med status 200, og oppdater lastmod bare når innholdet faktisk endres. Test reglene med en robots.txt-sjekker før hver utrulling, og legg aldri en robots.txt fra staging med «Disallow: /» ut i produksjon.
Google bruker Core Web Vitals som en del av sine signaler for sideopplevelse. Ifølge web.dev er en side god når den oppfyller disse terskelverdiene på 75. persentil av ekte sideinnlastinger, på mobil og desktop:
| Måling | Måler | God terskel | Vanlige tiltak for utviklere |
|---|---|---|---|
| LCP (Largest Contentful Paint) | Lasting | 2,5 s eller mindre | Forhåndslast heltebildet, server-rendre innhold over brettet, bruk CDN |
| INP (Interaction to Next Paint) | Respons | 200 ms eller mindre | Del opp lange oppgaver, utsett tredjepartsskript, reduser kostnaden for hydrering |
| CLS (Cumulative Layout Shift) | Visuell stabilitet | 0,1 eller mindre | Sett bredde og høyde på medier, reserver plass til annonser og innebygde elementer |
INP erstattet First Input Delay som stabil Core Web Vital i 2024. Bruk feltdata (Search Console, Chrome UX Report) for å vurdere, og laboratorieverktøy for å feilsøke. Vårt oppslag om Core Web Vitals lister verktøyene.
Bruk JSON-LD i en script-tagg, gjengitt på serveren, som beskriver det som er synlig på siden:
<script type="application/ld+json">
{"@context": "https://schema.org", "@type": "Article",
 "headline": "Løpesko for flate føtter",
 "datePublished": "2026-10-01",
 "author": {"@type": "Person", "name": "Jane Doe"}}
</script>
Generer det fra de samme dataene som siden, så de aldri går fra hverandre, valider det i CI, og unngå å injisere det via en taggbehandler. En skjemagenerator gir en startmal for vanlige typer.
Tips
Legg SEO-kontroller inn i pipelinen: la bygget feile hvis en indekserbar mal mangler tittel eller canonical, hvis en rute returnerer 200 for et ukjent slug, eller hvis produksjonens robots.txt inneholder «Disallow: /». Slike regresjoner er billige å fange før utrulling og dyre etterpå.
AI-synlighet starter med tilgang. Bestem hvilke AI-brukeragenter du tillater (GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot med flere), og skriv eksplisitte regler i robots.txt. Guiden vår om robots.txt for AI-crawlere forklarer forskjellen mellom trenings- og søkeroboter. Sørg så for at tekst, priser, spesifikasjoner og FAQ finnes i den første HTML-en, bruk semantiske overskrifter og tabeller i stedet for bilder av tekst, og hold sidene lette nok til å hentes raskt. En llms.txt-fil kan oppsummere hovedsidene dine for AI-verktøy, men ingen større assistent har bekreftet at den brukes, så betrakt den som valgfri.
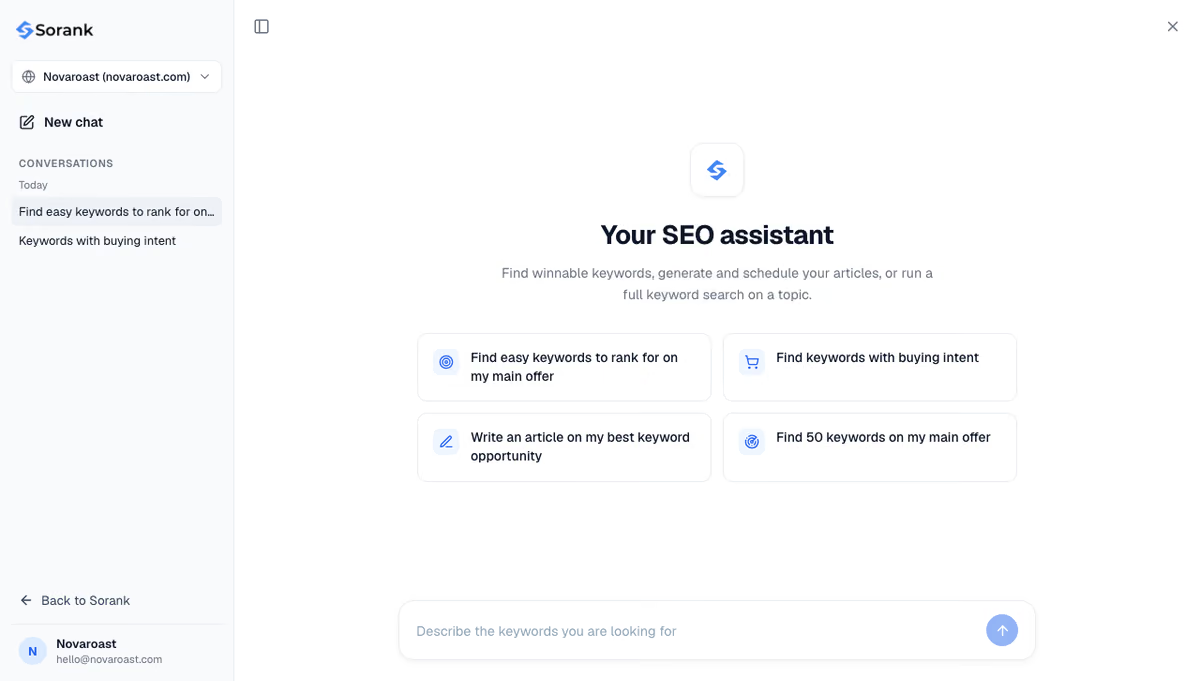
Sorank er vårt produkt: en SEO- og GEO-programvare med autopilot. Utviklere møter det mest gjennom integrasjonene: det publiserer artikler til WordPress, Shopify, Webflow eller Wix, eller til en egen løsning via en webhook, slik det beskrives på installasjonssiden. SEO-chatten svarer på spørsmål om nettstedet ditt i samtaleform, og AI-omtalesporing sjekker hver måned om ChatGPT, Claude og Gemini siterer merkevaren din.
Kort sagt: send komplett HTML, ærlige statuskoder og riktige head-tagger fra serveren, og mål deretter ytelsen hos ekte brukere. Det betjener Googlebot og de AI-crawlerne som ikke kjører JavaScript. For å fylle et godt bygget nettsted med innhold som rangerer, se Sorank-abonnementene, fra $49 per måned med en gratis prøveperiode på 3 dager.

Ikke alltid for Google, som kjører JavaScript, men det gir forsinkelse og risiko, og de fleste AI-crawlere kjører ikke JavaScript i det hele tatt. For sider som skal rangere eller bli sitert, legg hovedinnholdet og lenkene i den første HTML-en med server-side rendering, statisk generering eller forhåndsgjengivelse, og behold gjengivelse på klientsiden for de interaktive delene.
Begge forteller Google at siden er borte, og Google slutter etter hvert å bruke URL-en uansett. En 410 sier at fjerningen er bevisst og permanent, noe enkelte team foretrekker for innhold de slettet med vilje. Det viktigste er å ikke returnere en 200 med en feilmelding, for det skaper myke 404-feil.
De er en del av Googles signaler for sideopplevelse, som Google beskriver som én faktor blant mange, der relevans og innholdskvalitet veier tyngst. I praksis fungerer de som en avgjørelse mellom like sider, og de har stor effekt på konverteringer, så det er verdt innsatsen å nå terskelverdiene.
Vi analyserer konkurrentene dine, nettstedet ditt og synligheten din i AI for å lage en skreddersydd innholdsplan, gratis.
 KI-generator for innholdsbrief
 Generator for FAQ-schema
 Generator for blogg-ideer med AI
 Validator for strukturerte data (schema-validator)
 Sjekk av alt-tekst
 Analyse av interne lenker
 Lenkeutfordringen
 KI-generator for metabeskrivelser
 KI-generator for bloggtitler
 Indekserbarhetssjekker for Google
 KI-generator for bloggdisposisjon
 Generator for UTM-lenker
 Verktøy for gruppering av søkeord
 Sjekk av kanonisk tagg
 XML-sitemap-generator
 Sjekk av ødelagte lenker
 KI-generator for SEO-tittel
 Overskriftsanalyse
 SERP-forhåndsvisning
 Kontroll av omdirigeringer
 Generator for hreflang-tagger
 Analyse av overskriftsstruktur
 Kontroll av HTTP-headere
 Favikon-henter
 SERP CTR-kalkulator
 Sparekalkulator: SEO mot betalt søk
 Kalkulator for SEO-synlighetsandel
 ROI-kalkulator for SEO
 SEO-prognosekalkulator for trafikk og inntekter
 SEO-budsjettkalkulator
 SEO-nullpunktkalkulator
 ROI-kalkulator for SaaS-SEO
 ROAS-kalkulator
 Lesetidskalkulator
 Simulator for rangeringsgevinst
 Kalkulator for verdien av organisk trafikk
 Estimator for organisk trafikk og sjekk av nettstedstrafikk
 Kalkulator for LTV til CAC-forhold
 Kalkulator for avkastning på lokal SEO
 Kalkulator for kostnad ved lenkebygging
 Kalkulator for søkeordverdi
 Kalkulator for poengsum for søkeordmuligheter
 Kalkulator for tetthet av søkeord
 Kalkulator for GEO-avkastning
 Kalkulator for investering i GEO-innhold
 Kalkulator for SEO-avkastning i netthandel
 Kalkulator for kundens levetidsverdi
 Kalkulator for kundeanskaffelseskostnad
 CTR-kalkulator
 Kalkulator for kostnad per artikkel
 Kalkulator for konverteringsrate
 Kalkulator for ROI i innholdsmarkedsføring
 Estimator for ChatGPT-trafikk
 Kalkulator for avvisningsrate
 Kalkulator for backlink-ROI
 Kalkulator for AI-synlighetspoeng
 Kalkulator for verdien av AI-trafikk
 Kalkulator for AI-synlighetsandel
 Kalkulator for kostnaden av AI-usynlighet
 Kalkulator for AI-siteringsrate
 llms.txt-validator
 AI Overview-sjekker og rangeringssjekker for AI Overviews
 Robots.txt-sjekker
 KI-SEO-revisjon
 Sjekk av lesbarhet for LLM
 Sjekk av klargjøring for SearchGPT
 Revisjon av strukturerte data for LLM
 KI-revisjon av crawlbarhet
 Hvorfor ChatGPT ikke anbefaler nettstedet mitt
 Gemini-rangeringsverktøy
 Sjekk av rangering i Perplexity
 Sjekk av LLM-sitater
 AEO-revisjon
 GEO-revisjon
 Test av synlighet i AI-søk
 Sjekk av synlighet i ChatGPT
 llms.txt-generator
 URL-uttrekker
 Nettside til Markdown
 Sjekk av sitemap
 Sensor for SERP-volatilitet
 Sidestørrelsessjekk
 Ordteller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Generator for metatagger
 Bildekomprimerer
 Favicon-generator
 Revisjon av on-page SEO: SEO-sjekk og SEO-analyse
 Verktøy for analyse av tilbakelenker
 Verktøy for søkeordforslag
 Sjekk av domeneautoritet
DE PRØVDE SORANK FØR DEG
 “Jeg testet Sorank på et ekte kundenettsted, og det er helt utrolig. Det gjør alt et byrå ville tatt deg $1500 i måneden for. Nå går det i produksjon på den kunden.”

 Guillaume Guersanguersanguillaume.com“Vi er et annonsebyrå, og vi ville få SEO-en vår på rett spor en gang for alle. Sorank ga oss en tydelig oversikt over nettstedet vårt, hjalp oss å prioritere optimaliseringene og å strukturere innholdet vårt på riktig måte. Verktøyet er enkelt å bruke, godt utformet for et team, og veldig praktisk for å samle oppfølgingen på ett sted uten å jonglere med flere plattformer. Et veldig solid grunnlag for å starte på nytt med SEO.”
 Gaspard MadouiAnnonsebyrå
 “Jeg lot bare Sorank-programvaren gjøre jobben sin, og nå er DR-en min 25, og siden min rangerer høyere.”
 Lucas Flandrefoundertrace.fr“Jeg spesialiserte meg på GEO takket være Sorank. GEO-rangeringen lar meg vise kundene mine hvor de står mot konkurrentene på ChatGPT. Det er en reell kommersiell fordel.”
 MélanieSEO-frilanser“Kjempebra service, den fungerer godt for nettstedet vårt og hjelper oss å forstå hvordan vi kan forbedre det for å rangere bedre på Google og andre steder. Gratulerer, fortsett slik, jeg anbefaler det.”
 Hugo T.Netthandler