העדפות
הפרטיות חשובה לנו, ולכן יש לך אפשרות להשבית סוגים מסוימים של אחסון שייתכן שאינם נחוצים לתפקוד הבסיסי של האתר. חסימת קטגוריות עלולה להשפיע על חווית השימוש שלך באתר. מידע נוסף

הפרטיות חשובה לנו, ולכן יש לך אפשרות להשבית סוגים מסוימים של אחסון שייתכן שאינם נחוצים לתפקוד הבסיסי של האתר. חסימת קטגוריות עלולה להשפיע על חווית השימוש שלך באתר. מידע נוסף

הכינו את אתר Lovable שלכם לקידום אורגני ולאופטימיזציית GEO. תקנו בעיות רינדור של React SPA, כך שהתוכן שלכם ייסרק ויצוטט על ידי Google, ChatGPT, Perplexity וכן Claude.






מקורות
רוצים להפוך את אתר Lovable שלכם לגלוי בחיפוש מבוסס AI ובחיפוש המסורתי? אתם ניצבים מול אתגר אמיתי. Lovable יוצרת אפליקציות React מלאות (full-stack) באמצעות React 18, TypeScript, Vite, Tailwind CSS וכן shadcn/ui, כאשר צד השרת מופעל על ידי Supabase. אף שהמחסנית המודרנית הזו מייצרת חוויות משתמש מצוינות, היא יוצרת חסמים משמעותיים לגילוי על ידי מנועי חיפוש וסורקי AI. במדריך הזה תלמדו בדיוק למה אתרי Lovable מתקשים בקידום אורגני (SEO) ובאופטימיזציית GEO, בגיבוי נתונים, ואיך לתקן זאת.
Lovable בונה כל אתר כאפליקציית עמוד יחיד (SPA) של React עם רינדור בצד הלקוח (CSR). כשסורק מבקר באתר שלכם, הוא מקבל מעטפת HTML כמעט ריקה, רק <div id="root"></div>, וחייב להריץ JavaScript כדי לראות את התוכן האמיתי שלכם. הנה הבעיה: רוב סורקי AI כלל אינם מריצים JavaScript.
לפי המחקר של Vercel על סורקי AI, ניתוח של 500 מיליון בקשות ויותר של GPTBot לא מצא שום עדות להרצת JavaScript. הדבר נכון גם לגבי ClaudeBot (של Anthropic), PerplexityBot וסורקי AI נוספים: הם מורידים רק HTML סטטי ועוקפים לחלוטין את JavaScript. המשמעות היא שתוכן אתר Lovable שלכם בלתי נראה לחלוטין עבור ChatGPT, Claude, Perplexity ומערכות AI אחרות.
היקף הבעיה עצום. נתוני Cloudflare מראים שסורקי AI מבצעים כיום פי 3.6 יותר בקשות מסורקי חיפוש מסורתיים. GPTBot של OpenAI לבדו מייצר 569 מיליון בקשות בחודש ברשת של Vercel, ואילו ClaudeBot של Anthropic מגיע אחריו עם 370 מיליון. אם האתר שלכם לא יכול להיקרא על ידי הבוטים האלה, אתם מפספסים את ערוץ הגילוי הצומח ביותר ברשת.
גם Google, הסורק הגדול היחיד שמסוגל לרנדר JavaScript במלואו, מאנדקסת דפים כבדי JavaScript לאט פי 9 בערך בהשוואה לדפי HTML סטטיים. Google משתמשת בתהליך אינדוקס דו-שלבי: קודם היא סורקת HTML גולמי, ורק אחר כך מכניסה את הדף לתור לרינדור, מה שעלול להביא לכך שהתוכן שלכם ימתין ימים ולא שעות עד שיופיע בתוצאות החיפוש. Google הכריזה רשמית על הוצאה משימוש של רינדור דינמי כפתרון ארוך טווח, ובכך אותתה שאתרים חייבים לטפל בקידום האורגני של אתרי JavaScript כבר במקור, באמצעות יישום נכון של SSR.
באתרי Lovable זה יוצר עונש כפול: אינדוקס איטי אצל Google וגם אפס נראות בחיפוש מבוסס AI. המתחרים שלכם שמשתמשים במסגרות עבודה עם רינדור בצד השרת מאונדקסים מהר יותר ומצוטטים על ידי מערכות AI, בעוד האפליקציה שלכם, מסוג React SPA, נשארת בחושך.
המחסנית הטכנולוגית של Lovable מתועדת היטב בתיעוד הרשמי שלה. כל פרויקט משתמש בדברים הבאים:
צד לקוח (Frontend): React 18 + TypeScript, נבנה באמצעות Vite, מעוצב באמצעות Tailwind CSS וכן shadcn/ui (רכיבי Radix UI), עם React Router v6 לניווט וכן React Context API לניהול מצב.
צד שרת (Backend): Supabase מספקת מסד נתונים PostgreSQL, אימות (אימייל, Google, GitHub), אחסון קבצים, וכן Edge Functions (JavaScript/TypeScript). לא נוצר שרת מותאם אישית.
פריסה (Deployment): הקוד מסונכרן אל GitHub עם בעלות מלאה. פרסו אל תתי-דומיינים של Lovable, אל Vercel, אל Netlify או אל שרתים מותאמים אישית.
הבעיה הקריטית היא שהכלי Vite מגיש מעטפת HTML מינימלית ומאפשר לספריית React לבצע הידרציה לכל התוכן בצד הלקוח. אין רינדור מובנה בצד השרת. Lovable מודה במגבלות האלה בתיעוד שלה בנושא SEO וגם GEO, ומציינת שאינדוקס יכול לקחת ״ימים במקום שעות״ ושתצוגות מקדימות ברשתות חברתיות שבורות כברירת מחדל.
יש שלוש גישות עיקריות כדי להפוך את אתר Lovable שלכם לניתן לסריקה, ולכל אחת מהן פשרות שונות:
1. הוספת SSR באמצעות מסגרת Vike: Vike מאפשרת להוסיף רינדור בצד השרת לאפליקציית React הקיימת שלכם מבית Lovable בלי לארגן מחדש את הקוד. שמרו על React Router וקבלו את מלוא היתרונות של קידום אורגני. מוסיפים 4 קבצי עטיפה, רנדרר ושרת Express, בעוד תיקיית src/ נשארת ללא שינוי. תכונת wildcard route של Vike מעבירה את כל הניתוב אל React Router, ואילו Vike מטפלת ברינדור בצד השרת.
2. יצירת אתר סטטי (SSG): צרו נקודת כניסה לשרת (src/entry-server.tsx) באמצעות renderToString של React ובנו את חבילות הלקוח והשרת באמצעות מצב SSR של Vite. כך הדפים מרונדרים מראש בזמן הבנייה, ונוצרים קובצי HTML סטטיים שכל סורק יכול לקרוא מיד. מתאים ביותר לאתרים עתירי תוכן עם כתובות צפויות.
3. מעבר אל Next.js: ביישומים קריטיים לייצור, מעבר מהמחסנית Vite+React אל Next.js מעניק לכם SSR, SSG וכן ISR (Incremental Static Regeneration) כיכולות מובנות. שירותים כמו NextLovable מתמחים בהמרת פרויקטי Lovable אל Next.js 15 עם תמיכה מלאה בקידום אורגני.
בלי קשר לפתרון הרינדור שתבחרו, היסודות האלה חלים על כל פרויקט Lovable:
ודאו שכל נתיב מרכזי מחזיר HTML שמציג את התוכן קודם. ודאו שהניווט הראשי מבוסס טקסט ונמצא בקוד המקור, ולא מוזרק רק על ידי קוד בצד הלקוח. ספקו מפת אתר XML מלאה, הגישו אותה דרך Google Search Console, ושמרו על קובץ robots.txt שמאפשר סריקה של CSS/JS הנדרשים לרינדור. בחרו slugs נקיים ותיאוריים והחזירו קודי סטטוס HTTP נכונים בכל הנתיבים.
טפלו בבינאום באמצעות hreflang ומנעו כפילויות באמצעות תגיות canonical. באתרי Lovable עתירי מדיה, השתמשו בטעינה עצלה (lazy-load) באחריות והוסיפו מאפייני width/height כדי להימנע מקפיצות פריסה. כווצו CSS/JS והטמיעו CSS קריטי בתוך הדף כדי לשמור על Core Web Vitals.
התייחסו לכל דף כאל מסמך ממוקד סביב ישות. השתמשו בכותרת H1 אחת שמשקפת את כוונת החיפוש, בכותרות H2/H3 מובנות ובפסקאות תמציתיות וקלות לסריקה. כתבו הגדרות, השוואות ומדריכים שלב אחר שלב שתואמים להתנהגות של חיפוש תשובות. שלבו שמות ישויות, מאפיינים וקשרים בצורה טבעית כדי שהמודלים יוכלו לשלב את המותג שלכם בהבנת גרף הידע (Knowledge Graph) שלהם.
הוסיפו נתונים מובנים מקיפים לסוג התוכן שלכם: Organization, WebSite, WebPage, Article, Product, Service, FAQPage, BreadcrumbList, וכן Review היכן שרלוונטי. כללו קישורי sameAs לפרופילים סמכותיים. בתוך Lovable, הוסיפו JSON-LD בחלק <head> של האפליקציה באמצעות React Helmet או ספרייה דומה. לצורך תכנון, התחילו את הנושאים עם המדריך שלנו לסוכנויות בנושא SEO וגם GEO, ואז השתמשו במחקר מילות מפתח והרחיבו את האשכולות באמצעות מחולל אשכולות נושאיים.
GEO (אופטימיזציה לבינה מלאכותית גנרטיבית) עניינו להיות המקור שמערכות AI בוחרות לצטט. בנו את הדפים שלכם לתשובות ישירות: סיכומים קצרים וניתנים לציטוט ואחריהם עומק שאפשר להרחיב. השתמשו בטענות מפורשות עם תאריכים, מספרים ומקורות. כל טענה צריכה להיות מגובה בציטוטים יוצאים אל מקורות אמינים ובקישורים פנימיים אל הסברי יסוד כדי לחזק את הסמכות הנושאית.
התובנה המרכזית ממחקר Search Engine Journal היא שהסריקה של ChatGPT גדולה כיום פי 3.6 מזו של Googlebot. אם אתר Lovable שלכם מרונדר בצד השרת, אתם ממוקמים ללכוד את התנועה הצומחת הזו. אם לא, אתם בלתי נראים בערוץ הגילוי הצומח ביותר. כדי להרחיב את כיסוי הפרומפטים, נתחו אסטרטגיות SEO עבור YouTube ובנו אב-טיפוס של שאילתות באמצעות query fan out של מילות מפתח עבור AI.
כללו הקשר קריא למכונה: סכמת Organization עם sameAs לפרופילים מרכזיים ועמוד אודות יציב. פרסמו ביוגרפיות של כותבים עם הסמכות כדי לחזק את E-E-A-T. השתמשו במילונים למונחי ליבה כמו הגדרות SEO מול GEO, מודלים מעדיפים מינוח עקבי וחד-משמעי.
מערכות AI מעדיפות מקורות מהירים, יציבים ואמינים. תהליך הבנייה של Lovable המבוסס על Vite כבר מספק ביצועי פיתוח טובים, אך אופטימיזציה לסביבת ייצור דורשת תשומת לב. בדקו את גודל מעטפת האפליקציה וחלקו את הקוד באגרסיביות כדי להימנע מחסימת התהליך הראשי. שאפו ליעדים הבאים בנייד: LCP שאינו עולה על 2.5 שניות, CLS שאינו עולה על 0.1 וכן INP שאינו עולה על 200 אלפיות השנייה.
צמצמו את נפח הקוד של JavaScript באמצעות פיצול נתיבים עם React.lazy() וכן Suspense. טענו מראש את הגופנים החשובים ואחדו תגיות של צד שלישי. אינדוקס שמתחיל בנייד (mobile-first indexing) אומר דבר אחד: Google מבינה את קוד HTML של גרסת הנייד שלכם, ולכן שמרו על זהות בין שולחן העבודה לנייד.
בזמן שמערכות AI מציגות תשובות, תוצאות עשירות ממשיכות להביא תנועה איכותית ולהזין מודלים בהקשר איכותי. הטמיעו סימון Product, HowTo, Event וכן JobPosting לפי הצורך. עבור מאמרים (Article), כללו author, datePublished וכן dateModified. אמתו באמצעות Rich Results Test של Google והתאימו את התוכן הגלוי שלכם לסימון.
הוסיפו תגיות Open Graph וכן Twitter Card: הן מעצבות את האופן שבו התוכן שלכם משותף, מקושר ונדון, אותות שמודלי שפה גדולים (LLM) קולטים בעקיפין. בתוך Lovable, הגדירו אותן בקובץ index.html או באופן דינמי באמצעות React Helmet עבור מטא-נתונים ייחודיים לכל דף.
מודלי שפה גדולים (LLM) נותנים עדיפות למותגים שהרשת כבר סומכת עליהם. בנו קישורים נכנסים (backlinks) איכותיים מפרסומים רלוונטיים, ספריות נישה וסיכומי מומחים, ועקבו במיוחד אחר ציטוטי AI באמצעות מעקב אחר אזכורי AI. חפשו אזכורים ללא קישור והמירו אותם לקישורים. פרסמו נתונים מקוריים, בצעו מחקרים קטנים ושתפו הדמיות כדי למשוך סיקור. עקבו אחר הצמיחה באמצעות מעקב סמכות דומיין.
עצבו דפים בגישת ״תשובה קודם״: תקציר של 2 עד 3 משפטים, הגדרה מרכזית ואז העמקה. ספקו אזורי TL;DR ותוכן שאלות נפוצות (FAQ) שמתאים לאופן שבו משתמשים מנסחים פרומפטים למערכות AI. הוסיפו עדכונים עם חותמת זמן ויומני שינויים לנושאים מתפתחים כדי לאותת על רעננות. לצורך קנה מידה, התחילו טיוטות באמצעות מחולל מאמרי בלוג ושפרו אותן עם העורכים שלכם.
צרו רכזי נושא בארכיטקטורת רכז וצירים (hub-and-spoke). כל רכז צריך לסכם את הנושא, לקשר אל צירים מעמיקים ולהחזיר קישורים הקשריים. זה מחזק את הכיסוי הנושאי ועוזר למודלים למפות את האונטולוגיה הפנימית שלכם. עקבו אחר שינויים בתוצאות החיפוש (SERP) ואחר מתחרים באמצעות מרגל מתחרי SEO.
אם המערך של Lovable שלכם משתמש בהגדרת ברירת המחדל עם רינדור בצד הלקוח, הנה תוכנית פעולה קונקרטית:
שלב 1: בדקו מה הסורקים רואים. הריצו curl -s https://yoursite.com | head -50 כדי לראות את קוד HTML הגולמי שמוגש. אם אתם רואים <div id="root"> ריק, הסורקים לא יכולים לקרוא את התוכן שלכם.
שלב 2: בחרו את פתרון הרינדור שלכם (Vike SSR, סקריפט בנייה של SSG או מעבר אל Next.js). ברוב פרויקטי Lovable, Vike SSR דורש את מאמץ ההגירה הנמוך ביותר.
שלב 3: ודאו זהות ברינדור. השוו בין הפלט שרואה אדם לפלט שרואה בוט באמצעות כלי בדיקת הכתובות (URL Inspection) של Google Search Console ובדקו באמצעות curl כדי לוודא שהתוכן, הקישורים הפנימיים וכן JSON-LD מופיעים באופן זהה.
שלב 4: הגישו את מפת האתר המעודכנת ועקבו אחר האינדוקס. עקבו אחר הנראות בתשובות AI באמצעות מעקב אחר אזכורי AI והשוו את הנישה שלכם בעזרת טבלת דירוג GEO.
מערכות AI לומדות מהרשת הרחבה. פרסמו תוכן באופן טבעי בפלטפורמות שבהן הקהל שלכם פעיל, והקפידו על מטא-נתוני Open Graph עקביים בכל הערוצים. הפיצו תוכן באחריות עם קישורי canonical חזרה אל מקור Lovable שלכם.
שקלו תיעוד ידידותי למפתחים, יומני שינויים ציבוריים וקובצי README: הם נקלטים לעיתים קרובות בתהליכי האימון של מודלי שפה גדולים. שמרו על קול מותג ברור ויציב כדי להפחית בלבול של המודלים. קבעו את קו הבסיס שלכם באמצעות כלי ביקורת GEO/SEO מקיף.
ההצלחה חורגת מדירוגים מסורתיים. עקבו אחר חשיפות, הקלקות וכן Core Web Vitals, ואז הוסיפו מדדי KPI לעידן הבינה המלאכותית: נתח התשובה בתוך AI Overviews, ציטוטים בתוך Perplexity ושאילתות ממותגות. רכזו את המעקב בלוח בקרה GEO/SEO, עקבו אחר אזכורי מותג באמצעות מעקב אחר אזכורי AI, והשוו בעזרת טבלת דירוג GEO.
אם אתם מתאמים הטמעות או הגירות בכמה מערכות CMS, הקפידו על זהות בין המערכות, כגון BigCommerce, Shopify, Webflow, WordPress, Wix, Squarespace וכן WooCommerce. אחדו את הנתונים המובנים, את מדיניות תגיות canonical ואת דפוסי הקישורים הפנימיים בכל המערך.
Lovable היא בונה אפליקציות עוצמתית מבוססת AI, מחינם ועד $50 לחודש, אך ארכיטקטורת React SPA שלה יוצרת פער יסודי באופטימיזציית SEO וגם GEO. כשסורקי AI מבצעים כיום פי 3.6 יותר בקשות מאשר Googlebot, ואף אחד מהם אינו מריץ JavaScript, מחיר ההתעלמות מהבעיה גדל מדי יום. תקנו את הרינדור, הוסיפו נתונים מובנים, בנו סמכות נושאית ועקבו אחר ציטוטי AI. אם תעשו זאת, אתר Lovable שלכם לא רק ידורג, הוא יהיה מוזכר בחיפוש מבוסס AI. כך מכינים את אתר Lovable שלכם לקידום אורגני ולאופטימיזציית GEO כדי להופיע בתוצאות AI.

Lovable יוצרת אפליקציות עמוד יחיד (SPA) של React עם רינדור בצד הלקוח. כשסורקי AI כמו GPTBot, ClaudeBot או PerplexityBot מבקרים באתר שלכם, הם מקבלים מעטפת HTML ריקה ואינם יכולים להריץ JavaScript כדי לראות את התוכן שלכם. הניתוח של Vercel, שכלל 500 מיליון בקשות ויותר של GPTBot, לא מצא שום עדות להרצת JavaScript. המשמעות היא שתוכן אתר Lovable שלכם בלתי נראה לחלוטין עבור ChatGPT, Claude, Perplexity ומערכות AI אחרות. הפתרון הוא ליישם רינדור בצד השרת (SSR) באמצעות מסגרות כמו Vike, יצירת אתר סטטי (SSG), או מעבר אל Next.js.
יש שלוש גישות עיקריות. ראשית, אפשר להשתמש במסגרת Vike כדי להוסיף SSR בלי לארגן מחדש את הקוד: היא עוטפת את מערך React Router הקיים שלכם בעזרת 4 קבצי עטיפה ושרת Express. שנית, אפשר ליישם יצירת אתר סטטי על ידי יצירת נקודת כניסה לשרת באמצעות renderToString של React ובנייה במצב SSR של Vite. שלישית, אפשר לעבור אל Next.js 15 לקבלת תמיכה מובנית ברינדור בצד השרת (SSR), ביצירת אתר סטטי (SSG) וכן ISR. התיעוד הרשמי של Lovable בכתובת docs.lovable.dev/tips-tricks/seo-geo עוסק גם בשיפורי SEO בסיסיים שאפשר לבצע בתוך הפלטפורמה.
SEO (אופטימיזציה למנועי חיפוש) מבטיח שאתר Lovable שלכם יתגלה, ייסרק וידורג על ידי Google. GEO (אופטימיזציה לבינה מלאכותית גנרטיבית) הופך את התוכן שלכם למובן, אמין וראוי לציטוט עבור מערכות AI כמו ChatGPT, Gemini וכן Perplexity. באתרי Lovable, שניהם דורשים לפתור קודם את בעיית הרינדור של JavaScript. ברגע שהסורקים יכולים לקרוא את קוד HTML שלכם, SEO מתמקד בנתונים מובנים, בתגיות מטא ובקישורים נכנסים (backlinks), ואילו GEO מתמקד בתוכן שמתחיל בתשובה, בטענות מפורשות עם מקורות ובבהירות ישויות. כשסורקי AI מבצעים פי 3.6 יותר בקשות מסורקי חיפוש מסורתיים (לפי נתוני Cloudflare), GEO הופך לחשוב כמו SEO.
הם ניסו את Sorank לפניכם
 “אנחנו סוכנות פרסום (Ads) ורצינו סוף סוף להחזיר את ה-SEO שלנו למסלול. Sorank נתנה לנו תמונה ברורה של האתר שלנו, עזרה לנו לתעדף אופטימיזציות ולבנות נכון את התוכן. הכלי קל לשימוש, מעוצב היטב לעבודת צוות, ומאוד מעשי לריכוז המעקב בלי לקפוץ בין מספר פלטפורמות. בסיס איתן מאוד לפתיחת דף חדש עם ה-SEO שלנו.”
 Gaspard Madouiסוכנות פרסום (Ads)“במשך שנתיים, 100% מהלקוחות שלי הגיעו מ-LinkedIn. פרסום יומי, תגובות, מעקבים בהודעות פרטיות... תלות מוחלטת באלגוריתם. ידעתי שאני צריך לעבוד על SEO אבל תמיד דחיתי את זה: ארוך מדי, טכני מדי, לא התחום שלי. עם Sorank, סוף סוף עשיתי את הצעד. בתוך 4 חודשים, אני מייצר 15 לידים אורגניים בחודש בלי לפרסם כלום. זה עדיין לא 50/50 מול LinkedIn, אבל אני ישן טוב יותר בידיעה שיש לי עכשיו מקור לידים שני שגדל באופן אוטומטי.”
 Valentin Thomyסוכנות ColdMailing
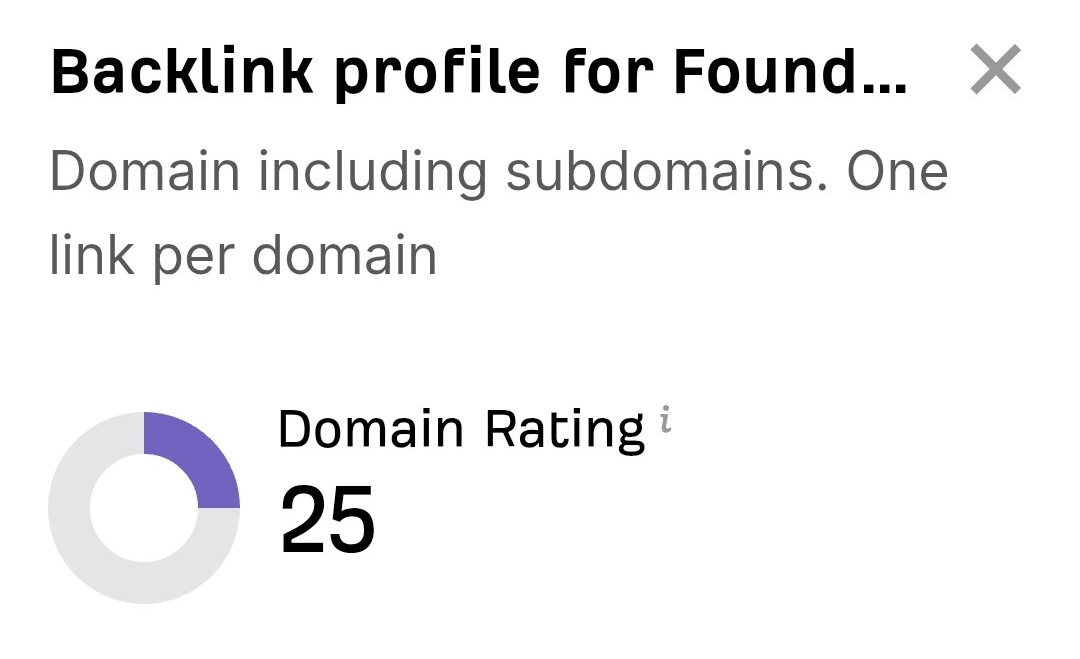 “פשוט נתתי לתוכנה של Sorank לעשות את שלה, ועכשיו ציון DR של האתר שלי הוא 25 והדף שלי מדורג גבוה יותר.”
 Lucas FlandrePodcast Host“פתרון מצוין לניהול SEO בלי כאב ראש. הביקורות מהירות, הממשק ברור, ואתה רואה במהירות אילו פעולות ליישם. זה הפך לכלי חיוני למעקב ולשיפור ה-SEO של האתרים שלי. ממליץ בחום.”
 Xavיזם