संक्षेप में: LLM SEO वह प्रक्रिया है जिससे आपका ब्रांड और आपके पेज ChatGPT, Gemini, Claude और Perplexity जैसे बड़े भाषा मॉडल के जवाबों में दिखें। ये मॉडल दो स्रोतों पर निर्भर करते हैं: जो उन्होंने प्रशिक्षण के दौरान सीखा, और जो सवाल पूछे जाने के समय वेब से खोजकर लाते हैं। पहले स्रोत पर आप वेब भर में आपके ब्रांड के व्यापक और एकरूप मेंशन से असर डालते हैं, और दूसरे पर ऐसे क्रॉल होने लायक पेज से, जिनके अंश तथ्यों और स्रोतों के साथ सीधे सवाल का जवाब दें। फिर हर प्रॉम्प्ट पर मापते हैं कि आपका उद्धरण हो रहा है या नहीं।
सर्च का व्यवहार क्लासिक नतीजों के पन्ने और बातचीत वाले जवाबों के बीच बँट रहा है, और LLM SEO वह नाम है जो ज़्यादातर मार्केटर इस दूसरे हिस्से के लिए इस्तेमाल करते हैं। इसे GEO (generative engine optimization), AEO या LLMO भी कहा जाता है। नाम अलग हैं, पर तरीका एक है, और वह इतना ठोस है कि व्यवस्थित ढंग से काम किया जा सके।
LLM SEO क्या है?
LLM SEO उन कामों का समूह है जो इस संभावना को बढ़ाते हैं कि भाषा मॉडल सवाल का जवाब देते समय आपके ब्रांड का ज़िक्र करे, उसकी सिफ़ारिश करे या उसका हवाला दे। क्लासिक SEO दस लिंक की सूची में जगह चाहता है। LLM SEO एक संश्लेषित जवाब के भीतर जगह चाहता है, जहाँ अक्सर केवल तीन से पाँच ब्रांड या स्रोत नाम लिए जाते हैं।
इस लक्ष्य के दो रूप हैं, और इन्हें अलग समझना उपयोगी है:
- मेंशन: मॉडल अपने जवाब में आपके ब्रांड का नाम लेता है (उदाहरण के लिए, सुझाए गए टूल की सूची में)।
- उद्धरण: मॉडल अपनी बात के स्रोत के रूप में आपके किसी पेज का लिंक देता है।
किसी ब्रांड का ज़िक्र हो सकता है बिना उद्धरण के (मॉडल उसे प्रशिक्षण से जानता है), और उद्धरण हो सकता है बिना सिफ़ारिश के (आपके पेज को तटस्थ स्रोत की तरह इस्तेमाल किया गया)। अच्छा LLM SEO दोनों पर काम करता है।
LLM अपने स्रोत कैसे चुनते हैं?
दो रास्तों से: प्रशिक्षण के दौरान बनी पैरामीट्रिक मेमोरी से, और मॉडल के खोज करते समय वेब से ताज़ा रिट्रीवल से। यह समझना कि किसी सवाल में कौन-सा रास्ता काम कर रहा है, बताता है कि किस लीवर को खींचना है।
| रास्ता | कैसे काम करता है | किससे प्रभावित होता है | असर की रफ़्तार |
|---|
| प्रशिक्षण डेटा | मॉडल ने वेब के एक बड़े स्नैपशॉट से जुड़ाव सीखे, जो उसकी नॉलेज कट-ऑफ़ पर जम जाता है | आपके ब्रांड का कितनी बार और कितनी एकरूपता से कई स्वतंत्र साइटों पर वर्णन होता है | धीमा: महीने, अगले मॉडल वर्ज़न तक |
| लाइव रिट्रीवल | मॉडल सर्च क्वेरी भेजता है, कुछ पेज लाता है और निकाले गए अंशों से अपना जवाब बनाता है | इंडेक्सिंग, क्रॉलर की पहुँच, उप-क्वेरी पर रैंकिंग, अंशों की गुणवत्ता | तेज़: प्रकाशन के दिनों से हफ़्तों बाद |
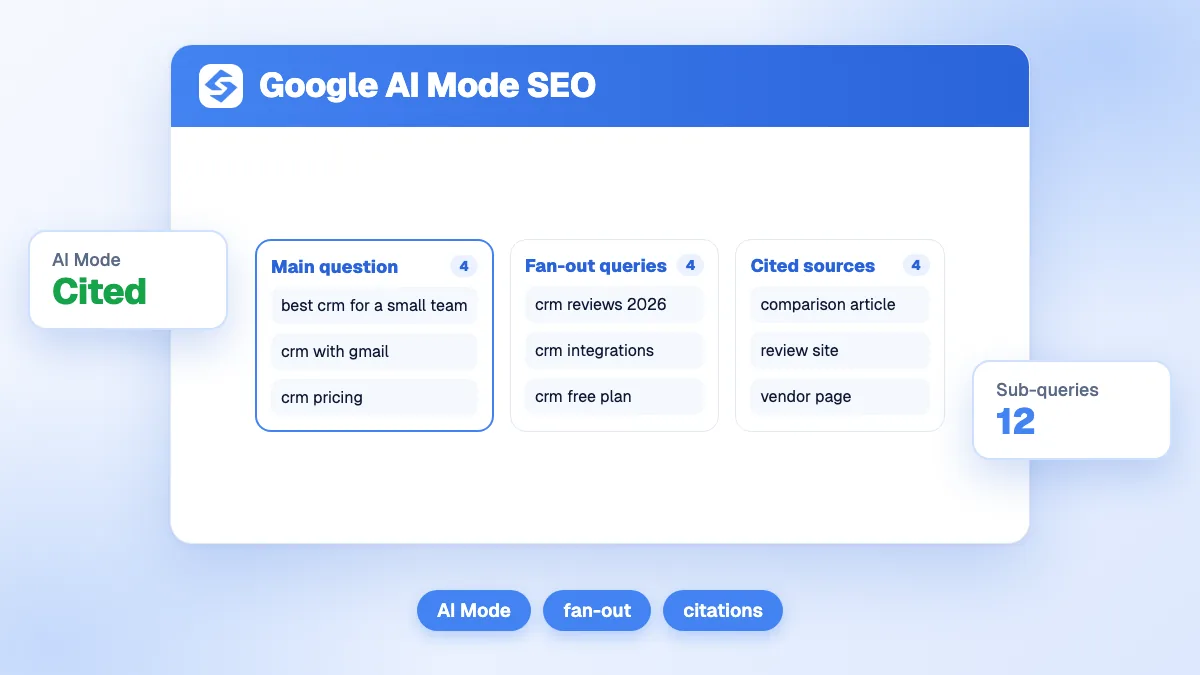
रिट्रीवल को retrieval-augmented generation (RAG) कहा जाता है। जब मॉडल खोज करता है, तो वह अक्सर सवाल को कई उप-क्वेरी में बाँटता है (query fan-out), हर एक के नतीजे लाता है, और सबसे अच्छा जवाब देने वाले अंश रखता है। इसलिए उन उप-क्वेरी पर क्लासिक सर्च में अच्छी रैंकिंग अब भी उद्धृत होने का सबसे मज़बूत संकेतक है। Google कहता है कि उसके AI फ़ीचर, जैसे AI Overviews, वही इंडेक्स और वही गुणवत्ता प्रणालियाँ इस्तेमाल करते हैं जो Search में, और इनमें दिखने के लिए कोई विशेष मार्कअप ज़रूरी नहीं (Google Search Central)।
कौन-सा अंश उद्धृत होने लायक है?
कोई अंश तब उद्धृत होता है जब वह एक सवाल का पूरा जवाब दे, अपने दम पर, एक जाँचे जा सकने वाले तथ्य के साथ। मॉडल कुछ वाक्यों का एक टुकड़ा निकालता है, इसलिए वह टुकड़ा पेज के बाक़ी हिस्से के बिना भी अर्थपूर्ण होना चाहिए।
शोध इसकी पुष्टि करता है। GEO शब्द गढ़ने वाले प्रिंसटन अध्ययन ने कई दोबारा लिखने के तरीकों की जाँच की और पाया कि स्रोत, उद्धरण और आँकड़े जोड़ने से उनके बेंचमार्क पर जेनरेट हुए जवाबों में विज़िबिलिटी लगभग 40% तक बढ़ी (Aggarwal et al., GEO)। इसके उलट, कीवर्ड ठूँसने से कोई फ़ायदा नहीं हुआ।
व्यावहारिक नियम:
- पहले जवाब दें। हर हेडिंग के नीचे पहले वाक्य में सीधा जवाब रखें, फिर विस्तार करें।
- एक हिस्सा, एक सवाल। हेडिंग को उन सवालों के रूप में लिखें जो लोग टाइप करते हैं, और “जैसा ऊपर बताया गया” कभी न लिखें।
- चीज़ों के नाम सटीक लिखें। “यह” या “यह टूल” के बजाय विषय दोहराएँ, ताकि निकाला गया अंश अपना अर्थ बनाए रखे।
- आँकड़े स्रोत के साथ दें। किसी नामित अध्ययन से जुड़ा आँकड़ा राय से ज़्यादा उद्धृत होने लायक है।
- तुलना वाली चीज़ों के लिए टेबल और सूचियाँ इस्तेमाल करें; ये सबसे आसानी से निकाले जाने वाले फ़ॉर्मेट हैं।
- इनफ़ॉर्मेशन गेन लाएँ। मौलिक डेटा, खुद किए गए परीक्षण या विशेषज्ञ की राय मॉडल को दस मिलते-जुलते पेजों के बजाय आपका पेज चुनने की वजह देते हैं।
आप हमारे मुफ़्त LLM readability checker से जाँच सकते हैं कि आपका पेज मॉडल को कैसा पढ़ा जाता है।
LLM SEO के लिए इकाई (entity) की एकरूपता क्यों मायने रखती है?
क्योंकि मॉडल उस बात पर भरोसा करता है जो कई स्वतंत्र स्रोत एक ही तरह से कहते हैं। अगर आपकी साइट, आपका LinkedIn पेज, रिव्यू प्लेटफ़ॉर्म, डायरेक्टरी और प्रेस लेख आपकी कंपनी का वर्णन एक ही नाम, श्रेणी और मुख्य तथ्यों के साथ करते हैं, तो मॉडल आपके ब्रांड और उस श्रेणी के बीच एक स्थिर जुड़ाव बना लेता है।
असंगत वर्णन (एक साइट पर पुराना नाम, दूसरी पर अलग श्रेणी, कहीं और पुरानी कीमतें) वह जुड़ाव धुंधला करते हैं और जवाबों में गलती का जोखिम बढ़ाते हैं। काम नीरस है, पर असरदार:
- अपने ब्रांड का एक संदर्भ वर्णन लिखें (वह क्या है, किसके लिए है, क्या अलग करता है) और उसे हर जगह दोबारा इस्तेमाल करें।
- Organization स्ट्रक्चर्ड डेटा जोड़ें, जिसमें आपके आधिकारिक प्रोफ़ाइल के लिंक हों।
- वहाँ मौजूद रहें जहाँ AI राय ढूँढते हैं: तुलना लेख, रिव्यू साइट, Reddit या इंडस्ट्री फ़ोरम, आपके बाज़ार के हिसाब से।
- तीसरे पक्ष की सामग्री में मेंशन कमाएँ, जो प्रशिक्षण डेटा और लाइव रिट्रीवल दोनों को पोषित करते हैं।
यही entity SEO का मूल है, और अक्सर उन ब्रांड के लिए गायब कड़ी होता है जिनकी साइट अच्छी तरह ऑप्टिमाइज़ है, पर जो कभी सिफ़ारिश की सूचियों में नहीं आते।
AI क्रॉलर को अपनी साइट तक पहुँच कैसे दें?
उन क्रॉलर को अनुमति देकर जो लाइव जवाबों के लिए पेज लाते हैं, मुख्य सामग्री को बिना JavaScript के रेंडर होने लायक रखकर, और उन सर्च इंजन में इंडेक्स बने रहकर जिन्हें मॉडल इस्तेमाल करते हैं। जो पेज मॉडल नहीं ला सकता, वह कितना भी अच्छा हो, कभी उद्धृत नहीं होगा।
| क्रॉलर | संचालक | भूमिका |
|---|
| OAI-SearchBot | OpenAI | ChatGPT सर्च के जवाबों के लिए पेज लाता है |
| GPTBot | OpenAI | मॉडल प्रशिक्षण के लिए सामग्री जुटाता है |
| ClaudeBot | Anthropic | Claude के लिए सामग्री जुटाता है |
| PerplexityBot | Perplexity | Perplexity के जवाबों के लिए पेज इंडेक्स करता है |
| Google-Extended | Google | Gemini प्रशिक्षण में सामग्री के उपयोग को नियंत्रित करता है; Search या AI Overviews पर असर नहीं डालता |
अपनी robots.txt, अपनी फ़ायरवॉल या CDN के बॉट सेटिंग जाँचें (कुछ AI क्रॉलर को डिफ़ॉल्ट रूप से ब्लॉक करते हैं), और मुख्य सामग्री की सर्वर-साइड रेंडरिंग भी। AI क्रॉलर के लिए robots.txt नियम की हमारी गाइड हर निर्देश को पंक्ति-दर-पंक्ति समझाती है।
LLM SEO के नतीजे कैसे मापें?
प्रॉम्प्ट की एक तय सूची समय के साथ ट्रैक करके, और मेंशन, उद्धरण और आपकी जगह नाम लिए गए प्रतिद्वंद्वियों को दर्ज करके। रैंकिंग पोज़िशन जैसा कोई पैमाना नहीं है, और हर बार जवाब बदलते हैं, इसलिए एक ही नतीजे के बजाय सवालों के पैनल पर रुझान मापें।
- प्रॉम्प्ट पैनल बनाएँ: असली खरीदारों के 20 से 50 सवाल, जिनमें सामान्य (“X के लिए सबसे अच्छा टूल”), तुलनात्मक (“X बनाम Y”) और समस्या-आधारित सवाल हों।
- कई मॉडल ट्रैक करें: ChatGPT, Gemini, Claude और Perplexity एक ही स्रोत उद्धृत नहीं करते।
- चार मेट्रिक दर्ज करें: मेंशन दर, जवाब में स्थान, आपके URL का उद्धरण, और प्रतिद्वंद्वियों के मुक़ाबले शेयर ऑफ़ वॉइस।
- अपनी एनालिटिक्स में AI रेफ़रल ट्रैफ़िक देखें (chatgpt.com, perplexity.ai, gemini.google.com से आने वाले सेशन)।
यह हाथ से करना जल्दी उबाऊ हो जाता है, इसलिए AI मेंशन ट्रैकिंग जैसे टूल हर महीने पैनल दोहराते हैं और हर प्रॉम्प्ट के लिए उद्धृत स्रोतों की सूची देते हैं।
निष्कर्ष
LLM SEO तीन बातों पर आता है: क्रॉलर के लिए पहुँच में रहना, ऐसे अंश लिखना जो एक सवाल का पूरा जवाब स्रोत वाले तथ्यों के साथ दें, और यह सुनिश्चित करना कि बाक़ी वेब आपके ब्रांड का वर्णन वैसे ही करे जैसे आप करते हैं। फिर प्रॉम्प्ट के एक स्थिर पैनल पर मापें, क्योंकि जो आप ट्रैक नहीं करते, उसे सुधार नहीं सकते।
Sorank यह autopilot पर चलाता है: हर दिन जवाब-पहले वाले लेख लिखता और प्रकाशित करता है, हर महीने ट्रैक करता है कि ChatGPT, Gemini या Claude आपके ब्रांड का उद्धरण कर रहे हैं या नहीं, और दिखाता है कि आपकी जगह किसे उद्धृत किया जा रहा है। आप 3-day free trial से शुरू कर सकते हैं।