Innstillinger
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

LLM SEO-guide: hvordan store språkmodeller velger kildene sine, hva som gjør et avsnitt siterbart, crawlertilgang, entitetskonsistens og hvordan du måler omtaler.

Verktøy

Kort fortalt
LLM SEO er arbeidet med å få merkevaren og sidene dine til å dukke opp i svarene fra store språkmodeller som ChatGPT, Gemini, Claude og Perplexity. Disse modellene henter fra to kilder: det de lærte under trening, og det de henter fra nettet akkurat når spørsmålet stilles. Den første påvirker du gjennom hyppige og konsistente omtaler av merkevaren din på nettet, den andre gjennom søkbare sider der avsnitt svarer direkte på spørsmål, med fakta og kilder. Deretter måler du, prompt for prompt, om du blir sitert.
Vil du vite mer? Spør
Rask quiz
Hvordan får du omtale fra ChatGPT og andre AI-assistenter?
Sorank passer til svarene dine


Prøv det i 3 dager på ditt eget nettsted, og se hvor du står på Google, ChatGPT og de andre AI-assistentene.
Start en gratis prøveperiode på 3 dager3 dager gratis, deretter kan du stoppe når du vil. Resultatgaranti i 90 dager, ellers pengene tilbake.
Søkeatferden deles mellom den klassiske resultatsiden og samtalebaserte svar, og LLM SEO er navnet de fleste markedsførere bruker på den andre halvdelen av jobben. Du vil også se det kalt GEO (generative engine optimization), AEO eller LLMO. Navnene varierer, men mekanikken er den samme, og den er konkret nok til å jobbe systematisk med.
LLM SEO er settet med tiltak som øker sjansen for at en språkmodell nevner, anbefaler eller siterer merkevaren din når den svarer på et spørsmål. Klassisk SEO sikter mot en plass på en liste med ti lenker. LLM SEO sikter mot en plass i et samlet svar, der det ofte bare nevnes tre til fem merker eller kilder.
Målet har to former, og de er verdt å skille:
Et merke kan bli omtalt uten å bli sitert (modellen kjenner det fra treningen), og sitert uten å bli anbefalt (siden din brukes som en nøytral kilde). God LLM SEO jobber med begge.
Gjennom to kanaler: parametrisk hukommelse bygd under trening, og direkte henting fra nettet når modellen søker. Å forstå hvilken kanal som er i spill for et gitt spørsmål forteller deg hvilken spak du skal dra i.
| Kanal | Slik fungerer det | Hva påvirker det | Hastighet på effekt |
|---|---|---|---|
| Treningsdata | Modellen lærte sammenhenger fra et stort øyeblikksbilde av nettet, fryst ved kunnskapsgrensen | Hvor ofte og hvor konsekvent merkevaren din beskrives på mange uavhengige sider | Treg: måneder, til neste modellversjon |
| Direkte henting | Modellen sender søk, henter en håndfull sider og bygger svaret sitt av uttrukne avsnitt | Indeksering, crawlertilgang, rangering for delspørsmålene, kvaliteten på avsnittene | Rask: dager til uker etter publisering |
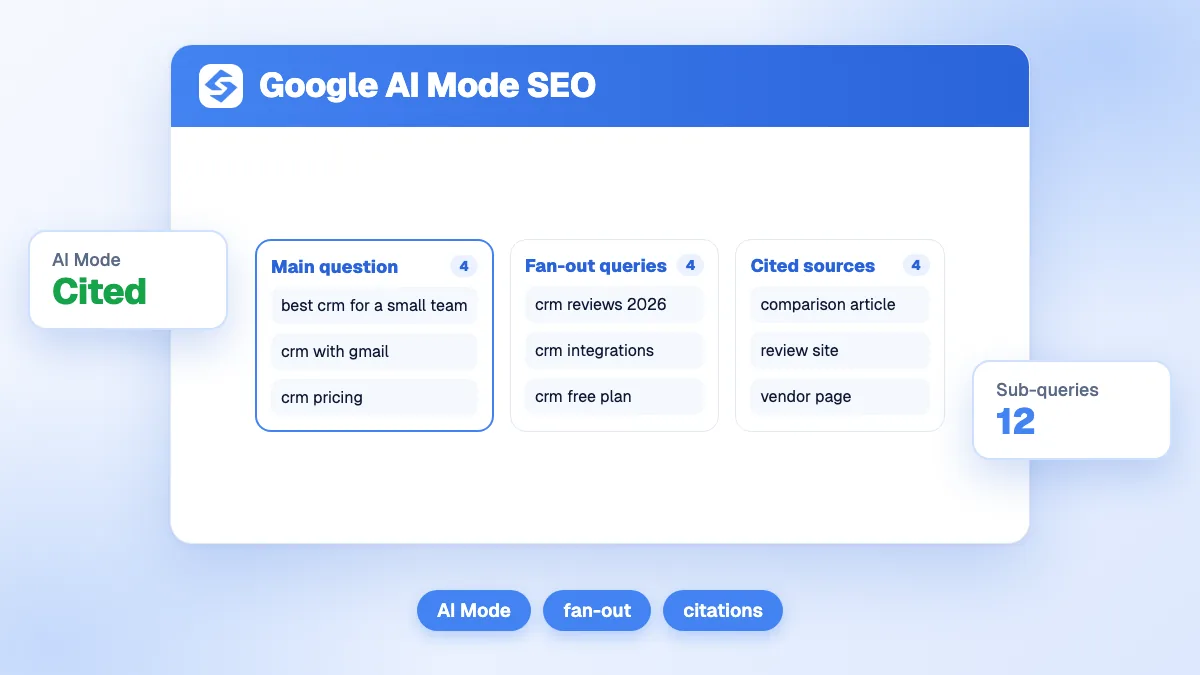
Henting er mekanismen som kalles retrieval-augmented generation (RAG). Når en modell søker, deler den ofte spørsmålet opp i flere delspørsmål (query fan-out), henter resultater for hvert av dem, og beholder avsnittene som svarer best. Å rangere godt i klassisk søk for disse delspørsmålene er derfor fortsatt en av de sterkeste indikatorene på at du blir sitert. Google opplyser at KI-funksjonene deres, som AI Overviews, bruker samme indeks og samme kvalitetssystemer som Søk, og at det ikke kreves spesiell markup for å dukke opp i dem (Google Search Central).
Et avsnitt blir sitert når det svarer fullstendig på ett spørsmål, på egen hånd, med et verifiserbart faktum. Modellen henter ut en bit på noen få setninger, så biten må gi mening uten resten av siden.
Forskningen støtter dette. Princeton-studien som laget begrepet GEO testet flere omskrivingsmetoder og fant at tilføyelse av kilder, sitater og statistikk økte synligheten i genererte svar med opptil omtrent 40% i testen deres (Aggarwal et al., GEO). Nøkkelordspamming hjalp derimot ikke.
De praktiske reglene:
Du kan sjekke hvordan en side leses av en modell med vår gratis LLM-lesbarhetssjekker.
Fordi en modell stoler på det mange uavhengige kilder sier likt. Hvis nettstedet ditt, LinkedIn-siden din, anmeldelsesplattformer, kataloger og pressartikler beskriver selskapet ditt med samme navn, kategori og nøkkelfakta, danner modellen en stabil kobling mellom merkevaren din og kategorien.
Ulike beskrivelser (et gammelt navn på én side, en annen kategori på en annen, utdatert prising andre steder) gjør den koblingen uklar og øker risikoen for feil i svarene. Arbeidet er lite glamorøst, men effektivt:
Dette er kjernen i entitets-SEO, og det mangler ofte for merkevarer som har et godt optimalisert nettsted, men aldri dukker opp i anbefalingslister.
Ved å slippe til crawlerne som henter sider til direkte svar, holde sidene dine mulige å gjengi uten JavaScript, og være indeksert i søkemotorene modellene bruker. En side modellen ikke kan hente, blir aldri sitert, uansett hvor god den er.
| Crawler | Operatør | Rolle |
|---|---|---|
| OAI-SearchBot | OpenAI | Henter sider til svar i ChatGPT-søk |
| GPTBot | OpenAI | Samler inn innhold til modelltrening |
| ClaudeBot | Anthropic | Samler inn innhold til Claude |
| PerplexityBot | Perplexity | Indekserer sider til svar i Perplexity |
| Google-Extended | Styrer bruk av innhold til trening av Gemini; påvirker ikke Søk eller AI Overviews |
Sjekk robots.txt, brannmuren eller CDN-innstillingene for bots (noen blokkerer KI-crawlere som standard), og server-side gjengivelse av hovedinnholdet. Guiden vår om robots.txt-regler for KI-crawlere går gjennom direktivene linje for linje.
Ved å følge en fast liste med spørringer over tid og registrere omtaler, siteringer og konkurrentene som nevnes i stedet for deg. Det finnes ingen tilsvarende plassering til en rangeringsplass, og svarene varierer fra kjøring til kjøring, så du måler trender over et panel av spørsmål i stedet for ett enkelt resultat.
Å gjøre dette for hånd blir fort tungvint, og derfor gjentar verktøy for AI-omtaleovervåking panelet hver måned og viser kildene som siteres for hver spørring.
LLM SEO handler om tre ting: være tilgjengelig for crawlerne, skrive avsnitt som svarer fullstendig på ett spørsmål med kildebelagte fakta, og sørge for at resten av nettet beskriver merkevaren din på samme måte som du gjør. Mål deretter på et stabilt panel av spørsmål, for det du ikke måler, kan du ikke forbedre.
Sorank kjører dette på autopilot: den skriver og publiserer svarorienterte artikler hver dag, følger hver måned med på om ChatGPT, Gemini eller Claude siterer merkevaren din, og viser hvem som siteres i stedet for deg. Du kan starte med en gratis prøveperiode på 3 dager.


LLM SEO bygger på tradisjonell SEO i stedet for å erstatte den. KI-ene som søker på nettet er fortsatt avhengige av crawlbare, indekserte sider, så teknisk helse og autoritet betyr fortsatt noe. Det som endrer seg er hva konkurransen står om: KI-ene siterer avsnitt, ikke sider, og de vekter hvor konsekvent andre sider beskriver merkevaren din. Klare svar, kilder og omtaler fra tredjeparter teller mer.
Lag en liste med de 20 til 50 spørsmålene kjøperne dine faktisk stiller, kjør dem i ChatGPT, Gemini, Perplexity og Claude, og noter om merkevaren din dukker opp, på hvilken plass, og hvilke kilder som siteres. Gjenta samme liste hver uke eller måned, for svarene varierer mellom kjøringene. Et sporingsverktøy automatiserer dette og viser hvilke konkurrenter som siteres i stedet for deg.
Å blokkere en treningscrawler som GPTBot holder innholdet ditt utenfor fremtidige treningsdata, men det fjerner ikke merkevaren din fra svarene og kan redusere tilstedeværelsen din på sikt. Søkecrawlere som OAI-SearchBot eller PerplexityBot er de som henter sider til direkte svar, og blokkerer du dem, blir du usynlig i disse svarene. De fleste merker som ønsker synlighet tillater begge.
Vi analyserer konkurrentene dine, nettstedet ditt og synligheten din i AI for å lage en skreddersydd innholdsplan, gratis.
 KI-generator for innholdsbrief
 Generator for FAQ-schema
 Generator for blogg-ideer med AI
 Validator for strukturerte data (schema-validator)
 Sjekk av alt-tekst
 Analyse av interne lenker
 Lenkeutfordringen
 KI-generator for metabeskrivelser
 KI-generator for bloggtitler
 Indekserbarhetssjekker for Google
 KI-generator for bloggdisposisjon
 Generator for UTM-lenker
 Verktøy for gruppering av søkeord
 Sjekk av kanonisk tagg
 XML-sitemap-generator
 Sjekk av ødelagte lenker
 KI-generator for SEO-tittel
 Overskriftsanalyse
 SERP-forhåndsvisning
 Kontroll av omdirigeringer
 Generator for hreflang-tagger
 Analyse av overskriftsstruktur
 Kontroll av HTTP-headere
 Favikon-henter
 SERP CTR-kalkulator
 Sparekalkulator: SEO mot betalt søk
 Kalkulator for SEO-synlighetsandel
 ROI-kalkulator for SEO
 SEO-prognosekalkulator for trafikk og inntekter
 SEO-budsjettkalkulator
 SEO-nullpunktkalkulator
 ROI-kalkulator for SaaS-SEO
 ROAS-kalkulator
 Lesetidskalkulator
 Simulator for rangeringsgevinst
 Kalkulator for verdien av organisk trafikk
 Estimator for organisk trafikk og sjekk av nettstedstrafikk
 Kalkulator for LTV til CAC-forhold
 Kalkulator for avkastning på lokal SEO
 Kalkulator for kostnad ved lenkebygging
 Kalkulator for søkeordverdi
 Kalkulator for poengsum for søkeordmuligheter
 Kalkulator for tetthet av søkeord
 Kalkulator for GEO-avkastning
 Kalkulator for investering i GEO-innhold
 Kalkulator for SEO-avkastning i netthandel
 Kalkulator for kundens levetidsverdi
 Kalkulator for kundeanskaffelseskostnad
 CTR-kalkulator
 Kalkulator for kostnad per artikkel
 Kalkulator for konverteringsrate
 Kalkulator for ROI i innholdsmarkedsføring
 Estimator for ChatGPT-trafikk
 Kalkulator for avvisningsrate
 Kalkulator for backlink-ROI
 Kalkulator for AI-synlighetspoeng
 Kalkulator for verdien av AI-trafikk
 Kalkulator for AI-synlighetsandel
 Kalkulator for kostnaden av AI-usynlighet
 Kalkulator for AI-siteringsrate
 llms.txt-validator
 AI Overview-sjekker og rangeringssjekker for AI Overviews
 Robots.txt-sjekker
 KI-SEO-revisjon
 Sjekk av lesbarhet for LLM
 Sjekk av klargjøring for SearchGPT
 Revisjon av strukturerte data for LLM
 KI-revisjon av crawlbarhet
 Hvorfor ChatGPT ikke anbefaler nettstedet mitt
 Gemini-rangeringsverktøy
 Sjekk av rangering i Perplexity
 Sjekk av LLM-sitater
 AEO-revisjon
 GEO-revisjon
 Test av synlighet i AI-søk
 Sjekk av synlighet i ChatGPT
 llms.txt-generator
 URL-uttrekker
 Nettside til Markdown
 Sjekk av sitemap
 Sensor for SERP-volatilitet
 Sidestørrelsessjekk
 Ordteller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Generator for metatagger
 Bildekomprimerer
 Favicon-generator
 Revisjon av on-page SEO: SEO-sjekk og SEO-analyse
 Verktøy for analyse av tilbakelenker
 Verktøy for søkeordforslag
 Sjekk av domeneautoritet
DE PRØVDE SORANK FØR DEG
 “Jeg testet Sorank på et ekte kundenettsted, og det er helt utrolig. Det gjør alt et byrå ville tatt deg $1500 i måneden for. Nå går det i produksjon på den kunden.”

 Guillaume Guersanguersanguillaume.com“Vi er et annonsebyrå, og vi ville få SEO-en vår på rett spor en gang for alle. Sorank ga oss en tydelig oversikt over nettstedet vårt, hjalp oss å prioritere optimaliseringene og å strukturere innholdet vårt på riktig måte. Verktøyet er enkelt å bruke, godt utformet for et team, og veldig praktisk for å samle oppfølgingen på ett sted uten å jonglere med flere plattformer. Et veldig solid grunnlag for å starte på nytt med SEO.”
 Gaspard MadouiAnnonsebyrå
 “Jeg lot bare Sorank-programvaren gjøre jobben sin, og nå er DR-en min 25, og siden min rangerer høyere.”
 Lucas Flandrefoundertrace.fr“Jeg spesialiserte meg på GEO takket være Sorank. GEO-rangeringen lar meg vise kundene mine hvor de står mot konkurrentene på ChatGPT. Det er en reell kommersiell fordel.”
 MélanieSEO-frilanser“Kjempebra service, den fungerer godt for nettstedet vårt og hjelper oss å forstå hvordan vi kan forbedre det for å rangere bedre på Google og andre steder. Gratulerer, fortsett slik, jeg anbefaler det.”
 Hugo T.Netthandler