Præferencer
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Guide til LLM SEO: hvordan store sprogmodeller vælger deres kilder, hvad der gør et afsnit citérbart, crawleradgang, entitetskonsistens og hvordan du måler omtaler.

Værktøjer

Kort fortalt
LLM SEO er at få dit brand og dine sider til at optræde i svarene fra store sprogmodeller som ChatGPT, Gemini, Claude og Perplexity. Disse modeller trækker på to kilder: det, de lærte under træningen, og det, de henter fra nettet på tidspunktet for spørgsmålet. Du påvirker den første gennem udbredte, konsistente omtaler af dit brand på nettet, og den anden gennem crawlbare sider, hvis afsnit svarer direkte på spørgsmål med fakta og kilder. Derefter måler du, prompt for prompt, om du bliver citeret.
Vil du vide mere? Spørg
Hurtig quiz
Hvordan får du nævnt af ChatGPT og andre AI-assistenter?
Sorank matcher dine svar


Test det i 3 dage på dit eget site, og se, hvor du står på Google, ChatGPT og de andre AI'er.
Start prøveperiode på 3 dage3 dage gratis, derefter stopper du, når du vil. 90 dages garanti: resultater eller pengene tilbage.
Søgeadfærden deler sig mellem den klassiske resultatside og samtalebaserede svar, og LLM SEO er det navn, de fleste marketingfolk bruger om den sidste halvdel af opgaven. Du vil også se det kaldt GEO (generative engine optimization), AEO eller LLMO. Betegnelserne er forskellige, mekanikken er den samme, og den er konkret nok til at arbejde metodisk med.
LLM SEO er de tiltag, der øger sandsynligheden for, at en sprogmodel nævner, anbefaler eller citerer dit brand, når den besvarer et spørgsmål. Klassisk SEO sigter efter en placering på en liste med ti links. LLM SEO sigter efter en plads inde i et sammenfattet svar, hvor der ofte kun nævnes tre til fem brands eller kilder.
Målet har to former, og det er værd at holde dem adskilt:
Et brand kan blive nævnt uden at blive citeret (modellen kender det fra træningen), og citeret uden at blive anbefalet (din side bruges som neutral kilde). God LLM SEO arbejder på begge dele.
Gennem to kanaler: den parametriske hukommelse, der bygges under træningen, og live-hentning fra nettet, når modellen søger. At forstå, hvilken af dem der er på spil ved et givent spørgsmål, fortæller dig, hvilken løftestang du skal trække i.
| Kanal | Sådan virker den | Hvad påvirker den | Hastighed for effekt |
|---|---|---|---|
| Træningsdata | Modellen lærte sammenhænge fra et stort øjebliksbillede af nettet, frosset ved dens vidensgrænse | Hvor ofte og hvor konsistent dit brand beskrives på tværs af mange uafhængige sites | Langsom: måneder, indtil den næste modelversion |
| Live-hentning | Modellen sender søgeforespørgsler, henter en håndfuld sider og bygger sit svar ud fra udtrukne afsnit | Indeksering, crawleradgang, rangering på delforespørgslerne, afsnittenes kvalitet | Hurtig: dage til uger efter udgivelse |
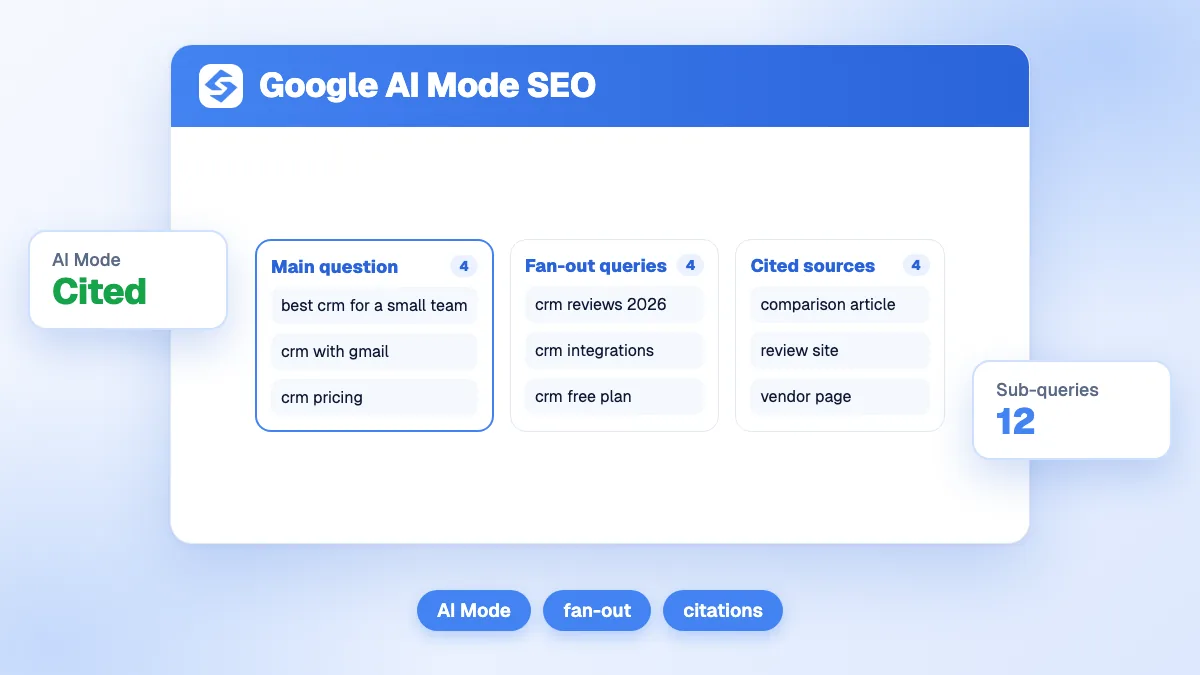
Hentning er den mekanisme, der kaldes retrieval-augmented generation (RAG). Når en model søger, deler den ofte spørgsmålet op i flere delforespørgsler (query fan-out), henter resultater til hver af dem og beholder de afsnit, der svarer bedst. God placering i klassisk søgning for disse delforespørgsler er derfor stadig en af de stærkeste forudsigelser for at blive citeret. Google oplyser, at dets AI-funktioner, som AI Overviews, bygger på det samme indeks og de samme kvalitetssystemer som søgningen, og at der ikke kræves særlig markup for at optræde i dem (Google Search Central).
Et afsnit bliver citeret, når det besvarer ét spørgsmål fuldt ud, alene, med et verificerbart faktum. Modellen udtrækker et stykke på nogle få sætninger, så stykket skal give mening uden resten af siden.
Forskningen understøtter det. Princeton-undersøgelsen, der introducerede begrebet GEO, testede flere omskrivningsmetoder og fandt, at tilføjelse af kilder, citater og statistik øgede synligheden i genererede svar med op til cirka 40 % i deres benchmark (Aggarwal et al., GEO). Nøgleordsfyldning hjalp derimod ikke.
De praktiske regler:
Du kan se, hvordan en side læses af en model, med vores gratis LLM-læsbarhedstjek.
Fordi en model stoler på det, mange uafhængige kilder siger på samme måde. Hvis dit site, din LinkedIn-side, anmeldelsesplatforme, kataloger og pressartikler beskriver din virksomhed med samme navn, kategori og nøglefakta, danner modellen en stabil sammenhæng mellem dit brand og den kategori.
Inkonsistente beskrivelser (et gammelt navn på ét site, en anden kategori på et andet, forældede priser et tredje sted) udvisker den sammenhæng og øger risikoen for fejl i svarene. Arbejdet er ikke glamourøst, men det virker:
Dette er kernen i entity SEO, og det er ofte den manglende brik for brands, hvis site er godt optimeret, men som aldrig optræder på anbefalingslister.
Ved at tillade de crawlere, der henter sider til live-svar, ved at holde dine sider læsbare uden JavaScript og ved at være indekseret i de søgemaskiner, modellerne bruger. En side, modellen ikke kan hente, bliver aldrig citeret, uanset hvor god den er.
| Crawler | Udbyder | Rolle |
|---|---|---|
| OAI-SearchBot | OpenAI | Henter sider til svar i ChatGPT-søgning |
| GPTBot | OpenAI | Indsamler indhold til træning af modeller |
| ClaudeBot | Anthropic | Indsamler indhold til Claude |
| PerplexityBot | Perplexity | Indekserer sider til svar i Perplexity |
| Google-Extended | Styrer brug af indhold til træning af Gemini; påvirker ikke søgning eller AI Overviews |
Tjek din robots.txt, dine firewall- eller CDN-indstillinger for bots (nogle blokerer AI-crawlere som standard) og server-side rendering af hovedindholdet. Vores guide til robots.txt-regler for AI-crawlere gennemgår direktiverne linje for linje.
Ved at følge en fast liste af prompts over tid og registrere omtaler, citationer og de konkurrenter, der nævnes i stedet for dig. Der findes ingen modstykke til en rangeringsplacering, og svarene varierer fra kørsel til kørsel, så du måler tendenser over en række spørgsmål frem for et enkelt resultat.
At køre dette manuelt bliver hurtigt kedeligt, og derfor gentager værktøjer som AI-omtaleovervågning panelet hver måned og viser de kilder, der er citeret for hver prompt.
LLM SEO handler om tre ting: at være tilgængelig for crawlerne, at skrive afsnit, der svarer på ét spørgsmål fuldt ud med kildebelagte fakta, og at sørge for, at resten af nettet beskriver dit brand på samme måde, som du gør. Mål derefter på et stabilt panel af prompts, for det, du ikke måler, kan du ikke forbedre.
Sorank kører dette på autopilot: Det skriver og udgiver svar-først-artikler hver dag, sporer hver måned, om ChatGPT, Gemini eller Claude citerer dit brand, og viser, hvem der bliver citeret i dit sted. Du kan starte med den 3 dages gratis prøveperiode.


LLM SEO bygger videre på traditionel SEO frem for at erstatte den. AI'erne, der søger på nettet, er stadig afhængige af crawlbare, indekserede sider, så teknisk sundhed og autoritet betyder fortsat noget. Det, der ændrer sig, er konkurrencens enhed: AI'erne citerer afsnit, ikke sider, og de vægter, hvor konsekvent andre sites beskriver dit brand. Klare svar, kilder og omtaler fra tredjepart vejer tungere.
Opstil de 20 til 50 spørgsmål, dine købere reelt stiller, kør dem i ChatGPT, Gemini, Perplexity og Claude, og registrer om dit brand optræder, på hvilken placering, og hvilke kilder der citeres. Gentag den samme liste hver uge eller måned, for svarene varierer mellem kørsler. Et sporingsværktøj automatiserer det og viser, hvilke konkurrenter der bliver citeret i dit sted.
Hvis du blokerer en træningscrawler som GPTBot, holdes dit indhold ude af fremtidige træningsdata, men det fjerner ikke dit brand fra svarene, og det kan på længere sigt reducere din tilstedeværelse. Søgecrawlere som OAI-SearchBot eller PerplexityBot er dem, der henter sider til live-svar, og blokerer du dem, bliver du usynlig i disse svar. De fleste brands, der ønsker synlighed, tillader begge.
Vi analyserer dine konkurrenter, dit website og din synlighed i AI for at lave en skræddersyet indholdsplan gratis.
 AI-generator til indholdsbrief
 FAQ-schemagenerator
 AI-generator til blogidéer
 Validator for struktureret data (schema-validator)
 Tjek af alt-tekst
 Analyse af interne links
 Backlink-udfordringen
 AI-generator til metabeskrivelser
 AI-generator til blogtitler
 Tjek af indekserbarhed
 AI-generator til blogdispositioner
 UTM-linkgenerator
 Værktøj til søgeordsclustering
 Tjek af canonical-tag
 XML-sitemap-generator
 Tjek af ødelagte links
 AI-generator til SEO-titler
 Overskriftsanalysator
 SERP-forhåndsvisning
 Redirect-tjekker
 Hreflang-generator
 Overskriftsanalysator
 HTTP-headertjekker
 Favicon-udtrækker
 SERP CTR-beregner
 Beregner for besparelse ved SEO vs. betalt søgning
 Beregner af SEO-synlighedsandel
 Beregner af SEO-afkast
 Beregner af SEO-trafik- og omsætningsprognose
 Beregner af SEO-budget
 Beregner af SEO-break-even
 Beregner af SaaS-SEO-afkast
 Beregner af ROAS
 Beregner af læsetid
 Simulator for placeringsgevinst
 Beregner for værdi af organisk trafik
 Estimator for organisk trafik og tjek af webstedstrafik
 Beregner for LTV/CAC-forhold
 Beregner for lokal SEO-afkast
 Beregner for linkbuilding-omkostninger
 Beregner for søgeordsværdi
 Beregner for søgeordsmulighed
 Beregner for nøgleordstæthed
 Beregner for GEO-ROI
 Beregner for investering i GEO-indhold
 Ecommerce SEO-ROI-beregner
 Beregner for kundens levetidsværdi
 CAC-beregner
 Beregner for CTR
 Beregner for omkostning pr. artikel
 Beregner for konverteringsrate
 Beregner for ROI på content marketing
 Estimator for henvisningstrafik fra ChatGPT
 Beregner for bounce rate
 Beregner for backlinks ROI
 Beregner for AI-synlighedsscore
 AI-trafikværdi-beregner
 AI-share of voice-beregner
 Beregner for omkostningen ved AI-usynlighed
 AI-citationsrate-beregner
 llms.txt-validator
 AI Overview-tjekker og rangeringstjekker for AI Overviews
 Robots.txt-tjekker
 AI-SEO-audit
 LLM-læsbarhedstjek
 SearchGPT-klartjek
 LLM-audit af strukturerede data
 AI-crawlbarhedsaudit for websites
 Hvorfor anbefaler ChatGPT ikke mit website?
 Gemini-rangeringsværktøj
 Perplexity-placeringstjek
 LLM-citeringstjek
 AEO-audit
 GEO-audit
 Test af synlighed i AI-søgning
 Tjek af ChatGPT-synlighed
 llms.txt-generator
 URL-udtrækker
 Webside til Markdown
 Sitemap-tjek
 SERP-volatilitetsmåler
 Sidestørrelsestjek
 Ordtæller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Metatag-generator
 Billedkompressor
 Favicon-generator
 On-page SEO-audit: SEO-tjek og SEO-analyse
 Backlinkanalyseværktøj
 Værktøj til søgeordsanalyse
 Domain Authority-tjek
DE PRØVEDE SORANK, FØR DU GJORDE DET
 “Jeg testede Sorank på en rigtig kundes site, og det er vanvittigt. Det gør alt, et bureau ville opkræve dig 1500 dollar om måneden for. Det går nu i produktion på den kunde.”

 Guillaume Guersanguersanguillaume.com“Vi er et annoncebureau, og vi ville have vores SEO på rette spor en gang for alle. Sorank gav os et klart overblik over vores site, hjalp os med at prioritere optimeringer og strukturere vores indhold ordentligt. Værktøjet er nemt at bruge, velegnet til et team og meget praktisk til at samle opfølgningen et sted uden at jonglere med flere platforme. Et meget solidt fundament til at starte forfra med vores SEO.”
 Gaspard MadouiAnnoncebureau
 “Jeg lod bare Sorank-softwaren gøre sit arbejde, og nu er min DR 25, og min side rangerer højere.”
 Lucas Flandrefoundertrace.fr“Jeg specialiserede mig i GEO takket være Sorank. GEO-ranglisten gør det muligt at vise mine kunder deres placering i forhold til konkurrenterne på ChatGPT. Det er en reel kommerciel fordel.”
 MélanieSEO-freelancer“Fantastisk service, den virker godt til vores hjemmeside og hjælper os med at forstå, hvordan vi kan forbedre den for at rangere bedre på Google og andre steder. Tillykke, bliv ved, jeg anbefaler det.”
 Hugo T.Netbutiksejer