Resumo: O rastreio e a indexação são os dois passos sequenciais que levam uma página à pesquisa: o rastreio descobre e obtém a página, enquanto a indexação a analisa e a armazena na base de dados para que possa aparecer nos resultados.
O rastreio e a indexação são os processos emparelhados que decidem se uma página pode sequer aparecer na pesquisa. O rastreio é quando um motor de pesquisa descobre e descarrega as suas páginas, e a indexação é quando analisa esse conteúdo, decide se vale a pena armazená-lo e o adiciona à sua base de dados. Antes de uma página poder posicionar-se, o Google tem primeiro de a encontrar e depois de a compreender.
Os dois são sequenciais e distintos. Cada página indexada teve primeiro de ser rastreada, mas nem toda a página rastreada é indexada. Compreender onde uma página se situa neste fluxo é a base para diagnosticar por que motivo o conteúdo aparece ou não na pesquisa e nas respostas de IA.
O que é o rastreio?
O rastreio é a fase de descoberta. Robôs automatizados como o Googlebot encontram páginas através de ligações, mapas do site, redirecionamentos e submissões diretas, e depois descarregam o conteúdo. O rastreador salta de ligação em ligação, faz pedidos HTTP e coloca as páginas com muito JavaScript numa fila de apresentação separada, para que o seu conteúdo completo possa ser visto.
Isto é puramente sobre acesso e obtenção. Um rastreio bem-sucedido significa que o motor de pesquisa obteve e analisou a página. Ainda não diz nada sobre se a página é suficientemente boa, suficientemente única ou suficientemente importante para ser mantida. Para a mecânica de descoberta em profundidade, consulte a entrada dedicada de rastreio.
O que é a indexação?
A indexação acontece após o rastreio. O Google analisa a página, examinando texto, imagens, vídeos, títulos, ligações e etiquetas-chave, e depois decide se a armazena no índice, a enorme base de dados a partir da qual os resultados são extraídos. Só as páginas indexadas são elegíveis para aparecer quando alguém pesquisa.
A decisão é um juízo de qualidade e relevância, e não uma formalidade. O Google pondera a qualidade e a originalidade do conteúdo, os sinais E-E-A-T, o conteúdo duplicado, a estrutura técnica e qual o URL que deve ser canónico. Uma página fina, duplicada ou de baixo valor pode ser rastreada e depois discretamente deixada de fora do índice. A entrada de indexação aborda esta fase com mais detalhe.
O fluxo do rastreio à indexação passo a passo
A jornada completa tem fases claras. A descoberta encontra um URL através de uma ligação ou de um mapa do site. O rastreio obtém-no. A apresentação executa o JavaScript para que o conteúdo real fique visível. A indexação analisa e armazena a página. Por fim, o posicionamento e a entrega decidem se e onde aparece para uma determinada consulta.
Cada fase pode falhar de forma independente. Uma página bloqueada no robots.txt nunca é rastreada. Uma página rastreada mas julgada de baixo valor nunca é indexada. Uma página indexada mas pouco competitiva nunca se posiciona. Mapear um problema para a fase certa é o que torna o diagnóstico eficiente em vez de uma adivinhação.
Porque é que nem toda a página rastreada é indexada
A indexação é seletiva por design, porque armazenar e servir milhares de milhões de páginas é dispendioso e os utilizadores querem qualidade. O Google, segundo se relata, indexa em média apenas entre 30 e 60 por cento das páginas de um site, de acordo com comentários atribuídos a John Mueller, o que significa que a indexação parcial é normal e não uma falha.
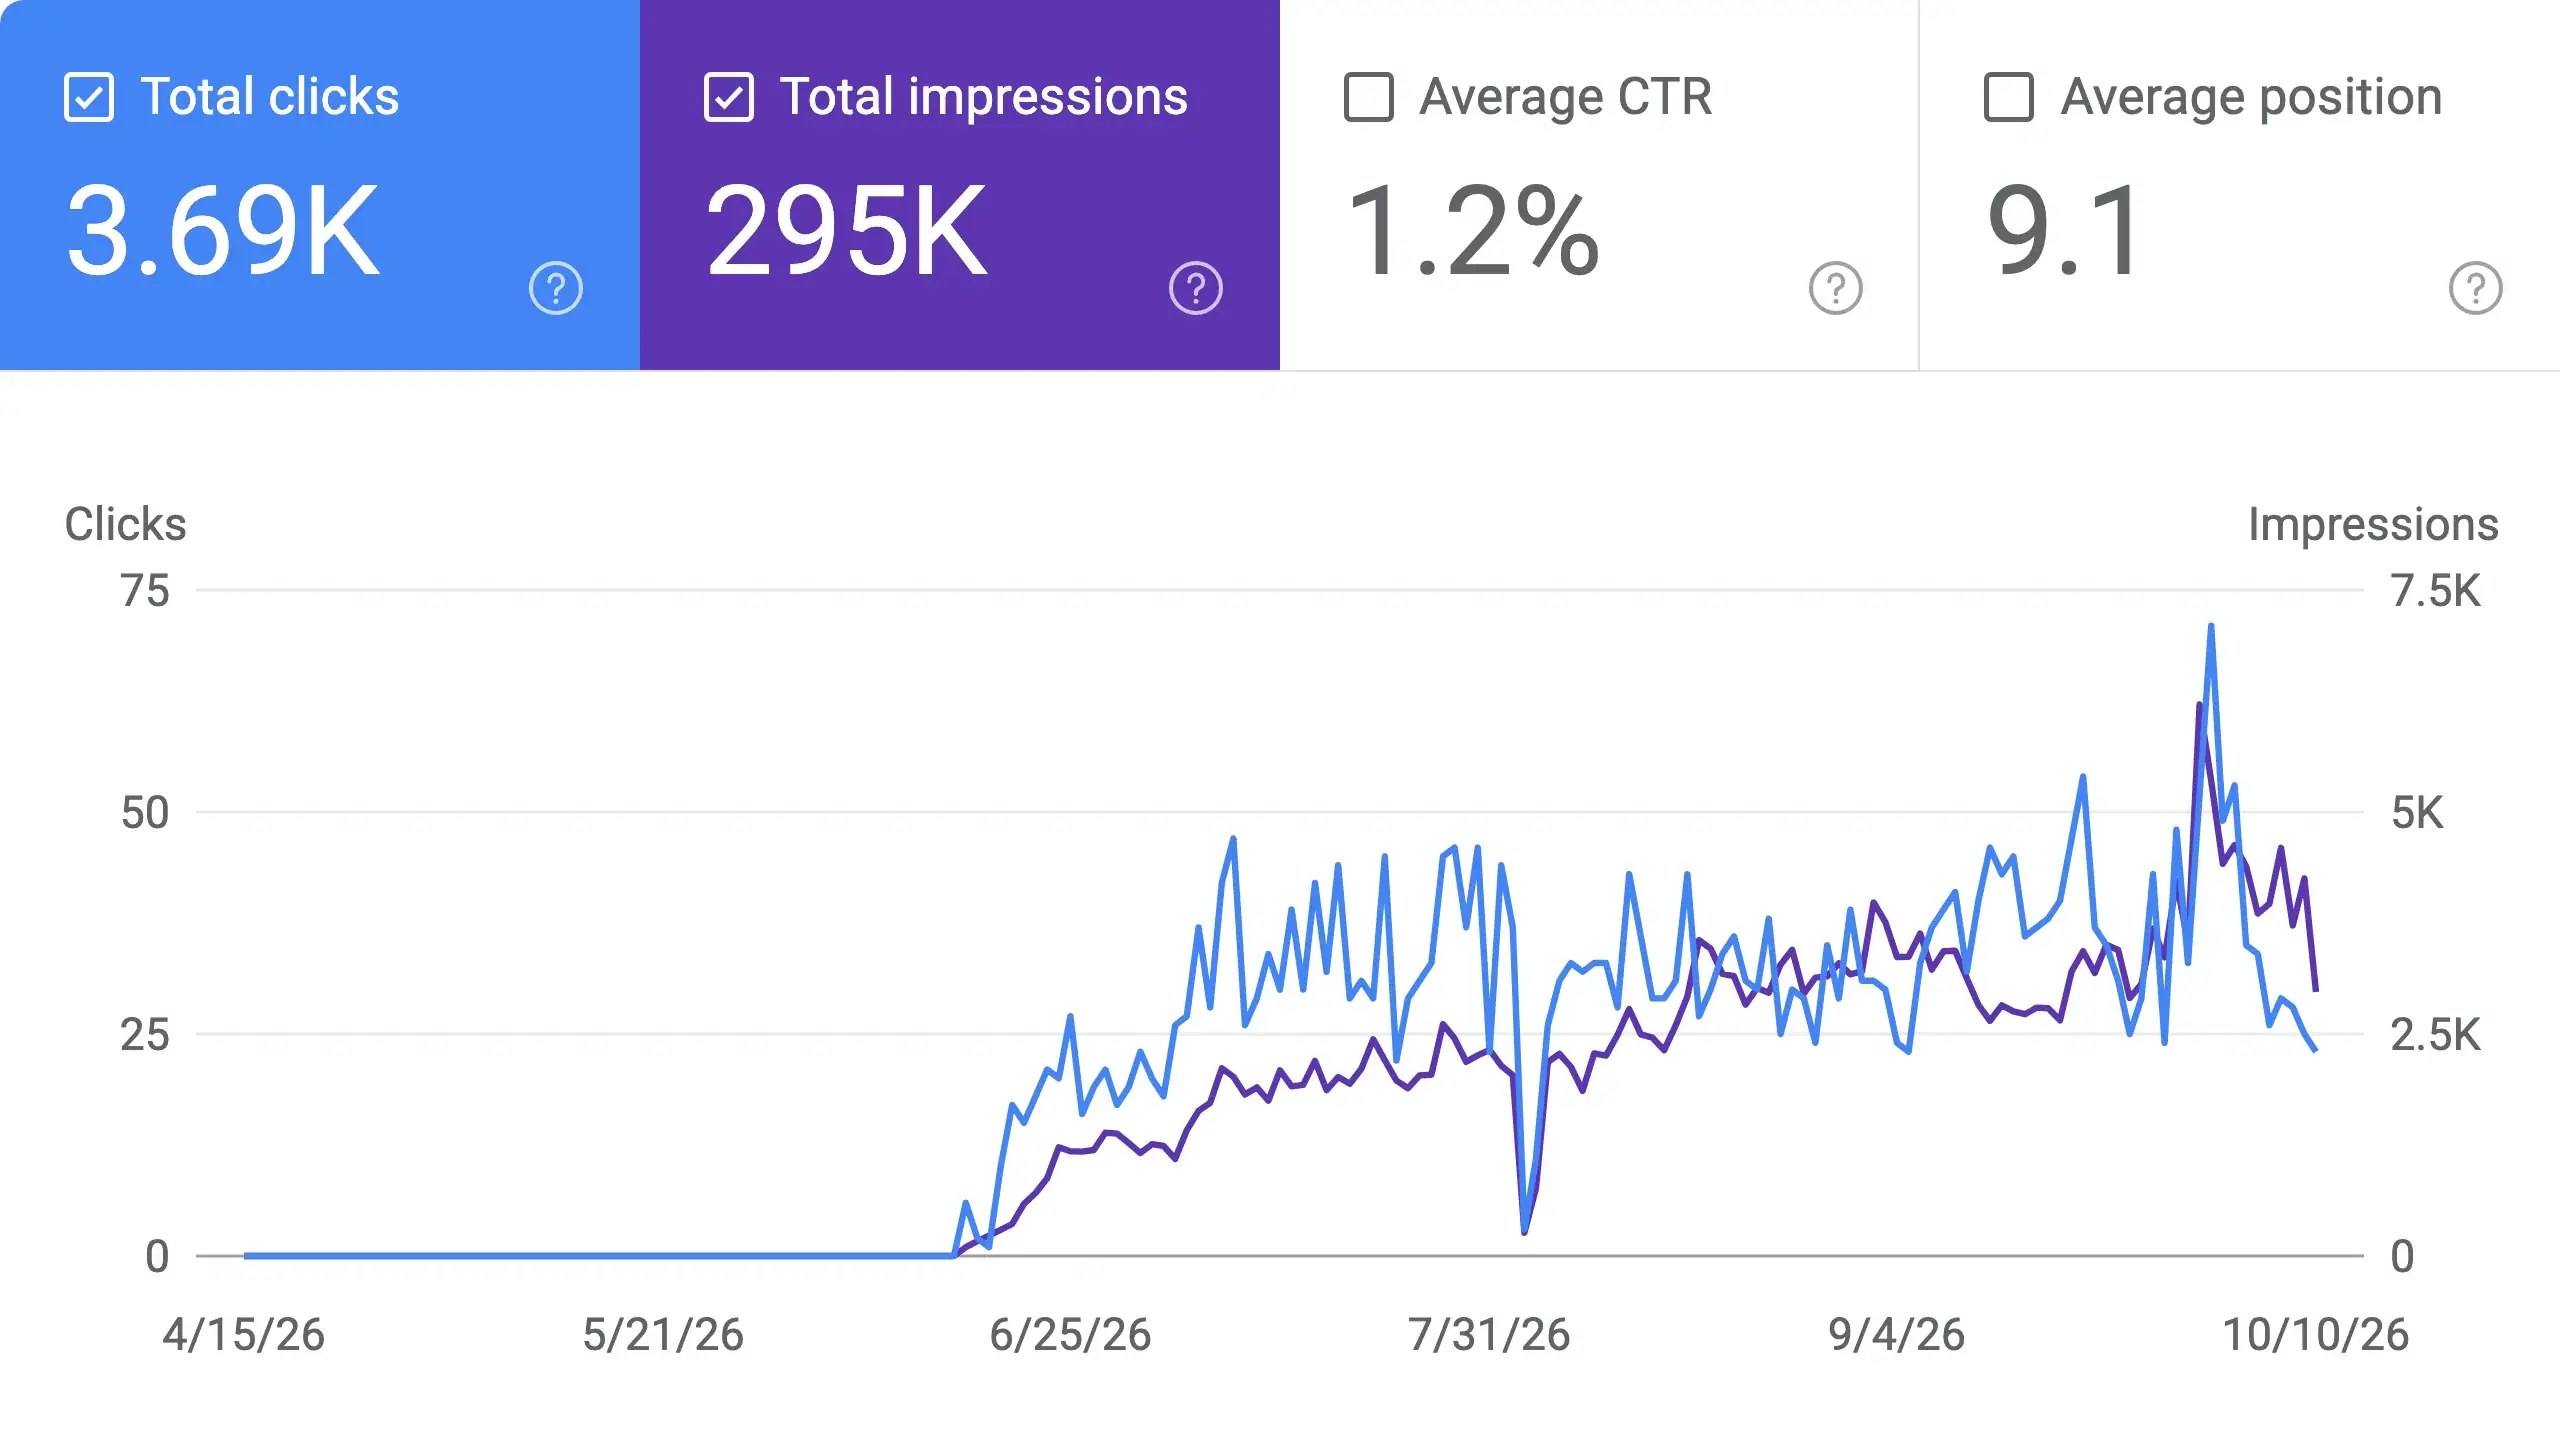
Casos reais mostram quão acentuado isto pode ser. Um site lançou com mais de 70 publicações otimizadas mas viu apenas 12 indexadas ao fim de três meses, e depois atingiu 83 páginas indexadas em seis semanas após correções sistemáticas. A lição é que ser rastreado é a parte fácil, enquanto conquistar um lugar no índice exige qualidade genuína e sinais técnicos limpos.
Canonização e controlo da indexação
As páginas duplicadas e quase duplicadas complicam a indexação, por isso os motores de pesquisa usam a canonização para escolher uma única versão preferida entre URLs semelhantes. Definir um URL canónico claro consolida os sinais na página certa e evita o rastreio desperdiçado em cópias redundantes.
Tem também controlos diretos. Uma etiqueta meta robots noindex mantém uma página fora do índice permitindo ainda assim o rastreio, o robots.txt bloqueia totalmente o rastreio de secções, e as ferramentas de remoção podem retirar conteúdo dos resultados. Usar a ferramenta certa para o objetivo certo, bloquear a indexação face a bloquear o rastreio, evita perdas acidentais de visibilidade.
Porque é que o rastreio e a indexação importam para o SEO e o GEO
Para o SEO, este fluxo é o bilhete de entrada. Uma página que não está indexada não se pode posicionar por melhor que esteja escrita, por isso confirmar a indexação é uma verificação básica de saúde. Ferramentas como a GSC indicam que páginas estão indexadas e por que motivo outras são excluídas.
Para a otimização para IAs generativas, aplica-se um processo paralelo. A indexação por IA determina se o seu conteúdo é armazenado e recuperável pelos sistemas de IA que alimentam assistentes como o ChatGPT, o Perplexity e o Gemini. Ser rastreável e indexável tanto pelos motores de pesquisa como pelos sistemas de IA é a condição prévia para a visibilidade tanto nos resultados como nas respostas geradas por IA.
Como conseguir mais páginas rastreadas e indexadas
Ajude primeiro a descoberta: submeta um mapa do site rigoroso, construa ligações internas limpas, corrija ligações partidas e cadeias de redirecionamento e evite páginas órfãs. Mantenha os servidores rápidos e estáveis para que o orçamento de rastreio não seja desperdiçado, e garanta que o conteúdo em JavaScript apresenta conteúdo que os rastreadores conseguem ler.
Depois, conquiste a indexação através da qualidade. Publique conteúdo original e substancial, resolva a duplicação com etiquetas canónicas e remova ou consolide as páginas finas que diluem o site. Monitorize a cobertura na Search Console e combine o trabalho técnico com uma pesquisa de palavras-chave e planeamento de conteúdo disciplinados, para que as páginas indexadas valham também a pena posicionar.
Conclusão
O rastreio e a indexação são as duas portas que uma página tem de atravessar antes de se poder posicionar: descoberta e obtenção, depois análise e armazenamento. São sequenciais e seletivos, e como só uma fração das páginas rastreadas é indexada, a qualidade e os sinais técnicos limpos decidem o resultado.
Confirme a indexação como uma verificação de rotina, controle-a de forma deliberada com etiquetas canónicas e diretivas robots, e lembre-se de que a mesma lógica se estende agora à indexação por IA para a pesquisa generativa. Fontes de referência: Google Search Central e CrawlWP.