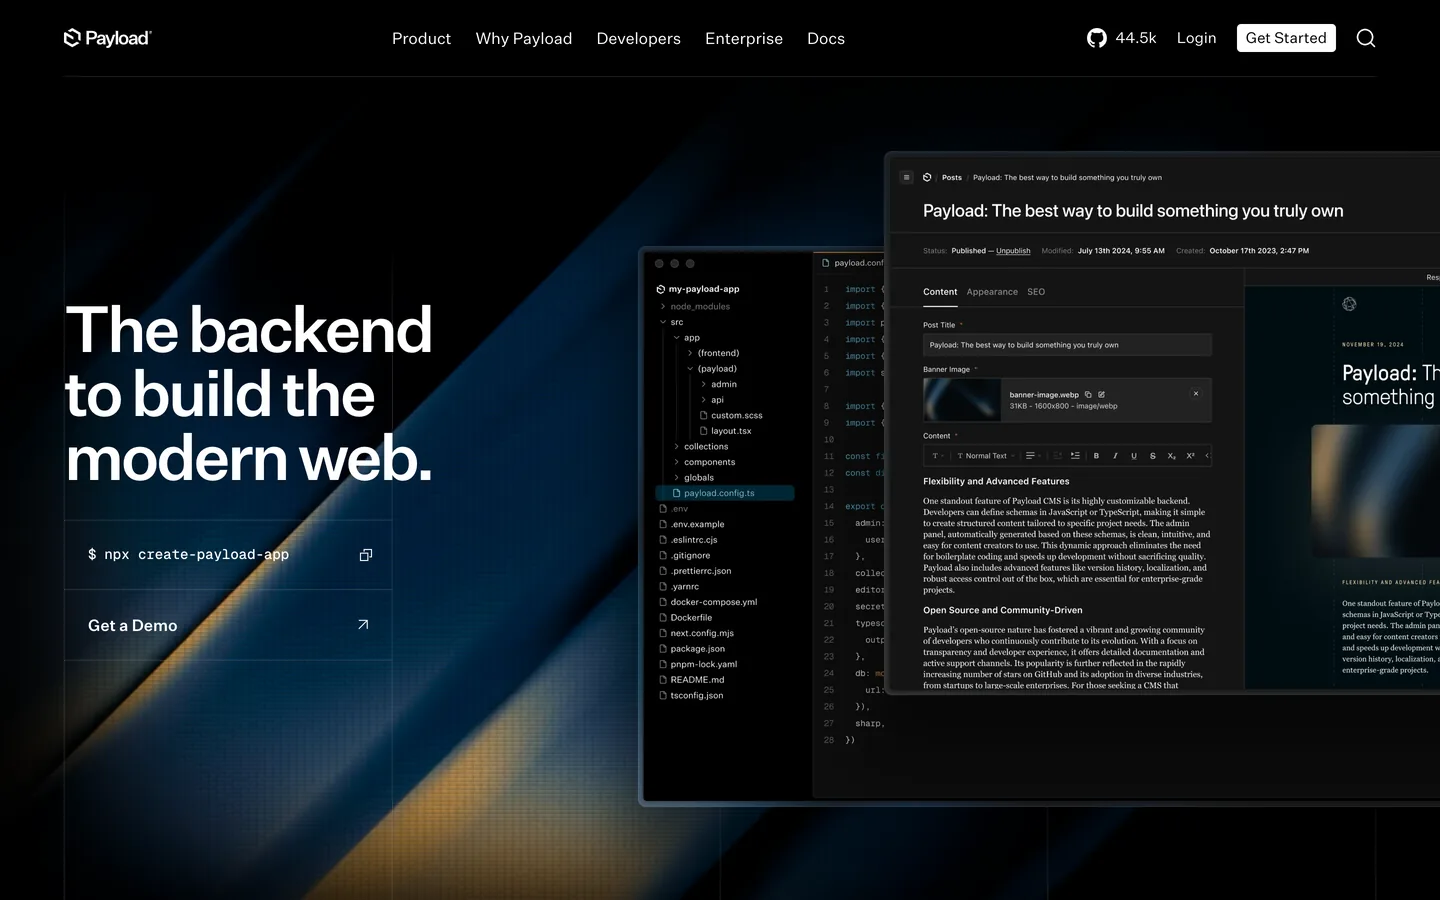
Wil je dat je Payload CMS-site opduikt in AI-antwoorden, en niet alleen tussen de klassieke tien blauwe links? Payload CMS is een code-first, TypeScript-gebaseerd headless CMS dat je naast je applicatie zelf host, waarin redacteuren werken met collecties en globals die als getypeerde velden zijn gedefinieerd, en ontwikkelaars content lezen en schrijven via REST, GraphQL en een server-side Local API. Die schemagestuurde kern maakt het een sterke basis voor generative engine optimization (GEO). Begin met een geo seo audit als nulmeting en laat elke verbetering zich opstapelen in een levend GEO / SEO-dashboard. Deze gids laat zien hoe je Payload modelleert, rendert en annoteert, zodat Google en assistenten als ChatGPT, Perplexity, Claude en Gemini je pagina's begrijpen en citeren.
Waarom GEO op Payload CMS in 2026
Zichtbaarheid splitst zich nu in twee: de gerangschikte links waar je al achteraan zit, en het korte lijstje bronnen dat ChatGPT, Perplexity, Claude en Gemini citeren als ze antwoorden. Generative Engine Optimization is het werk om op dat lijstje te komen. Payload past daarbij, omdat content als code wordt gedefinieerd: elke collectie heeft getypeerde velden, validatie en relaties, ondersteund door MongoDB of Postgres, waardoor elk document zich gedraagt als een schoon, gestructureerd record in plaats van een vrije pagina. Omdat Payload headless is, render je het via een snelle, moderne front-end en houd je volledige controle over de semantische HTML die modellen als aparte entiteiten lezen.
Controleer waar je staat in AI-antwoorden
Meet voordat je bouwt. Leg de echte vragen van je doelgroep voor aan de belangrijkste assistenten en noteer vervolgens of je pagina's verschijnen en welke URL's ze citeren. Volg merkcitaties met AI-vermeldingstracking, bestudeer de verwijzingen die je al verdient via door AI geciteerde backlinks en voer een uitgebreide geo seo audit uit om de entiteiten (merk, mensen, producten) in kaart te brengen die al aan je domein zijn gekoppeld. Deze nulmeting laat zien welke collecties en documenten je als eerste moet aanpakken.
Breng echte zoekintenties en prompts in kaart
Bij GEO komt zoekintentie binnen als complete prompts, niet als afgekapte zoekwoorden. Verzamel de exacte formuleringen die mensen gebruiken in chat en spraak, en groepeer ze per taak: leren, vergelijken, kiezen en oplossen. Vergroot je dekking met de query fan-out-tool en rangschik de onderwerpen met zoekwoordonderzoek. Wijs per cluster één canoniek Payload-document aan als de pagina die je geciteerd wilt zien, en maak die beknopt, citeerbaar en onderbouwd met expliciet bewijs, zodat een model een passage kan overnemen zonder de betekenis te verbuigen.
Structureer content met collecties, velden en entiteiten
Zie je collecties als de ruggengraat van je entiteiten. Definieer collecties zoals Posts, Categories, Products, Team, FAQs en een Glossary, geef elk getypeerde velden en verbind ze met relatievelden. Koppel je velden aan schema.org-eigenschappen zoals name, description, image, datePublished, author, about en sameAs, en bewaar SEO-metadata in een aparte groep bij elke collectie. Omdat het schema code is, blijven canonieke namen en feiten overal op de site uniform, en de officiële SEO-plugin standaardiseert de velden voor titel en beschrijving. Die herhaalbare diepgang is de thematische autoriteit waar antwoordmachines op belonen bij het kiezen van een bron.
Kies een Next.js-front-end voor snelle, crawlbare pagina's
Payload is headless, dus combineer het met een snelle front-end als Next.js, Nuxt of Astro en render pagina's op de server. Payload sluit nauw aan op Next.js, dus je haalt documenten op via de Local API tijdens de build of per verzoek en levert schone, semantische HTML zonder client-side hydratatiekosten voor content. Gebruik statische generatie of incrementele regeneratie voor artikelen, lever assets via een CDN en cache fors. Snelle pagina's met crawlbare markup vergroten de crawldekking en hoe vaak assistenten je citeren.
Stuur metadata aan vanuit je collectievelden: voeg de officiële SEO-plugin of een eigen SEO-groep toe, zodat elk document een precieze titel, een meta description en Open Graph-waarden draagt die de inhoud weerspiegelen. Render die velden in je front-end in de head van het document, bouw schone, entiteitsrijke URL's op basis van je slugs en geef canonical-tags weer om duplicaten en gepagineerde archieven samen te voegen tot één adres. Pas meta robots toe om dunne taglijsten en gefilterde weergaven buiten de index te houden, zodat assistenten per pagina één samenhangende betekenis lezen.
JSON-LD-schema op de juiste manier toevoegen
In Payload leeft JSON-LD in je front-endframework, niet in het adminpaneel. Voer in de paginacomponent van je Next.js-, Nuxt- of Astro-project een scriptblok van het type application/ld+json uit, gevuld vanuit het document dat je hebt opgehaald, zodat elke pagina gestructureerde data uitvoert die uit haar eigen velden is opgebouwd. Gebruik Article met WebPage en BreadcrumbList voor content, Product met offers op commercepagina's, HowTo voor tutorials en FAQPage voor vraagblokken. Voeg een Organization-graaf voor de hele site toe met logo, contactPoint en sameAs-links, zodat assistenten feiten bevestigen en je pagina's koppelen aan herkende entiteiten.
Maak expliciete vraag-en-antwoordblokken die echte prompts weerspiegelen en voeg een aparte FAQ-veldgroep of blocks-veld toe, zodat redacteuren het patroon op elk relevant document herhalen. Houd elk antwoord tussen 50 en 120 woorden, link naar de bijpassende interne pagina en citeer één gezaghebbende externe bron. Zet bij procedures de benodigdheden, de genummerde stappen en de benodigde tijd in HowTo-vorm. Deze compacte formaten halen dubbelzinnigheid weg en maken het voor een assistent eenvoudig om je Payload-pagina's te citeren met behoud van de betekenis.
Bestanden die crawlers sturen: robots.txt, sitemap.xml, llms.txt
Genereer in je front-end een XML-sitemap met elk gepubliceerd document en dien die in bij Google Search Console. Sta in robots.txt de routes toe die citeerbare content bevatten en blokkeer het adminpaneel en de API-endpoints. Publiceer een llms.txt-bestand in de root van je domein met de gewenste crawlregels voor AI-agents, je prioritaire URL's en je voorwaarden voor hergebruik. Dit bestand wordt steeds vaker gerespecteerd en geeft een duidelijke herkomst door aan de modellen die bronnen citeren.
Interne links, navigatie en broodkruimels
Bouw onderwerphubs die verwante documenten bundelen en je canonieke antwoorden vastleggen, en gebruik een navigatie-global plus breadcrumbs voor een heldere hiërarchie. Voeg contextuele inline links toe met beschrijvende ankerteksten en verbind elk document via relatievelden met de bovenliggende hub en met verwante onderwerpen. Versnel het in kaart brengen met een topicclustergenerator. Draaien delen van je stack elders, gebruik dan dezelfde aanpak op strapi, directus, webflow en shopify.
Autoriteitssignalen: backlinks, vermeldingen en E-E-A-T
GEO draait nog steeds op autoriteit. Verdien citaties van betrouwbare publicaties, primair onderzoek en de TypeScript- en ontwikkelaarscommunity's rond Payload-projecten. Publiceer onder de naam van experts, toon de kwalificaties van reviewers en houd uitgebreide biopagina's en een Over ons-pagina bij die E-E-A-T versterken. Volg je positie in de loop van de tijd met een domeinautoriteit-tracker en toon een duidelijke datum van de laatste update op strategische documenten, zodat zowel Google als assistenten je content lezen als actueel en goed onderhouden.
Op schaal publiceren met Sorank en Make.com
Payload CMS biedt een publieke API: elke collectie krijgt automatisch REST- en GraphQL-endpoints waarmee je documenten aanmaakt, al is er geen eigen Make.com-app. Sorank verbindt daarom via een Make.com-webhookbrug: elk artikel dat Sorank genereert, wordt naar een Make.com-scenario gestuurd, en Make publiceert het in Payload met de generieke HTTP-module van Make.com om met een API-sleutel een POST uit te voeren op het endpoint van je collectie. Er is nog geen native Sorank-connector, en deze route automatiseert het publiceren. Schrijf geoptimaliseerde artikelen snel met de blogartikelgenerator en zet ze daarna volgens planning live. Test de aanroep voor het aanmaken van content eerst op je live instantie, en val terug op de zelfgehoste blog van Sorank als je configuratie dit beperkt.
Meet AI-zichtbaarheid en stuur bij
Volg welke prompts je merk oproepen, welke documenten worden geciteerd en waar concurrenten winnen. Vergelijk jezelf met SEO-concurrentiespion, houd je positie in de gaten op een GEO-ranglijst en schrijf bezoeken die via assistenten komen toe met getagde landingspagina's en UTM's. Bekijk de data na elk nieuw schema, elke contentcluster en elke linkcampagne, en herhaal de cyclus maandelijks, zodat GEO een meetbare, almaar groeiende motor van groei wordt.
Conclusie
Payload CMS geeft je een code-first, getypeerd contentmodel en volledige controle over de markup van je front-end; GEO geeft je de strategie om dat bij antwoordmachines onder de aandacht te brengen. Als je documenten duidelijke entiteiten, precieze metadata en betrouwbaar bewijs tonen, citeren assistenten je met vertrouwen. Zet gestructureerde collecties op, een snelle server-side gerenderde front-end, JSON-LD en citeerbare antwoorden, en laat Sorank de audits, content en links aansturen, zodat je merk de bron wordt die modellen in 2026 en daarna het liefst citeren.